
문제지 PDF · 웹 정답 해설
정보처리기사 필기 2021년 3회 공개기출 100문항
정보처리기사 필기 2021년 3회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.

© 자격증3001. 이 정보처리기사 필기 기출문제 게시물의 문제 재구성 문장, 해설, 재작성 도식, 편집 및 PDF 디자인은 자격증3001의 저작권 보호를 받습니다. 국가기술자격 시험 및 관련 명칭의 권리는 해당 기관에 있으며, 본 자료는 Q-Net 공식 문제지 또는 공식 해설이 아닙니다. 무단 복제·재배포를 금합니다.
정보처리기사 필기 2021년 3회 공개기출 100문항 안내
정보처리기사 필기 2021년 3회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.
이 회차의 100문항 해설을 문항별 기술 원문과 필요한 독립 계산으로 편집 검토했습니다. 질문·조건·보기를 고친 문항은 학습용 개정문항으로 표시합니다. 원 시험의 공식 원문이나 공식 정답표를 새로 확인한 자료는 아닙니다.
정보처리기사 필기 기출문제 · 소프트웨어 설계
1. 요구사항 검증(Requirements Validation)과 관련한 설명으로 틀린 것은?
- 요구사항이 고객이 정말 원하는 시스템을 제대로 정의하고 있는지 점검하는 과정이다.
- 개발완료 이후에 문제점이 발견될 경우 막대한 재작업 비용이 들 수 있기 때문에 요구사항 검증은 매우 중요하다.
- 요구사항이 실제 요구를 반영하는지, 문서상의 요구사항은 서로 상충되지 않는지 등을 점검한다.
- 요구사항 검증 과정을 통해 모든 요구사항 문제를 발견할 수 있다.
정답과 해설 보기
정답: 4
정답은 ④이다. 요구사항 검증은 작성한 요구가 이해관계자의 실제 필요를 나타내는지, 서로 모순되지 않는지, 실현하거나 시험할 수 있는지 등을 확인하는 활동이다. 검토·시제품·시험 기준 작성 등을 통해 문제를 일찍 찾으면 잘못된 요구를 구현한 뒤 수정하는 부담을 줄일 수 있다. 그러나 검증 과정이 모든 누락과 오류를 반드시 찾아낸다고 보장할 수는 없다. 이해관계자의 새로운 지식이나 환경 변화로 나중에 문제가 드러날 수도 있으므로 개발 과정에서 요구를 계속 확인하고 관리해야 한다.
선지별 해설
- 실제 필요와 작성한 요구사항 사이의 적합성을 확인한다.
- 잘못된 요구를 토대로 구현을 진행하면 이후 재작업 범위가 커질 수 있다.
- 내용의 타당성과 요구사항 사이의 일관성을 점검한다.
- 검증으로 발견 가능성을 높일 수 있지만 모든 문제의 발견을 보장하지는 않는다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §5 Requirements Validation; §5.1 Requirements Reviews; ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §1.3 Seven Testing Principles
2. UML 모델에서 한 사물의 명세가 바뀌면 다른 사물에 영향을 주며, 일반적으로 한 클래스가 다른 클래스를 오퍼레이션의 매개변수로 사용하는 경우에 나타나는 관계는?
- Association
- Dependency
- Realization
- Generalization
정답과 해설 보기
정답: 2
정답은 ②이다. UML의 의존 관계는 한 모델 요소가 다른 요소의 정의나 존재에 기대고 있어 공급자 요소의 변경이 사용자 요소에 영향을 줄 수 있음을 나타낸다. 다른 클래스를 연산의 매개변수 형식으로 사용하는 경우가 대표적인 예다. 연관은 인스턴스 사이의 연결을, 일반화는 보다 일반적인 분류자와 특수한 분류자의 관계를, 실체화는 명세와 이를 구현하는 요소의 관계를 나타낸다. 단순히 두 요소가 관련되어 있다는 이유만으로 네 관계를 같은 의미로 사용해서는 안 된다.
선지별 해설
- Association은 인스턴스 사이에 존재할 수 있는 연결을 나타낸다.
- Dependency는 한 요소가 다른 요소의 정의에 기대는 사용 관계다.
- Realization은 명세와 구현 요소 사이의 관계다.
- Generalization은 일반적인 분류자와 특수한 분류자를 연결한다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §7.7 Dependencies; §9.2 Classifiers; §11.5 Associations
3. 익스트림 프로그래밍(XP)에 대한 설명으로 틀린 것은?
- 빠른 개발을 위해 테스트를 수행하지 않는다.
- 사용자의 요구사항은 언제든지 변할 수 있다.
- 고객과 직접 대면하며 요구사항을 이야기하기 위해 사용자 스토리(User Story)를 활용할 수 있다.
- 기존의 방법론에 비해 실용성(pragmatism)을 강조한 것이라고 볼 수 있다.
정답과 해설 보기
정답: 1
정답은 ①이다. XP는 작은 단위의 피드백을 자주 얻으며 변경에 대응하는 개발 방식으로, 자동화된 시험과 지속적인 통합을 중요한 실천으로 다룬다. 개발 속도를 높이기 위해 시험을 생략한다는 주장은 이 접근과 반대다. 사용자 스토리는 고객이 원하는 기능을 이야기하고 작업을 계획하는 데 활용하며 세부 내용은 대화를 통해 보완할 수 있다. 간단한 설계와 반복적인 개선을 추구한다는 것이 요구 분석이나 품질 확인을 하지 않는다는 뜻은 아니다.
선지별 해설
- XP는 반복적인 자동 시험을 강조하므로 시험 생략이라는 설명은 틀렸다.
- 요구 변화에 피드백과 짧은 개발 주기로 대응한다.
- 스토리는 기능을 설명하고 고객과 대화를 이어가는 수단이 될 수 있다.
- 실제 피드백과 동작하는 결과를 중시한다는 취지로 이해할 수 있다.
편집 해설 근거: Ron Jeffries, What is Extreme Programming? (2011) — Customer Tests; Test-Driven Development; Planning Game; Simple Design
4. 소프트웨어 설계에서 사용되는 대표적인 추상화(Abstraction) 기법이 아닌 것은?
- 자료 추상화
- 제어 추상화
- 과정 추상화
- 강도 추상화
정답과 해설 보기
정답: 4
정답은 ④이다. 추상화는 특정 목적에 필요한 본질적인 특성을 남기고 구현 세부 사항을 감추는 사고 방식이다. 자료 추상화는 값과 허용되는 연산을 중심으로 자료를 다루고, 과정 추상화는 일련의 처리를 하나의 절차나 함수로 나타낸다. 제어 추상화는 반복이나 호출 같은 제어 흐름의 세부 구현을 높은 수준의 구성으로 표현한다. 강도 추상화는 이 문항에서 비교하는 대표적인 세 추상화 종류에 포함되는 명칭이 아니다. 추상화는 정보 자체를 무조건 없애는 일이 아니다.
선지별 해설
- 자료의 구체적인 표현보다 자료형과 연산의 의미를 드러내는 기법이다.
- 제어 흐름의 세부 구현을 높은 수준의 제어 구조로 표현하는 기법이다.
- 연속된 처리를 절차·함수의 이름과 인터페이스로 표현하는 기법이다.
- 제시한 대표적인 자료·제어·과정 추상화의 분류에 해당하지 않는다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Abstraction; MIT Laboratory for Computer Science, Programming Methodology Group Progress Report 1975–76, Memo 150 (1977) — printed p. 3 — procedural, control and data abstractions
5. 객체지향 설계에서 정보 은닉(Information Hiding)과 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 다른 모듈이 알 필요 없는 구현 세부 사항에 대한 직접 접근을 제한한다.
- 모듈들 사이의 독립성을 유지하는 데 도움이 된다.
- 내부 자료 구조나 변경 가능성이 큰 구현 결정을 은닉할 수 있다.
- 요구사항 변화에 따른 모듈 내부 구현의 수정이 불가능해진다.
정답과 해설 보기
정답: 4
정답은 ④이다. 정보 은닉은 모듈 사용자가 알 필요가 없는 내부 표현이나 변경 가능성이 큰 설계 결정을 공개 인터페이스 뒤에 감추는 원칙이다. 다른 모듈이 그 세부 사항에 직접 의존하지 않으면 내부 구현을 바꾸어도 변경의 영향을 제한할 수 있다. 따라서 정보 은닉 때문에 요구 변화에 따른 수정이 불가능해진다는 설명은 반대다. 다만 공개한 기능 계약 자체가 바뀌는 경우에는 다른 모듈에도 수정이 필요할 수 있다. 보안용 암호화와 설계 원칙으로서의 정보 은닉도 구별해야 한다.
선지별 해설
- 다른 모듈의 불필요한 구현 의존성을 제한하는 원칙이다.
- 변경 영향을 줄여 모듈 사이의 독립성을 높이는 데 도움이 된다.
- 내부 자료 구조나 변경 가능성이 큰 구현 결정을 숨길 수 있다.
- 내부를 변경하기 쉽게 하는 원칙이며 요구 변화에 대한 수정을 금지하지 않는다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Encapsulation; Separation of interface and implementation
6. 소프트웨어 공학에서 모델링(Modeling)과 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 개발팀이 응용 문제를 이해하는 데 도움을 줄 수 있다.
- 유지보수 단계에서만 모델링 기법을 활용한다.
- 여러 분야의 엔지니어가 공통된 개념을 공유하는 데 도움을 준다.
- 자료 흐름도는 자료를 변환하는 처리와 자료 이동을 표현한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 모델은 복잡한 시스템을 특정 관점에서 표현하여 문제를 이해하고 설계안을 비교하며 서로의 생각을 전달하는 데 쓰인다. 요구 분석·설계·구현·시험·유지보수 등 여러 활동에서 활용할 수 있으므로 유지보수 단계에만 사용한다는 설명은 틀렸다. 자료 흐름도는 자료를 변환하는 처리와 저장소, 외부 실체 사이의 자료 이동을 나타낸다. 모델 하나가 시스템의 모든 측면을 완전히 담아야 하는 것은 아니며 목적에 맞는 관점과 상세 수준을 선택해야 한다.
선지별 해설
- 실제 문제의 중요한 요소와 관계를 표현하여 이해를 돕는다.
- 모델링은 유지보수에만 한정되지 않는다.
- 공유한 표기와 개념으로 여러 참여자의 의사소통을 도울 수 있다.
- 자료 흐름도는 자료 변환 처리와 그 사이의 흐름을 모델링한다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Models and Methods §1 Modeling; §2 Types of Models; Excel Software, Process Model — Data Flow Diagrams — Data Flow Diagrams
7. 요구 분석(RequirementAnalysis)에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 수집한 사용자 요구를 이해하고 충돌·누락·제약을 분석한다.
- 요구 도출은 이해관계자에게 필요한 사항을 찾아내는 활동이다.
- 도메인 분석은 업무 분야의 개념·규칙·제약을 이해하는 데 도움을 준다.
- 응답시간·처리 용량 같은 성능 조건은 모두 기능적 요구로만 분류한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 요구 분석에서는 수집한 요구를 구조화하고 충돌·누락·제약을 확인하여 시스템이 제공해야 할 기능과 품질 조건을 구체화한다. 응답시간이나 처리 용량 같은 성능 조건은 일반적으로 비기능적 요구 또는 품질 요구로 분류하므로 모두 기능적 요구로만 분류한다는 설명은 틀렸다. 보안도 로그인처럼 기능으로 표현되는 부분과 보호 수준 같은 품질 조건이 함께 있을 수 있다. 요구 활동을 일회성 첫 단계로만 보지 않고 이해와 환경이 바뀔 때 반복해서 정교화할 수 있다.
선지별 해설
- 수집한 요구를 이해하고 충돌·누락 등을 분석하는 활동이다.
- 사용자와 이해관계자에게서 필요한 사항을 찾아내는 활동이다.
- 업무 분야의 개념·규칙·제약을 이해하면 요구 분석에 도움이 된다.
- 응답시간·용량 같은 성능 조건을 모두 기능적 요구로만 분류하는 것은 잘못이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §1.4 Functional Requirements; §1.5 Nonfunctional Requirements; §2 Requirements Elicitation; §3 Requirements Analysis
8. 클래스 다이어그램의 요소로 다음 설명에 해당하는 용어는?
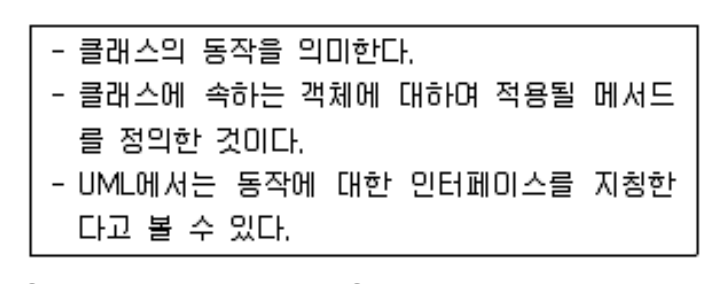
- Instance
- Operation
- Item
- Hiding
정답과 해설 보기
정답: 2
정답은 ②이다. UML에서 오퍼레이션은 분류자의 인스턴스에 호출할 수 있는 동작의 이름, 매개변수와 반환 형식 등 호출 계약을 규정한다. 해당 오퍼레이션을 실제로 수행하는 동작의 구현을 메서드라고 구별할 수 있다. 따라서 그림의 동작에 대한 인터페이스라는 단서는 Operation에 해당한다. Instance는 분류자에 속하는 개별 사례이고 정보 은닉은 구현 세부 사항을 감추는 원칙이다. 클래스 다이어그램에서 속성과 오퍼레이션을 구분하여 상태와 수행 가능한 동작을 읽는 것이 중요하다.
선지별 해설
- Instance는 클래스 등에 속하는 개별 객체를 뜻한다.
- Operation은 호출 가능한 동작의 인터페이스를 규정한다.
- Item은 그림이 설명한 UML 동작 인터페이스의 명칭이 아니다.
- Hiding은 은닉 원칙이며 호출 동작의 명세 요소가 아니다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §9.6 Operations; §11.4 Classes
9. 마스터가 작업을 조정하고 워커가 할당된 일을 수행하는 마스터-워커(기존 Master-Slave) 분산 구조에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 여러 프로세스가 조정과 작업 수행의 역할을 나누어 협력할 수 있다.
- 마스터는 작업 분배나 통신·결과 조정을 담당할 수 있다.
- 워커 프로세스는 자료 수집 기능을 수행할 수 없다.
- 마스터가 워커에게 작업을 요청하고 진행을 조정할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 이 구조에서는 조정 역할을 맡은 마스터와 할당된 작업을 수행하는 워커가 서로 협력한다. 워커의 작업에는 자료 수집이나 계산, 결과 전송 등이 포함될 수 있으므로 자료 수집을 수행할 수 없다고 제한할 근거가 없다. 마스터는 작업을 나누거나 통신·결과를 조정할 수 있지만 반드시 모든 계산을 혼자 수행해야 하는 것은 아니다. 구체적인 역할 배분은 시스템 설계에 따라 달라지며 이 역할 구조 자체가 특정 응답시간이나 무중단 운영을 보장하지도 않는다.
선지별 해설
- 조정 역할과 작업 수행 역할을 나누어 협력할 수 있다.
- 마스터가 작업 분배와 통신·결과 조정을 담당할 수 있다.
- 워커도 할당된 작업으로 자료를 수집할 수 있으므로 틀렸다.
- 마스터가 워커에게 작업을 요청하고 진행을 조정할 수 있다.
편집 해설 근거: Oracle Retail Integration Bus 16.0.030, Cloud Enhancements — Configuring RIB-RWMS for Hybrid Cloud Deployment Topology
10. 요구사항 정의 및 분석 – 설계의 결과물을 표현하기 위한 모델링 과정에서 사용되는 다이어그램 (Diagram)이 아닌 것은?
- Data Flow Diagram
- UML Diagram
- E-R Diagram
- AVL Diagram
정답과 해설 보기
정답: 4
정답은 ④이다. 자료 흐름도는 처리 사이의 자료 이동을, E-R 다이어그램은 데이터의 개체·속성·관계를, UML 다이어그램은 소프트웨어 구조나 상호작용 등의 여러 관점을 표현한다. 반면 AVL은 삽입·삭제 뒤에도 높이 균형을 유지하도록 하는 이진 탐색 트리의 한 종류다. AVL 트리를 그림으로 그릴 수는 있지만 그것이 요구 분석과 설계 산출물을 표현하는 일반적인 다이어그램 체계의 이름이라는 뜻은 아니다. 자료 구조의 이름과 모델링 표기 체계를 구별한다.
선지별 해설
- DFD는 자료 변환과 이동을 나타내는 분석 모델이다.
- UML은 구조·행동 등 여러 관점의 다이어그램을 제공한다.
- E-R 다이어그램은 데이터 개체와 관계를 나타낸다.
- AVL은 균형 이진 탐색 트리로, 제시한 모델링 다이어그램 체계의 분류와 다르다.
편집 해설 근거: Excel Software, Process Model — Data Flow Diagrams — Data Flow Diagrams; OMG UML 2.5.1 (2017) — Annex A Diagrams; NIST DADS, AVL tree — Definition
11. 객체지향의 주요 개념에 대한 설명으로 틀린 것은?
- 캡슐화는 상위 클래스에서 속성이나 연산을 전달받아 새로운 형태의 클래스로 확장하여 사용하는 것을 의미한다.
- 객체는 실세계에 존재하거나 생각할 수 있는 것을 말한다.
- 클래스는 하나 이상의 유사한 객체들을 묶어 공통된 특성을 표현한 것이다.
- 다형성은 상속받은 여러 개의 하위 객체들이 다른 형태의 특성을 갖는 객체로 이용될 수 있는 성질이다.
정답과 해설 보기
정답: 1
정답은 ①이다. 상위 클래스에서 속성이나 동작을 이어받아 하위 클래스를 정의하는 개념은 상속이다. 캡슐화는 관련 데이터와 연산을 하나의 단위로 묶고 공개한 경계를 통해 사용하게 하는 개념이므로 두 용어를 바꾸어 설명하면 안 된다. 객체는 문제 영역의 실체나 개념을 모델링한 개별 사례이고 클래스는 공통된 구조와 동작을 정의한다. 다형성은 같은 인터페이스나 상위 타입을 통해 사용하더라도 실제 하위 타입에 맞는 동작이 선택될 수 있다는 점으로 이해하면 된다.
선지별 해설
- 상위 클래스의 특성을 이어받는 설명은 캡슐화가 아니라 상속이다.
- 객체는 실세계 실체뿐 아니라 계좌·예약 같은 개념도 표현할 수 있다.
- 클래스는 공통된 속성과 동작을 갖는 객체의 형식을 정의한다.
- 같은 상위 타입이나 호출 인터페이스를 다양한 하위 객체에 적용할 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles; §5.4 Object-Oriented Design; OMG UML 2.5.1 (2017) — §9.2 Classifiers; §11.4 Classes
12. 사용자 인터페이스(User Interface)에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 사용자와 시스템이 정보를 주고받는 상호작용을 매개하는 장치나 소프트웨어를 포함한다.
- 편리한 유지보수를 위해 개발자 중심으로 설계되어야 한다.
- 배우기 쉽고 사용하기 편리하도록 설계해야 한다.
- 사용자의 작업과 요구사항을 파악하여 구성에 반영해야 한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 사용자 인터페이스는 사용자가 시스템의 기능을 이해하고 작업을 수행하며 결과와 상태를 확인하는 접점이다. 따라서 실제 사용자의 목표·능력·사용 환경을 고려해야 하며 개발자의 편의만을 기준으로 설계하면 안 된다. 배우기 쉬운 구성, 일관된 용어와 조작, 적절한 피드백은 사용성을 높이는 데 도움이 된다. 유지보수하기 쉬운 구현도 가치가 있지만 그것이 사용자 중심 설계를 대신하지는 않는다. 서로 다른 사용자 집단의 요구와 접근성도 함께 검토해야 한다.
선지별 해설
- 사용자와 시스템 사이의 입력·출력과 상호작용을 매개한다.
- 사용자의 목표와 환경을 우선 검토해야 하므로 개발자 중심이라는 설명은 틀렸다.
- 학습과 사용 부담을 줄이는 것은 사용성의 중요한 목표다.
- 사용자의 작업과 요구를 파악해 인터페이스에 반영해야 한다.
편집 해설 근거: Jakob Nielsen, 10 Usability Heuristics for User Interface Design — Match between the system and the real world; Consistency and standards; Recognition rather than recall
13. GoF(Gang of Four) 디자인 패턴과 관련한 설명으로 틀린 것은?
- 디자인 패턴을 목적(Purpose)으로 분류할 때 생성, 구조, 행위로 분류할 수 있다.
- Strategy 패턴은 대표적인 구조 패턴으로 인스턴스를 복제하여 사용하는 구조를 말한다.
- 행위 패턴은 클래스나 객체들이 상호작용하는 방법과 책임을 분산하는 방법을 정의한다.
- Singleton 패턴은 특정 클래스의 인스턴스가 오직 하나임을 보장하고, 이 인스턴스에 대한 접근 방법을 제공한다.
정답과 해설 보기
정답: 2
정답은 ②이다. Strategy는 교체 가능한 알고리즘들을 공통 인터페이스로 캡슐화하여 사용하는 행위 패턴이다. 인스턴스를 복제하여 새 객체를 만드는 설명은 생성 패턴인 Prototype에 해당한다. GoF 패턴은 목적에 따라 생성·구조·행위로 분류하며, 행위 패턴은 객체 사이의 책임 배분과 협력을 다룬다. Singleton은 설계가 정한 범위에서 클래스의 인스턴스를 하나로 제한하고 접근 지점을 제공한다. 분산된 여러 프로세스 전체에서 단 하나의 객체가 자동 보장된다는 뜻은 아니다.
선지별 해설
- 목적에 따른 GoF의 대표 분류는 생성·구조·행위다.
- Strategy는 알고리즘 교체를 위한 행위 패턴이며 복제 생성은 Prototype이다.
- 행위 패턴은 협력과 책임 배분을 다룬다.
- Singleton은 하나의 인스턴스와 이에 대한 접근 지점을 제공하려는 패턴이다.
편집 해설 근거: Rob Pierry, Microsoft MSDN Magazine, Design Patterns in .NET (2005) — Strategy Pattern; Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — p. 15, Design Space for GoF Patterns
14. 애자일 개발 방법론과 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 빠른 릴리스를 통해 문제점을 일찍 파악할 수 있다.
- 동작하는 소프트웨어보다 포괄적인 문서 완성을 항상 우선한다.
- 고객과의 의사소통과 협력을 중요하게 생각한다.
- 진화하는 요구사항에 맞춰 계획을 조정할 수 있다.
정답과 해설 보기
정답: 2
정답은 ②이다. 애자일 선언은 포괄적인 문서보다 동작하는 소프트웨어에, 계획 준수보다 변화 대응에 더 높은 가치를 둔다. 따라서 문서 완성을 동작하는 결과보다 항상 우선한다는 설명은 선언의 방향과 맞지 않는다. 짧은 주기로 결과를 전달하고 고객과 대화하면 요구에 대한 오해를 일찍 확인할 수 있다. 그렇다고 계획이나 문서를 없애라는 뜻은 아니다. 필요한 계획과 기록을 유지하되 피드백에 따라 조정하면서 실제 가치를 전달하는 데 활용해야 한다.
선지별 해설
- 짧은 전달 주기는 결과에 대한 피드백을 일찍 얻는 데 도움이 된다.
- 애자일은 포괄적 문서보다 동작하는 소프트웨어에 더 높은 가치를 둔다.
- 고객과 협력하며 요구와 결과를 지속적으로 확인한다.
- 변화하는 요구에 대응하며 계획을 조정한다.
편집 해설 근거: Manifesto for Agile Software Development (2001) — Manifesto for Agile Software Development; Principles behind the Agile Manifesto
15. 럼바우(Rumbaugh)의 객체지향 분석 기법 중 자료 흐름도(DFD)를 주로 이용하는 것은?
- 기능 모델링
- 동적 모델링
- 객체 모델링
- 정적 모델링
정답과 해설 보기
정답: 1
정답은 ①이다. 럼바우의 OMT는 객체 모델, 동적 모델, 기능 모델을 서로 보완하는 관점으로 사용한다. 기능 모델은 입력 자료가 어떤 처리를 거쳐 출력으로 변환되는지를 나타내며 자료 흐름도를 활용한다. 동적 모델은 사건에 따른 상태 변화와 제어 동작을, 객체 모델은 객체·클래스·관계 같은 정적인 구조를 표현한다. 자료 흐름도의 화살표는 자료 이동이며 실행 명령의 시간 순서를 직접 나타내는 흐름도와는 구별된다. 세 모델을 혼동하지 않고 무엇을 표현하는지 확인해야 한다.
선지별 해설
- 기능 모델은 자료 변환과 처리 사이의 자료 흐름을 DFD로 표현한다.
- 동적 모델은 사건과 상태 변화에 초점을 둔다.
- 객체 모델은 객체와 클래스의 구조 및 관계를 나타낸다.
- 정적인 구조를 설명하는 관점이며 DFD를 사용하는 기능 모델의 명칭이 아니다.
편집 해설 근거: Dov Dori, On Bridging the Analysis–Design and Structure–Behavior Grand Canyons with Object Paradigms (1996), 저자 제공 원문 — p. 26, three models of OMT
16. 순차 다이어그램(Sequence Diagram)과 관련한 설명으로 틀린 것은?
- 객체들의 상호작용을 나타내기 위해 사용한다.
- 시간의 흐름에 따라 객체들이 주고 받는 메시지의 전달 과정을 강조한다.
- 동적 다이어그램보다는 정적 다이어그램에 가깝다.
- 교류 다이어그램(lnteraction Diagram)의 한 종류로 볼 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 순차 다이어그램은 생명선으로 표현한 참여자 사이에 어떤 메시지가 어떤 순서로 전달되는지 보여 주는 상호작용 다이어그램이다. 시간에 따른 메시지 교환을 다루므로 UML의 행동 다이어그램에 속한다. 클래스나 패키지의 정적인 구성을 나타내는 다이어그램과 구별해야 한다. 일반적으로 세로 방향으로 메시지의 순서를 읽지만 그림의 간격이 곧 실제 경과 시간을 뜻하는 것은 아니다. 별도의 시간 제약이 제시된 경우에만 구체적인 시간 조건을 해석한다.
선지별 해설
- 참여 객체 또는 역할 사이의 상호작용을 표현한다.
- 메시지의 전달 순서와 상호작용 흐름을 보여 준다.
- 정적 구조보다 행동·상호작용을 나타내므로 틀렸다.
- UML 상호작용 다이어그램의 한 종류다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §17 Interactions; Annex A, Figure A.5
17. 객체지향 분석 기법과 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 동적 모델링 기법을 사용할 수 있다.
- 객체의 상태와 책임은 고려하지 않고 기능을 순차 처리 단계로만 분해한다.
- 관련된 데이터와 행동을 객체 개념으로 묶고 추상화한다.
- 적절한 책임 분리와 추상화는 재사용과 변경 대응에 도움이 될 수 있다.
정답과 해설 보기
정답: 2
정답은 ②이다. 객체지향 분석에서는 문제 영역의 객체와 그 책임, 데이터와 행동, 객체 사이의 협력을 중심으로 요구를 이해한다. 기능을 순차 처리 단계로만 분해하고 객체의 상태와 책임을 고려하지 않는 설명은 이 관점에 맞지 않는다. 상태 변화나 상호작용을 나타내는 동적 모델도 활용할 수 있다. 객체지향 접근이 재사용과 변경 대응에 도움이 될 수 있지만 모든 경우에 생산성이 자동으로 높아지는 것은 아니다. 하향식 사고 자체를 객체지향에서 사용할 수 없다는 뜻도 아니다.
선지별 해설
- 객체의 상태 변화와 상호작용을 동적 모델로 표현할 수 있다.
- 객체의 상태와 책임을 배제하고 기능 분해만 사용하는 설명은 맞지 않는다.
- 문제 영역의 데이터와 행동을 관련된 객체 개념으로 묶어 이해한다.
- 적절한 책임 분리와 추상화는 재사용·변경 대응에 도움이 될 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §5.2 Function-Oriented (Structured) Design; §5.4 Object-Oriented Design; Dov Dori, On Bridging the Analysis–Design and Structure–Behavior Grand Canyons with Object Paradigms (1996), 저자 제공 원문 — p. 26, object and dynamic models
18. 대표적으로 DOS 및 Unix 등의 운영체제에서 조작을 위해 사용하던 것으로, 정해진 명령 문자열을 입력하여 시스템을 조작하는 사용자 인터페이스(User Interface)는?
- GUI(Graphical User Interface)
- CLI(Command Line Interface)
- CUI(Cell User Interface)
- MUI(Mobile User Interface)
정답과 해설 보기
정답: 2
정답은 ②이다. CLI는 사용자가 명령 이름과 인수 등으로 구성된 문자열을 입력하고 셸이나 명령 해석기가 이를 처리하는 인터페이스다. DOS 명령 프롬프트와 Unix 셸이 대표적인 예다. GUI는 창·아이콘·메뉴 같은 그래픽 요소를 이용한 조작에 초점을 둔다. CUI라는 약어가 다른 문맥에서 문자 기반 인터페이스를 가리키기도 하지만, 이 보기에는 Cell User Interface라는 다른 확장어가 제시되어 있다. 문항의 명령줄 입력이라는 핵심 조건은 Command Line Interface에 직접 대응한다.
선지별 해설
- GUI는 창·아이콘 등 그래픽 요소를 이용하는 인터페이스다.
- CLI는 명령 문자열을 입력하여 시스템을 조작하는 인터페이스다.
- 여기 제시한 Cell User Interface는 명령줄 인터페이스의 풀어쓴 이름이 아니다.
- 모바일이라는 사용 환경을 가리키는 표현만으로 명령줄 입력 방식을 뜻하지 않는다.
편집 해설 근거: POSIX.1-2024 Issue 8, Shell Command Language — Shell Introduction
19. 분산 시스템에서의 미들웨어(Middleware)와 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 분산된 구성 요소가 통신하고 데이터를 교환하도록 지원하는 소프트웨어다.
- 위치 투명성을 제공할 수 있다.
- 여러 구성 요소가 재사용할 수 있는 공통 서비스를 제공한다.
- 애플리케이션과 사용자 화면 사이에서만 분산 서비스를 제공한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 미들웨어는 분산된 애플리케이션이나 서비스가 통신하고 공통 기능을 이용하도록 중간 계층에서 지원하는 소프트웨어다. 메시지 전달·원격 호출·이름 해석·트랜잭션 관리 등이 그 예이며 사용자 화면과 애플리케이션 사이에만 놓이는 것은 아니다. 위치 투명성은 자원의 실제 위치를 사용 코드에서 감출 수 있게 하는 성질이다. 제공하는 투명성과 기능의 범위는 제품·프로토콜·설계에 따라 달라진다. 미들웨어를 사용했다고 모든 분산 처리의 복잡성이 없어지는 것도 아니다.
선지별 해설
- 서로 떨어진 구성 요소가 통신하고 자료를 교환하도록 지원할 수 있다.
- 자원의 실제 위치를 감추는 서비스를 제공할 수 있다.
- 여러 구성 요소에서 공통으로 활용하는 기능을 제공할 수 있다.
- 애플리케이션 사이, 서비스와 기반 시스템 사이 등에서도 사용되므로 틀렸다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 48 Distributed Systems — Communication Basics; Remote Procedure Call; Tanenbaum·van Steen, Distributed Systems 2판, 저자 공개 해답 Chapter 1 — Distribution transparency
20. 소프트웨어 아키텍처와 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 파이프-필터 구조에서 자료는 항상 양방향으로 흐르고 전달 오버헤드는 전혀 없다.
- 주요 구성 요소와 관계 등 외부에서 이해할 수 있는 기본 구조를 나타낸다.
- 데이터 중심 구조는 공유 저장소를 통해 구성 요소들이 자료를 교환할 수 있다.
- 이해관계자의 품질 요구사항을 아키텍처 결정에 반영한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 파이프-필터 구조에서는 각 필터가 입력을 처리해 출력을 만들고 파이프가 이를 다음 처리 단계로 전달한다. 이 구조의 자료 흐름을 항상 양방향이라고 하거나 단계 사이의 전달 비용이 전혀 없다고 할 수 없다. 직렬화·버퍼링·통신 등의 비용을 검토해야 한다. 아키텍처는 시스템의 주요 구성과 관계, 설계 결정을 나타내며 이해관계자의 품질 요구도 고려한다. 공유 저장소를 사용하는 구조에서도 저장 형식이나 인터페이스 변경은 여러 접근자에게 영향을 줄 수 있다.
선지별 해설
- 자료는 처리 흐름에 따라 전달되며 전달 오버헤드가 0이라는 보장은 없다.
- 시스템의 주요 구성 요소와 관계를 정하는 기본 구조다.
- 데이터 중심 구조는 공유 저장소를 매개로 자료를 교환할 수 있다.
- 성능·보안·변경 용이성 등 품질 요구를 아키텍처 결정에 반영한다.
편집 해설 근거: Microsoft Azure Architecture Center, Pipes and Filters pattern (2026-10-05 확인) — Solution; Issues and considerations; IEEE Computer Society, SWEBOK Guide V4.0a — Software Architecture §1 Software Architecture Fundamentals
정보처리기사 필기 기출문제 · 소프트웨어 개발
21. 테스트를 목적에 따라 분류했을 때, 강도(Stress) 테스트에 대한 설명으로 옳은 것은?
[학습용 개정문항]
- 고의로 장애를 유도한 뒤 시스템이 정상 상태로 복구되는지 확인한다.
- 정상 예상 수준이나 설계 용량을 넘는 부하를 가해 시스템의 한계와 동작을 확인한다.
- 응답시간과 처리량 등 시스템의 성능 특성을 측정한다.
- 허가되지 않은 침입 시도에 대한 방어 능력을 확인한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 스트레스 테스트는 정상적으로 예상하는 수준이나 설계 용량을 넘는 부하를 가해 시스템의 한계와 한계 초과 시 동작을 확인한다. 오류 처리, 자원 고갈, 서비스 저하와 복구 가능성 등을 관찰할 수 있다. 목적은 어떤 과부하에서도 반드시 정상 응답해야 한다고 요구하는 것이 아니다. 고의로 장애를 일으켜 복구를 확인하는 시험, 응답시간·처리량을 측정하는 성능 시험, 침입에 대한 방어를 평가하는 보안 시험과는 주된 관심 대상이 다르다.
선지별 해설
- 장애 뒤 정상 상태로 돌아오는 능력을 보는 복구 시험의 설명이다.
- 예상 용량을 넘는 부하에서 한계와 동작을 확인하는 스트레스 시험이다.
- 응답시간·처리량 등 성능 특성을 측정하는 시험의 설명이다.
- 불법적인 접근에 대한 방어 능력을 평가하는 보안 시험의 설명이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Testing §2.2.7 Non-functional Testing — Stress Testing
22. 그림의 자료를 오름차순 버블 정렬한다. 각 PASS에서 왼쪽부터 인접한 두 값을 비교·교환하여 미정렬 구간의 최댓값을 오른쪽 끝에 놓을 때, PASS 3을 마친 결과는?
[학습용 개정문항]
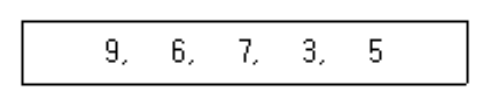
- 6, 3, 5, 7, 9
- 3, 5, 6, 7, 9
- 6, 7, 3, 5, 9
- 3, 5, 9, 6, 7
정답과 해설 보기
정답: 2
정답은 ②이다. 왼쪽부터 인접한 두 값을 비교하여 큰 값을 오른쪽으로 보내는 버블 정렬을 적용한다. 처음 9, 6, 7, 3, 5에서 첫 회전 결과는 6, 7, 3, 5, 9이며 최댓값 9가 마지막에 놓인다. 두 번째 회전에서는 6, 3, 5, 7, 9가 되고 세 번째 회전에서는 3, 5, 6, 7, 9가 된다. 한 번의 비교·교환과 전체 구간을 훑는 한 회전은 다르다. 비교 방향이 반대인 구현도 있으므로 이 문항은 왼쪽에서 오른쪽으로 진행하는 조건을 명시했다.
선지별 해설
- 왼쪽에서 오른쪽으로 진행한 두 번째 회전의 결과다.
- 세 번째 회전을 마친 결과이며 이 시점에 전체가 오름차순이다.
- 첫 번째 회전을 마친 결과다.
- 제시한 방향의 세 번째 회전 결과와 다르다.
편집 해설 근거: NIST DADS — bubble sort — Definition
23. 그림의 무방향 그래프에서 A부터 깊이우선탐색(DFS)을 수행한다. 인접 정점을 고르는 순서는 자유로울 때, 다음 중 가능한 최초 방문 순서는?
[학습용 개정문항]
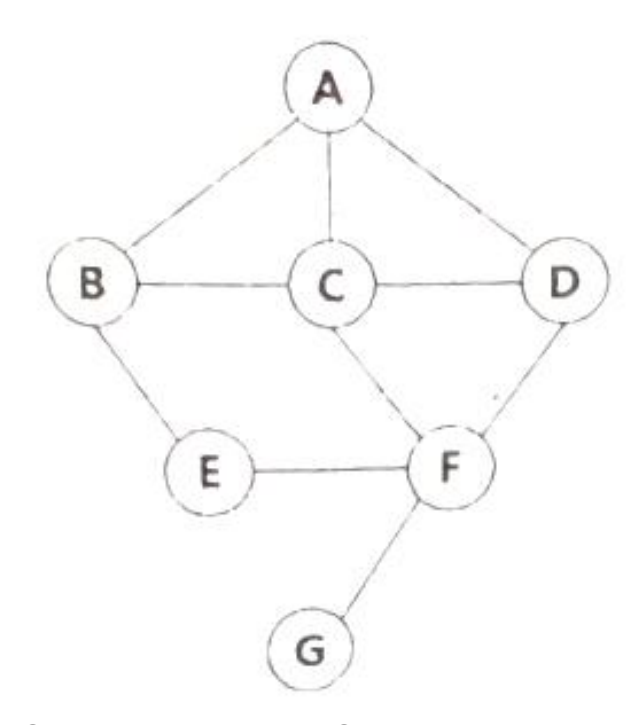
- ABECDFG
- ABECFDG
- ABCDEFG
- ABEFGCD
정답과 해설 보기
정답: 4
정답은 ④이다. 깊이우선탐색은 현재 정점에서 아직 방문하지 않은 이웃이 있으면 그 이웃으로 더 들어가고, 없을 때 이전 정점으로 되돌아간다. A→B→E→F→G까지 진행한 뒤 G에서 F로 되돌아와 C→D를 방문하면 ABEFGCD가 된다. E에는 아직 방문하지 않은 F가 있으므로 ABE 다음에 C로 바로 돌아가는 ①·②는 이 절차에 맞지 않는다. ③도 D에서 방문하지 않은 이웃 F를 두고 E로 넘어간다. 이웃을 고르는 순서가 정해지지 않았으므로 전체 DFS 순서가 하나뿐이라고 단정하지 않는다.
선지별 해설
- E에서 미방문 이웃 F를 먼저 처리해야 하므로 ABEC로 이어질 수 없다.
- E의 미방문 이웃 F를 두고 C로 되돌아가므로 가능하지 않다.
- D에서 미방문 이웃 F를 두고 E를 방문하는 흐름이 맞지 않는다.
- G에서 F로 되돌아온 뒤 C와 D를 방문하면 가능한 순서다.
편집 해설 근거: NIST DADS — depth-first search — Definition
24. 다음 설명에 부합하는 용어로 옳은 것은?
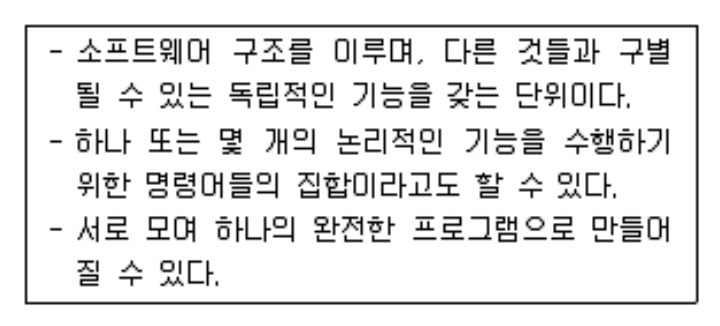
- 통합 프로그램
- 저장소
- 모듈
- 데이터
정답과 해설 보기
정답: 3
정답은 ③이다. 모듈은 프로그램을 이해하고 구현·시험·변경하기 쉽도록 기능이나 책임에 따라 나눈 구성 단위다. 외부에서 사용하는 인터페이스와 내부 구현을 구분하면 다른 부분이 구현 세부 사항에 직접 의존하는 것을 줄일 수 있다. 원본 설명의 전체 프로그램을 이루는 독립적인 단위라는 단서가 모듈에 해당한다. 여기서 독립적이라는 말은 다른 구성 요소와 전혀 연결되지 않는다는 뜻이 아니다. 잘 정의된 인터페이스로 필요한 정보와 제어를 교환할 수 있다.
선지별 해설
- 여러 부분을 합친 전체 프로그램을 뜻하므로 분할된 구성 단위라는 단서와 다르다.
- 자료나 산출물을 보관하는 장소이며 기능·책임 단위의 명칭이 아니다.
- 프로그램을 기능이나 책임에 따라 분리한 구성 단위다.
- 처리 대상인 값이나 정보이며 프로그램 구성 단위 자체와 다르다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Modularization
25. 테스트 드라이버(Test Driver)에 대한 설명으로 틀린 것은?
- 시험대상 모듈을 호출하는 간이 소프트웨어이다.
- 필요에 따라 매개변수를 전달하고 모듈을 수행한 후의 결과를 보여줄 수 있다.
- 상향식 통합 테스트에서 사용된다.
- 테스트 대상 모듈이 호출하는 하위 모듈의 역할을 한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 테스트 드라이버는 시험 대상 모듈을 호출하고 필요한 입력이나 매개변수를 전달하며 실행 결과를 확인하도록 돕는 시험용 코드다. 상위 호출 모듈이 아직 준비되지 않은 상향식 통합 시험에서 활용할 수 있다. 반대로 시험 대상이 호출해야 하는 하위 모듈을 대신하는 코드는 스텁이다. 호출하는 쪽을 대신하는지 호출받는 쪽을 대신하는지를 그려 보면 구분하기 쉽다. 드라이버와 스텁은 시험을 지원하는 역할이며 자체로 결함이 없음을 보장하지는 않는다.
선지별 해설
- 드라이버는 시험 대상 모듈을 호출한다.
- 입력을 전달하고 반환값이나 결과를 관찰할 수 있다.
- 상위 호출 부분을 대신하여 상향식 통합을 지원할 수 있다.
- 하위 피호출 모듈을 대신하는 것은 스텁의 역할이다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — Entries: test driver; test stub; ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §2.2.2 Integration Testing
26. 다음 중 선형 구조로만 묶인 것은?
- 스택, 트리
- 큐, 데크
- 큐, 그래프
- 리스트, 그래프
정답과 해설 보기
정답: 2
정답은 ②이다. 선형 자료 구조는 원소들을 일렬의 순서 관계로 다루는 구조다. 큐는 먼저 들어온 원소를 먼저 꺼내는 FIFO 구조이고 데크는 양쪽 끝에서 삽입·삭제할 수 있는 선형 구조다. 스택과 리스트도 선형 구조에 속하지만 트리와 그래프는 분기나 일반적인 연결 관계를 표현하는 비선형 구조다. 따라서 두 항목이 모두 선형인 묶음은 큐와 데크뿐이다. 배열과 연결 노드 중 무엇으로 구현했는지가 이 추상적인 분류를 바꾸지는 않는다.
선지별 해설
- 스택은 선형이지만 트리는 비선형 구조다.
- 큐와 양쪽 끝을 사용하는 데크는 모두 선형 자료 구조다.
- 큐는 선형이지만 그래프는 비선형 구조다.
- 리스트는 선형이지만 그래프는 비선형 구조다.
편집 해설 근거: NIST DADS — queue — Definition; NIST DADS, deque — Definition; NIST DADS, tree — Definition
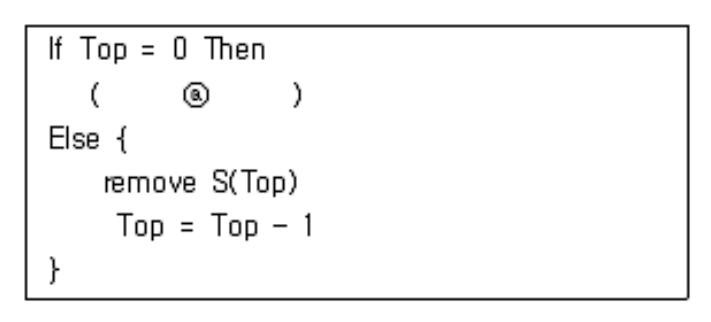
27. 그림은 스택의 자료 삭제 알고리즘이다. Top은 현재 원소 수이며 Top=0이면 빈 스택이다. S가 스택일 때 ⓐ에 들어갈 오류 처리는?
[학습용 개정문항]
- Overflow
- Top = Top + 1
- Underflow
- Top = Top
정답과 해설 보기
정답: 3
정답은 ③이다. 이 알고리즘은 Top을 스택에 들어 있는 원소 수로 사용하므로 Top=0이면 꺼낼 원소가 없는 빈 상태다. 이때 삭제를 시도하면 언더플로를 처리해야 한다. 원소가 있으면 꼭대기의 값을 꺼내고 Top을 하나 줄이는 정상 삭제 경로로 진행한다. 오버플로는 저장 용량이 제한된 스택에 더 넣으려 할 때 발생하는 문제이므로 방향이 반대다. Top을 0부터 시작하는 배열 인덱스로 정의한 다른 구현에서는 빈 상태 표시가 다를 수 있으므로 이 문항의 정의를 따라야 한다.
선지별 해설
- Overflow는 가득 찬 스택에 삽입하려는 경우의 오류다.
- Top 증가는 삭제의 빈 상태 처리와 맞지 않는다.
- 빈 스택에서 삭제를 시도했으므로 Underflow다.
- 아무 변화 없이 두는 것만으로 빈 스택 삭제 오류를 나타내지 못한다.
편집 해설 근거: NIST DADS, stack — Definition; push and pop
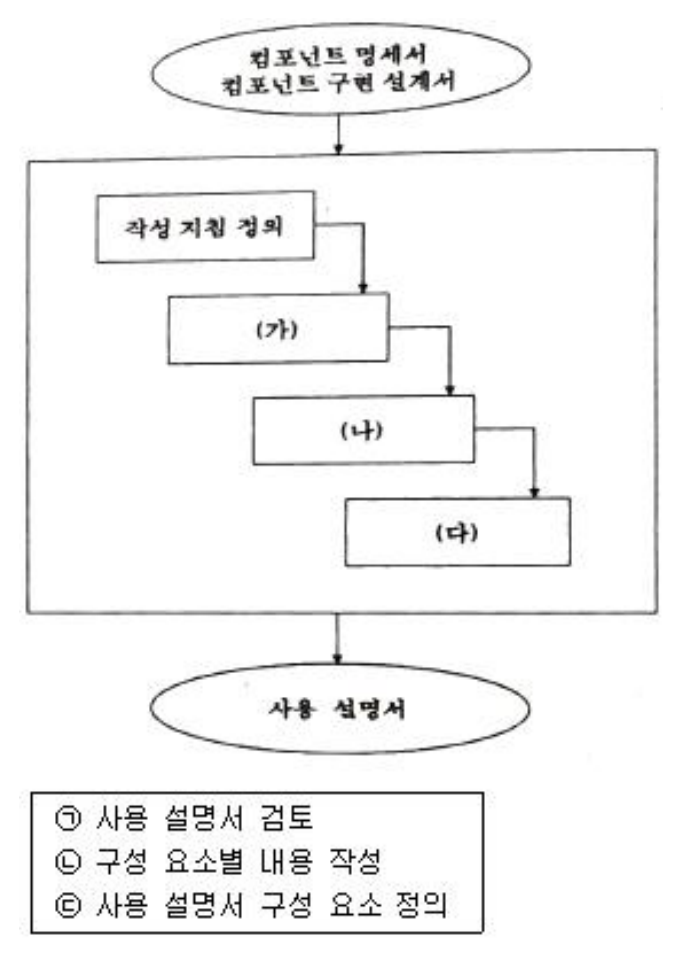
28. 이 문항에서는 매뉴얼의 목표를 정한 뒤, 구성 요소를 정하고 그에 맞는 내용을 작성한 후 검토하는 절차를 따른다. 그림의 (가)~(다)와 [보기]의 기호를 바르게 연결한 것은?
[학습용 개정문항]
- (가)-㉠, (나)-㉡, (다)-㉢
- (가)-㉢, (나)-㉡, (다)-㉠
- (가)-㉠, (나)-㉢, (다)-㉡
- (가)-㉢, (나)-㉠, (다)-㉡
정답과 해설 보기
정답: 2
정답은 ②이다. 이 문항의 절차는 사용자 매뉴얼의 목표를 정한 다음 필요한 구성 요소를 정의하고, 그 구성에 맞춰 내용을 작성한 뒤 검토하는 순서다. 따라서 (가)는 구성 요소 정의인 ㉢, (나)는 구성 요소별 내용 작성인 ㉡, (다)는 검토인 ㉠으로 연결된다. 독자와 범위에 맞는 구성을 먼저 잡으면 필요한 정보를 빠뜨리지 않고 작성하는 데 도움이 된다. 실제 문서 작업에서는 검토 결과에 따라 구성과 내용을 다시 수정할 수 있으며 모든 작성 활동이 한 번씩만 일어나는 것은 아니다.
선지별 해설
- 검토를 구성과 내용 작성보다 앞의 최종 단계처럼 배치하므로 정해진 절차와 다르다.
- 구성 요소 정의→내용 작성→검토에 맞는 연결이다.
- 구성 요소를 정의하기 전에 검토를 먼저 배치한다.
- 내용을 작성하기 전에 최종 검토를 배치하므로 정해진 절차와 다르다.
편집 해설 근거: Google Technical Writing One, Documents — State your document’s scope; State your audience; Organize the document to meet your audience’s needs
29. A, B, C, D 순서를 지켜 각 원소를 스택에 한 번씩 push한다. push 사이에 pop을 자유롭게 섞을 수 있을 때, 다음 중 불가능한 pop 결과는?
[학습용 개정문항]
- D, C, B, A
- B, C, D, A
- C, B, A, D
- D, B, C, A
정답과 해설 보기
정답: 4
정답은 ④이다. A, B, C, D 순서로 넣되 중간에 꺼내는 동작을 섞을 수 있다고 생각한다. D를 가장 먼저 꺼내려면 네 원소를 모두 넣어야 하므로 그 뒤 스택 꼭대기는 C다. 따라서 D 다음에 B를 꺼내는 DBCA는 불가능하다. DCBA는 모두 넣은 뒤 연속으로 꺼내면 된다. BCDA는 A와 B를 넣고 B를 꺼낸 뒤 C, D를 각각 넣었다 꺼내면 되며, CBAD는 A·B·C를 넣고 C·B·A를 꺼낸 뒤 D를 넣었다 꺼내면 된다.
선지별 해설
- 네 원소를 모두 넣은 뒤 순서대로 꺼내면 DCBA가 된다.
- B, C, D를 차례로 꺼내면서 A를 바닥에 남겨 두면 가능하다.
- A·B·C를 넣고 C·B·A를 꺼낸 후 D를 처리하면 가능하다.
- D를 먼저 꺼낸 뒤에는 C가 꼭대기이므로 B를 바로 꺼낼 수 없다.
편집 해설 근거: NIST DADS, stack — Definition
30. 소프트웨어 테스트에서 검증(Verification)과 확인(Validation)에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 검증과 확인을 구별하면 명세 충족과 사용 적합성의 문제를 나누어 검토하는 데 도움이 된다.
- 검증과 확인은 개발 생명주기의 여러 단계와 산출물에 적용할 수 있다.
- 검증은 산출물이 명시된 기능·비기능 요구사항을 충족하는지 확인한다.
- 검증은 실제 사용자 요구에 대한 적합성만 확인하고, 확인은 개발자의 기대만 충족하는지 측정한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 검증은 산출물이 명시된 요구나 명세를 충족하는지 확인하는 활동이고, 확인은 의도한 사용 환경과 실제 사용자의 필요에 적합한지 판단하는 활동이다. 따라서 검증을 사용자 적합성으로, 확인을 개발자의 기대 충족으로 바꾸어 놓은 ④는 틀렸다. 두 활동은 개발 전 과정에서 여러 산출물에 적용될 수 있다. 검증은 과정만, 확인은 완성된 결과만 검사한다고 이분법적으로 외우면 안 된다. 명세에 맞게 구현했어도 명세 자체가 실제 필요와 어긋나면 사용 목적을 만족하지 못할 수 있다.
선지별 해설
- 명세 충족과 실제 사용 적합성의 관점을 구분하는 데 도움이 된다.
- 두 활동은 여러 생명주기 단계와 산출물에 적용할 수 있다.
- 검증은 기능·품질 등을 포함한 명시된 요구 충족을 확인한다.
- 검증·확인의 목적을 뒤바꾸고 확인을 개발자 기대만으로 제한했으므로 틀렸다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — Entries: verification; validation; ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §1.1 What is Testing?
31. 개별 모듈을 시험하는 것으로, 모듈이 정확하게 구현되었는지, 예정한 기능이 제대로 수행되는지를 점검하는 것이 주목적인 테스트는?
- 통합 테스트(Integration Test)
- 단위 테스트(UnitTest)
- 시스템 테스트(System Test)
- 인수 테스트(Acceptance Test)
정답과 해설 보기
정답: 2
정답은 ②이다. 단위 테스트는 개별 함수·클래스·모듈 같은 작은 구성 단위가 정해진 계약과 요구에 맞게 동작하는지 확인한다. 필요하면 주변 의존성을 드라이버나 스텁 등으로 대체하여 대상의 동작을 집중적으로 관찰할 수 있다. 통합 테스트는 여러 구성 요소가 연결될 때의 인터페이스와 상호작용을, 시스템 테스트는 완성된 시스템 전체를 평가한다. 인수 테스트는 사용 또는 인도에 필요한 수용 기준을 확인한다. 단위가 무엇인지는 시스템의 구조와 시험 범위에 따라 정한다.
선지별 해설
- 연결된 구성 요소 사이의 상호작용을 확인하는 수준이다.
- 개별 모듈의 구현과 기능을 확인하는 단위 수준의 시험이다.
- 전체 시스템의 기능과 품질을 평가하는 수준이다.
- 사용자·고객 등이 정한 수용 기준의 충족 여부를 확인하는 수준이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §2.2 Test Levels; §2.2.1 Component Testing
32. 형상 관리의 개념과 절차에 대한 설명으로 틀린 것은?
- 형상 식별은 형상 관리 계획을 근거로 형상관리의 대상이 무엇인지 식별하는 과정이다.
- 형상 관리를 통해 가시성과 추적성을 보장함으로써 소프트웨어의 생산성과 품질을 높일 수 있다.
- 형상 통제 과정에서는 형상 목록의 변경 요구를 즉시 수용 및 반영해야 한다.
- 형상 감사는 형상 관리 계획대로 형상 관리가 진행되고 있는지, 형상 항목의 변경이 요구 사항에 맞도록 제대로 이뤄졌는지 등을 살펴보는 활동이다.
정답과 해설 보기
정답: 3
정답은 ③이다. 형상 통제는 변경 요청을 기록하고 영향·비용·필요성을 평가한 뒤 권한 있는 절차에 따라 승인하거나 반려하고, 승인된 변경의 구현과 확인을 관리한다. 요청이 왔다는 이유만으로 즉시 모두 반영하면 기준선과 추적성을 유지하기 어렵다. 형상 식별은 관리할 항목과 버전·기준선을 정하는 활동이며, 상태 기록은 변경 상황을 추적하도록 돕는다. 형상 감사는 항목과 기록이 요구 및 승인된 내용에 부합하는지 확인한다. 변경을 무조건 막는 것 역시 형상 통제의 목적은 아니다.
선지별 해설
- 관리 대상과 식별 방법을 정하는 형상 식별의 설명이다.
- 가시성과 추적성을 유지하면 변경 관리와 품질 확보에 도움이 된다.
- 변경 요청은 평가와 승인 절차를 거쳐야 하므로 즉시 모두 수용하지 않는다.
- 계획·요구·승인 내용과 실제 형상 사이의 부합 여부를 살핀다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Configuration Management §2 Software Configuration Identification; §3.1 Requesting, Evaluating, and Approving Software Changes; §5 Software Configuration Auditing
33. 소스 코드 정적 분석(Static Analysis)에 대한 설명으로 틀린 것은?
- 소스 코드를 실행하지 않고 분석한다.
- 코드의 오류와 잠재적인 결함을 찾는 데 활용한다.
- 하드웨어적인 방법으로만 코드 분석이 가능하다.
- 자료 흐름과 제어 흐름에서 비정상적인 패턴을 찾을 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 정적 분석은 대상 프로그램을 실제로 실행하지 않고 소스 코드나 다른 표현을 분석하여 규칙 위반과 잠재적 결함을 찾는 기법이다. 자료 흐름·제어 흐름 분석, 형식 검사 등 다양한 소프트웨어 도구와 분석 방법을 사용할 수 있으므로 하드웨어 방식으로만 가능하다는 설명은 틀렸다. 도달할 수 없는 코드나 초기화하지 않은 값의 사용 같은 문제를 발견하는 데 도움이 된다. 다만 도구가 보고한 모든 항목이 실제 장애라는 뜻은 아니며 분석의 한계와 오탐 가능성을 검토해야 한다.
선지별 해설
- 대상 프로그램을 실행해 결과를 관찰하는 동적 시험과 구별된다.
- 결함과 규칙 위반의 조기 발견에 활용한다.
- 소프트웨어 정적 분석 도구로 수행할 수 있으므로 틀렸다.
- 프로그램의 흐름을 분석하여 의심스러운 사용과 경로를 찾을 수 있다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §3.1 Static Testing Basics; Cppcheck 공식 저장소, 프로젝트 소개 — Introduction
34. 사람의 실수로 소프트웨어 산출물에 들어가며, 실행 중 특정 조건에서 장애(Failure)를 일으킬 수 있는 결함을 뜻하는 용어는?
[학습용 개정문항]
- Fault
- Test case
- Mistake
- Inspection
정답과 해설 보기
정답: 1
정답은 ①이다. 사람이 작업 중에 하는 실수는 오류 또는 mistake라고 표현할 수 있고, 그 결과 요구 명세나 설계·코드에 잘못된 내용이 들어가면 결함인 defect 또는 fault가 된다. 실행 중 그 결함이 특정 조건에서 드러나 기대한 기능을 수행하지 못하면 장애 또는 failure로 관찰될 수 있다. 결함이 있다고 모든 실행에서 반드시 장애가 발생하는 것은 아니다. 테스트 케이스는 시험 조건과 입력·기대 결과 등을 정한 것이고 인스펙션은 결함을 찾기 위한 검토 활동이다.
선지별 해설
- 산출물 안에 존재하며 실행 시 장애의 원인이 될 수 있는 결함이다.
- 시험 입력·조건·기대 결과 등을 정한 시험 명세다.
- 잘못된 결과를 낳을 수 있는 사람의 실수에 해당한다.
- 결함을 발견하기 위한 체계적인 검토 활동이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §1.2.3 Errors, Defects, and Failures; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — Entries: fault; failure; error
35. 코드의 간결성을 유지하기 위해 사용되는 지침으로 틀린 것은?
- 공백을 이용하여 실행문 그룹과 주석을 명확히 구분한다.
- 복잡한 논리식과 산술식은 괄호와 들여쓰기(Indentation)를 통해 명확히 표현한다.
- 빈 줄을 사용하여 선언부와 구현부를 구별한다.
- 한 줄에 최대한 많은 문장을 코딩한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 간결한 코드는 적은 줄 수만을 뜻하지 않고 의도와 흐름을 불필요한 복잡함 없이 이해할 수 있는 코드를 뜻한다. 한 줄에 가능한 한 많은 문장을 몰아넣으면 읽기·수정·오류 위치 확인이 어려워질 수 있다. 공백과 빈 줄은 관련된 구문을 묶고 다른 역할의 구간을 구분하는 데 사용한다. 복잡한 식은 적절한 괄호나 중간 변수로 의미를 드러내고 들여쓰기로 구조를 표현할 수 있다. 구체적인 형식은 해당 언어와 팀의 일관된 스타일 규칙을 따른다.
선지별 해설
- 관련된 실행문과 주석의 구역을 식별하는 데 도움이 된다.
- 논리 관계와 구문의 계층을 읽기 쉽게 표현할 수 있다.
- 서로 다른 역할의 구간을 시각적으로 구분할 수 있다.
- 줄 수를 줄이려고 문장을 과도하게 몰아넣으면 가독성을 해친다.
편집 해설 근거: Google Engineering Practices, What to look for in a code review — Complexity; Style; Comments
36. ISO/IEC 25010:2011의 품질 용어를 기준으로, 소프트웨어를 다른 하드웨어·소프트웨어 환경으로 이전하고 적응시키기 쉬운 정도에 해당하는 것은?
[학습용 개정문항]
- Portability
- Efficiency
- Usability
- Correctness
정답과 해설 보기
정답: 1
정답은 ①이다. 이식성은 소프트웨어를 한 하드웨어·소프트웨어 환경에서 다른 환경으로 옮겨 활용할 수 있는 정도다. 제시한 구판 품질 모델에서는 적응성·설치성·대체성 등이 관련된다. 새 운영체제나 장치에 맞추기 위해 얼마나 쉽게 적응시킬 수 있는지가 대표적인 판단 대상이다. 효율성은 자원과 성능, 사용성은 사용자의 목표 달성 경험, 정확성은 요구된 결과와의 부합에 초점을 둔다. 품질 모델의 항목과 이름은 판에 따라 달라질 수 있으므로 여기서는 명시된 2011년판의 이식성을 기준으로 답한다.
선지별 해설
- 다른 하드웨어·소프트웨어 환경으로 이전하고 적응시키는 이식성이다.
- 효율성은 주로 성능과 자원 사용의 관계에 관한 성질이다.
- 사용성은 사용자가 효과적이고 편리하게 사용할 수 있는 정도다.
- 정확성은 요구된 기능·결과에 맞게 동작하는 성질이다.
편집 해설 근거: ISO/IEC 25010:2011, Software quality model (문항에 명시한 구판) — §4.2.8 Portability; §4.2.8.1 Adaptability
37. 같은 수 n개의 키를 저장한다. 다음 중 최악의 경우 키 검색 시간 복잡도가 가장 나쁜 것은?
[학습용 개정문항]
- 자동 균형 유지가 없는 일반 이진 탐색 트리
- AVL 트리
- 2-3 트리
- 레드-블랙 트리
정답과 해설 보기
정답: 1
정답은 ①이다. 균형을 유지하지 않는 이진 탐색 트리는 정렬된 값이 차례로 삽입되는 등의 경우 한쪽으로 길게 치우칠 수 있다. 원소가 n개라면 높이가 n에 비례하여 최악의 검색에 O(n) 비교가 필요할 수 있다. AVL 트리·2-3 트리·레드-블랙 트리는 각각의 균형 조건으로 높이가 O(log n)이 되도록 유지하므로 최악의 검색도 O(log n)이다. 일반 이진 탐색 트리도 우연히 균형 잡힌 상태라면 빠를 수 있지만 이 문항은 평균이나 좋은 경우가 아니라 최악의 경우를 묻는다.
선지별 해설
- 자동 균형 유지가 없으면 편향되어 최악의 검색 시간이 O(n)이 될 수 있다.
- AVL의 높이 균형 조건으로 최악의 검색은 O(log n)이다.
- 2-3 트리는 균형을 유지하여 최악의 검색이 O(log n)이다.
- 레드-블랙 균형 조건으로 최악의 검색이 O(log n)이다.
편집 해설 근거: NIST DADS — binary search tree — Definition; NIST DADS, AVL tree — Definition; NIST DADS, red-black tree — Definition; NIST DADS, B-tree — Definition; Specialization — 2-3 tree
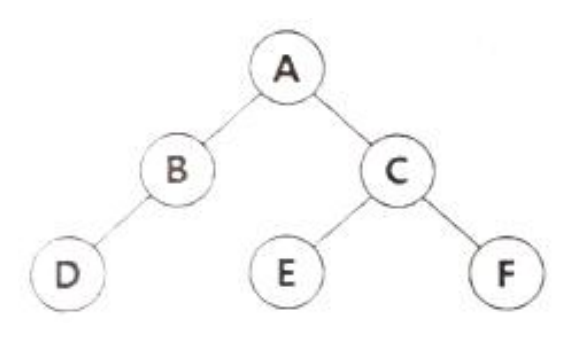
38. 다음 트리에 대한 중위 순회 운행 결과는?
- ABDCEF
- ABCDEF
- DBECFA
- DBAECF
정답과 해설 보기
정답: 4
정답은 ④이다. 중위 순회는 각 노드에서 왼쪽 서브트리, 현재 노드, 오른쪽 서브트리 순서로 방문한다. 그림의 루트 A에서는 먼저 B를 루트로 하는 왼쪽 부분을 순회하므로 D 다음 B를 방문한다. 이어 A를 방문하고, 오른쪽 C 부분에서는 E, C, F 순서로 방문한다. 이를 합치면 D-B-A-E-C-F다. ABDCEF는 루트를 먼저 방문하는 전위 순회와 대응하며, 중위 순회는 단순히 그림을 위에서 아래로 또는 알파벳순으로 읽는 절차가 아니다.
선지별 해설
- 루트를 먼저 방문하는 전위 순회 결과다.
- 중위 순회의 왼쪽 부분 방문 순서를 따르지 않는다.
- 왼쪽 부분 D·B 다음에는 루트 A가 와야 하는데 이를 끝으로 미루어 중위 순회가 아니다.
- 왼쪽 D·B, 루트 A, 오른쪽 E·C·F 순서다.
편집 해설 근거: NIST DADS, inorder traversal — Definition
39. 테스트 케이스 자동 생성 도구를 이용하여 테스트 데이터를 찾아내는 방법이 아닌 것은?
[학습용 개정문항]
- 스텁과 드라이버라는 시험 지원 코드 자체
- 입력 도메인을 분석하여 대표 입력을 선택
- 입력 공간에서 무작위 테스트 데이터를 생성
- 프로그램의 자료 흐름을 분석하여 경로를 실행할 입력을 생성
정답과 해설 보기
정답: 1
정답은 ①이다. 테스트 데이터 생성은 입력 공간을 나누어 대표값을 고르거나 무작위로 값을 만들거나 프로그램의 자료 정의·사용 관계를 분석하여 필요한 경로를 실행할 값을 찾는 방식으로 수행할 수 있다. 스텁과 드라이버는 실행 환경의 일부를 대신하거나 시험 대상을 호출하는 지원 코드이므로 그 자체가 입력값을 선정하는 분석 방법의 이름은 아니다. 드라이버 안에 생성기를 넣는 구현은 가능하지만 두 역할을 구별해야 한다. 단순한 업무 자료 흐름도와 코드의 자료 흐름 분석도 같은 뜻이 아니다.
선지별 해설
- 시험을 지원하는 대역·호출 코드이며 그 자체가 데이터 선정 분석법은 아니다.
- 입력 영역을 구분하여 대표값이나 경계값 등을 선택할 수 있다.
- 입력 공간에서 무작위로 시험값을 생성할 수 있다.
- 변수의 정의·사용 관계를 분석하여 필요한 실행 경로의 입력을 찾을 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Testing §3.1 Specification-Based Techniques; §3.2.2 Data Flow Testing; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — Entries: test driver; test stub; random testing
40. 저작권 관리 구성 요소 중 패키저(Packager)의 주요 역할로 옳은 것은?
- 콘텐츠를 제공하는 저작권자를 의미한다.
- 콘텐츠를 메타 데이터와 함께 배포 가능한 단위로 묶는다.
- 라이선스를 발급하고 관리한다.
- 배포된 콘텐츠의 이용 권한을 통제한다.
정답과 해설 보기
정답: 2
정답은 ②이다. DRM의 패키징은 콘텐츠를 배포와 보호에 필요한 형태로 가공하고 관련 메타데이터와 결합하는 과정이다. 사용 방식에 따라 암호화나 콘텐츠 식별자·라이선스 취득 정보의 포함 등이 이루어질 수 있다. 콘텐츠 소유자는 권리를 가진 주체이고 라이선스 서버는 사용 조건과 키 등 권한 정보를 전달한다. 이용 권한을 실제로 집행하는 클라이언트 기능도 패키징 작업과 구별된다. 모든 DRM 구현의 세부 구성 요소 이름이 같지는 않으므로 문항이 묻는 역할을 기준으로 판단한다.
선지별 해설
- 콘텐츠 소유자 또는 제공자의 역할이다.
- 콘텐츠와 관련 정보를 배포 가능한 보호 단위로 구성하는 패키저의 역할이다.
- 라이선스 발급·관리 기능의 역할이다.
- 클라이언트 등에서 권한 조건을 집행하는 기능의 역할이다.
편집 해설 근거: Microsoft PlayReady, Content Packaging and Delivery — Content Packaging and Delivery; Open Mobile Alliance, DRM Content Format 2.1 (2008-10-14) — DRM Content Format — Content and metadata
정보처리기사 필기 기출문제 · 데이터베이스 구축
41. 데이터베이스의 무결성 규정(Integrity Rule)과 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 무결성 제약은 데이터가 만족해야 하는 조건과 제약 이름을 포함할 수 있다.
- 허용 값의 범위, 키의 유일성, 참조 관계 등이 무결성 제약의 대상이다.
- 무결성 제약은 불법적인 사용자 접근 권한만 통제하는 규정이다.
- 자료 삽입·수정·삭제 후에도 정해진 의미적 조건을 유지하도록 제한한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 무결성 제약은 저장되는 자료가 업무 규칙과 데이터 모델의 조건을 만족하도록 제한하는 규칙이다. 값의 허용 범위, 키의 유일성, 참조 대상의 존재, 값 사이의 관계 등이 그 예다. 누가 데이터를 읽거나 바꿀 수 있는지 정하는 접근 권한과는 구별된다. 정당한 권한을 가진 사용자가 잘못된 값을 입력할 수도 있으므로 권한 검사만으로 무결성이 확보되지는 않는다. 제약에 이름을 부여하면 위반 원인을 확인하거나 제약을 관리하는 데 도움이 된다.
선지별 해설
- 제약 조건과 이를 식별하는 이름 등을 정의할 수 있다.
- 값의 범위·키·참조 관계 등 데이터가 만족해야 하는 조건을 다룬다.
- 무결성 제약을 사용자 접근 권한 규정으로만 설명했으므로 틀렸다.
- 자료를 변경해도 정해진 의미적 조건이 유지되도록 제한한다.
편집 해설 근거: PostgreSQL 18 — Constraints — Constraints — Check; Not-Null; Unique; Primary Keys; Foreign Keys
42. 데이터베이스에서 하나의 논리적 기능을 수행하기 위한 작업의 단위 또는 한꺼번에 모두 수행되어야 할 일련의 연산들을 의미하는 것은?
- 트랜잭션
- 뷰
- 튜플
- 카디널리티
정답과 해설 보기
정답: 1
정답은 ①이다. 트랜잭션은 여러 데이터베이스 작업을 하나의 논리적인 단위로 묶는 개념이다. 계좌 이체에서 출금과 입금을 하나로 묶어 둘 다 반영되거나 둘 다 취소되게 하는 것이 대표적이다. 이때 원자성은 중간 일부만 완료된 상태를 확정하지 않는 성질을 뜻한다. 뷰는 질의로 정의한 가상 테이블이고 튜플은 관계의 한 행이며 카디널리티는 보통 관계에 들어 있는 행의 수다. 트랜잭션의 연산이 물리적으로 같은 순간에 실행되어야 한다는 의미는 아니다.
선지별 해설
- 관련 연산들을 하나의 논리적인 실행·완료 단위로 묶는다.
- 질의 결과로 정의한 가상 테이블이다.
- 관계를 구성하는 개별 행이다.
- 관계에 포함된 튜플의 수를 나타낸다.
편집 해설 근거: PostgreSQL 18, 3.4 Transactions — Transactions; Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relational Model — relation, tuple, cardinality
43. 한 열로 된 두 관계가 R1(학번) = {(1), (2), (3)}, R2(학과) = {(컴퓨터), (국문), (수학)}일 때, R1 × R2의 카티션 프로덕트 결과는?
[학습용 개정문항]
- {(1, 컴퓨터), (2, 국문), (3, 수학)}
- {(2, 컴퓨터), (2, 국문), (2, 수학)}
- {(3, 컴퓨터), (3, 국문), (3, 수학)}
- {(1, 컴퓨터), (1, 국문), (1, 수학), (2, 컴퓨터), (2, 국문), (2, 수학), (3, 컴퓨터), (3, 국문), (3, 수학)}
정답과 해설 보기
정답: 4
정답은 ④이다. 카티션 프로덕트는 첫 번째 관계의 각 튜플을 두 번째 관계의 모든 튜플과 하나씩 결합한다. R1에 1, 2, 3의 세 값이 있고 R2에 컴퓨터, 국문, 수학의 세 값이 있으므로 조합은 3×3=9개다. 학번 1·2·3 각각에 세 학과가 모두 대응한다. 같은 위치의 행끼리만 짝짓거나 특정 학번의 세 조합만 뽑는 연산이 아니다. 관계 대수에서 결과 튜플의 나열 순서는 의미가 없으며 별도의 결합 조건이 없는 SQL CROSS JOIN으로도 확인할 수 있다.
선지별 해설
- 같은 위치의 값만 묶은 세 쌍으로 나머지 조합이 빠졌다.
- 학번 2에 대한 세 조합만 있어 전체 결과가 아니다.
- 학번 3에 대한 세 조합만 있어 전체 결과가 아니다.
- 세 학번과 세 학과의 모든 조합인 아홉 쌍을 포함한다.
편집 해설 근거: PostgreSQL 18 — Cross Join — Joined Tables — CROSS JOIN; Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — Cross-Product
44. 물리적 데이터베이스 설계에 대한 설명으로 거리가 먼 것은?
[학습용 개정문항]
- 효율적으로 데이터를 저장하고 접근하는 방법을 정한다.
- 트랜잭션 처리량, 응답시간, 디스크 용량 등을 고려한다.
- 저장 레코드의 배치와 순서, 인덱스 같은 접근 경로를 설계한다.
- 업무 영역의 개체·속성·관계를 개념적 ER 모델로 정의한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 물리적 데이터베이스 설계에서는 논리적인 구조를 실제 저장 장치와 DBMS에서 효율적으로 관리하도록 저장 방식과 접근 경로를 선택한다. 인덱스, 레코드 배치, 파일 구성 등을 결정할 때 조회·갱신 부하, 응답시간, 처리량과 저장 공간을 함께 고려한다. 반면 업무 영역의 개체·속성·관계를 개념적 ER 모델로 파악하는 일은 개념적 설계에 해당한다. 물리적 최적화는 한 질의의 속도만 높이는 일이 아니며 쓰기 비용과 공간 등 전체 작업 부하의 균형을 평가해야 한다.
선지별 해설
- 실제 저장과 접근을 효율화하는 것이 물리적 설계의 목적이다.
- 처리량·응답시간·공간은 물리적 선택의 주요 평가 기준이다.
- 레코드 배치와 인덱스 등 접근 경로를 설계한다.
- 업무의 개체와 관계를 개념적으로 정의하는 활동으로 물리적 설계와 다르다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Physical Database Design — Physical Database Design and Tuning
45. 다음 중 기본키는 NULL 값을 가져서는 안 되며, 릴레이션 내에서 각 기본키 값이 유일해야 한다는 조건을 무엇이라 하는가?
- 개체 무결성 제약조건
- 참조 무결성 제약조건
- 도메인 무결성 제약조건
- 속성 무결성 제약조건
정답과 해설 보기
정답: 1
정답은 ①이다. 기본키는 관계의 각 튜플을 고유하게 식별해야 하므로 중복을 허용하지 않고 NULL도 허용하지 않는다. 이 조건을 통해 실제로 식별할 수 없는 행이 생기는 것을 막는 것이 개체 무결성이다. 복합 기본키라면 구성 속성 어느 것에도 NULL이 있어서는 안 된다. 참조 무결성은 외래키 값과 참조 대상 키 사이의 관계를 다루며 도메인 제약은 값의 형식이나 허용 범위를 제한한다. UNIQUE만 선언한 열의 NULL 처리와 기본키의 조건을 혼동하지 않아야 한다.
선지별 해설
- 기본키의 유일성과 NULL 금지를 통해 개체를 식별한다.
- 외래키와 참조 대상 사이의 관계를 유지하는 조건이다.
- 속성 값의 자료형·범위 등 허용 값에 관한 조건이다.
- 제시한 기본키 식별 조건의 표준적인 분류는 개체 무결성이다.
편집 해설 근거: PostgreSQL 18 — Constraints — Primary Keys; Foreign Keys; Unique Constraints
46. SQL에서 행을 지정한 기준으로 묶어 그룹을 만들며, HAVING으로 각 그룹에 조건을 적용할 때 사용하는 그룹화 절은?
[학습용 개정문항]
- LIKE 절
- WHERE 절
- GROUP BY 절
- ORDER BY 절
정답과 해설 보기
정답: 3
정답은 ③이다. GROUP BY는 지정한 식이나 열의 값에 따라 행을 묶어 그룹을 만드는 절이다. HAVING은 만들어진 그룹에 집계 조건 등을 적용하여 남길 그룹을 결정한다. 예를 들어 부서별로 묶고 COUNT(*)가 일정 수 이상인 부서만 남길 수 있다. WHERE는 그룹화 전에 개별 행을 거르고 ORDER BY는 결과의 정렬 순서를 정한다. HAVING은 GROUP BY를 생략한 집계 질의에서도 사용할 수 있으므로 두 절이 반드시 함께 있어야 한다고 외우면 안 된다.
선지별 해설
- LIKE는 문자열 패턴을 비교하는 연산자이며 그룹화 절이 아니다.
- WHERE는 그룹화 전에 개별 행을 제한한다.
- GROUP BY가 그룹을 만들고 HAVING이 그룹에 조건을 적용한다.
- ORDER BY는 출력 결과의 순서를 정한다.
편집 해설 근거: PostgreSQL 18 — SELECT — GROUP BY Clause; HAVING Clause
47. 관계 데이터베이스에 있어서 관계 대수 연산이 아닌 것은?
- 디비전(Division)
- 프로젝트(Project)
- 조인(Join)
- 포크(Fork)
정답과 해설 보기
정답: 4
정답은 ④이다. 관계 대수는 관계를 입력으로 받아 새로운 관계를 만드는 연산 체계다. 프로젝션은 필요한 속성을 선택하고, 조인은 조건에 맞는 두 관계의 튜플을 결합한다. 디비전은 다른 관계의 모든 값과 관련된 대상을 찾는 전칭 조건을 표현하는 데 사용할 수 있다. Fork는 이 관계 대수 연산들의 명칭이 아니며 운영체제의 프로세스 생성 등 다른 문맥에서 쓰인다. 프로젝션의 열 선택과 셀렉션의 행 선택도 구별하여 이해해야 한다.
선지별 해설
- 디비전은 모든 관련 값에 대응하는 대상을 구하는 관계 대수 연산이다.
- 프로젝션은 필요한 속성으로 관계를 구성하는 연산이다.
- 조인은 조건에 따라 관계를 결합하는 연산이다.
- Fork는 제시한 관계 대수 연산에 속하지 않는다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — Projection; Joins; Division
48. 학적 테이블에서 전화번호가 NULL이 아닌 학생명을 모두 검색하는 SQL문으로 옳은 것은?
- SELECT 학생명 FROM 학적 WHERE 전화번호 = NULL;
- SELECT 학생명 FROM 학적 WHERE 전화번호 != NULL;
- SELECT 학생명 FROM 학적 WHERE 전화번호 IS NOT NULL;
- SELECT 학생명 FROM 학적 WHERE 전화번호 IS NULL;
정답과 해설 보기
정답: 3
정답은 ③이다. SQL의 NULL은 알 수 없거나 값이 없음을 나타내므로 일반적인 값처럼 등호나 부등호로 비교하지 않는다. 전화번호가 존재하는 행을 찾으려면 IS NOT NULL이라는 전용 술어를 사용한다. 표준적인 NULL 비교 의미에서 전화번호 = NULL이나 != NULL은 TRUE가 되지 않으며 WHERE는 TRUE인 행만 남긴다. IS NULL은 반대로 전화번호가 NULL인 행을 선택한다. 빈 문자열이 저장된 경우와 NULL인 경우도 DBMS의 구체적인 의미를 확인해 구별해야 한다.
선지별 해설
- NULL에 대한 일반 등호 비교는 NULL 여부를 검사하는 올바른 방법이 아니다.
- NULL에 대한 일반 부등호 비교도 존재하는 값을 찾지 못한다.
- IS NOT NULL이 전화번호가 NULL이 아닌 행을 선택한다.
- IS NULL은 문제와 반대로 전화번호가 NULL인 행을 선택한다.
편집 해설 근거: PostgreSQL 18, Comparison Functions and Operators — Comparison Predicates — IS NULL; IS NOT NULL
49. 관계형 데이터베이스에서 튜플을 유일하게 식별할 수 있으며, 최소성은 정의상 요구하지 않는 속성 집합을 무엇이라고 하는가?
[학습용 개정문항]
- 후보키
- 대체키
- 슈퍼키
- 외래키
정답과 해설 보기
정답: 3
정답은 ③이다. 슈퍼키는 한 관계에서 튜플을 유일하게 식별할 수 있는 속성의 집합이다. 유일성은 요구하지만 불필요한 속성이 하나도 없어야 한다는 최소성은 요구하지 않는다. 슈퍼키에서 더 이상 속성을 제거할 수 없으면서 유일성을 유지하는 최소 집합이 후보키다. 따라서 후보키도 슈퍼키에 포함된다. 후보키 가운데 기본키로 선택되지 않은 키는 대체키이며, 외래키는 다른 키를 참조하는 역할을 한다. 슈퍼키가 반드시 최소성을 위반해야 한다고 정의하면 잘못이다.
선지별 해설
- 후보키는 유일성에 더해 최소성도 요구한다.
- 대체키는 후보키 중 기본키로 선택되지 않은 키다.
- 유일성만 요구하고 최소성은 요구하지 않는 키 집합이다.
- 외래키는 참조 관계를 표현하며 그 자체의 유일성을 반드시 요구하지 않는다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Keys; Candidate Keys; Foreign Keys
50. 데이터베이스에서 인덱스(Index)와 관련한 설명으로 틀린 것은?
- 인덱스의 기본 목적은 검색 성능을 최적화하는 것으로 볼 수 있다.
- B-트리 인덱스는 분기를 목적으로 하는 Branch Block을 가지 고 있다.
- BETWEEN 등 범위(Range) 검색에 활용될 수 있다.
- 시스템이 자동으로 생성하여 사용자가 변경할 수 없다.
정답과 해설 보기
정답: 4
정답은 ④이다. 인덱스는 조회에 사용할 접근 경로를 추가하여 필요한 행을 더 효율적으로 찾도록 돕는 자료 구조다. DBMS가 제약을 지원하려고 자동 생성하는 경우도 있지만 사용자가 CREATE INDEX 등으로 명시적으로 만들고 관리할 수도 있다. B-트리 계열 인덱스는 분기 정보를 통해 탐색 범위를 좁히며 범위 조건에도 활용된다. 다만 모든 인덱스가 모든 질의를 빠르게 하지는 않는다. 저장 공간과 갱신 비용이 들고 실제 사용 여부는 질의 조건과 실행 계획에 따라 달라진다.
선지별 해설
- 필요한 행에 효율적으로 접근하여 검색 성능을 높이는 데 사용한다.
- 분기 노드·블록의 정보를 이용해 하위 탐색 범위를 고른다.
- 적절한 B-트리 인덱스는 BETWEEN 등 범위 조건에 활용될 수 있다.
- 사용자가 인덱스를 생성·관리할 수 있으므로 틀렸다.
편집 해설 근거: PostgreSQL 18, CREATE INDEX — CREATE INDEX — Description; PostgreSQL 18 — Indexes — Index Types — B-tree
51. 로킹 단위(Locking Granularity)에 대한 설명으로 옳은 것은?
- 로킹 단위가 크면 병행성 수준이 낮아진다.
- 로킹 단위가 크면 병행 제어 기법이 복잡해진다.
- 로킹 단위가 작으면 로크(lock)의 수가 적어진다.
- 로킹은 파일 단위로 이루어지며, 레코드와 필드는 로킹 단위가 될 수 없다.
정답과 해설 보기
정답: 1
정답은 ①이다. 같은 작업 부하에서 잠금 단위가 커지면 한 잠금이 보호하는 자료의 범위가 넓어져 다른 트랜잭션이 접근할 수 있는 범위가 줄어드는 경향이 있다. 예를 들어 서로 다른 행을 수정해도 테이블 전체를 잠그면 서로 대기할 수 있다. 작은 단위의 잠금은 동시 처리 여지를 늘리지만 관리해야 하는 잠금 수와 비용이 커질 수 있다. 따라서 큰 잠금이 언제나 나쁘거나 작은 잠금이 언제나 빠르다는 뜻은 아니다. DBMS의 지원 범위와 실제 접근 패턴에 맞추어 선택한다.
선지별 해설
- 한 잠금의 보호 범위가 넓어지면 경합이 늘고 병행성이 낮아지는 경향이 있다.
- 큰 단위는 보통 관리할 잠금 수를 줄이므로 제어가 반드시 복잡해진다고 할 수 없다.
- 같은 자료 범위를 더 작은 단위로 잠그면 필요한 잠금 수는 늘어날 수 있다.
- 테이블·페이지·행 등 여러 단위가 가능하므로 파일에만 한정되지 않는다.
편집 해설 근거: IBM Db2 11.5, Lock granularity — Lock granularity
52. 관계 대수에 대한 설명으로 틀린 것은?
- 원하는 릴레이션을 정의하는 방법을 제공하며 비절차적 언어이다.
- 릴레이션 조작을 위한 연산의 집합으로 피연산자와 결과가 모두 릴레이션이다.
- 일반 집합 연산과 순수 관계 연산으로 구분된다.
- 질의에 대한 해를 구하기 위해 수행해야 할 연산의 순서를 명시한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 관계 대수는 선택·프로젝션·조인 등의 연산을 조합하여 결과 관계를 얻는 과정을 표현하므로 절차적인 질의 표현으로 분류한다. 어떤 결과가 필요한지만 논리식으로 기술하는 관계 해석의 비절차적 성격과 구별된다. 각 연산은 관계를 입력으로 받아 관계를 결과로 내므로 다른 연산과 이어 붙일 수 있다. 여기서 절차적이라는 말이 디스크 읽기나 조인 알고리즘까지 물리적으로 지정한다는 뜻은 아니다. DBMS는 같은 결과를 내는 다른 실행 계획을 선택할 수 있다.
선지별 해설
- 관계 대수는 연산의 조합을 나타내는 절차적 표현이므로 틀렸다.
- 관계를 받아 관계를 반환하므로 연산을 중첩할 수 있다.
- 합집합·차집합 등과 선택·프로젝션·조인 등을 구별할 수 있다.
- 원하는 결과를 얻기 위한 논리적 연산의 적용을 표현한다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — Relational Algebra; Operators; Composing Operators
53. 데이터의 중복으로 인하여 관계 연산을 처리할 때 예기치 못한 곤란한 현상이 발생하는 것을 무엇 이라 하는가?
- 이상(Anomaly)
- 제한(Restriction)
- 종속성 (Dependency)
- 변환(Translation)
정답과 해설 보기
정답: 1
정답은 ①이다. 하나의 사실을 여러 행에 중복 저장하면 일부만 바뀌어 값이 서로 맞지 않거나, 관계없는 사실 때문에 새 자료를 넣지 못하거나, 행을 지우면서 보존해야 할 사실까지 사라질 수 있다. 이러한 현상을 각각 갱신·삽입·삭제 이상으로 설명한다. 이상은 단순히 중복 값이 보인다는 뜻이 아니라 자료 구조와 종속성 때문에 변경 작업에서 발생하는 문제다. 정규화는 종속성에 맞추어 관계를 분해하여 이런 위험을 줄이며, 필요한 데이터가 손실 없이 재구성되는지도 함께 검토한다.
선지별 해설
- 중복과 부적절한 종속 구조로 생기는 삽입·삭제·갱신 문제를 뜻한다.
- 제한은 일반적인 제약을 나타내며 이 현상의 명칭이 아니다.
- 종속성은 속성 사이의 관계이며 이상이 발생하는 구조를 분석할 때 사용한다.
- 변환은 표현을 바꾸는 작업으로 삽입·삭제·갱신 이상의 명칭이 아니다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — Pitfalls in Relational Database Design; Decomposition
54. 다음 중 SQL에서의 DDL문이 아닌 것은?
- CREATE
- DELETE
- ALTER
- DROP
정답과 해설 보기
정답: 2
정답은 ②이다. DELETE는 테이블에 저장된 행을 삭제하는 데이터 조작문이다. WHERE 조건을 붙이면 해당 행만 삭제하고 조건이 없으면 대상 테이블의 모든 행을 삭제할 수 있지만 테이블 정의 자체를 없애는 것은 아니다. CREATE는 데이터베이스 객체를 만들고 ALTER는 정의를 바꾸며 DROP은 객체 정의를 제거하는 데이터 정의문에 해당한다. 따라서 행 삭제와 테이블 제거를 같은 작업으로 이해하면 안 된다. 외래키 등 제약과 트랜잭션 조건도 실제 삭제 결과에 영향을 줄 수 있다.
선지별 해설
- 테이블 등 객체를 정의하는 DDL이다.
- 저장된 행을 삭제하는 데이터 조작문으로 제시한 DDL 분류에 속하지 않는다.
- 기존 객체의 정의를 변경하는 DDL이다.
- 객체 자체를 제거하는 DDL이다.
편집 해설 근거: PostgreSQL 18: DELETE — DELETE — Description; PostgreSQL 18: Data Definition — Data Definition
55. 정규화에 대한 설명으로 적절하지 않은 것은?
[학습용 개정문항]
- 개념적 설계 이전에만 수행할 수 있고 논리적 설계에서는 수행할 수 없다.
- 데이터의 의미와 종속성에 맞는 안정적인 관계 구조를 설계하는 데 도움이 된다.
- 불필요한 중복을 줄여 삽입·삭제·갱신 이상을 줄일 수 있다.
- 새 자료를 저장할 때 불필요한 구조 재편이 필요한 상황을 줄이는 데 도움이 된다.
정답과 해설 보기
정답: 1
정답은 ①이다. 정규화는 함수 종속이나 다치 종속 등 데이터의 의미적 관계를 분석하여 불필요한 중복과 변경 이상을 줄이도록 관계 스키마를 구성하는 작업이다. 논리적 데이터베이스 설계에서 수행하거나 기존 스키마를 개선할 때 적용할 수 있으므로 개념적 설계 이전에만 가능하다는 설명은 틀렸다. 분해할 때에는 정보가 손실 없이 복원되는지와 필요한 종속성을 어떻게 유지할지도 검토해야 한다. 정규화가 모든 질의를 빠르게 하거나 모든 유형의 데이터 오류를 자동으로 없애는 것은 아니다.
선지별 해설
- 논리 설계와 기존 스키마 개선에서도 수행할 수 있으므로 틀렸다.
- 데이터 의미에 맞는 구조를 만들고 변경의 영향을 줄이는 데 도움이 된다.
- 부적절한 중복으로 생기는 삽입·삭제·갱신 이상을 줄일 수 있다.
- 새 사실의 저장 때문에 불필요하게 구조를 바꾸는 상황을 줄이는 데 도움이 된다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — Relational Database Design; Functional Dependencies; Decomposition
56. ACID 중 동시 트랜잭션 사이의 중간 상태 노출과 간섭을 제한하는 성질은? 직렬화 가능 격리 수준에서는 동시 실행 결과가 어떤 직렬 실행 결과와 같아야 한다.
[학습용 개정문항]
- Log
- Consistency
- Isolation
- Durability
정답과 해설 보기
정답: 3
정답은 ③이다. 격리성은 동시에 실행되는 트랜잭션 사이에서 중간 상태의 노출과 간섭을 제한하는 성질이다. 가장 강한 직렬화 가능 수준에서는 동시에 실행한 결과가 어떤 직렬 실행의 결과와 같아야 한다. 실제 명령이 시간상 서로 섞여 실행되는 것 자체를 금지하지는 않는다. DBMS가 제공하는 격리 수준에 따라 허용되는 읽기 현상과 이상이 다를 수 있다. 일관성은 유효한 데이터 규칙의 유지, 지속성은 완료된 변경의 보존과 관련되며 로그는 이를 지원하는 수단 중 하나다.
선지별 해설
- 로그는 작업 기록이나 복구 수단이며 ACID의 격리성 명칭이 아니다.
- 일관성은 유효한 데이터 규칙을 유지하는 성질이다.
- 동시 트랜잭션 사이의 중간 상태 노출과 간섭을 제한하는 격리성이다.
- 지속성은 성공적으로 확정한 변경을 보존하는 성질이다.
편집 해설 근거: PostgreSQL 18 — Transaction Isolation — Transaction Isolation; Serializable Isolation Level
57. SQL의 논리 연산자가 아닌 것은?
- AND
- OTHER
- OR
- NOT
정답과 해설 보기
정답: 2
정답은 ②이다. SQL의 기본 논리 연산자는 AND, OR, NOT이다. AND는 조건을 함께 만족하는지를, OR는 적어도 하나를 만족하는지를, NOT은 조건의 부정을 표현한다. OTHER는 이 논리 연산자들의 이름이 아니다. SQL 조건에는 TRUE와 FALSE뿐 아니라 NULL과 관련된 UNKNOWN도 등장할 수 있으므로 일반적인 이진 논리만으로 모든 식을 판단하면 안 된다. WHERE에서는 조건 평가 결과가 TRUE인 행만 선택되며 FALSE나 UNKNOWN인 행은 남지 않는다.
선지별 해설
- 두 논리 조건의 결합을 표현하는 연산자다.
- 제시한 SQL 논리 연산자에 해당하지 않는다.
- 조건 중 적어도 하나가 참인지 평가하는 연산자다.
- 논리 조건을 부정하는 연산자다.
편집 해설 근거: PostgreSQL, Logical Operators — Logical Operators
58. 동시성 제어를 위한 직렬화 기법으로, 트랜잭션 간의 처리 순서를 미리 정하는 방법은?
- 로킹 기법
- 타임스탬프 기법
- 검증 기법
- 배타 로크 기법
정답과 해설 보기
정답: 2
정답은 ②이다. 타임스탬프 순서 기법은 각 트랜잭션에 부여한 순서 값을 기준으로 충돌하는 읽기·쓰기가 그 순서를 어기지 않도록 제어한다. 자료 항목의 읽기·쓰기 타임스탬프를 확인하고 순서를 위반하는 연산이나 트랜잭션을 취소·재시작하는 방식 등이 사용된다. 순서 값은 실제 시계 시각일 수도 있지만 유일하게 증가하는 번호 등으로 구현할 수도 있다. 잠금을 획득해 상호 접근을 제한하는 기법이나 실행 후 충돌을 검증하는 낙관적 방법과 구별한다.
선지별 해설
- 접근 전에 잠금을 획득하여 충돌을 제어하는 방식이다.
- 미리 부여한 순서 값에 맞춰 충돌 연산을 허용하는 방식이다.
- 실행 단계 뒤 검증 과정에서 충돌 가능성을 확인하는 방법이다.
- 수정 등을 위해 다른 접근과 충돌하는 배타 잠금을 사용하는 방법이다.
편집 해설 근거: Database System Concepts, Concurrency Control — slides 18.39–18.42, Timestamp-Based Protocols; Timestamp-Ordering Protocol
59. 관계에 성립하는 모든 비자명한 조인 종속(JD)이 후보키에 의해 함의되도록 하는 정규형은?
[학습용 개정문항]
- 제3정규형
- 제4정규형
- 제5정규형
- 제6정규형
정답과 해설 보기
정답: 3
정답은 ③이다. 제5정규형은 관계에 성립하는 모든 비자명한 조인 종속이 후보키에 의해 함의되는 상태를 뜻한다. 조인 종속은 관계를 여러 투영으로 나누었다가 자연 조인했을 때 원래 관계를 정확히 재구성할 수 있다는 조건이다. 제4정규형이 다치 종속에 따른 중복을 다루는 데 비해 제5정규형은 더 일반적인 다자 분해·재결합 관계를 다룬다. 단순히 조인을 사용하지 말라는 뜻이나 모든 관계를 최대한 잘게 나누라는 뜻은 아니다. 무손실 재구성과 데이터의 의미를 함께 확인해야 한다.
선지별 해설
- 제3정규형은 주로 함수 종속과 비주요 속성의 조건을 다룬다.
- 제4정규형은 비자명한 다치 종속의 결정자가 슈퍼키인지 확인한다.
- 비자명한 조인 종속이 후보키로 함의되는 조건이 제5정규형이다.
- 문항의 조인 종속 조건을 가리키는 답은 제5정규형이다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts, 온라인 Chapter 28 — §28.2.2 Join Dependencies and Fifth Normal Form
60. 관계 R의 속성 집합 X, Y에 대해 모든 유효한 관계 상태에서 두 튜플의 X 값이 같으면 Y 값도 같다. Y가 X에 함수 종속된다는 올바른 표기는?
[학습용 개정문항]
- Y → X
- Y ⊂ X
- X → Y
- X ⊂ Y
정답과 해설 보기
정답: 3
정답은 ③이다. 함수 종속 X→Y는 관계의 유효한 상태에서 두 튜플의 X 값이 같으면 Y 값도 같아야 한다는 제약이다. X가 결정자이고 Y가 종속되는 속성 집합이므로 화살표는 X에서 Y로 향한다. 예를 들어 한 시점의 유효한 학생 관계에서 학번이 같으면 학생명도 같아야 한다면 학번→학생명으로 나타낸다. 이것이 이름을 평생 변경할 수 없다는 뜻은 아니다. 현재 표에서 우연히 중복이 없다는 사실만으로 모든 유효 상태에 성립할 함수 종속을 확정할 수도 없다.
선지별 해설
- Y가 X를 결정한다는 반대 방향의 종속이다.
- 집합 포함 관계 표기이며 함수 종속의 방향 표기가 아니다.
- X 값이 Y 값을 결정하므로 X→Y다.
- 속성 집합의 포함 관계이며 함수 종속과 다르다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — Functional Dependencies
정보처리기사 필기 기출문제 · 프로그래밍 언어 활용
61. 모듈 내 구성 요소들이 서로 다른 기능을 같은 시간대에 함께 실행하는 경우의 응집도 (Cohesion)는?
- Temporal Cohesion
- Logical Cohesion
- Coincidental Cohesion
- Sequential Cohesion
정답과 해설 보기
정답: 1
정답은 ①이다. 시간적 응집도는 기능 자체가 밀접해서가 아니라 같은 실행 시점이나 단계에 필요하다는 이유로 여러 처리를 하나의 모듈에 묶은 경우다. 프로그램 시작 때 환경 읽기, 버퍼 초기화, 로그 준비 등을 함께 수행하는 것이 예다. 순차적 응집도는 한 처리의 출력이 다음 처리의 입력으로 이어지는 관계이며, 논리적 응집도는 유사한 종류의 기능을 선택하게 묶는 경우다. 우연적 응집도는 뚜렷한 관련 없이 묶인 상태다. 같은 시간대라는 단서는 실제 병렬 실행을 반드시 뜻하지는 않는다.
선지별 해설
- 같은 실행 시점이나 단계에 수행한다는 이유로 묶인 시간적 응집도다.
- 유사한 범주의 기능을 논리적으로 묶는 경우다.
- 명확한 관련성 없이 우연히 한 단위로 모인 경우다.
- 앞 처리의 출력이 뒤 처리의 입력으로 사용되는 관계다.
편집 해설 근거: Lethbridge·Laganière, Object-Oriented Software Engineering, Chapter 9 (2001), 저자 강의 자료 — Temporal cohesion; Logical cohesion; Sequential cohesion
62. 오류 제어에 사용되는 자동반복 요청방식(ARQ)이 아닌 것은?
[학습용 개정문항]
- Stop-and-wait ARQ
- Go-back-N ARQ
- Selective-Repeat ARQ
- Non-Acknowledge ARQ
정답과 해설 보기
정답: 4
정답은 ④이다. ARQ는 전송 오류나 손실을 확인하고 필요한 데이터를 다시 보내 신뢰성을 높이는 방식이다. 정지-대기는 한 단위 전송 뒤 확인을 기다리고, Go-Back-N은 오류 이후의 연속 구간을 다시 전송하며, 선택적 반복은 필요한 단위를 골라 재전송한다. Non-Acknowledge ARQ는 이 문항이 비교하는 대표적인 방식의 이름이 아니다. 다만 NAK라는 부정 응답을 활용하는 ARQ 변형은 실제로 있으므로 ④가 틀렸다는 사실을 모든 ARQ가 반드시 같은 확인 메시지를 쓴다는 뜻으로 확대하면 안 된다.
선지별 해설
- 한 단위를 보내고 확인을 기다리는 ARQ 방식이다.
- 오류가 난 위치 이후의 구간을 다시 전송하는 Go-Back-N 방식이다.
- 필요한 프레임을 선택하여 다시 보내는 ARQ 방식이다.
- 대표적인 ARQ 방식의 표준적인 명칭에 해당하지 않는다.
편집 해설 근거: IETF RFC 3366, Advice to link designers on link ARQ (2002) — §1.1 Link ARQ; §1.4 Commonly-used ARQ Techniques
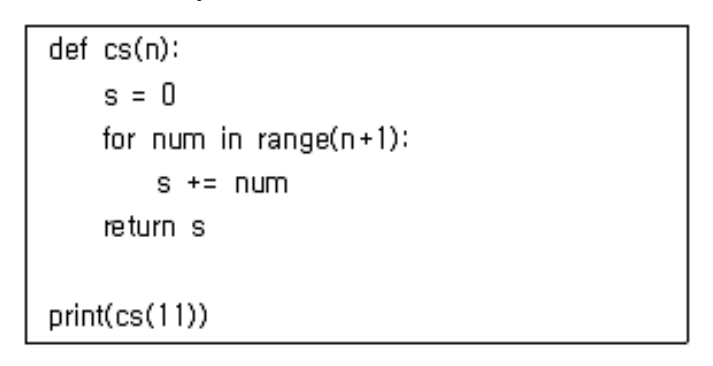
63. 이미지의 Python cs 함수에 11을 전달했을 때 출력되는 합은?
- 45
- 55
- 66
- 78
정답과 해설 보기
정답: 3
정답은 ③이다. cs(11)을 호출하면 n은 11이고 range(n+1)은 range(12)가 된다. Python의 range는 끝값을 포함하지 않으므로 반복 변수 num은 0부터 11까지의 열두 값을 차례로 갖는다. s의 초기값 0에 이 값들을 더하면 0+1+…+11=11×12÷2=66이다. 함수를 마친 뒤 반환된 66을 print가 출력한다. n을 포함하지 않는 0부터 10까지의 합 55와 구별해야 하며, range의 인수에 이미 1을 더했다는 점을 놓치지 않는 것이 핵심이다.
선지별 해설
- 0부터 9까지 더한 합으로 실제 반복 범위보다 짧다.
- 0부터 10까지 더한 합으로 마지막 11이 빠졌다.
- 0부터 11까지 더한 합 66이 출력된다.
- 0부터 12까지 더한 합으로 포함되지 않는 12까지 더했다.
편집 해설 근거: Python 3.14, Built-in Types — Ranges; Python 3.14 Tutorial, More Control Flow Tools: Defining Functions — Defining Functions
64. 다음 C 프로그램의 출력은?
#include <stdio.h>
#include <string.h>
int main(void) {
    char str[50] = "nation";
    const char *p2 = "alter";
    strcat(str, p2);
    printf("%s", str);
    return 0;
}
[학습용 개정문항]
- nation
- nationalter
- alter
- alternation
정답과 해설 보기
정답: 2
정답은 ②이다. strcat은 첫 번째 인수에 있는 문자열의 끝을 찾고 그 뒤에 두 번째 인수의 문자열을 이어 붙인다. str의 초기 문자열 nation 뒤에 alter가 붙으므로 nationalter가 되고 이 값이 출력된다. 결합한 글자는 11개이며 종료 널 문자까지 12바이트가 필요하므로 50바이트 배열에는 충분히 들어간다. 대상 배열이 수정 가능하고 공간이 충분해야 하며 문자열의 저장 영역이 부적절하게 겹치면 안 된다. 두 번째 문자열을 앞에 붙이는 함수가 아니라는 점도 확인해야 한다.
선지별 해설
- 결합 전 문자열이며 strcat 이후에는 alter가 추가된다.
- nation 뒤에 alter가 붙은 올바른 결과다.
- 원본 대상 내용이 사라지고 원본 문자열로 교체되는 연산이 아니다.
- alter 뒤에 nation을 붙인 순서로 실제 인수 방향과 반대다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §7.24.3.1 The strcat function; §7.21.6.1 The fprintf function
65. Java에서 실행 중인 프로그램의 유효한 참조를 따라 더 이상 도달할 수 없는 힙 객체의 저장 공간을 자동으로 회수하는 기능은?
[학습용 개정문항]
- Heap Collector
- Garbage Collector
- Memory Collector
- Variable Collector
정답과 해설 보기
정답: 2
정답은 ②이다. 가비지 컬렉터는 실행 중인 프로그램에서 더 이상 도달할 수 없는 객체의 저장 공간을 회수하는 기능을 담당한다. 어떤 변수 하나가 참조를 잃었다고 바로 회수 대상이 되는 것은 아니다. 다른 살아 있는 참조를 따라 도달할 수 있다면 객체는 여전히 사용될 수 있다. 반대로 서로 참조하는 객체들이 있어도 프로그램의 유효한 시작점에서 도달할 수 없으면 회수 대상이 될 수 있다. 객체가 회수 가능한 상태가 되었다고 즉시 특정 시점에 수거된다고 보장되는 것도 아니다.
선지별 해설
- Java의 표준적인 자동 메모리 회수 기능 명칭이 아니다.
- 도달할 수 없는 객체의 저장 공간을 회수하는 가비지 컬렉터다.
- 이 기능의 표준적인 명칭은 Garbage Collector다.
- 변수 자체를 모으는 기능으로 정의하지 않는다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 12 Execution — §12.6.1 Implementing Finalization
66. 다음 C 프로그램의 출력은?
#include <stdio.h>
int main(void) {
    int a = 3, b = 4, c = 2;
    int r1 = b <= 4 || c == 2;
    int r2 = (a > 0) && (b < 5);
    int r3 = !c;
    printf("%d", r1 + r2 + r3);
    return 0;
}
[학습용 개정문항]
- 0
- 1
- 2
- 3
정답과 해설 보기
정답: 3
정답은 ③이다. b가 4이므로 b<=4는 참이고 논리 OR 결과 r1은 1이다. a가 3이어서 a>0이 참이며 b<5도 참이므로 논리 AND 결과 r2도 1이다. c가 2로 0이 아닌 값이므로 !c는 거짓인 0이다. 따라서 r1+r2+r3은 1+1+0=2다. C의 논리 연산 결과는 정수 0 또는 1이며 피연산자의 값 2나 4를 그대로 반환하지 않는다. ||와 &&에는 왼쪽 평가 결과만으로 결론이 나면 오른쪽을 평가하지 않는 단축 평가 규칙도 있다.
선지별 해설
- 세 논리식이 모두 거짓인 결과지만 앞의 두 식은 참이다.
- 참인 결과가 하나라고 센 값으로 r1과 r2가 모두 1임을 놓쳤다.
- r1=1, r2=1, r3=0을 더하면 2다.
- !2는 1이 아니라 0이므로 합이 3이 되지 않는다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.3.3 Unary arithmetic operators; §6.5.13 Logical AND; §6.5.14 Logical OR
67. 다음 중 JAVA에서 우선순위가 가장 낮은 연산자는?
- —
- %
- &
- =
정답과 해설 보기
정답: 4
정답은 ④이다. Java에서 제시한 연산자 중 대입 연산자 =의 우선순위가 가장 낮다. 감소 연산자 –는 단항 또는 후위 연산 위치에서 결합하고, 나머지 연산자 %는 곱셈 수준에서 결합한다. &는 정수의 비트 AND 또는 boolean의 비단축 논리 AND로 사용될 수 있으며 대입보다 먼저 묶인다. 따라서 오른쪽 계산 결과가 정해진 뒤 변수에 대입하는 식으로 해석한다. 연산자의 우선순위는 식을 어떻게 묶는지 정하는 규칙이며 피연산자의 평가 순서와 같은 개념은 아니다.
선지별 해설
- 감소 연산자로 대입 연산자보다 우선순위가 높다.
- 곱셈·나눗셈과 같은 수준의 나머지 연산자다.
- 비트 또는 boolean AND로 대입보다 먼저 결합한다.
- =는 제시한 네 연산자 중 우선순위가 가장 낮다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 15 Expressions — §15.14 Postfix Expressions; §15.15 Unary Operators; §15.17 Multiplicative Operators; §15.22; §15.26 Assignment Operators
68. 그림의 디스크 요청들이 모두 대기 중이며 처리 도중 새 요청은 없다. 헤드의 현재 위치가 53이고 트랙 범위가 1~200일 때, SSTF로 처리하는 순서는?
[학습용 개정문항]
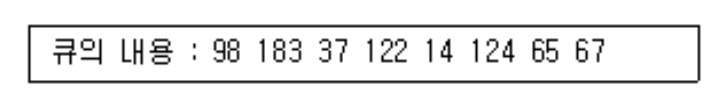
- 53-65-67-37-14-98-122-124-183
- 53-98-183-37-122-14-124-65-67
- 53-37-14-65-67-98-122-124-183
- 53-67-65-124-14-122-37-183-98
정답과 해설 보기
정답: 1
정답은 ①이다. SSTF는 현재 헤드 위치에서 이동 거리가 가장 짧은 대기 요청을 매번 선택한다. 53에서는 65가 12트랙 거리로 가장 가깝고, 다음에는 67을 선택한다. 이후 남은 요청 중 가까운 순서로 37, 14, 98, 122, 124, 183을 처리한다. 따라서 시작 위치를 포함하면 53-65-67-37-14-98-122-124-183이다. 총 이동 거리는 12+2+30+23+84+24+2+59=236트랙이다. 매 단계마다 기준 위치가 바뀌며 도착 순서를 그대로 따르는 FCFS와 다르다.
선지별 해설
- 각 처리 뒤 새 헤드 위치에서 가장 가까운 요청을 다시 고른 결과다.
- 요청이 큐에 들어온 순서를 따른 FCFS 결과다.
- 첫 단계에서 37까지 16보다 65까지 12가 짧으므로 틀렸다.
- 첫 단계에서 67보다 65가 가까우므로 틀렸다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 37 Hard Disk Drives — §37.5 Disk Scheduling — SSTF: Shortest Seek Time First
69. 192.168.1.0/24 네트워크를 FLSM 방식으로 4개의 서브넷으로 나누고 IP Subnet-zero를 적용했다. 이때 네 번째 서브넷의 네 번째 사용 가능한 IP 주소는?
- 192.168.1.192
- 192.168.1.195
- 192.168.1.196
- 192.168.1.198
정답과 해설 보기
정답: 3
정답은 ③이다. /24를 같은 크기의 네 서브넷으로 나누려면 서브넷 구분에 두 비트를 더 사용하여 /26이 된다. 각 블록은 64개 주소이므로 네트워크 주소는 .0, .64, .128, .192 순서다. 네 번째 블록의 네트워크 주소 .192와 브로드캐스트 .255를 제외하면 첫 호스트는 .193이다. 사용 가능한 주소를 .193, .194, .195, .196으로 세면 네 번째는 192.168.1.196이다. 네 번째 서브넷의 시작 주소 자체를 첫 사용 가능 호스트로 세지 않아야 한다.
선지별 해설
- 네 번째 서브넷의 네트워크 주소이므로 호스트 주소로 세지 않는다.
- 네 번째 서브넷에서 세 번째 사용 가능 호스트 주소다.
- 첫 호스트 .193부터 네 번째가 .196이다.
- 네 번째 서브넷에서 여섯 번째 사용 가능 호스트 주소다.
편집 해설 근거: RFC 4632, Classless Inter-domain Routing (2006) — §3.1 Basic Concept and Prefix Notation; IETF RFC 791, Internet Protocol (1981) — §3.2 Discussion — Addressing
70. 과거 클래스 기반(classful) IPv4 주소 체계에서 클래스 C 범위에 속하는 주소는?
[학습용 개정문항]
- 200.168.30.1
- 10.3.2.14
- 225.2.4.1
- 172.16.98.3
정답과 해설 보기
정답: 1
정답은 ①이다. 과거 클래스 기반 IPv4 주소 체계에서 클래스 C는 첫 옥텟의 상위 비트가 110이며 첫 옥텟 값은 192부터 223까지다. 따라서 첫 값이 200인 200.168.30.1이 해당한다. 10으로 시작하는 주소는 클래스 A 범위, 172는 클래스 B 범위, 225는 멀티캐스트에 사용되는 클래스 D 범위다. 오늘날 실제 네트워크의 경계는 보통 CIDR 프리픽스로 지정하므로 주소 첫 숫자만으로 실제 서브넷 마스크를 결정해서는 안 된다. 이 문제는 역사적 분류를 묻는다.
선지별 해설
- 첫 옥텟 200이 192~223 사이이므로 클래스 C다.
- 첫 옥텟 10은 역사적 클래스 A 범위다.
- 첫 옥텟 225는 멀티캐스트 클래스 D 범위다.
- 첫 옥텟 172는 역사적 클래스 B 범위다.
편집 해설 근거: IETF RFC 791, Internet Protocol (1981) — §3.2 Discussion — Addressing; RFC 4632, Classless Inter-domain Routing (2006) — §2 History and Problem Description; §3.1 Basic Concept and Prefix Notation
71. 다음 C11 프로그램의 출력은?
#include <stdio.h>
int main(void) {
    int values[5] = {4, 0, 0, 0, 0};
    int n = 4;
    int *pt = &values[0];
    printf("%td", &values[0] + *pt - *&pt + n);
    return 0;
}
[학습용 개정문항]
- 0
- 4
- 8
- 12
정답과 해설 보기
정답: 3
정답은 ③이다. pt는 values[0]을 가리키고 *pt는 저장된 정수 4다. *&pt는 포인터 변수의 주소를 다시 역참조한 것이므로 pt와 같다. 따라서 &values[0]+4는 배열의 다섯 번째 원소 위치이고, 여기에서 pt를 빼면 같은 배열 안의 포인터 차이인 4가 된다. 마지막으로 n의 값 4를 더하여 8을 출력한다. 포인터 덧셈은 바이트 수가 아니라 원소 단위로 이동한다. 원본의 단일 int 객체 밖으로 이동하는 식은 C에서 결과를 보장할 수 없어 유효한 배열 범위의 연산과 맞는 출력 형식으로 개정했다.
선지별 해설
- 배열 포인터의 차이 4와 마지막 정수 덧셈을 모두 반영하지 않은 값이다.
- 포인터 차이만 계산하고 뒤의 +n을 빠뜨린 값이다.
- 같은 배열 안에서의 원소 간 거리 4에 n=4를 더한 결과다.
- 포인터 이동값 4를 중복해서 더한 값으로 실제 식과 다르다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.6 Additive operators; §6.5.3.2 Address and indirection operators; §7.21.6.1
72. 귀도 반 로섬(Guido van Rossum)이 발표한 언어로, 인터프리터 방식이자 객체지향적이며, 배우기 쉽고 이식성이 좋은 것이 특징인 스크립트 언어는?
- C++
- JAVA
- C#
- Python
정답과 해설 보기
정답: 4
정답은 ④이다. Python은 귀도 반 로섬이 개발하여 공개한 프로그래밍 언어다. 가독성을 중시하는 문법과 풍부한 라이브러리를 제공하며 객체지향뿐 아니라 여러 프로그래밍 방식을 사용할 수 있다. 인터프리터를 통해 실행한다는 설명은 일반적인 사용 방식의 특징이지만 내부에서 바이트코드로 변환하는 등 구현별 실행 과정이 있을 수 있다. 언어를 스크립트용으로만 제한하는 것도 적절하지 않다. 이 문항에서는 개발자의 이름과 함께 제시된 언어의 특징을 연결하여 판단한다.
선지별 해설
- C++는 귀도 반 로섬이 개발한 언어가 아니다.
- Java는 이 문항의 개발자 단서와 일치하지 않는다.
- C#은 이 문항의 개발자 단서와 일치하지 않는다.
- 귀도 반 로섬이 개발한 언어가 Python이다.
편집 해설 근거: Python Software Foundation, General Python FAQ — What is Python?; Why was Python created in the first place?
73. 다음 Java 프로그램의 출력은?
public class Ovr {
    public static void main(String[] args) {
        int[] arr = new int[10];
        int i = 0;
        arr[0] = 0;
        arr[1] = 1;
        while (i < 8) {
            arr[i + 2] = arr[i + 1] + arr[i];
            i++;
        }
        System.out.println(arr[9]);
    }
}
[학습용 개정문항]
- 13
- 21
- 34
- 55
정답과 해설 보기
정답: 3
정답은 ③이다. 배열의 시작 값은 arr[0]=0, arr[1]=1이고 반복문은 바로 앞 두 원소를 더해 다음 원소를 채운다. i가 0부터 7까지 여덟 번 실행되면서 arr[2]부터 arr[9]까지 차례로 1, 2, 3, 5, 8, 13, 21, 34가 저장된다. 따라서 arr[9]는 34다. Java 배열은 0부터 인덱스를 매기므로 arr[9]는 열 번째 원소다. 반복 조건 i<8과 대입 위치 i+2를 함께 확인하면 마지막으로 계산하는 위치가 9임을 알 수 있다.
선지별 해설
- arr[7]에 저장되는 값으로 출력 대상보다 두 칸 앞이다.
- arr[8]에 저장되는 값으로 출력 대상보다 한 칸 앞이다.
- arr[9]에 저장되는 34가 출력된다.
- 다음 항의 값이며 길이 10인 이 코드에서는 그 항을 저장하지 않는다.
편집 해설 근거: Oracle Java SE 17 Language Specification, Chapter 14 Blocks and Statements — §14.12 The while Statement; Oracle Java SE 25 Language Specification, Chapter 15 Expressions — §15.10 Array Creation and Access Expressions; §15.18 Additive Operators
74. 프로세스와 관련한 설명으로 틀린 것은?
- 프로세스가 준비 상태에서 프로세서가 배당되어 실행 상태로 변화하는 것을 디스패치(Dispatch)라고 한다.
- 프로세스 제어 블록(PCB, Process Control Block)은 프로세스 식별자, 프로세스 상태 등의 정보로 구성된다.
- 이전 프로세스의 상태 레지스터 내용을 보관하고 다른 프로세스의 레지스터를 적재하는 과정을 문맥 교환(Context Switching)이라고 한다.
- 프로세스는 스레드(Thread) 내에서 실행되는 흐름의 단위이며, 스레드와 달리 주소 공간에 실행 스택(Stack)이 없다.
정답과 해설 보기
정답: 4
정답은 ④이다. 프로세스는 실행 중인 프로그램의 자원과 실행 상태를 묶는 단위이며 하나 이상의 스레드를 포함할 수 있다. 스레드는 그 프로세스 안에서 실행되는 흐름으로, 일반적으로 자신의 레지스터 상태와 실행 스택을 갖고 주소 공간의 다른 부분을 공유한다. 따라서 프로세스가 스레드 안에 있고 스택이 없다는 설명은 관계를 뒤집은 것이다. 디스패치는 준비된 작업에 CPU를 배정하는 과정이며 문맥 교환에서는 이전 실행 상태를 저장하고 다음 상태를 복원한다.
선지별 해설
- 준비된 프로세스에 CPU를 배정하여 실행시키는 디스패치의 설명이다.
- PCB는 식별자·상태 등 운영체제의 관리 정보를 담는다.
- 레지스터 등 실행 문맥을 저장하고 다른 실행 문맥을 복원한다.
- 스레드가 프로세스 안의 실행 흐름이며 일반적으로 스레드별 스택이 있으므로 틀렸다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 4 The Abstraction: The Process — §4.2 Process API; §4.4 Process States; §4.5 Data Structures; Arpaci-Dusseau, Operating Systems: Three Easy Pieces, Chapter 26 Concurrency: An Introduction — Chapter 26 introduction — per-thread program counter, registers and stack
75. 모듈의 독립성을 높이기 위한 결합도(coupling)와 관련한 설명으로 틀린 것은?
- 오류가 발생했을 때 전파되어 다른 오류의 원인이 되는 파문 효과(Ripple Effect)를 최소화해야 한다.
- 인터페이스가 정확히 설정되어 있지 않을 경우 불필요한 인터페이스가 나타나 모듈 사이의 의존도는 높아지고 결합도가 증가한다.
- 모듈들이 변수를 공유하여 사용하게 하거나 제어 정보를 교류 하게 함으로써 결합도를 낮추어야 한다.
- 다른 모듈과 데이터 교류가 필요한 경우 전역변수(Global Variable)보다는 매개변수(Parameter)를 사용하는 것이 결합도를 낮추는 데 도움이 된다.
정답과 해설 보기
정답: 3
정답은 ③이다. 결합도는 모듈 사이에 존재하는 의존의 정도다. 공유 전역 자료에 여러 모듈이 직접 의존하거나 다른 모듈의 동작을 선택하는 제어 정보를 많이 전달하면 변경의 영향이 넓어질 수 있다. 따라서 그런 방식을 늘려 결합도를 낮춘다는 설명은 맞지 않는다. 필요한 데이터만 명확한 인터페이스로 전달하면 숨은 의존성을 줄이는 데 도움이 된다. 매개변수를 쓴다고 언제나 낮은 결합도가 되는 것은 아니며 전달 정보의 범위와 상대 모듈 내부 구조에 대한 의존도 함께 살펴야 한다.
선지별 해설
- 한 모듈의 변경·오류가 다른 곳으로 퍼지는 영향을 줄이는 것이 목표다.
- 불명확한 인터페이스는 불필요한 의존과 변경 영향을 만들 수 있다.
- 공유 변수와 제어 의존을 늘리는 것이 결합도를 낮추는 일반적인 방법은 아니다.
- 필요한 정보를 명시적으로 전달하면 숨은 전역 의존을 줄이는 데 도움이 된다.
편집 해설 근거: CMU SEI, Candidate Complexity Metrics (2016), Appendix A.6 — Appendix A.6 Coupling — five forms of coupling
76. TCP 헤더와 관련한 설명으로 틀린 것은?
- 순서 번호(Sequence Number)는 전달하는 바이트마다 번호가 부여된다.
- 수신 번호 확인(Acknowledgement Number)은 상대편 호스트에서 받으려는 바이트의 번호를 정의한다.
- 체크섬(Checksum)은 데이터를 포함한 세그먼트의 오류를 검사한다.
- 윈도우 크기는 송수신 측의 버퍼 크기로 최대 크기는 32767bit이다.
정답과 해설 보기
정답: 4
정답은 ④이다. TCP의 Window 필드는 수신 측이 받아들일 수 있다고 알리는 데이터량을 나타내며 기본 단위는 바이트다. 기본 16비트 필드의 최대 값은 65,535이고, 연결 설정에서 Window Scale 옵션을 협상하면 더 큰 수신 윈도우를 표현할 수 있다. 따라서 최대 32,767비트라는 설명은 크기와 단위 모두 틀렸다. 순서 번호는 바이트 흐름의 위치를 식별하고 확인 번호는 다음에 기대하는 순서 번호를 나타낸다. 체크섬은 TCP 헤더·데이터와 IP 주소 등을 반영하는 의사 헤더를 함께 검사한다.
선지별 해설
- TCP 데이터는 바이트 단위 순서 번호로 식별하며 SYN·FIN도 순서 공간을 사용한다.
- 유효한 ACK는 다음에 받을 것으로 기대하는 순서 번호를 전달한다.
- 체크섬은 TCP 세그먼트의 헤더와 데이터 등을 검사한다.
- 기본 필드는 최대 65,535바이트이고 확장 협상도 가능하므로 틀렸다.
편집 해설 근거: IETF RFC 9293, Transmission Control Protocol (2022) — §3.1 Header Format; IETF RFC 7323, TCP Extensions for High Performance — §2 TCP Window Scale Option
77. 모듈화(Modularity)와 관련한 설명으로 틀린 것은?
- 소프트웨어의 모듈은 프로그래밍 언어에서 Subroutine, Function 등으로 표현될 수 있다.
- 모듈의 수가 증가하면 상대적으로 각 모듈의 크기가 커지며, 모듈 사이의 상호교류가 감소하여 과부하(Overload) 현상이 나타난다.
- 모듈화는 시스템을 지능적으로 관리할 수 있도록 해주며, 복잡도 문제를 해결하는 데 도움을 준다.
- 모듈화는 시스템의 유지보수와 수정을 용이하게 한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 같은 전체 기능을 더 많은 모듈로 분해하면 보통 개별 모듈이 다루는 범위는 작아지지만 모듈 사이의 연결과 조정 비용은 늘 수 있다. 따라서 모듈 수가 증가할수록 각 모듈이 커지고 상호교류가 감소한다는 설명은 일반적인 분해 관계를 거꾸로 설명한다. 함수·서브루틴·클래스 등으로 책임을 나누면 복잡도를 이해하고 변경 영향을 제한하는 데 도움이 된다. 그러나 무조건 잘게 나누는 것이 목적은 아니며 응집도 높은 책임과 적절한 인터페이스 경계를 선택해야 한다.
선지별 해설
- 함수나 서브루틴은 모듈을 구현하는 수단이 될 수 있다.
- 분해할수록 각 모듈이 커지고 연결이 줄어든다는 설명은 맞지 않는다.
- 문제를 부분별로 이해하고 관리하여 복잡도를 다루는 데 도움이 된다.
- 적절한 책임 분리는 변경과 유지보수의 범위를 제한할 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Modularization; Cohesion and coupling
78. 다음 중 페이지 교체(Page Replacement) 알고리즘이 아닌 것은?
[학습용 개정문항]
- FIFO(First-In-First-Out)
- SJF(Shortest Job First)
- Optimal
- LRU(Least Recently Used)
정답과 해설 보기
정답: 2
정답은 ②이다. FIFO는 메모리에 가장 먼저 들어온 페이지를, LRU는 가장 오랫동안 사용하지 않은 페이지를 교체하는 정책이다. 최적 교체는 앞으로 가장 늦게 다시 사용될 페이지를 고르므로 미래 참조를 아는 비교 기준으로 활용한다. SJF는 실행 시간이 짧은 작업을 우선하는 CPU 스케줄링 정책이어서 페이지 교체 정책과 구별된다. 사용 빈도가 낮은 페이지를 고르는 LFU도 실제 교체 정책이다. 따라서 빈도가 적다는 표현 자체를 무효한 정책으로 단정해서는 안 된다.
선지별 해설
- 적재된 지 가장 오래된 페이지를 교체하는 정책이다.
- 짧은 CPU 작업을 우선하는 스케줄링 정책이며 페이지 교체 정책이 아니다.
- 미래에 가장 늦게 사용될 페이지를 교체하는 이론적인 최적 정책이다.
- 가장 오래 참조하지 않은 페이지를 교체하는 정책이다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 22 Beyond Physical Memory: Policies — §22.2 The Optimal Replacement Policy; §22.3 FIFO; §22.5 LRU; Arpaci-Dusseau, OSTEP v1.10, 7 Scheduling: Introduction — Shortest Job First (SJF)
79. C11에서 관련된 다른 선언이나 매크로가 없는 블록 안에 작성할 때, 키워드를 변수명으로 사용하여 잘못된 선언은?
[학습용 개정문항]
- int else;
- int Test2;
- int pc;
- int True;
정답과 해설 보기
정답: 1
정답은 ①이다. C11에서 else는 if 문과 함께 사용하는 키워드이므로 일반 변수의 식별자로 선언할 수 없다. Test2는 문자로 시작하고 뒤에 숫자를 포함하므로 가능한 식별자이며 pc도 허용된다. C는 대소문자를 구별하므로 대문자 T로 시작하는 True는 여기에서 금지된 키워드가 아니다. 유효한 이름이라고 해서 모든 범위에서 중복 선언이 허용되는 것은 아니지만, 다른 선언이나 매크로가 없는 문항의 상황에서는 나머지 세 선언이 가능하다. 식별자 규칙과 예약어를 함께 확인해야 한다.
선지별 해설
- else는 C11 키워드이므로 변수명으로 사용할 수 없다.
- 문자로 시작하고 숫자를 뒤에 둔 유효한 이름이다.
- C11 키워드가 아닌 유효한 식별자다.
- 대소문자를 구별하며 True는 C11 키워드가 아니다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.4.1 Keywords; §6.4.2.1 General
80. 운영체제의 파일 제어 블록(FCB)과 파일 디스크립터를 구별할 때, 다음 설명으로 틀린 것은?
[학습용 개정문항]
- FCB는 파일 관리에 필요한 메타데이터를 담는 자료 구조다.
- 구현에 따라 파일 메타데이터를 디스크에서 읽어 메모리에 캐시할 수 있다.
- 사용자 프로그램은 시스템 호출 없이 커널 내부의 FCB를 직접 수정하여 파일을 조작한다.
- POSIX open이 반환하는 정수형 파일 디스크립터는 FCB 자체와 구별된다.
정답과 해설 보기
정답: 3
정답은 ③이다. 파일 제어 블록은 파일의 소유·권한·크기·저장 위치 등 관리에 필요한 메타데이터를 나타내는 운영체제 자료 구조다. 구현에 따라 디스크의 메타데이터를 메모리에 읽어 캐시할 수 있지만 사용자 프로그램이 커널 내부 구조를 직접 수정하는 방식으로 파일을 조작하지는 않는다. POSIX의 파일 디스크립터는 open 등이 반환하는 정수형 식별 값이며 시스템 호출을 통해 열린 파일을 참조할 때 사용한다. 이 정수 값과 파일 제어 블록을 같은 것으로 부르면 안 된다.
선지별 해설
- 파일 관리에 필요한 메타데이터를 유지하는 자료 구조다.
- 필요한 메타데이터를 저장 장치에서 읽어 메모리에 캐시할 수 있다.
- 사용자 프로그램이 커널의 FCB를 직접 수정하는 방식은 아니다.
- 정수형 파일 디스크립터와 커널 파일 메타데이터 구조는 구별된다.
편집 해설 근거: Silberschatz·Galvin·Gagne, Operating System Concepts 9판, 12 File-System Implementation — File-System Implementation — File Control Block; POSIX.1-2024 Issue 8, open() — DESCRIPTION; RETURN VALUE
정보처리기사 필기 기출문제 · 정보시스템 구축관리
81. 침입 탐지 시스템(IDS: Intrusion Detection System)에 대한 설명으로 틀린 것은?
- 이상 탐지는 알려진 공격 서명만 등록해 일치 여부를 검사하는 기법이다.
- HIDS(Host-Based Intrusion Detection System)는 호스트의 계정·파일·로그와 시스템 활동을 감시한다.
- NIDS(Network-Based Intrusion Detection System)의 대표적인 도구로 Snort가 있다.
- 외부 서비스를 제공하는 서버가 위치한 DMZ에도 IDS를 설치할 수 있다.
정답과 해설 보기
정답: 1
정답은 ①이다. 알려진 공격 패턴과 일치하는지를 보는 것은 서명 기반 탐지이고, 정상적인 활동의 기준에서 벗어나는지를 보는 것은 이상 탐지다. 이상 탐지는 새로운 유형의 이상 징후를 발견할 가능성이 있지만 정상적인 변화도 경보로 판단할 수 있어 기준과 오탐을 관리해야 한다. HIDS는 호스트 내부의 파일·로그·계정 활동 등을, NIDS는 네트워크 트래픽을 주로 관찰한다. IDS를 DMZ에 배치하여 외부 공개 서버에 대한 접근을 감시할 수도 있다. 탐지 기능과 자동 차단 기능은 별도로 구별한다.
선지별 해설
- 등록한 공격 서명과의 일치 검사는 이상 탐지가 아니라 서명 기반 탐지다.
- 호스트 내부의 활동과 기록을 관찰하는 HIDS의 설명이다.
- Snort는 네트워크 침입 탐지·방지에 사용되는 도구다.
- 관찰하려는 트래픽과 위협에 맞춰 DMZ에도 배치할 수 있다.
편집 해설 근거: NIST SP 800-94, Guide to Intrusion Detection and Prevention Systems (2007) — §2.2 Detection Methodologies; §4 Network-Based IDPS; §7 Host-Based IDPS
82. 정보 시스템 내에서 어떤 주체가 특정 개체에 접근하려 할 때 양쪽의 보안 레이블(Security Label)에 기초하여 높은 보안 수준을 요구하는 정보(객체)가 낮은 보안 수준의 주체에게 노출되지 않도록 하는 접근 제어 방법은?
- Mandatory Access Control
- User Access Control
- Discretionary Access Control
- Data-Label Access Control
정답과 해설 보기
정답: 1
정답은 ①이다. 강제적 접근 제어는 사용자가 임의로 바꾸기 어려운 중앙 정책에 따라 접근을 결정한다. 문항처럼 주체의 인가 수준과 객체의 보안 레이블을 비교하여 높은 등급의 정보가 낮은 등급의 주체에게 노출되지 않도록 하는 것이 대표적인 적용이다. 임의적 접근 제어는 소유자 등의 재량에 따라 권한을 부여하는 성격이 강하다. 보안 레이블 기반 기밀성 모델은 MAC의 중요한 예이지만 모든 MAC 구현이 반드시 하나의 동일한 모델과 규칙을 쓰는 것은 아니다.
선지별 해설
- 보안 레이블과 중앙 정책에 따라 강제하는 MAC에 해당한다.
- 일반적인 사용자 접근 제어라는 표현만으로 문항의 정책을 특정하지 않는다.
- DAC는 소유자 등의 재량에 의한 접근 권한 설정을 중심으로 한다.
- 문항에서 설명한 대표적인 접근 제어 분류의 이름은 MAC이다.
편집 해설 근거: NIST CSRC Glossary, mandatory access control — Mandatory access control definitions; Bell·LaPadula, Secure Computer System: Unified Exposition and Multics Interpretation (1976), IEEE 보존 원문 — Simple Security Condition; *-Property
83. Google Brain 팀이 제작해 공개한 기계 학습(Machine Learning)용 오픈 소스 소프트웨어 라이브러리는?
- 타조(Tajo)
- 원 세그(One Seg)
- 포스퀘어(Foursquare)
- 텐서플로(TensorFlow)
정답과 해설 보기
정답: 4
정답은 ④이다. TensorFlow는 Google Brain 팀이 개발하여 공개한 기계 학습 소프트웨어로, 수치 계산과 학습 모델의 구성·실행을 지원한다. 이 문제는 당시의 개발 배경과 도구의 목적을 묻는다. Tajo는 분산 데이터 처리에서 SQL을 사용하는 프로젝트이고 One Seg는 방송 방식의 이름이며 Foursquare는 위치 기반 서비스로 알려져 있어 제시한 기계 학습 라이브러리와 다르다. 특정 팀의 현재 조직 이름을 추정할 필요 없이 공식 보존 자료에 기록된 TensorFlow의 개발 배경을 기준으로 답하면 된다.
선지별 해설
- Tajo는 Google Brain의 기계 학습 라이브러리를 가리키는 이름이 아니다.
- One Seg는 제시한 기계 학습 라이브러리와 다르다.
- Foursquare는 제시한 개발팀의 기계 학습 라이브러리가 아니다.
- Google Brain 팀에서 개발한 TensorFlow가 해당한다.
편집 해설 근거: Google Brain, Computer Systems for Machine Learning (보존된 팀 소개) — Computer Systems for Machine Learning — TensorFlow
84. 2021년 시험 당시의 명칭을 기준으로, 정부 연구개발 지원 아래 NIA와 국내 기업들이 공동 개발하고 소스코드를 공개한 국내 개방형 클라우드 플랫폼은?
[학습용 개정문항]
- N20S
- PaaS-TA
- KAWS
- Metaverse
정답과 해설 보기
정답: 2
정답은 ②이다. 파스-타(PaaS-TA)는 국내에서 연구개발 지원을 받아 NIA와 기업들이 공동 개발하고 소스코드를 공개한 개방형 클라우드 플랫폼이다. 애플리케이션을 개발·배포·실행하는 플랫폼 기능을 제공하려는 PaaS의 성격과 연결해 이해할 수 있다. 이 문항은 시험 시점 이전의 공식 공개 자료에서 사용한 프로젝트 이름을 묻는다. 메타버스처럼 넓은 서비스 개념과 특정 클라우드 플랫폼의 이름을 구별해야 하며, 당시의 구성과 명칭을 현재 모든 클라우드의 표준 구성으로 확대해서는 안 된다.
선지별 해설
- 당시 NIA 자료에서 설명한 국내 개방형 클라우드 플랫폼의 이름이 아니다.
- NIA와 국내 기업들이 공동 개발·공개한 파스-타다.
- 제시한 공식 개발 배경과 연결되는 프로젝트 이름이 아니다.
- 가상 공간·서비스를 가리키는 개념으로 해당 플랫폼 이름이 아니다.
편집 해설 근거: NIA, 파스-타 기반 서비스 개발 및 아이디어 공모전 최종 선정작 발표 (2020-12-10) — 2020-12-10 보도자료의 파스-타 정의와 개발 배경
85. 정보 보안을 위한 접근 제어(Access Control)과 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 정책상 권한이 있는 주체만 허용된 시스템이나 정보에 접근하도록 통제한다.
- 네트워크 접근 규칙의 조건으로 IP 주소, 프로토콜, 포트 등을 사용할 수 있다.
- XDMCP는 DBMS 보안 정책을 적용하는 데이터베이스 전용 접근 제어 도구다.
- 네트워크 장비의 관리 인터페이스 접근 제한과 ACL 등을 사용할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. XDMCP는 X Display Manager Control Protocol로, 독립적인 디스플레이가 원격 호스트의 로그인 서비스를 요청하고 X 세션을 시작하는 과정을 지원한다. DBMS에 보안 정책을 적용하는 전용 접근 제어 도구가 아니다. 접근 제어는 주체가 특정 자원에 어떤 작업을 할 수 있는지 정책에 따라 판단하는 기능이다. 네트워크에서는 주소·프로토콜·포트 기반 규칙을 사용할 수 있고 장비 관리 인터페이스에도 접근 제한을 둘 수 있다. IP 주소만 확인하는 것으로 사용자 인증과 모든 권한 검사가 해결되는 것은 아니다.
선지별 해설
- 인가된 주체가 허용된 자원을 사용하도록 제한하는 접근 제어의 목적이다.
- 주소·프로토콜·포트는 네트워크 규칙의 조건으로 사용할 수 있다.
- XDMCP는 X 디스플레이의 원격 로그인·세션 관리 프로토콜이므로 틀렸다.
- 장비의 관리 인터페이스와 패킷 접근 규칙을 제한할 수 있다.
편집 해설 근거: X.Org, X Display Manager Control Protocol 1.1 — Chapter 1 Purpose and Goals; Chapter 2 Overview of the Protocol; Peter Reiher, OSTEP v1.10, 55 Access Control — Access Control Lists
86. 소프트웨어 개발 프레임워크와 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 공통 구조와 확장 지점을 제공하여 도메인에 맞는 기능을 재사용·확장할 수 있다.
- 애플리케이션의 공통 기능이 구현되어 있어 같은 로직의 반복을 줄일 수 있다.
- 사용자 코드가 항상 직접 호출하기만 하므로 프레임워크는 실행 흐름을 제어할 수 없다.
- 적절하게 적용하면 생산성과 유지보수성을 높이는 데 도움이 될 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 프레임워크는 공통적인 애플리케이션 구조와 확장 지점을 제공하며 개발자가 필요한 부분을 채워 넣도록 한다. 프레임워크가 실행 흐름을 조직하고 사용자 코드를 호출하는 제어의 역전이 중요한 특징이므로, 직접 흐름을 제어할 수 없다는 설명은 반대다. 공통 기능을 재사용하면 반복 구현을 줄일 수 있지만 성능이나 유지보수성이 무조건 보장되는 것은 아니다. 제공하는 구조가 문제에 맞는지, 필요한 확장과 운영을 지원하는지 평가해야 한다. 라이브러리 호출과 프레임워크 사용이 한 프로그램에서 함께 나타날 수도 있다.
선지별 해설
- 공통 구조와 확장 지점을 재사용하는 기반을 제공할 수 있다.
- 이미 구현된 기능을 활용하여 반복 작업을 줄일 수 있다.
- 프레임워크가 사용자 코드를 호출하고 흐름을 제어할 수 있으므로 틀렸다.
- 적절하게 사용하면 생산성과 유지보수성 향상에 도움이 될 수 있다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — Overview of Frameworks; Comparing Class Libraries and Frameworks; Benefits and Limitations; Spring Framework 6.2, Introduction to the Spring IoC Container and Beans — The IoC Container
87. 물리적인 연결 위치와 별도로 논리적인 LAN을 구성하여 브로드캐스트 도메인을 나누는 기술은?
[학습용 개정문항]
- VLAN
- STP
- L2AN
- ARP
정답과 해설 보기
정답: 1
정답은 ①이다. VLAN은 스위치 네트워크에서 물리적인 연결 위치와 별도로 논리적인 LAN을 구성하여 브로드캐스트 도메인을 나누는 기술이다. 같은 스위치에 연결되어도 서로 다른 VLAN으로 분리할 수 있고, 적절한 트렁크 구성을 통해 여러 스위치에 걸쳐 같은 VLAN을 전달할 수 있다. 서로 다른 VLAN 사이의 통신에는 일반적으로 3계층 전달과 관련 정책이 필요하다. STP는 2계층 루프 방지, ARP는 IPv4 주소와 링크 계층 주소의 대응을 알아내는 역할이다. VLAN만 설정했다고 완전한 보안이 자동 확보되지는 않는다.
선지별 해설
- 논리적인 LAN과 브로드캐스트 도메인을 구분하는 VLAN이다.
- STP는 스위치 연결의 루프를 방지하는 프로토콜이다.
- 제시한 논리 LAN 기술의 일반적인 명칭이 아니다.
- ARP는 IPv4 주소에 대응하는 링크 계층 주소를 찾는 프로토콜이다.
편집 해설 근거: Cisco Configuration Assistant SBCS Administrator Guide 3.0.1, VLANs — Virtual LANs; Broadcast Domains
88. SQL Injection 공격과 관련한 설명으로 틀린 것은?
- SQL Injection은 임의로 작성한 SQL 구문을 애플리케이션에 삽입하는 공격방식이다.
- SQL Injection 취약점이 발생하는 곳은 주로 웹 애플리케이션과 데이터베이스가 연동되는 부분이다.
- DBMS의 종류와 관계없이 SQL Injection 공격 기법은 모두 동일하다.
- 로그인과 같이 웹에서 사용자의 입력 값을 받아 데이터베이스 SQL문으로 데이터를 요청하는 경우 SQL Injection을 수행할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. SQL 삽입 취약점은 신뢰할 수 없는 입력이 질의의 데이터로만 처리되지 않고 SQL 구조의 일부로 해석될 때 발생한다. DBMS마다 문법·함수·권한 모델이 달라 구체적인 공격 구문과 영향도 동일하지 않다. 사용자가 입력하는 로그인이나 검색 기능이라도 적절히 매개변수화한 질의를 사용하면 입력을 코드와 분리할 수 있다. 따라서 입력을 받는 모든 기능이 취약하다고 판단해서는 안 된다. 예방에서는 매개변수화, 필요한 경우 허용 목록 검증, 최소 권한을 함께 고려한다.
선지별 해설
- 입력이 SQL 구문의 구조에 영향을 주도록 삽입되는 공격을 뜻한다.
- 애플리케이션이 입력으로 질의를 구성하는 연결 부분에서 발생할 수 있다.
- DBMS별 문법과 기능이 달라 모든 기법이 동일하지 않다.
- 입력값을 안전하지 않게 SQL에 결합하는 경우 취약해질 수 있다.
편집 해설 근거: OWASP — SQL Injection Prevention — Anatomy of a Typical SQL Injection Vulnerability; Primary Defenses; Least Privilege
89. 비대칭 암호화 방식으로 소수를 활용한 암호화 알고리즘은?
- DES
- AES
- SMT
- RSA
정답과 해설 보기
정답: 4
정답은 ④이다. RSA는 공개키와 개인키를 사용하는 비대칭 암호 체계이며 키 생성에서 큰 소수들의 곱으로 만든 모듈러스를 사용한다. 표준적인 RSA 키에서는 공개 지수와 개인 지수가 관련된 모듈러 산술을 구성한다. DES와 AES는 암호화·복호화에 대칭 키를 사용하는 블록 암호이므로 구별된다. 실제 RSA 암호화나 서명에서는 표준이 정한 안전한 인코딩·패딩 방식이 필요하며 단순한 수학 연산만 그대로 사용해서는 안 된다. 이 문항은 비대칭 방식과 소수 활용이라는 두 단서를 묻는다.
선지별 해설
- DES는 대칭 키 블록 암호다.
- AES도 대칭 키 블록 암호다.
- 제시한 RSA의 공개키·소수 기반 조건과 맞는 답이 아니다.
- 큰 소수를 활용하여 키를 구성하는 대표적인 비대칭 암호 체계다.
편집 해설 근거: IETF RFC 8017, PKCS #1: RSA Cryptography Specifications Version 2.2 (2016) — §3 Key Types; §7 Encryption Schemes; §8 Signature Schemes
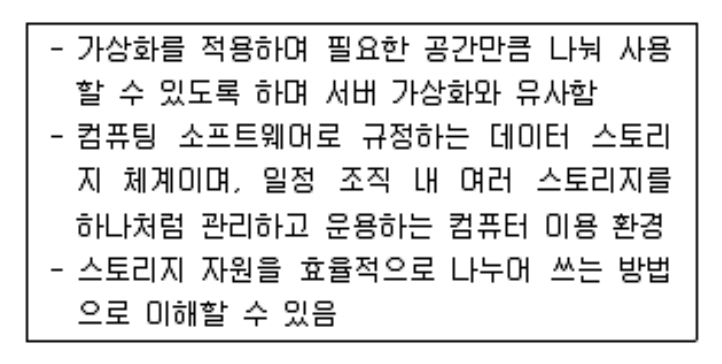
90. 다음에서 설명하는 IT 스토리지 기술은?
- Software Defined Storage
- Distribution Oriented Storage
- Network Architected Storage
- Systematic Network Storage
정답과 해설 보기
정답: 1
정답은 ①이다. SDS는 저장 장치를 제어하고 자원을 배분하는 소프트웨어 계층을 특정 물리 하드웨어와 분리하여 관리하는 접근이다. 여러 저장 자원을 풀로 묶고 정책에 따라 용량·성능·보호 기능을 운영하는 방식 등이 가능하다. 그림의 가상화와 소프트웨어 중심 제어라는 단서는 Software Defined Storage에 대응한다. 물리 디스크가 없어지거나 소프트웨어만으로 용량이 생긴다는 뜻은 아니다. 하드웨어의 특성과 장애 가능성은 여전히 고려하면서 관리와 배치의 유연성을 높이려는 것이다.
선지별 해설
- 저장 자원의 제어·관리를 소프트웨어로 추상화하는 SDS다.
- 그림의 소프트웨어 중심 저장 관리 기술을 가리키는 이름이 아니다.
- 이 문항의 소프트웨어 정의 저장 기술 명칭과 다르다.
- 제시한 기술의 표준적으로 쓰이는 이름은 SDS다.
편집 해설 근거: IBM, What is Software Defined Storage? — What is software-defined storage?; Key features of software-defined storage
91. COCOMO 81에서 경험 있는 비교적 작은 팀이 익숙하고 안정적인 환경의 소프트웨어를 개발하며 제약이 상대적으로 적은 개발 모드는?
[학습용 개정문항]
- Embedded
- Organic
- Semi-detached
- Semi-embeded
정답과 해설 보기
정답: 2
정답은 ②이다. COCOMO 81의 Organic 모드는 비교적 익숙하고 안정적인 환경에서 숙련된 작은 팀이 개발하는 프로젝트의 성격을 나타낸다. Semi-detached는 경험과 제약이 중간적인 경우, Embedded는 하드웨어·운영 환경 등의 제약이 강하게 얽힌 경우를 설명한다. 코드 규모는 비용 산정에 중요하지만 특정 라인 수 하나로 모드를 기계적으로 확정하는 것은 적절하지 않다. 이 문항은 팀의 경험과 환경·제약의 특성을 기준으로 판단하며, 후속 COCOMO II 모델의 분류와도 구별해야 한다.
선지별 해설
- 하드웨어·운영 환경 등 제약이 강하게 얽힌 프로젝트 유형이다.
- 익숙한 환경과 경험 있는 작은 팀에 대응하는 Organic 모드다.
- 경험·제약이 Organic과 Embedded 사이인 중간 유형이다.
- COCOMO 81의 대표적인 세 모드 명칭에 포함되지 않는다.
편집 해설 근거: Barry W. Boehm, Software Engineering Economics (1984), 저자 논문 보존 사본 — COCOMO development modes — Organic, Semidetached, Embedded
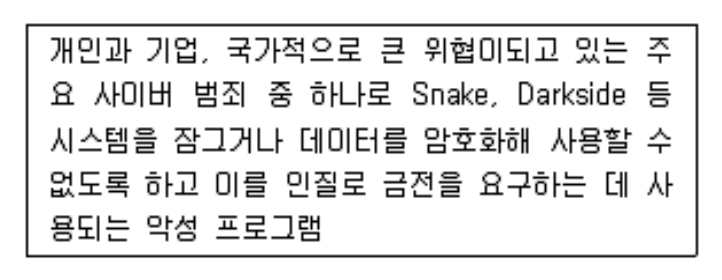
92. 다음 내용이 설명하는 것은?
- Format String
- Ransomware
- Buffer overflow
- Adware
정답과 해설 보기
정답: 2
정답은 ②이다. 랜섬웨어는 파일이나 시스템에 대한 접근을 제한하고 이를 되돌리는 대가 등을 요구하는 악성코드다. 암호화로 업무 자료를 사용할 수 없게 만들거나 자료 유출을 함께 협박하는 방식이 나타날 수 있다. 그림의 금전 요구와 파일 접근 제한이라는 단서가 이에 해당한다. 포맷 문자열과 버퍼 오버플로는 프로그램의 취약점 유형이며 애드웨어는 광고를 표시하는 소프트웨어 범주다. 감염 예방과 복구 준비에는 업데이트, 접근 권한 관리, 분리된 백업과 복원 검증이 함께 필요하다.
선지별 해설
- 포맷 문자열의 부적절한 처리를 악용하는 취약점 유형이다.
- 자료나 시스템 접근을 제한하고 대가를 요구하는 랜섬웨어다.
- 버퍼 경계를 넘는 메모리 접근과 관련된 취약점 유형이다.
- 광고 표시와 관련된 소프트웨어로 문항의 금전 요구·암호화 단서와 다르다.
편집 해설 근거: CISA, #StopRansomware Guide (2023 update) — Ransomware and Data Extortion; Prevention Best Practices
93. 분석·설계·구현·시험 등 단계별 산출물을 확인하며 다음 단계로 진행하는 선형 순차적 생명주기 모형으로, 후반 요구 변경 시 재작업 부담이 커질 수 있는 것은?
[학습용 개정문항]
- Waterfall Model
- Prototype Model
- COCOMO Model
- Spiral Model
정답과 해설 보기
정답: 1
정답은 ①이다. 폭포수 모형은 요구 분석·설계·구현·시험 등 개발 활동을 구분하고 앞 단계의 산출물을 바탕으로 다음 단계로 진행하는 선형 순차적 모형으로 설명된다. 단계 경계와 문서화가 분명한 대신 뒤늦게 요구가 달라지면 여러 산출물의 재작업이 필요할 수 있다. 프로토타입은 시제품으로 요구를 확인하는 접근이고 나선형은 위험 분석을 중심으로 반복한다. COCOMO는 주로 개발 비용과 공수를 추정하는 모델이다. 실제 폭포수 적용에서도 검토와 되돌림이 전혀 불가능하다는 뜻은 아니다.
선지별 해설
- 단계별 산출물과 순차 진행을 강조하는 폭포수 모형이다.
- 시제품을 통해 요구와 사용 경험을 확인하는 모형이다.
- 개발 규모·공수·비용을 추정하는 모델이다.
- 위험 분석과 반복적인 개발·평가를 중심으로 하는 모형이다.
편집 해설 근거: Connell·Wenneson, NASA CR-177625 Software Engineering Guidebook (1993) — §3.2 Software Engineering Life Cycles — waterfall phases; Barry W. Boehm, Software Engineering Economics (1984), 저자 논문 보존 사본 — COCOMO cost estimation model
94. 소프트웨어 생명 주기 모형 중 Spiral Model에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 규모가 크거나 위험을 면밀하게 관리해야 하는 프로젝트에 적용을 검토할 수 있다.
- 각 주기에서 목표와 대안, 위험, 개발·검증 결과, 다음 계획을 검토한다.
- 개발 중의 위험을 식별·평가하고 줄이는 것을 중요하게 다룬다.
- 계획·개발·평가의 주기를 단 한 번만 수행한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 나선형 모형은 반복 주기마다 목표와 대안을 정하고 위험을 식별·평가한 뒤 필요한 개발과 검증을 수행하며 다음 주기를 계획한다. 따라서 한 번의 개발 주기만 수행한다는 설명은 틀렸다. 위험을 줄이기 위해 시제품이나 추가 분석을 사용할 수 있고 다음 활동의 규모와 방식도 위험에 따라 달라진다. 비교적 큰 프로젝트에서 유용할 수 있지만 크기만으로 적합성을 결정하지 않는다. 핵심은 그림의 고정된 단계 이름을 암기하는 것보다 위험에 근거해 반복의 방향을 결정한다는 점이다.
선지별 해설
- 큰 규모나 높은 위험의 프로젝트에서 적용을 검토할 수 있다.
- 목표·위험 평가·개발과 검증·다음 계획을 주기적으로 수행한다.
- 위험을 식별하고 줄이면서 개발 방향을 정하는 것이 핵심이다.
- 개발과 평가의 반복 주기를 한 번만 수행하는 모형이 아니다.
편집 해설 근거: Barry W. Boehm, A Spiral Model of Software Development and Enhancement (1988), 논문 보존 사본 — A Typical Cycle of the Spiral; Risk-driven Approach
95. 특정 사이트에 매우 많은 ICMP Echo를 보내면, 이에 대한 응답 (Respond)을 하기 위해 시스템 자원을 모두 사용해버려 시스템이 정상적으로 동작하지 못하도록 하는 공격방법은?
- Role-Based Access Control
- Ping Flood
- Brute-Force
- Trojan Horses
정답과 해설 보기
정답: 2
정답은 ②이다. Ping Flood는 많은 ICMP Echo 요청이나 관련 트래픽을 발생시켜 대상 또는 연결망의 처리 능력과 대역폭을 소모시키는 서비스 거부 공격이다. 일반적인 ping은 연결 상태 확인에 사용되지만 양이 처리 한계를 넘으면 정상 이용이 어려워질 수 있다. 모든 경우에 반드시 CPU 자원 전체가 소진되는 것은 아니며 네트워크 혼잡이나 장비 처리 한계로도 장애가 발생한다. 역할 기반 접근 제어는 보안 정책, 무차별 대입은 반복적인 추측, 트로이목마는 정상 프로그램처럼 위장한 악성코드와 관련된다.
선지별 해설
- 역할에 따라 권한을 부여하는 접근 제어 방식이다.
- ICMP Echo 트래픽으로 자원·대역폭을 소모하는 Ping Flood다.
- 암호나 인증값 등을 반복 추측하는 공격 방식을 뜻한다.
- 정상 프로그램처럼 보이게 위장한 악성코드의 종류다.
편집 해설 근거: Cloudflare, Ping (ICMP) flood DDoS attack — What is a Ping flood attack?; How does a Ping flood attack work?; IETF RFC 792 — Internet Control Message Protocol — Echo or Echo Reply Message
96. TCP/IP 기반 네트워크에서 동작하는 발행-구독 기반의 메시징 프로토콜로 최근 IoT 환경에서 자주 사용되는 프로토콜은?
- MLFQ
- MQTT
- Zigbee
- MTSP
정답과 해설 보기
정답: 2
정답은 ②이다. MQTT는 메시지를 주제에 따라 발행하고 구독자에게 전달하는 방식의 프로토콜이다. 클라이언트가 서버인 브로커와 연결하고 주제에 메시지를 발행하거나 관심 주제를 구독한다. 가벼운 메시징과 연결 관리 기능 덕분에 IoT 환경에서도 활용된다. MQTT 5.0은 TCP/IP 또는 순서 보장·손실 없는 양방향 전송을 제공하는 다른 네트워크 연결 위에서 동작하도록 정의한다. 따라서 MQTT가 특정 무선 전송 기술 자체라고 이해하면 안 되며 브로커를 통한 응용 메시지 교환과 하위 통신망을 구별해야 한다.
선지별 해설
- MLFQ는 다단계 피드백 큐 스케줄링 문맥에서 쓰이는 이름이다.
- 주제 기반 발행·구독 메시징 프로토콜인 MQTT다.
- Zigbee는 저전력 무선 네트워크 기술로 이 메시징 프로토콜과 다르다.
- 제시한 발행·구독 메시징 프로토콜의 이름이 아니다.
편집 해설 근거: OASIS, MQTT Version 5.0 Standard (2019) — §1 Introduction; §1.2 Terminology; §4.2 Network Connections
97. 한 시스템에서 인증을 완료하면 연계된 다른 시스템에도 다시 로그인하지 않고 접근할 수 있게 하는 방식은?
- SOS
- SBO
- SSO
- SOA
정답과 해설 보기
정답: 3
정답은 ③이다. SSO는 한 번의 인증 결과를 신뢰 관계가 설정된 여러 애플리케이션에서 활용하여 사용자가 같은 인증 절차를 반복하는 부담을 줄이는 방식이다. 모든 시스템이 자동으로 연결되는 것은 아니며 인증 제공자와 각 서비스의 연동·검증이 필요하다. 또한 로그인에 성공했다는 사실과 특정 자료를 볼 권한이 있다는 사실은 다르므로 서비스별 권한 검사는 계속 적용된다. 세션 만료나 추가 인증 정책에 따라 다시 인증을 요구할 수도 있다. SOA는 서비스 중심의 구조 설계 개념이므로 SSO와 구별한다.
선지별 해설
- 여러 서비스에서 인증 결과를 활용하는 기능의 약어가 아니다.
- 제시한 인증 방식의 일반적인 이름이 아니다.
- Single Sign-On으로 연계된 서비스의 반복 로그인을 줄인다.
- Service-Oriented Architecture는 서비스 중심 구조를 뜻한다.
편집 해설 근거: Microsoft Entra, What is single sign-on? — What is single sign-on?; SSO flow
98. 같은 비밀번호라도 서로 다른 저장용 해시 결과가 나오도록 비밀번호 해싱 함수에 함께 넣는 계정별 무작위 추가 값은?
[학습용 개정문항]
- Pass flag
- Bucket
- Opcode
- Salt
정답과 해설 보기
정답: 4
정답은 ④이다. 솔트는 비밀번호를 저장용으로 해시할 때 비밀번호와 함께 입력하는 계정별 또는 비밀번호별 값이다. 충분한 무작위 솔트를 사용하면 같은 비밀번호를 사용하더라도 저장되는 결과가 달라져 사전 계산 결과를 여러 계정에 재사용하기 어렵게 한다. 솔트는 보통 해시 결과와 함께 저장해도 되며 비밀 키와 같은 역할은 아니다. 적절한 비밀번호 해싱 방식과 비용 설정도 필요하다. 일반적인 비밀번호 저장을 복호화 가능한 암호화만으로 해결하거나 솔트 하나로 모든 추측 공격이 불가능해진다고 생각해서는 안 된다.
선지별 해설
- 비밀번호 해싱에 추가하는 무작위 값의 일반적인 명칭이 아니다.
- 버킷은 주로 저장·분류 단위를 뜻하며 솔트와 다르다.
- Opcode는 명령의 연산 종류를 나타내는 코드다.
- 계정별 저장 해시를 다르게 만드는 추가 입력 값인 Salt다.
편집 해설 근거: NIST SP 800-63B-4, Digital Identity Guidelines: Authentication and Authenticator Management (2025) — §3.1.1.2 Password Verifiers
99. 각 기능의 원시 코드 라인 수를 낙관값·가장 가능성 높은 값·비관값으로 추정하고, 예상 라인 수와 생산성을 이용해 공수·비용을 산정하는 규모 기반 기법은?
[학습용 개정문항]
- Effort Per Task기법
- 전문가 감정 기법
- 델파이기법
- LOC기법
정답과 해설 보기
정답: 4
정답은 ④이다. LOC 기법은 소스 코드의 예상 라인 수를 소프트웨어 규모의 기준으로 사용하고 생산성 등의 가정과 연결하여 공수·비용을 추정한다. 각 기능에 대해 낙관적 규모, 가장 가능성이 높은 규모, 비관적 규모를 잡아 불확실성을 반영할 수 있다. 3점 가중 추정을 사용하는 경우에는 보통 (낙관값+4×최빈값+비관값)÷6 같은 값을 계산하지만 이것이 모든 LOC 산정에 강제되는 유일한 공식은 아니다. 전문가 판단과 델파이는 추정값을 얻는 방법이고 LOC는 여기서 규모의 단위라는 점이 핵심이다.
선지별 해설
- 작업별 필요한 노력을 추정하는 접근으로 라인 수라는 규모 기준과 다르다.
- 전문가의 경험과 판단에 의존하는 추정 방식이다.
- 여러 전문가의 추정을 반복 조정하는 방식이다.
- 원시 코드 라인 수를 규모로 사용하므로 LOC 기반 산정이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Management §2.3 Effort, Schedule, and Cost Estimation; R. G. Batson, NASA TM-100311 Program Risk Analysis Handbook (1987) — p. 30, §E Analytical Technique, Steps 1–2
100. 오픈소스 웹 애플리케이션 보안 프로젝트로서 주로 웹을 통한 정보 유출, 악성 파일 및 스크립트, 보안 취약점 등을 연구하는 곳은?
- WWW
- OWASP
- WBSEC
- ITU
정답과 해설 보기
정답: 2
정답은 ②이다. OWASP는 소프트웨어 보안을 개선하기 위해 공개 프로젝트·문서·도구와 커뮤니티 활동을 지원하는 비영리 재단이다. 웹 애플리케이션 보안 위험을 정리하는 OWASP Top 10 등으로 널리 알려져 있으며 개발자와 조직이 취약점을 이해하고 줄이는 데 필요한 자료를 제공한다. 시험 당시의 이름은 Open Web Application Security Project였으며 현재 공식 소개에서는 Open Worldwide Application Security Project라는 이름을 사용한다. WWW는 웹 자체를, ITU는 국제전기통신연합을 가리키므로 구별해야 한다.
선지별 해설
- World Wide Web으로 웹 시스템을 가리키며 해당 보안 재단의 이름이 아니다.
- 공개 소프트웨어 보안 프로젝트와 자료를 지원하는 OWASP다.
- 제시한 비영리 보안 프로젝트·재단의 이름이 아니다.
- 국제전기통신연합으로 OWASP와 다른 기구다.
편집 해설 근거: OWASP Foundation, About OWASP — About OWASP; Our Mission; OWASP Global Board, February 2023 name-change resolution — February 2023 — Open Web to Open Worldwide resolution
정보처리기사 필기 기출문제 학습 방법
먼저 PDF 문제지를 시간에 맞춰 푼 뒤, 이 글에서 오답의 정답·해설·근거를 확인하세요. 법규 문항은 근거 기준일 이후 개정 여부도 함께 확인하는 것이 안전합니다.