
문제지 PDF · 웹 정답 해설
정보처리기사 필기 2015년 1회 공개기출 100문항
정보처리기사 필기 2015년 1회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.

© 자격증3001. 이 정보처리기사 필기 기출문제 게시물의 문제 재구성 문장, 해설, 재작성 도식, 편집 및 PDF 디자인은 자격증3001의 저작권 보호를 받습니다. 국가기술자격 시험 및 관련 명칭의 권리는 해당 기관에 있으며, 본 자료는 Q-Net 공식 문제지 또는 공식 해설이 아닙니다. 무단 복제·재배포를 금합니다.
정보처리기사 필기 2015년 1회 공개기출 100문항 안내
정보처리기사 필기 2015년 1회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.
이 회차의 100문항 해설을 문항별 기술 원문과 필요한 독립 계산으로 편집 검토했습니다. 질문·조건·보기를 고친 문항은 학습용 개정문항으로 표시합니다. 원 시험의 공식 원문이나 공식 정답표를 새로 확인한 자료는 아닙니다.
정보처리기사 필기 기출문제 · 데이터베이스
1. PostgreSQL 18에서 인사 테이블을 참조하는 외래 키 제약조건과 종속 뷰가 존재한다. 다음 SQL문의 실행 결과를 가장 정확하게 설명한 것은?
[학습용 개정문항]
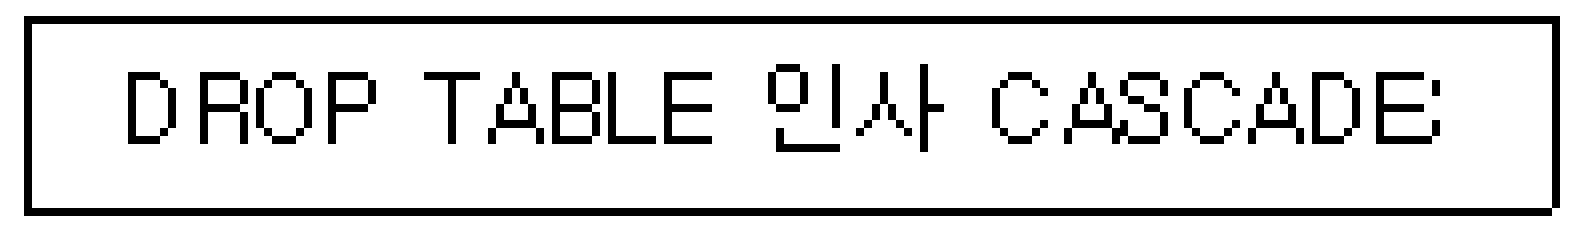
DROP TABLE 인사 CASCADE;
- 인사 테이블의 행만 삭제하고 테이블 정의와 종속 객체는 유지한다.
- 인사 테이블과 종속 뷰·외래 키 제약조건은 제거하지만, 외래 키로 참조하던 다른 테이블 자체는 남긴다.
- 종속 객체가 있으므로 CASCADE를 지정해도 인사 테이블의 제거를 항상 거부한다.
- 인사 테이블을 제거할지 사용자에게 확인 질문을 표시한다.
정답과 해설 보기
정답: 2
정답은 ②이다. DROP TABLE은 행만 비우는 명령이 아니라 테이블 자체를 제거하는 명령이다. PostgreSQL에서 CASCADE는 제거 대상에 의존하는 객체도 함께 제거하도록 지정한다. 이때 ‘의존하는 객체’가 무엇인지 구별하는 것이 핵심이다.
인사 테이블을 조회하는 종속 뷰는 제거된다. 다른 테이블에 정의된 외래 키가 인사 테이블을 참조한다면 제거되는 것은 그 외래 키 제약조건이다. 외래 키를 가진 다른 테이블과 그 안의 데이터까지 통째로 삭제되는 것은 아니다. 기본값 RESTRICT는 다른 객체가 의존하면 제거를 거부하지만, 이 문장에는 CASCADE가 명시되어 있다. SQL 명령 자체가 사용자에게 대화형 확인 질문을 한다는 설명도 틀렸다.
기존 사이트의 ‘참조하는 테이블까지 제거한다’는 보기에는 제약조건 제거와 테이블 제거의 혼동이 있었다. 이 문항은 PostgreSQL 18을 명시한 학습용 개정문항이다. 과거 시험의 공식 정답을 새로 판정한 것으로 해석하지 않는다.
선지별 해설
- ① 오답. 행을 삭제하고 테이블 정의를 남기는 동작은 DELETE와 구분해야 한다. DROP TABLE은 테이블을 제거한다.
- ② 정답. 종속 뷰는 제거하고, 참조 테이블에서는 외래 키 제약조건을 제거하며 테이블 자체는 남긴다.
- ③ 오답. 종속 객체 때문에 거부하는 기본 동작은 RESTRICT이며, 이 SQL은 CASCADE를 지정했다.
- ④ 오답. CASCADE는 종속 객체 처리 방식이다. 사용자에게 확인 질문을 표시하라는 지시가 아니다.
편집 해설 근거: PostgreSQL 18: DROP TABLE — Description 제2문단; Parameters CASCADE·RESTRICT
2. Which of the following does not belong to the DDL statement of SQL?
- CREATE
- DELETE
- DROP
- ALTER
정답과 해설 보기
정답: 2
정답은 ② DELETE이다. DDL은 테이블 같은 데이터베이스 객체의 구조를 정의하거나 변경하는 명령을 묶는 분류이다. CREATE는 객체를 만들고, ALTER는 그 정의를 바꾸며, DROP은 객체를 제거한다. DELETE는 이미 존재하는 테이블의 행을 지우는 데이터 조작 명령이다.
예를 들어 DELETE FROM 인사 WHERE 부서='영업';은 조건에 맞는 행을 지워도 인사 테이블의 열 정의를 남긴다. 반면 DROP TABLE 인사;는 테이블 객체를 제거한다. 같은 ‘삭제’라는 일상어를 쓰더라도 삭제 대상이 행인지 구조인지를 구분해야 한다.
문제의 does not belong은 ‘속하지 않는 것’을 찾으라는 부정형 질문이다. CREATE·ALTER·DROP을 고르는 역선택에 주의한다.
선지별 해설
- ① CREATE — 객체를 생성하는 DDL이므로 이 부정형 문항의 답이 아니다.
- ② DELETE — 테이블의 행을 삭제하는 데이터 조작 명령이므로 DDL에 속하지 않는다.
- ③ DROP — 테이블 등 객체의 정의를 제거하는 DDL이다.
- ④ ALTER — 기존 객체의 구조나 속성을 변경하는 DDL이다.
편집 해설 근거: PostgreSQL 18: Data Definition — Chapter 5 개요 및 Removing Tables·Modifying Tables; PostgreSQL 18: DELETE — Description 첫 문단
3. Which of the following is a linear list in that elements are accessed, created and deleted in a last-in-first-out order?
- Queue
- Graph
- Stack
- Tree
정답과 해설 보기
정답: 3
정답은 ③ Stack이다. LIFO는 last in, first out의 약자로, 가장 나중에 넣은 항목을 먼저 꺼내는 규칙이다. 빈 스택에 A를 넣고 다음에 B를 넣었다면 꼭대기는 B이다. 한 번 꺼내면 B, 다시 꺼내면 A가 나온다. 넣는 동작을 push, 꺼내는 동작을 pop이라고 부른다.
큐는 먼저 들어온 항목이 먼저 나오는 FIFO의 대표 예이므로 같은 입력 A, B에 대해 출력 순서가 A, B이다. 그래프와 트리는 연결 관계 또는 계층을 나타내는 구조이며, 그 이름 자체가 이 문제의 LIFO 선형 리스트를 뜻하지 않는다.
‘자료를 넣고 지울 수 있다’는 공통점이 아니라, 지문에 주어진 접근 순서가 판정 기준이다.
선지별 해설
- ① Queue — 보통 FIFO를 설명하므로 지문의 LIFO 순서와 반대이다.
- ② Graph — 정점과 간선의 관계를 나타내며 LIFO 선형 리스트의 이름이 아니다.
- ③ Stack — 마지막으로 넣은 항목을 먼저 꺼내는 구조이다.
- ④ Tree — 부모·자식의 계층 구조를 나타내며, 트리라는 사실만으로 LIFO가 정의되지 않는다.
편집 해설 근거: Python 공식 자습서: Data Structures — 5.1.1 Using Lists as Stacks; 5.1.2 Using Lists as Queues
4. 시스템 카탈로그에 대한 설명으로 옳지 않은 것은?
- 시스템 카탈로그는 DBMS가 스스로 생성하고 유지하는 데이터베이스 내의 특별한 테이블들의 집합체이다.
- 일반 사용자도 시스템 카탈로그의 내용을 검색할 수 있다.
- 시스템 카탈로그 내의 각 테이블은 DBMS에서 지원하는 개체들에 관한 정보를 포함한다.
- 시스템 카탈로그에 대한 갱신은 데이터베이스의 무결성 유지를 위하여 사용자가 직접 갱신해야 한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 시스템 카탈로그는 테이블·열·자료형·제약조건 등 데이터베이스 객체에 관한 정보를 저장하는 메타데이터 집합이다. 사용자가 CREATE TABLE 같은 명령을 실행하면 DBMS는 실제 객체의 정의에 맞게 카탈로그도 관리한다. 일반적인 관리 방식은 지원되는 SQL 명령을 사용하는 것이며, 사용자가 무결성을 위해 카탈로그 행을 반드시 직접 고쳐야 하는 것이 아니다.
카탈로그를 조회하는 일과 카탈로그를 직접 수정하는 일은 다르다. 사용자에게 공개된 메타데이터를 검색할 수 있지만, 모든 내부 정보가 누구에게나 제한 없이 공개된다는 뜻은 아니다. 또한 PostgreSQL에서 권한에 따라 일부 카탈로그를 직접 변경할 수 있다는 사실은 ‘직접 갱신해야 한다’는 보기의 정당화가 되지 않는다.
옳지 않은 것을 묻는 문제이므로 ④의 의무 표현을 찾아야 한다.
선지별 해설
- ① 옳은 설명. DBMS가 생성·유지하는 메타데이터 테이블들의 집합이라는 일반 개념에 부합한다.
- ② 옳은 설명. 일반 사용자도 허용된 카탈로그 정보를 조회할 수 있다. 모든 카탈로그의 모든 열에 무제한 접근한다는 뜻은 아니다.
- ③ 옳은 설명. 카탈로그에는 DBMS가 관리하는 객체와 그 정의에 관한 정보가 담긴다.
- ④ 정답인 틀린 설명. 사용자가 무결성 유지를 위해 카탈로그를 직접 갱신해야 한다는 주장이 잘못이다.
편집 해설 근거: PostgreSQL 18: System Catalogs — Chapter 52 개요, 카탈로그와 일반 SQL 명령에 관한 설명
5. 릴레이션 R1에 저장된 튜플이 릴레이션 R2에 있는 튜플을 참조하려면 참조되는 튜플이 반드시 R2에 존재해야 한다는 무결성 규칙은?
- 개체 무결성 규칙(Entity Integrity Rule)
- 참조 무결성 규칙(Referential Integrity Rule)
- 영역 무결성 규칙(Domain Integrity Rule)
- 트리거 규칙 (Trigger Rule)
정답과 해설 보기
정답: 2
정답은 ② 참조 무결성이다. 두 릴레이션 사이의 참조가 끊기지 않도록 하는 규칙이다. 예를 들어 주문 테이블의 고객번호가 고객 테이블의 고객번호를 참조한다면, 실제로 참조하는 고객번호에 대응하는 고객 행이 존재해야 한다. 존재하지 않는 고객번호를 가진 주문을 허용하면 참조 관계가 깨진다.
개체 무결성은 기본 키가 행을 식별할 수 있도록 중복과 NULL을 허용하지 않는 성질에 초점을 둔다. 영역 무결성은 값의 자료형·범위 등 허용 영역의 문제이다. 트리거는 사건에 따라 동작을 실행하는 수단이며 이 참조 규칙의 이름이 아니다.
외래 키가 항상 기본 키만 참조해야 한다거나 언제나 NULL을 가질 수 없다는 뜻으로 확대하지 않는다. DBMS의 요건을 만족하는 유일 키도 참조 대상이 될 수 있고, NULL 허용 여부는 별도 제약조건에 따라 달라진다.
선지별 해설
- ① 개체 무결성 — 각 행을 식별하는 기본 키의 중복·NULL 문제이므로 다른 릴레이션의 참조 대상 존재를 묻는 지문과 다르다.
- ② 참조 무결성 — 참조하는 값에 대응하는 대상 행이 존재해야 한다는 규칙이다.
- ③ 영역 무결성 — 자료형·범위·허용값의 문제로, 두 릴레이션 간 연결 규칙과 구별된다.
- ④ 트리거 규칙 — 트리거는 실행 장치이며 이 무결성 개념의 명칭이 아니다.
편집 해설 근거: PostgreSQL 18: Constraints — 5.5.4 Primary Keys; 5.5.5 Foreign Keys
6. 데이터베이스의 정의 중 다음 설명과 관계되는 것은?
- Integrated Data
- Stored Data
- Operational Data
- shared Data
정답과 해설 보기
정답: 3
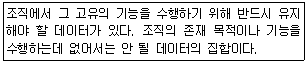
정답은 ③ Operational Data(운영 데이터)이다. 그림은 데이터가 저장된 장소나 공유 방식보다, 조직이 본래 업무를 수행하는 데 필요한가를 설명한다. 예를 들어 판매 업무를 계속하려면 주문·재고·고객 거래 정보가 필요하다. 이런 업무 수행 목적에 초점을 둔 표현이 운영 데이터이다.
통합 데이터는 여러 자료를 일관된 형태로 묶고 불필요한 중복을 줄였다는 관점이고, 저장 데이터는 저장장치에 기록했다는 관점이다. 공유 데이터는 여러 사용자나 응용프로그램이 함께 이용한다는 관점이다. 하나의 데이터베이스가 이 성질들을 동시에 가질 수 있으므로, 서로 배타적인 데이터 종류로 외우기보다 지문의 강조점을 찾아야 한다.
선지별 해설
- ① 오답. 통합·중복 조정 여부에 관한 표현이며 지문은 조직의 업무 수행 목적을 강조한다.
- ② 오답. 저장장치에 기록되어 있다는 성질이다.
- ③ 정답. 조직의 고유 업무를 수행하는 데 필요한 데이터를 뜻한다.
- ④ 오답. 여러 사용자·응용프로그램의 공동 이용을 강조하는 표현이다.
편집 해설 근거: OpenStax, Foundations of Information Systems, 2.1 — 2.1, structured data 아래 operational data 항목; Ramakrishnan·Gehrke, Database Management Systems 3판, Introduction — 슬라이드 2~4, What Is a DBMS? / Why Use a DBMS?
7. 정규화의 필요성으로 거리가 먼 것은?
- 데이터 구조의 안정성 최대화
- 중복 데이터의 활성화
- 수정, 삭제 시 이상현상의 최소화
- 테이블 불일치 위험의 최소화
정답과 해설 보기
정답: 2
정답은 ② 중복 데이터의 활성화이다. 정규화는 속성 사이의 함수 종속 등을 분석하여 릴레이션을 적절히 분해하는 과정이다. 같은 사실이 여러 행에 반복되면서 생기는 갱신·삽입·삭제 이상을 줄이는 것이 중요한 목적이다.
예를 들어 직원마다 같은 부서 전화번호를 반복 저장하면 전화번호 변경 때 일부 행만 고쳐 서로 다른 번호가 남을 수 있다. 부서 정보를 별도로 관리하면 이런 중복 사실의 불일치를 줄일 수 있다. 따라서 중복을 일부러 늘린다는 ②는 목적에 어긋난다. 다만 정규화가 모든 중복을 없애거나 모든 질의의 속도를 높여 준다는 뜻은 아니다. 분해할 때는 무손실 조인 등도 확인해야 한다.
선지별 해설
- ① 오답. 의존 관계에 맞게 구조를 정리하여 데이터 구조의 안정성을 높이려는 설명이다.
- ② 정답. 정규화는 불필요한 중복과 그로 인한 이상을 줄이려는 것이므로 반대 방향이다.
- ③ 오답. 갱신·삭제 이상을 줄이는 것은 정규화의 대표 목적이다.
- ④ 오답. 동일 사실을 여러 곳에서 서로 다르게 관리할 위험을 줄인다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Schema Refinement — 슬라이드 2, The Evils of Redundancy; 정상형·분해 절
8. 해싱에서 동일한 홈 주소로 인하여 충돌이 일어난 레코드들의 집합을 의미하는 것은?
- Overflow
- Bucket
- Synonym
- Collision
정답과 해설 보기
정답: 3
정답은 ③ Synonym(동의어)이다. 해시 함수가 서로 다른 키를 같은 홈 주소로 보내면 그 키들을 동의어라고 부른다. 충돌은 같은 주소로 대응되는 현상이고, 동의어는 그 현상에 관계된 서로 다른 키·레코드를 가리킨다는 차이가 있다.
예를 들어 h(k)=k를 10으로 나눈 나머지라고 정하면 키 12와 22의 홈 주소는 모두 2이다. 12와 22는 동의어이고, 둘을 같은 저장 위치에 넣으려 할 때의 문제가 충돌이다. 버킷은 레코드를 담는 저장 구역이며, 그 버킷의 허용 공간까지 부족해지는 상태는 오버플로이다. 충돌이 생겼다는 사실만으로 반드시 저장 공간이 모두 찼다고 판단하지 않는다.
선지별 해설
- ① 오답. 정해진 저장 구역의 수용 용량을 넘는 오버플로를 가리킨다.
- ② 오답. 레코드를 수용하는 저장 구역이다. 같은 주소로 대응된 키의 이름이 아니다.
- ③ 정답. 같은 해시 주소로 사상되는 서로 다른 키·레코드를 뜻한다.
- ④ 오답. 같은 주소로 대응되는 현상이며, 문항이 묻는 레코드들의 명칭과 구별한다.
편집 해설 근거: UC San Diego CSE 202, Hashing (2002) — Hash Functions / Synonyms 정의
9. 트랜잭션의 연산은 데이터베이스에 모두 반영되든지 아니면 전혀 반영되지 않아야 한다는 트랜잭션의 특징은?
- Consistency
- Isolation
- Atomicity
- Durability
정답과 해설 보기
정답: 3
정답은 ③ Atomicity(원자성)이다. 트랜잭션으로 묶인 변경은 하나의 작업 단위로 확정되거나 취소되어야 한다. 예를 들어 계좌 이체에서 보내는 계좌의 출금만 확정되고 받는 계좌의 입금은 사라지면 이 단위가 깨진다. 원자성은 이러한 부분 반영을 허용하지 않는 성질이다.
Consistency(일관성)는 트랜잭션 전후에 정의된 무결성 규칙을 만족하는 상태를 유지하는 것, Isolation(격리성)은 동시에 실행되는 트랜잭션 사이의 관찰·간섭을 제어하는 것, Durability(지속성)는 성공적으로 확정된 결과를 장애 후에도 보존하는 것이다. ‘모두 또는 전혀’는 원자성의 단서이고, ‘확정한 뒤 잃지 않는다’는 지속성의 단서이다. 격리 수준별 세부 보장은 DBMS 설정에 따라 달라진다.
선지별 해설
- ① 오답. 정의된 제약조건과 일관된 상태에 관한 성질이다.
- ② 오답. 동시 트랜잭션 사이의 간섭과 가시성에 관한 성질이다.
- ③ 정답. 하나의 트랜잭션에 속한 변경을 전부 확정하거나 전부 취소한다.
- ④ 오답. 확정된 결과를 이후 장애에도 보존하는 성질이다.
편집 해설 근거: PostgreSQL 18, 3.4 Transactions — 3.4 첫 단락 및 atomic·permanent·ROLLBACK 설명; Ramakrishnan·Gehrke, Database Management Systems 3판, Introduction — 슬라이드 11, Transaction: An Execution of a DB Program
10. 데이터 중복으로 인해 릴레이션 조작 시 예상하지 못한 곤란한 현상이 발생한다. 이를 무엇이라고 하는가?
- normalization
- degree
- cardinality
- anomaly
정답과 해설 보기
정답: 4
정답은 ④ anomaly(이상 현상)이다. 관계형 데이터베이스에서 한 사실을 여러 곳에 중복 저장하면 행을 넣거나 고치거나 지울 때 의도하지 않은 제약이나 정보 손실이 생길 수 있다. 이런 문제를 삽입 이상·갱신 이상·삭제 이상으로 구분한다.
예를 들어 직원과 부서 정보를 한 테이블에만 보관하여 부서의 마지막 직원을 삭제할 때 부서 전화번호까지 잃는다면 삭제 이상이다. 전화번호를 여러 행 중 일부에서만 바꾸어 값이 엇갈리는 것은 갱신 이상이다. 정규화는 이런 문제를 줄이기 위한 구조 개선 과정이지 문제 현상 자체의 이름이 아니다. 차수(degree)는 속성 수, 카디널리티(cardinality)는 튜플 수이므로 구조의 크기를 나타내는 용어와도 구별한다.
선지별 해설
- ① 오답. 정규화는 이상을 줄이기 위한 릴레이션 설계·분해 과정이다.
- ② 오답. 차수는 릴레이션의 속성 개수이다.
- ③ 오답. 카디널리티는 릴레이션에 있는 튜플 개수이다.
- ④ 정답. 중복·부적절한 종속 관계로 조작 때 발생하는 삽입·갱신·삭제 이상을 뜻한다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Schema Refinement — 슬라이드 2~3, The Evils of Redundancy; Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — 슬라이드 3~4, Relational Database: Definitions / Example Instance
11. 데이터베이스의 물리적 설계안을 비교하는 직접적인 성능·저장공간 평가 지표로 보기 어려운 것은?
[학습용 개정문항]
- 스키마의 평가
- 응답시간
- 저장공간의 효율화
- 트랜잭션 처리도(throughput)
정답과 해설 보기
정답: 1
정답은 ① 스키마의 평가이다. 이 학습용 문항은 물리적 설계안을 비교할 때 직접 측정하는 성능·자원 사용 지표를 묻는다. 응답시간은 요청부터 결과까지 걸리는 시간, 처리도는 단위 시간에 완료한 작업 수, 저장공간 효율은 같은 데이터를 얼마나 적절한 공간에 저장하는가에 관한 것이다.
‘스키마의 평가’는 설계 내용을 검토하는 활동의 넓은 이름이므로 나머지 세 가지와 같은 측정 지표가 아니다. 그렇다고 물리적 설계 중에는 스키마를 평가하거나 수정하지 않는다고 외우면 틀린다. 실제로 인덱스·클러스터링·작업 부하를 검토하면서 논리 스키마로 되돌아가 조정할 수 있다. 기존 질문의 포괄적인 표현을 평가 지표의 비교로 좁혀, 이 차이를 분명히 했다.
선지별 해설
- ① 정답. 설계 검토 활동을 가리키는 넓은 표현이며 직접적인 성능·공간 측정 지표가 아니다.
- ② 오답. 요청 처리에 걸리는 시간을 측정하는 성능 지표이다.
- ③ 오답. 물리적 저장 구조의 자원 사용을 평가하는 관점이다.
- ④ 오답. 단위 시간에 완료하는 트랜잭션 수를 나타내는 처리량 지표이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Physical Database Design — 슬라이드 2 Overview; 슬라이드 24 Summary
12. 순서가 A, B, C, D 로 정해진 입력 자료를 스택에 입력하였다가 출력한 결과로 가능한 것이 아닌 것은? (단, 왼쪽부터 먼저 출력된 순서이다.)
- D, C, B, A
- D, A, B, C
- A, B, C, D
- C, B, A, D
정답과 해설 보기
정답: 2
정답은 ② D, A, B, C이다. 입력 순서를 A→B→C→D로 지키면서 push와 pop을 중간에 섞을 수 있는 한 개의 스택을 생각한다. D를 첫 번째로 꺼내려면 A·B·C도 먼저 넣어야 한다. D를 꺼낸 직후 꼭대기에는 C가 있으므로 다음에 A를 꺼낼 수 없다.
①은 네 개를 모두 넣고 연속으로 꺼내면 된다. ③은 A를 넣고 바로 꺼낸 뒤 B·C·D도 같은 방식으로 처리하면 된다. ④는 A·B·C를 넣은 다음 C·B·A를 꺼내고 마지막에 D를 넣었다 꺼내면 된다. ‘입력 순서가 정해졌다’는 말은 모든 입력을 마친 후에만 출력한다는 뜻이 아니다. 그 조건이라면 가능한 결과가 ① 하나뿐이 되므로 중간 출력 허용 여부를 구별해야 한다.
선지별 해설
- ① 오답. push A,B,C,D 후 pop D,C,B,A로 가능하다.
- ② 정답. D를 먼저 꺼내면 그 아래 C가 막고 있어 A를 바로 꺼낼 수 없다.
- ③ 오답. 각 항목을 넣는 즉시 꺼내면 가능하다.
- ④ 오답. A,B,C를 넣고 C,B,A를 꺼낸 뒤 D를 처리하면 가능하다.
편집 해설 근거: Python 공식 자습서: Data Structures — 5.1.1 Using Lists as Stacks
13. 다음 자료를 버블 정렬을 이용하여 오름차순으로 정렬할 경우 PASS 3의 결과는?
- 6, 3, 5, 7, 9
- 3, 5, 6, 7, 9
- 6, 7, 3, 5, 9
- 3, 5, 9, 6, 7
정답과 해설 보기
정답: 2
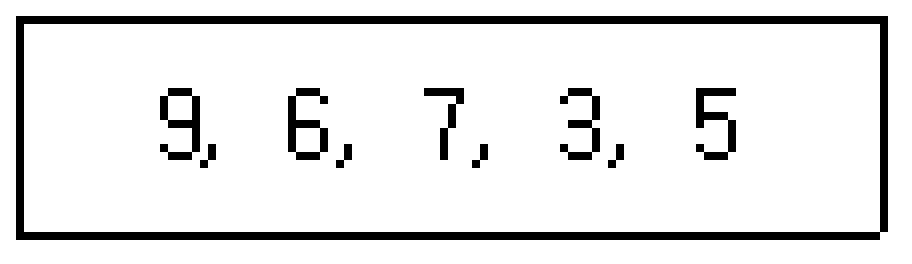
정답은 ② 3, 5, 6, 7, 9이다. 주어진 배열은 9, 6, 7, 3, 5이고, 이 풀이의 한 패스는 왼쪽부터 인접한 두 수를 비교하여 큰 수를 오른쪽으로 보내는 과정이다. 첫 패스에서 9가 끝으로 이동하여 6, 7, 3, 5, 9가 된다.
두 번째 패스에서는 미정렬 구간의 7이 뒤로 이동하여 6, 3, 5, 7, 9가 된다. 세 번째 패스에서는 6과 3을 바꾸고, 이어 6과 5를 바꾸어 3, 5, 6, 7, 9가 된다. 따라서 PASS 3의 결과는 ②이다. 한 번의 자리 교환을 한 패스로 세거나, 반대 방향으로 훑는 변형 알고리즘의 중간 상태와 섞으면 다른 결과가 나오므로 패스의 방향과 범위를 먼저 정해야 한다.
선지별 해설
- ① 오답. 왼쪽부터 훑는 이 절차의 두 번째 패스 결과이다.
- ② 정답. 세 번째 패스에서 6이 3과 5 뒤로 이동한 결과이다.
- ③ 오답. 첫 번째 패스에서 9를 맨 뒤로 보낸 결과이다.
- ④ 오답. 첫 패스에서 최대값 9가 맨 뒤에 확정되는 규칙과 맞지 않는다.
편집 해설 근거: NIST DADS, bubble sort (2023-04-07) — Definition 및 Note의 패스마다 비교 끝을 줄이는 설명
14. 관계 대수 및 관계 해석에 대한 설명으로 옳지 않은 것은?
- 관계 해석은 원하는 정보와 그 정보를 어떻게 유도하는가를 기술하는 절차적인 특성을 지닌다.
- 관계 해석과 관계 대수는 관계 데이터베이스를 처리하는 기능과 능력 면에서 동등하다.
- 관계 해석은 원래 수학의 프레디킷 해석에 기반을 두고 있다.
- 관계 대수는 릴레이션을 처리하기 위한 연산의 집합으로 피연산자가 릴레이션이고 결과도 릴레이션이다.
정답과 해설 보기
정답: 1
정답은 ①이다. 관계해석은 원하는 결과가 만족해야 하는 조건을 논리식으로 표현하는 선언적 방식이다. 어떤 순서로 선택·결합 같은 연산을 수행할지를 직접 나열하는 방식과 다르므로, ‘어떻게 유도하는가를 기술하는 절차적 특성’이라는 설명은 관계해석에 맞지 않는다.
관계대수는 선택·투영·조인 등 릴레이션을 입력받아 릴레이션을 반환하는 연산으로 질의를 구성한다. 관계해석과 관계대수의 표현력이 같다는 정리는 결과가 데이터베이스의 유한한 값에 적절히 제한되는 안전한 관계해석을 대상으로 한다. 제한 없는 관계해석은 무한한 결과를 요구할 수 있으므로 ②를 모든 논리식에 적용해서는 안 된다. 이 문제의 핵심은 관계대수의 연산 구성과 관계해석의 조건 명세를 구분하는 것이다.
선지별 해설
- ① 정답. 관계해석은 절차를 지시하기보다 원하는 결과 조건을 선언하므로 틀린 설명이다.
- ② 오답. 안전한 관계해석과 관계대수는 표현력이 동등하다는 교과서적 범위에서 맞다.
- ③ 오답. 관계해석은 술어 논리의 변수·조건·한정자 등을 사용한다.
- ④ 오답. 관계대수의 연산은 릴레이션에 적용하여 다시 릴레이션을 만든다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Calculus — 슬라이드 11 Expressive Power of Algebra and Calculus; 12 Summary
15. 병행제어의 로킹(Locking) 단위에 대한 설명으로 옳지 않은 것은?
- 데이터베이스, 파일, 레코드 등은 로킹 단위가 될 수 있다.
- 로킹 단위가 작아지면 로킹 오버헤드가 증가한다.
- 한꺼번에 로킹할 수 있는 단위를 로킹 단위라고 한다.
- 로킹 단위가 작아지면 병행성 수준이 낮아진다.
정답과 해설 보기
정답: 4
정답은 ④이다. 로킹 단위는 한 번에 잠금 대상으로 삼는 데이터의 범위이다. 데이터베이스 전체를 잠그면 다른 작업이 넓은 범위에서 기다려야 하지만, 특정 레코드만 잠그면 서로 다른 레코드를 다루는 작업은 함께 진행할 여지가 생긴다. 따라서 단위가 작아질수록 일반적으로 병행성은 높아진다.
반면 같은 양의 데이터를 처리하려고 많은 작은 잠금을 획득하면 잠금 정보 저장과 관리에 드는 비용이 커질 수 있다. 즉 ‘작은 단위→높은 병행성 가능, 많은 관리 비용’, ‘큰 단위→적은 잠금 수, 넓은 경합 범위’라는 절충이다. 실제 성능은 접근 범위·경합·DBMS의 잠금 확대 정책 등에 좌우되므로 작은 단위가 언제나 빠르다고 단정하지 않는다.
선지별 해설
- ① 오답. 데이터베이스·파일/테이블·페이지·레코드 등 여러 범위를 잠금 단위로 둘 수 있다.
- ② 오답. 같은 작업에서 관리할 잠금 수가 늘 수 있어 일반적인 절충을 설명한다.
- ③ 오답. 잠금을 설정하는 데이터 범위라는 뜻에 해당한다.
- ④ 정답. 작은 범위의 잠금은 서로 다른 데이터의 동시 접근 가능성을 보통 높인다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Concurrency Control — 슬라이드 13~17, Multiple-Granularity Locks / Protocol
16. 개체-관계 모델의 E-R 다이어그램에서 사용되는 기호와 그 의미의 연결이 옳지 않은 것은?
- 사각형 – 개체 타입
- 삼각형 – 속성
- 선(링크) – 연결
- 마름모 – 관계 타입
정답과 해설 보기
정답: 2
정답은 ② 삼각형-속성이다. 이 문항은 사각형·마름모·타원을 쓰는 전통적인 Chen 방식의 E-R 도형을 전제로 한다. 개체 타입은 사각형, 관계 타입은 마름모, 속성은 타원으로 표시하고 선으로 관련 요소를 연결한다. 따라서 속성을 삼각형에 연결한 ②가 틀리다.
예를 들어 학생이라는 개체를 사각형으로 그리고 이름·학번을 타원으로 연결할 수 있다. 학생과 강좌의 수강 관계는 마름모로 표시한다. 단, 모든 데이터 모델링 도구가 이 도형을 쓰는 것은 아니다. 까마귀발 표기나 UML 클래스 다이어그램에서는 다른 표기를 사용하므로, E-R이라는 이름만 보고 어떤 도구에서도 속성이 타원이라고 일반화하지 않는다.
선지별 해설
- ① 오답. Chen 표기에서 개체 타입을 사각형으로 나타낸다.
- ② 정답. 속성은 타원이며 삼각형으로 표시한다는 연결은 틀리다.
- ③ 오답. 관련 개체·관계·속성을 연결하는 데 선을 사용한다.
- ④ 오답. Chen 표기에서 관계 타입을 마름모로 나타낸다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, ER Model — 슬라이드 3~4 ER Model Basics의 Employees·Works_In 도형
17. 다음 트리를 Preorder 운행법으로 운행할 경우 다섯 번째로 탐색되는 것은?
- C
- E
- G
- H
정답과 해설 보기
정답: 2
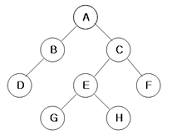
정답은 ② E이다. 전위 순회(Preorder)는 현재 노드를 먼저 방문한 다음 왼쪽 부분 트리, 오른쪽 부분 트리를 같은 방식으로 방문한다. 루트 A를 방문하고 왼쪽의 B와 그 자식 D를 처리한 뒤, A의 오른쪽 부분 트리인 C로 이동한다.
C를 먼저 방문하고 C의 왼쪽 자식 E를 방문하므로 순서는 A(1), B(2), D(3), C(4), E(5), G(6), H(7), F(8)이다. 따라서 다섯 번째 노드는 E이다. 왼쪽 아래를 먼저 찾더라도 루트를 나중에 방문하는 중위·후위 순회와 섞으면 안 된다. 전위의 ‘전’은 각 부분 트리에서 그 루트를 자식보다 먼저 처리한다는 뜻이다.
선지별 해설
- ① 오답. C는 네 번째 방문 노드이다.
- ② 정답. A,B,D,C 다음에 방문하는 다섯 번째 노드이다.
- ③ 오답. E를 방문한 뒤 그 왼쪽 자식 G를 여섯 번째로 방문한다.
- ④ 오답. H는 E의 오른쪽 자식으로 일곱 번째에 방문한다.
편집 해설 근거: NIST DADS, preorder traversal — Definition
18. 릴레이션의 특징으로 적합하지 않은 것은?
- 중복된 튜플이 존재하지 않는다.
- 튜플 간의 순서는 별다른 의미를 가지지 않는다.
- 속성 간의 순서는 존재하며 중요한 의미를 갖는다.
- 모든 속성 값은 원자 값을 갖는다.
정답과 해설 보기
정답: 3
정답은 ③이다. 이 문제는 제1정규형의 수학적 릴레이션 모델을 묻는다. 릴레이션은 튜플의 집합이므로 같은 튜플을 중복 원소로 갖지 않고, 집합 안의 튜플 순서는 의미를 바꾸지 않는다. 속성도 이름으로 구분하므로 표에서 열의 표시 순서를 바꾸었다고 같은 속성 값의 관계가 달라지지는 않는다.
④의 원자 값은 이 모델에서 하나의 속성 칸이 정의된 도메인의 한 값을 갖는다는 뜻이다. SQL에서 SELECT 결과가 중복 행을 포함하거나 ORDER BY로 출력 순서를 지정할 수 있다는 사실과 이 수학적 정의를 구분해야 한다. 실제 SQL 테이블의 모든 동작을 순수한 집합 모델과 동일하다고 단정하면 안 된다. ‘속성 간 순서가 중요한 의미를 갖는다’는 ③이 모델의 성질에 맞지 않는다.
선지별 해설
- ① 오답. 수학적 릴레이션은 집합이므로 동일한 튜플의 중복을 구별하지 않는다.
- ② 오답. 튜플의 나열 순서는 릴레이션의 의미를 바꾸지 않는다.
- ③ 정답. 이름으로 식별하는 속성의 표시 순서를 본질적 의미로 삼지 않는다.
- ④ 오답. 제1정규형 모델에서는 각 속성 칸이 도메인의 원자 값을 가진다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — 슬라이드 3 Relational Database: Definitions 및 Example Instance
19. 데이터베이스의 특성으로 옳지 않은 것은?
- 질의에 대하여 실시간 처리 및 응답이 가능하도록 지원해 준다.
- 삽입, 삭제, 갱신으로 항상 최신의 데이터를 유지한다.
- 다수의 사용자가 동시에 이용할 수 있다.
- 데이터 참조 시 데이터 값에 의해서는 참조될 수 없으므로 위치나 주소에 의하여 데이터를 찾는다.
정답과 해설 보기
정답: 4
정답은 ④이다. 데이터베이스에서는 사용자가 저장장치의 주소를 직접 알지 않아도 값의 조건으로 데이터를 요청할 수 있다. 예를 들어 고객번호가 100인 주문을 조회하면 DBMS가 저장 구조와 인덱스 등을 이용해 해당 행을 찾는다. 값에 의해서는 참조할 수 없다는 ④는 이 내용 기반 접근을 부정하므로 틀리다.
①~③은 신속한 질의 처리, 데이터 변경, 여러 사용자의 동시 이용이라는 일반적인 기능을 설명한다. 다만 모든 질의가 실시간 마감시간 안에 끝난다거나 외부 현실이 바뀌면 입력 없이도 즉시 최신 값으로 갱신된다는 절대 보장은 아니다. 실제 최신성은 입력·트랜잭션·복제 정책에, 동시 이용의 일관성은 동시성 제어에 달려 있다. 기능을 지원한다는 뜻과 언제나 자동 보장된다는 뜻을 구별한다.
선지별 해설
- ① 오답. 필요한 질의의 신속한 처리·응답을 지원한다는 일반적 특성으로 이해한다.
- ② 오답. 삽입·삭제·갱신으로 현재의 데이터를 유지하는 기능을 설명한다. 외부 변화가 저절로 입력된다는 뜻은 아니다.
- ③ 오답. 동시성 제어를 통해 여러 사용자의 접근을 지원한다.
- ④ 정답. 값의 조건에 따른 조회가 가능하므로 물리 주소로만 찾는다는 주장은 틀리다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Introduction — 슬라이드 4 Why Use a DBMS?; 7~9 추상화와 데이터 독립성; 10 Concurrency Control; Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — 슬라이드 5 Relational Query Languages
20. 스키마, 도메인, 테이블을 정의할 때 사용되는 SQL 문은?
- SELECT
- UPDATE
- MAKE
- CREATE
정답과 해설 보기
정답: 4
정답은 ④ CREATE이다. SQL에서 새로운 구조를 정의하는 대표 형식은 CREATE 뒤에 만들 객체의 종류를 쓰는 것이다. CREATE SCHEMA는 스키마, CREATE DOMAIN은 도메인, CREATE TABLE은 테이블을 정의한다. 도메인은 기본 자료형에 허용 값 등의 제약을 결합해 재사용할 수 있는 형식이다.
SELECT는 저장된 값에서 질의 결과를 구하고, UPDATE는 기존 행의 값을 바꾼다. 이들은 이 문항처럼 새 스키마·도메인·테이블을 정의하는 명령이 아니다. MAKE는 제시된 객체를 정의하는 SQL 명령 키워드가 아니다. CREATE를 ‘모든 데이터를 입력하는 명령’으로 외우지 말고, 테이블의 구조를 만드는 CREATE TABLE과 그 안에 행을 넣는 INSERT를 구별해야 한다.
선지별 해설
- ① 오답. SELECT는 질의 결과를 얻는 명령이다.
- ② 오답. UPDATE는 기존 행의 값을 변경하는 명령이다.
- ③ 오답. MAKE는 이 객체들을 정의하는 SQL 문이 아니다.
- ④ 정답. CREATE SCHEMA·CREATE DOMAIN·CREATE TABLE처럼 새 객체를 정의한다.
편집 해설 근거: PostgreSQL 18, CREATE SCHEMA — Description 및 Examples; PostgreSQL 18, 8.18 Domain Types — 8.18 Domain Types의 CREATE DOMAIN 예시; PostgreSQL 18: Data Definition — 5.1 Table Basics
정보처리기사 필기 기출문제 · 전자계산기 구조
21. 다음 [그림]에서 F를 A, B의 부울식으로 나타내면? (단, 그림에서 X는 선의 절단을 표시함)
[학습용 개정문항]
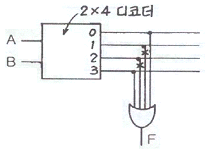
- F = A′B′ + AB
- F = A′B + AB′
- F = A + B
- F = AB
정답과 해설 보기
정답: 1
정답은 ① F=A′B′+AB이다. 디코더는 입력 A,B의 네 조합 00·01·10·11 중 해당하는 출력 하나를 활성화한다. 그림의 0번 출력은 A=0,B=0인 경우이므로 A′B′이고, 3번 출력은 A=1,B=1인 경우이므로 AB이다. X로 끊어진 1번·2번 출력은 최종 OR에 전달되지 않는다.
따라서 살아 있는 0번과 3번을 OR하면 F=A′B′+AB가 된다. 진리표 순서 00,01,10,11에서 출력은 1,0,0,1이다. 두 입력이 같을 때 1인 XNOR이며, 서로 다를 때 1인 XOR와 반대이다. 기존 사이트에서 네 보기가 모두 ‘번호 도식’이라는 빈 설명으로 표시되어 식을 읽을 수 없었으므로, 회로를 분석해 비교 가능한 식을 새로 구성한 학습용 문항이다.
선지별 해설
- ① 정답. A,B가 둘 다 0이거나 둘 다 1일 때만 1이다.
- ② 오답. XOR 식으로 1번·2번 출력에 해당하며 그림에서는 그 선이 끊어져 있다.
- ③ 오답. OR는 01과 10에서도 1이므로 회로와 다르다.
- ④ 오답. AND는 11에서만 1이며 00에서 활성화되는 0번 출력을 빠뜨린다.
편집 해설 근거: MIT 6.004 (2017), 4.1 Combinational Logic — Boolean Equations / Sum-of-Products / AND·OR gate 설명
22. 전파지연(propagation delay)에 대한 설명으로 옳지 않은 것은?
- gate상의 operating speed는 propagation delay에 반비례한다.
- 전파지연은 ALU path에서 가장 짧은 delay를 말한다.
- 더 빠른 gate를 사용함으로써 propagation delay time을 줄일 수 있다.
- ALU의 parallel-adder에 전파지연을 줄이기 위해 carry lock ahead를 사용한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 디지털 회로의 전파지연은 입력 변화 후 출력이 유효한 새 값으로 안정될 때까지 걸리는 지연을 말한다. 회로 전체가 언제까지 안정되는지를 보장하려면 가장 늦게 도착하는 경로를 고려해야 하므로 ALU의 가장 짧은 경로 지연이라는 설명은 틀리다.
최단 경로에서 출력이 가장 일찍 변할 수 있는 시간은 오염지연(contamination delay)과 관련된다. 데이터시트에서 상승·하강 지연을 따로 표시하거나 대표값을 평균하는 관례가 있더라도, 이를 이유로 최장 경로 분석이 불필요해지는 것은 아니다. 빠른 게이트와 적절한 회로 구조는 지연을 줄일 수 있다. ④의 carry look-ahead는 자리올림을 차례로 기다리는 경로를 줄이는 기법이다. 지연이 작아질수록 허용 동작 속도를 높일 여지가 있지만 실제 클록 한계에는 레지스터의 설정시간 등도 함께 들어간다.
선지별 해설
- ① 오답. 다른 조건이 같다면 지연이 작을수록 빠르게 동작할 수 있다는 일반적 관계이다.
- ② 정답. 출력 안정의 상한은 늦은 경로를 고려해야 하며 최단 경로 지연과 다르다.
- ③ 오답. 더 빠른 게이트는 경로 지연을 줄이는 수단이다.
- ④ 오답. carry look-ahead는 자리올림 전달 지연을 줄이는 방식이다. 기존 lock ahead 표기는 look-ahead의 오기이다.
편집 해설 근거: MIT 6.004 (2017), 3.1 CMOS Technology and Timing — Propagation Delay / Contamination Delay / Timing of Combinational Circuits
23. 불 함수식 F = (A+B)·(A+C)를 간략화 한 것은?
- F = A+BC
- F = B+AC
- F = A+AC
- F = C+AB
정답과 해설 보기
정답: 1
정답은 ① F=A+BC이다. 불 대수에서 +는 OR, 곱은 AND를 뜻한다. 분배하면 (A+B)(A+C)=AA+AC+AB+BC가 된다. 같은 변수끼리 AND하면 AA=A이고, A+AC=A 및 A+AB=A라는 흡수 법칙을 적용하면 A+BC만 남는다.
값을 나누어 확인할 수도 있다. A=1이면 원래 식의 두 괄호가 모두 1이어서 F=1이다. A=0이면 원래 식은 B·C가 된다. 따라서 ‘A가 1이거나 B와 C가 모두 1’이라는 A+BC가 정확하다. 여기서 A+A를 보통 수학의 2A로 계산하면 안 된다. 논리 OR에서는 1+1도 참인 1로 처리한다.
선지별 해설
- ① 정답. A=1일 때 1, A=0일 때 BC이므로 원래 함수와 같다.
- ② 오답. A=1,B=0,C=0에서 원래 식은 1인데 이 식은 0이다.
- ③ 오답. A+AC=A로 단순화되어 A=0,B=C=1일 때의 1을 놓친다.
- ④ 오답. A=1,B=0,C=0에서 이 식은 0이므로 원래 식과 다르다.
편집 해설 근거: MIT 6.004 (2017), 4.1 Combinational Logic — Boolean Equations 및 truth table과의 상호 변환
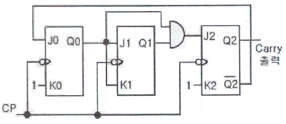
24. 다음 회로의 명칭은?
- 동기식 3진 카운터
- 동기식 4진 카운터
- 동기식 5진 카운터
- 동기식 6진 카운터
정답과 해설 보기
정답: 3
정답은 ③ 동기식 5진 카운터이다. 모든 플립플롭이 같은 CP에 연결되어 있으므로 클록 입력이 앞단 출력에서 다음 단으로 전달되는 리플 방식과 달리 동기식이다. JK 플립플롭은 J,K가 00이면 유지, 01이면 0, 10이면 1, 11이면 현재 값의 반전으로 다음 상태가 정해진다.
그림의 입력은 J0=Q2의 반전, K0=1, J1=K1=Q0, J2=Q0Q1, K2=1이다. 현재 상태의 Q값으로 세 플립플롭의 다음 값을 동시에 계산하면 Q2Q1Q0는 000→001→010→011→100→000으로 돌아온다. 순환하는 서로 다른 상태가 다섯 개이므로 5진이다. 플립플롭이 세 개라는 이유로 3진이라 하거나, 가능한 비트 조합이 여덟 개라는 이유로 반드시 8진이라 판단하면 안 된다.
선지별 해설
- ① 오답. 소자의 개수 3과 순환 상태 수는 다르다.
- ② 오답. 000~011 뒤에도 100 상태가 포함되어 네 상태보다 많다.
- ③ 정답. 공통 클록으로 다섯 상태가 순환한다.
- ④ 오답. 100 다음에 101이 아니라 000으로 돌아간다.
편집 해설 근거: Texas Instruments, SN5476/SN54LS76A Dual J-K Flip-Flops, function tables — 첫 페이지 LS76A FUNCTION TABLE
25. CPU의 산술논리연산장치(ALU)가 수행하는 계산 자체와 구별되는 역할은?
[학습용 개정문항]
- 입력된 수의 덧셈·뺄셈 계산
- 입력 비트들의 AND·OR 계산
- 입력된 두 값의 대소·동등 비교
- 메모리 주소 레지스터(MAR)에 접근 주소를 보관
정답과 해설 보기
정답: 4
정답은 ④이다. ALU(산술논리연산장치)는 입력된 비트에 대해 덧셈·뺄셈, AND·OR 같은 논리 연산, 비교 등의 결과를 계산하는 장치이다. 반면 메모리를 접근할 주소를 저장하여 유지하는 것은 주소 레지스터의 역할이다. 따라서 MAR에 주소를 보관하는 일을 ALU의 연산 그 자체로 설명한 ④가 적절하지 않다.
주소 계산에 ALU나 별도 가산기를 사용할 수 있다는 사실과, 계산한 주소를 레지스터에 보관한다는 사실은 다르다. 연산 결과를 저장하는 레지스터, 어떤 연산을 수행할지 지시하는 제어 논리, 연산을 실제 계산하는 ALU를 구별한다. 기존의 ‘제어·함수연산·전달·번지 기능’만으로는 연산장치의 범위가 불분명했으므로, 이 문항은 ALU와 주소 레지스터의 역할을 구분하는 학습용 보기로 개정했다.
선지별 해설
- ① 오답. 수의 덧셈·뺄셈은 대표적인 산술 연산이다.
- ② 오답. AND·OR와 같은 비트 연산은 대표적인 논리 연산이다.
- ③ 오답. 두 값의 대소·동등 여부를 계산하는 비교 기능이다.
- ④ 정답. 주소의 보관은 MAR의 역할이며 ALU의 산술·논리 계산 자체가 아니다.
편집 해설 근거: MIT 6.004 (2017), 13.1 Building the Beta — Datapath for ALU Instructions / ALUFN control / LD datapath
26. 짝수 패리티 비트의 해밍 코드로 0011011을 받았을 때 오류가 수정된 정확한 코드는?
[학습용 개정문항]
비트 위치는 왼쪽부터 1~7로 매기며, 1·2·4번을 패리티 위치로 사용한다. 한 비트 오류가 발생한 것으로 가정한다.
- 0111011
- 0001011
- 0011001
- 0010101
정답과 해설 보기
정답: 3
정답은 ③ 0011001이다. 비트 위치를 왼쪽부터 1~7로 매기고 한 비트 오류를 가정한다. 짝수 패리티이므로 검사 그룹의 1 개수가 짝수면 검사값 0, 홀수면 1이다. 수신값 0,0,1,1,0,1,1에 대해 위치 1·3·5·7은 0,1,0,1로 1이 두 개이므로 S1=0이다.
위치 2·3·6·7은 0,1,1,1로 세 개이므로 S2=1, 위치 4·5·6·7은 1,0,1,1로 세 개이므로 S4=1이다. 오류 위치는 S1+2S2+4S4=0+2+4=6이다. 왼쪽 여섯 번째 1을 0으로 바꾸면 0011001이 되고 세 검사 그룹 모두 짝수가 된다. 기존 해설의 첫 그룹 ‘1이 한 개’는 계산 오류이다. 단일 오류 정정 절차를 두 비트 이상의 오류까지 항상 올바르게 고치는 방법으로 확대하면 안 된다.
선지별 해설
- ① 오답. 두 번째 비트를 바꾼 값으로 검사값이 모두 0이 되지 않는다.
- ② 오답. 세 번째 비트를 바꾼 값으로 이번 신드롬 6과 맞지 않는다.
- ③ 정답. 여섯 번째 비트를 바꾸면 세 패리티 검사가 모두 짝수를 만족한다.
- ④ 오답. 수신값과 여러 비트가 달라 단일 오류 위치 6의 정정 결과가 아니다.
편집 해설 근거: MIT MAS.160 (2007), Error-correcting codes, Hamming code syndrome — PDF 2~3쪽, Hamming parity-check matrix와 syndrome 설명
27. 인터럽트 처리 루틴의 순서로 올바른 것은?
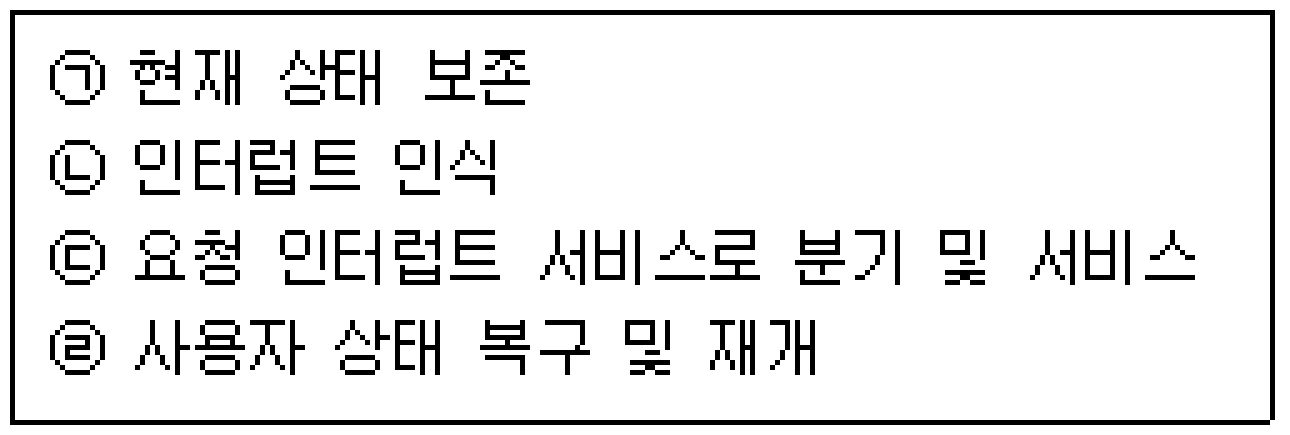
- (ㄱ)→(ㄴ)→(ㄷ)→(ㄹ)
- (ㄴ)→(ㄷ)→(ㄱ)→(ㄹ)
- (ㄴ)→(ㄱ)→(ㄹ)→(ㄷ)
- (ㄴ)→(ㄱ)→(ㄷ)→(ㄹ)
정답과 해설 보기
정답: 4
정답은 ④ (ㄴ)→(ㄱ)→(ㄷ)→(ㄹ)이다. 먼저 인터럽트 요청을 인식한다(ㄴ). 이어 중단한 곳으로 정확히 돌아올 수 있도록 프로그램 카운터와 필요한 상태를 보존한다(ㄱ). 그 다음 해당 서비스 처리 경로로 분기하여 요청을 처리한다(ㄷ). 마지막으로 보존한 상태를 복구하여 실행을 재개한다(ㄹ).
상태를 저장하기 전에 서비스 코드가 레지스터를 덮어쓰면 원래 계산의 값이 손상될 수 있다. 또한 서비스를 수행하기도 전에 사용자 상태를 복구하고 돌아가면 요청을 처리하지 못한다. 실제 프로세서에서는 일부 저장·복구를 하드웨어가 자동 수행하고 나머지를 소프트웨어가 담당한다. 이 문제의 네 단계는 그 전체 흐름을 논리적으로 나눈 것이며 모든 CPU가 동일한 명령어 순서를 쓴다는 뜻은 아니다.
선지별 해설
- ① 오답. 제시한 논리 단계에서는 인터럽트를 인식한 뒤 필요한 상태를 보존한다.
- ② 오답. 서비스 전에 원래 작업의 필요한 상태를 먼저 보존해야 한다.
- ③ 오답. 요청을 서비스하기 전에 복귀·재개하는 순서가 되어 잘못이다.
- ④ 정답. 인식→상태 보존→서비스→복구·재개 순서이다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 6 Limited Direct Execution — 6.3, timer interrupt 설명 및 Figure 6.3
28. 인터럽트 처리의 일반 원칙에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 처리 후 중단한 실행으로 돌아가기 위해 필요한 처리기 상태를 복구한다.
- 처리할 인터럽트 원인을 식별한다.
- 서비스 중 바뀔 수 있는 필요한 처리기 레지스터 상태를 보존한다.
- 모든 CPU에서 높은 우선순위 인터럽트를 차단하려면 반드시 마스크 레지스터를 0으로 클리어한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 인터럽트를 처리할 때는 중단된 작업에 필요한 상태를 보존하고, 처리할 원인을 식별하여 서비스한 뒤 복귀에 필요한 상태를 복구한다. 이 일은 하드웨어 진입·복귀 절차와 소프트웨어 핸들러가 나누어 맡을 수 있다.
마스크 레지스터의 어느 비트가 허용·차단을 뜻하는지는 프로세서 규약에 달려 있다. 예를 들어 Cortex-M의 PRIMASK는 1로 설정하면 구성 가능한 우선순위의 예외 활성화를 막고, 0으로 지우면 그 차단을 해제한다. 따라서 모든 CPU에서 레지스터를 0으로 지우는 것이 반드시 높은 우선순위 인터럽트를 차단한다는 ④는 틀리다. 기존 문항의 ‘높은 레벨의 마스크 클리어’만으로는 의도를 단정할 수 없어, 아키텍처와 무관한 일반 규칙으로 오해하지 않도록 보기를 명확히 했다.
선지별 해설
- ① 오답. 중단한 실행으로 돌아가려면 필요한 처리기 상태를 복원한다.
- ② 오답. 어떤 인터럽트를 처리할지 식별해야 하며 벡터 등으로 하드웨어가 일부 결정할 수도 있다.
- ③ 오답. 서비스가 덮어쓸 수 있는 필요한 레지스터 상태를 보존한다.
- ④ 정답. 마스크의 0·1 의미는 아키텍처별로 다르며 Cortex-M PRIMASK=0은 차단 해제의 예이다.
편집 해설 근거: Arm CMSIS 6, Cortex-M Core Register Access — __enable_irq / __disable_irq / __set_PRIMASK; Arpaci-Dusseau, OSTEP v1.10, 6 Limited Direct Execution — 6.3, 저장·복구 및 Figure 6.3
29. 컴퓨터의 메모리 용량이 4096워드이고, 워드당 16bit의 데이터를 갖는다면 MAR은 몇 비트인가?
[학습용 개정문항]
각 16비트 워드에 주소 하나를 부여하는 워드 주소 방식이며, 필요한 최소 MAR 폭을 구한다.
- 12
- 16
- 18
- 20
정답과 해설 보기
정답: 1
정답은 ① 12비트이다. MAR은 접근할 메모리 위치의 주소를 저장한다. 워드마다 주소 하나를 부여하는 조건에서 4096개의 위치를 구별하려면 서로 다른 주소 4096개가 필요하다. n비트로 표현할 수 있는 주소는 2의 n제곱 개이며, 4096=2의 12제곱이므로 n=12이다.
워드당 16비트는 한 주소에서 읽거나 쓰는 데이터의 폭이다. 이를 MAR의 주소 비트 수와 혼동하면 16을 고르게 된다. 총 데이터 용량은 4096×16비트이지만 주소가 워드 단위이므로 65536개의 개별 비트를 지정하는 것이 아니다. 바이트 주소 방식으로 같은 용량 8192바이트 각각에 주소를 부여한다면 13비트가 필요해진다. 문제에 워드 주소 조건을 추가하여 이 차이를 명확히 했다.
선지별 해설
- ① 정답. 2의 12제곱=4096개의 워드 주소를 표현한다.
- ② 오답. 워드의 데이터 폭 16비트와 주소 폭을 혼동한 값이다.
- ③ 오답. 18비트는 262144개의 주소를 표현하므로 필요한 최소 폭보다 크다.
- ④ 오답. 20비트는 1048576개의 주소를 표현하므로 필요한 최소 폭보다 크다.
편집 해설 근거: MIT 6.004 (2017), 10.1 Programmable Architectures — Memory / Addressing 및 word·byte 주소 설명
30. 제어장치의 구현에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 상태 플립플롭과 논리 회로로 다음 상태 및 제어 출력을 구성할 수 있다.
- RAM만 설치하면 명령 해석·순서 제어·출력 연결 논리 없이 제어장치가 완성된다.
- PLA로 제어 신호를 만드는 논리 함수를 구현할 수 있다.
- 제어 저장소에 둔 마이크로명령의 순서로 제어할 수 있다.
정답과 해설 보기
정답: 2
정답은 ②이다. 제어장치는 현재 명령과 상태 등에 따라 레지스터 쓰기, ALU 연산 선택, 메모리 읽기·쓰기 같은 제어 신호를 만든다. 상태 플립플롭과 논리 회로로 다음 상태와 출력을 정할 수도 있고, PLA로 논리 함수를 구현할 수도 있으며, 제어 저장소의 마이크로명령을 순서대로 읽는 방식도 있다.
RAM은 읽고 쓸 수 있는 저장장치의 한 종류이다. RAM에 제어 정보를 넣어 사용할 수는 있지만, RAM 하나를 두었다는 사실만으로 입력 해석·주소 선택·실행 순서·출력 제어가 저절로 구현되지는 않는다. 따라서 제어 논리나 순서 제어 없이 RAM 자체만으로 제어장치가 완성된다는 ②가 틀리다. RAM을 마이크로프로그램 저장에 절대 사용할 수 없다고 외우면 안 된다.
선지별 해설
- ① 오답. 상태를 저장하는 플립플롭과 다음 상태·출력 논리로 제어할 수 있다.
- ② 정답. 저장 매체만으로 명령 해석과 제어 신호 생성·순서 결정 전체가 자동 구성되지는 않는다.
- ③ 오답. PLA로 필요한 조합 논리 함수를 구현할 수 있다.
- ④ 오답. 제어 저장소의 마이크로명령과 순서 제어를 이용하는 방식이다.
편집 해설 근거: MIT 6.004 (2017), 9.1 Building Data Paths — FSM control logic / ROM-based control 및 datapath 설명; MIT 6.004 (2017), 13.1 Building the Beta — control ROM / opcode로 제어 신호를 만드는 설명
31. Flynn의 컴퓨터 시스템 분류 제안 중에서 하나의 데이터 흐름이 다수의 프로세서들로 전달되며, 각 프로세서는 서로 다른 명령어를 실행하는 구조는?
- 단일 명령어, 단일 데이터 흐름
- 단일 명령어, 다중 데이터 흐름
- 다중 명령어, 단일 데이터 흐름
- 다중 명령어, 다중 데이터 흐름
정답과 해설 보기
정답: 3
정답은 ③ 다중 명령어, 단일 데이터 흐름(MISD)이다. Flynn 분류는 명령어 흐름의 수와 데이터 흐름의 수를 서로 다른 축으로 센다. 지문에서 각 처리기가 서로 다른 명령어 흐름을 수행하므로 명령어는 Multiple이고, 하나의 데이터 흐름을 여러 처리기가 받으므로 데이터는 Single이다.
따라서 Multiple Instruction, Single Data의 첫 글자를 모은 MISD가 된다. 같은 명령을 서로 다른 데이터에 적용하는 SIMD와 두 축이 반대이다. 처리기 개수만 보고 MIMD라고 고르는 것도 틀리다. 여러 처리기가 있다는 사실만으로 서로 다른 데이터 흐름이 있다고 결론낼 수 없기 때문이다. 이 문항은 구체적인 상용 장비의 분류가 아니라 제시된 흐름의 정의를 묻는다.
선지별 해설
- ① 오답. SISD는 명령어와 데이터 흐름이 모두 하나이다.
- ② 오답. SIMD는 명령어 하나·데이터 여러 개로 지문과 반대이다.
- ③ 정답. 서로 다른 명령어 흐름이 하나의 데이터 흐름을 처리하는 MISD이다.
- ④ 오답. MIMD는 데이터 흐름도 여러 개여야 한다.
편집 해설 근거: Lawrence Livermore National Laboratory, Introduction to Parallel Computing Tutorial — Flynn's Classical Taxonomy, Multiple Instruction, Single Data (MISD)
32. 다중처리기가 공유 메모리에 동시에 접근하기 때문에 추가로 생기는 문제와 가장 거리가 먼 것은?
[학습용 개정문항]
- 메모리 충돌문제
- 메모리 용량문제
- 캐시 일관성 문제
- 메모리 접근의 효율성 문제
정답과 해설 보기
정답: 2
정답은 ② 메모리 용량 문제이다. 여기서는 여러 프로세서가 공유 메모리를 동시에 접근함에 따라 추가로 생기는 문제를 비교한다. 동일한 메모리 경로나 자원에 요청이 몰리면 충돌·경합이 생길 수 있고, 프로세서별 캐시에 서로 다른 복사본이 있으면 변경 사항을 맞추는 일관성 제어가 필요하다. 접근 경로의 대역폭과 지연도 성능에 영향을 준다.
필요한 총 메모리 용량을 산정하는 일은 프로세서가 하나인 시스템에서도 해야 한다. 따라서 나머지 세 보기처럼 공유 자원의 병행 접근 때문에 생기는 고유한 문제와는 구별된다. 그렇다고 다중처리기에서 메모리 용량을 고려하지 않아도 된다는 뜻은 아니다. 기존 질문의 ‘고려사항이 아닌 것’을 병행 접근에 따른 문제라는 범위로 좁힌 이유이다.
선지별 해설
- ① 오답. 여러 처리기의 요청이 같은 메모리 자원에서 경합할 수 있다.
- ② 정답. 용량 산정 자체는 단일 처리기에도 필요한 일반적인 설계 사항이다.
- ③ 오답. 여러 캐시의 공유 데이터 복사본을 일관되게 관리해야 한다.
- ④ 오답. 공유 경로의 대역폭·지연·경합을 포함한 접근 효율을 검토해야 한다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 10 Multiprocessor Scheduling — 10.1 Background: Multiprocessor Architecture; 10.2 Synchronization
33. 미소의 콘덴서에 전하를 충전하는 원리를 이용하는 메모리로, 재충전(Refresh)이 필요한 메모리는?
- SRAM
- DRAM
- PROM
- EPROM
정답과 해설 보기
정답: 2
정답은 ② DRAM이다. DRAM의 비트 셀은 작은 커패시터에 저장된 전하 상태로 값을 구분한다. 시간이 지나면 누설로 전하가 줄 수 있으므로, 전원이 켜져 있어도 주기적으로 값을 읽고 다시 써서 보존하는 refresh가 필요하다.
SRAM은 피드백을 이용한 안정된 회로 상태로 비트를 유지하므로 전원이 공급되는 동안 DRAM과 같은 주기적 전하 재충전이 필요하지 않다. 그러나 SRAM도 일반적으로 전원을 끄면 데이터를 잃는 휘발성 메모리이다. PROM과 EPROM은 비휘발성 ROM 계열로 프로그래밍·소거 방식의 차이를 가진다. ‘전원 없이도 보존된다’와 ‘전원이 있을 때 refresh가 필요 없다’를 같은 말로 취급하지 않는 것이 핵심이다.
선지별 해설
- ① 오답. SRAM은 전원이 있을 때 회로의 안정 상태로 값을 유지하며 DRAM식 주기적 refresh를 요구하지 않는다.
- ② 정답. 커패시터 전하의 누설 때문에 주기적인 refresh가 필요하다.
- ③ 오답. PROM은 프로그래밍 가능한 비휘발성 ROM 계열이며 지문의 DRAM 셀 원리와 다르다.
- ④ 오답. EPROM은 소거 후 재프로그래밍할 수 있는 비휘발성 ROM 계열이다.
편집 해설 근거: MIT 6.004 (2017), 14.1 Caches and the Memory Hierarchy — 슬라이드 3~11, SRAM / 1T Dynamic RAM Cell / Summary: DRAM
34. FETCH 메이저 상태에서 수행되는 마이크로오퍼레이션이 아닌 것은?
- MAR ← PC : PC의 값은 MAR로 이동
- PC ← PC+b : PC의 값을 인스트럭션의 바이트 수 b만큼 증가
- IR ← MBR(OP) : MBR에서 연산(operation) 부분을 인스트럭션 레지스터로 옮김
- IEN ← 0 : 인터럽트를 disable 시킴
정답과 해설 보기
정답: 4
정답은 ④ IEN←0이다. FETCH는 다음 명령어를 메모리에서 가져오는 단계이다. PC가 가리키는 주소를 MAR로 전달하고, 메모리에서 읽은 명령어를 명령어 레지스터 쪽으로 가져오며, 다음 순차 명령어의 주소를 준비하기 위해 PC를 증가시키는 동작이 이에 해당한다.
IEN←0은 인터럽트 허용 플래그를 끄는 동작으로, 명령어 인출 자체의 기본 동작을 설명하지 않는다. 이 문항의 교과서적 메이저 상태 구분에서는 인터럽트 진입·처리 제어와 관련지어 구별한다. 실제 CPU마다 레지스터 이름, 명령어 길이, PC 증가 시점과 예외 처리 방식은 다를 수 있으므로 매 FETCH마다 반드시 인터럽트를 금지한다고 일반화하지 않는다.
선지별 해설
- ① 오답. PC의 명령어 주소를 메모리 주소 입력에 전달하는 인출 준비이다.
- ② 오답. 바이트 주소 및 b바이트 명령어라는 표기의 가정에서 다음 순차 주소를 준비한다.
- ③ 오답. 읽어온 명령어의 연산 부분을 명령어 해석에 사용하기 위해 옮기는 단계이다.
- ④ 정답. 인터럽트 허용을 끄는 제어이며 기본적인 명령어 인출 동작이 아니다.
편집 해설 근거: MIT 6.004 (2017), 13.1 Building the Beta — Fetch and Decode 단계 및 PC+4 설명; Arpaci-Dusseau, OSTEP v1.10, 6 Limited Direct Execution — 6.3~6.4, timer interrupt와 인터럽트 중첩 제어
35. 캐시와 주기억장치로 구성된 컴퓨터에서 주기억장치의 접근 시간이 200ns, 캐시 적중률이 0.9, 평균 접근시간이 30ns일 때 캐시 메모리의 접근 시간은?
[학습용 개정문항]
모든 접근은 캐시를 먼저 확인한다. 캐시 실패 시에는 캐시 확인 시간 외에 주기억장치 접근시간 200ns가 추가되며 다른 비용은 무시한다.
- 9ns
- 10ns
- 11ns
- 12ns
정답과 해설 보기
정답: 2
정답은 ② 10ns이다. 모든 접근에서 캐시를 먼저 확인하고, 실패하면 주기억장치에 추가로 200ns가 걸린다는 조건이다. 캐시 접근시간을 x라 하면 적중할 때는 x, 실패할 때는 x+200이 걸린다.
평균은 0.9x+0.1(x+200)=x+20이다. 이것이 30ns이므로 x=10ns이다. 다시 대입하면 적중 90%는 10ns, 실패 10%는 210ns이므로 평균은 9+21=30ns로 일치한다. 200ns를 실패 때의 전체 시간으로 잘못 넣으면 식이 0.9x+0.1×200으로 달라진다. 주어진 200ns가 추가 지연인지 전체 지연인지 먼저 구분해야 하므로 그 가정을 학습용 문항에 명시했다.
선지별 해설
- ① 오답. x=9이면 이 모델의 평균은 29ns이다.
- ② 정답. x=10이면 평균 0.9×10+0.1×210=30ns이다.
- ③ 오답. x=11이면 평균은 31ns이다.
- ④ 오답. x=12이면 평균은 32ns이다.
편집 해설 근거: MIT 6.004 (2017), 14.1 Caches and the Memory Hierarchy — Cache Metrics, average memory access time / miss penalty
36. 메모리 관리 하드웨어(MMU)의 기본적인 역할에 대한 설명으로 옳지 않은 것은?
- 논리 주소를 물리 주소로 변환
- 허용되지 않는 메모리 접근을 방지
- 메모리 동적 재배치
- 가상 주소 공간을 물리 주소 공간으로 압축
정답과 해설 보기
정답: 4
정답은 ④이다. MMU는 프로그램이 만든 가상·논리 주소를 실제 메모리에 접근할 물리 주소로 변환하는 하드웨어이다. 허용된 주소 범위나 페이지 권한도 검사하여 허용되지 않은 접근에 예외를 발생시킬 수 있다. 기준 주소를 더하거나 페이지 테이블의 매핑을 이용하는 방식은 실행 중 주소 재배치를 지원한다.
이 기능은 큰 가상 주소 공간의 모든 내용을 작은 물리 공간 안으로 압축 저장하는 작업이 아니다. 한 시점에 일부 페이지가 메모리에 있고 다른 페이지는 보조기억장치에 있거나 아직 할당되지 않을 수 있다. MMU의 주소 변환과 운영체제의 페이지 배치·교체를 함께 이용하는 것이므로 ‘압축’이라는 표현으로 설명하면 동작 원리를 오해하게 된다.
선지별 해설
- ① 오답. 주소 변환은 MMU의 핵심 기능이다.
- ② 오답. 범위·권한 검사와 예외 발생으로 메모리 보호를 지원한다.
- ③ 오답. 실행 시 주소를 변환함으로써 재배치를 지원한다.
- ④ 정답. 주소 매핑은 공간의 내용을 압축하는 연산이 아니다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 15 Address Translation — 15.3 Dynamic (Hardware-based) Relocation; 15.4 Hardware Support
37. 기억장치에 기억된 정보를 액세스하기 위하여 주소를 사용하는 것이 아니라 기억된 정보의 일부분을 이용하여 원하는 정보를 찾는 것은?
- Random Access Memory
- Associative Memory
- Read Only Memory
- Virtual Memory
정답과 해설 보기
정답: 2
정답은 ② Associative Memory(연관 기억장치)이다. 보통 주소 지정 메모리는 주소를 입력해 그 위치의 내용을 읽는다. 연관 기억장치는 찾으려는 내용이나 태그를 제시하고 저장된 항목들과 비교하여 일치하는 항목을 찾는다는 점이 다르다. CAM(Content Addressable Memory)이라는 이름도 이 내용 기반 검색을 나타낸다.
예를 들어 완전 연관 TLB에서는 주어진 가상 페이지 번호와 여러 엔트리의 태그를 비교해 일치하는 주소 변환 정보를 찾을 수 있다. RAM·ROM은 접근 또는 기록 특성을 말하고, 가상 메모리는 주소 공간 관리 기법이다. 따라서 이 이름들만으로 지문에 제시한 내용 비교 검색 방식을 가리키지는 않는다. 연관 검색이 빠를 수 있는 이유는 병렬 비교 하드웨어이며, 비용·전력 등 다른 조건까지 항상 유리하다는 뜻은 아니다.
선지별 해설
- ① 오답. RAM이라는 이름은 임의 주소 접근을 나타내며 내용 비교 검색이라는 뜻이 아니다.
- ② 정답. 내용 또는 태그의 일치 여부로 항목을 찾는다.
- ③ 오답. ROM은 읽기 중심의 저장 특성을 나타내는 분류이다.
- ④ 오답. 가상 메모리는 가상 주소를 매핑·관리하는 기법이며 연관 기억장치 그 자체가 아니다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 19 Translation Lookaside Buffers — 19.5 TLB Contents: What’s In There?, fully-associative 검색 설명
38. CISC 구조와 RISC구조를 비교하였을 때, RISC 구조의 특징으로 틀린 것은?
- 명령어가 복잡하다.
- 프로그램 길이가 길다.
- 레지스터 개수가 많다.
- 파이프라인 구현이 용이하다.
정답과 해설 보기
정답: 1
정답은 ① 명령어가 복잡하다이다. 전통적인 RISC 설계는 비교적 단순하고 규칙적인 명령어를 사용하여 해독·제어를 단순하게 만들고 파이프라인 처리를 용이하게 하려는 방향이다. 따라서 복잡한 명령어 자체를 특징으로 든 ①은 맞지 않는다.
CISC의 복합 명령 하나를 여러 단순 명령으로 처리할 수 있어 같은 일을 하는 명령 수가 늘어날 수 있고, 메모리 접근을 줄이기 위해 많은 레지스터를 활용하는 설계가 흔하다. 그러나 모든 RISC 프로그램의 바이트 길이가 언제나 더 길거나, 모든 명령이 반드시 한 클록에 완료되거나, 어느 RISC든 CISC보다 빠르다는 뜻은 아니다. 현대 구조에는 압축 명령과 다양한 확장이 있으므로 이 문항의 비교는 전통적인 설계 경향으로 읽는다.
선지별 해설
- ① 정답. 전통적인 RISC는 복잡한 명령보다 단순·규칙적인 명령을 중시한다.
- ② 오답. 같은 작업에 필요한 단순 명령 수가 늘 수 있다는 교과서적 비교 경향이다. 항상 더 많은 바이트를 쓴다는 보장은 아니다.
- ③ 오답. 레지스터를 적극 활용하는 설계는 대표적인 RISC 특성이다.
- ④ 오답. 규칙적인 명령·제어 구조는 파이프라인 구현에 유리하다.
편집 해설 근거: Patterson·Séquin (1981), RISC I: A Reduced Instruction Set VLSI Computer — 서론의 architecture constraints 및 register organization
39. 실행 사이클에서 다음 마이크로 연산이 나타내는 동작은?
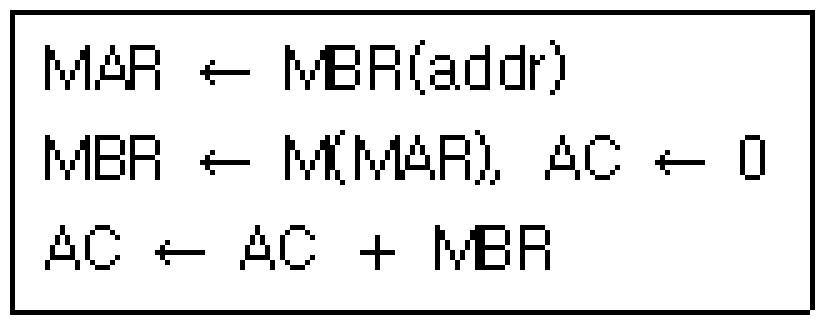
- ADD to AC
- OR to AC
- STORE to AC
- LOAD to AC
정답과 해설 보기
정답: 4
정답은 ④ LOAD to AC이다. 첫 단계 MAR←MBR(addr)는 명령어의 주소 부분을 메모리 주소로 사용하게 한다. 이어 MBR←M(MAR)는 그 주소의 데이터를 읽으며, 동시에 AC←0으로 누산기를 비운다. 마지막 AC←AC+MBR에서는 이미 AC가 0이므로 결과가 0+MBR, 즉 읽어온 데이터가 된다.
따라서 전체 효과는 메모리의 값을 AC에 적재하는 LOAD이다. 마지막 줄에 더하기 기호가 있다는 이유만으로 ADD라고 고르면 앞 단계의 AC←0을 놓친 것이다. ADD to AC라면 기존 AC의 값에 피연산자를 더하는 효과가 있어야 한다. 이 문항은 중간에 사용한 연산 종류보다 전체 마이크로 연산 전후의 상태를 비교해 명령의 효과를 판정한다.
선지별 해설
- ① 오답. 기존 AC를 0으로 지웠으므로 원래 값에 더하는 ADD 효과가 아니다.
- ② 오답. OR 연산이 제시되지 않았고 전체 효과도 메모리 값의 적재이다.
- ③ 오답. 제시한 경로는 메모리에서 읽어 AC로 가져오는 방향이다.
- ④ 정답. AC가 먼저 0이 된 뒤 MBR 값으로 바뀌므로 적재 동작이다.
편집 해설 근거: MIT 6.004 (2017), 13.1 Building the Beta — LD instruction datapath와 ALU/register write 설명
40. 버스 클록(clock)이 2.5GHz이고, 데이터 버스의 폭이 8비트인 버스의 대역폭에 가장 근접한 것은?
[학습용 개정문항]
클록 한 주기마다 8비트 데이터를 한 번 전송하며 대기·프로토콜 오버헤드는 무시한다. G는 10의 9제곱을 뜻한다.
- 약 25GBytes/s
- 약 16GBytes/s
- 약 2.5GBytes/s
- 약 1.6GBytes/s
정답과 해설 보기
정답: 3
정답은 ③ 약 2.5GBytes/s이다. 클록 한 주기마다 버스 폭만큼 한 번 전송한다면, 2.5GHz는 초당 2.5×10의 9제곱 회 전송이고 한 번에 8비트=1바이트를 보낸다. 따라서 이론 대역폭은 2.5×10의 9제곱 회/초×1바이트/회=2.5×10의 9제곱 바이트/초, 즉 2.5GB/s이다.
8을 곱한 20은 Gbit/s 단위의 값이며 GByte/s로 쓰려면 다시 8로 나누어야 한다. 여기서 G는 십진 접두어 10의 9제곱이다. 한 클록에 여러 번 전송하는 버스나 여러 채널을 병렬 사용하는 경우에는 그 전송 횟수·채널 수를 추가로 반영해야 한다. 실제 처리량은 대기·중재 등으로 이론값보다 작을 수 있으므로 문제에 전송 횟수와 오버헤드 무시 조건을 명시했다.
선지별 해설
- ① 오답. 주어진 폭과 초당 전송 횟수의 곱보다 10배 큰 값이다.
- ② 오답. 8비트=1바이트 변환과 2.5GHz 조건을 적용한 결과가 아니다.
- ③ 정답. 한 번에 1바이트를 초당 2.5×10의 9제곱 회 보내므로 2.5GB/s이다.
- ④ 오답. 이론 대역폭 계산에 제시되지 않은 감속 조건을 넣은 값이다.
편집 해설 근거: MIT 6.004 (2017), 14.1 Caches and the Memory Hierarchy — Memory Technologies / SRAM·DRAM의 latency와 bandwidth 구분
정보처리기사 필기 기출문제 · 운영체제
41. 운영체제에 대한 설명으로 옳지 않은 것은?
- 다중 사용자와 다중 응용프로그램 환경 하에서 자원의 현재 상태를 파악하고 자원분배를 위한 스케줄링을 담당한다.
- CPU, 메모리 공간, 기억 장치, 입/출력 장치 등의 자원을 관리한다.
- 운영체제의 종류로는 매크로 프로세서, 어셈블러, 컴파일러 등이 있다.
- 입출력 장치와 사용자 프로그램을 제어한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 운영체제는 실행 중인 프로그램이 CPU·메모리·파일·입출력 장치 같은 자원을 안전하고 효율적으로 사용하도록 관리한다. CPU를 어느 작업에 배분할지 결정하는 스케줄링과 장치 접근 조정도 이 역할에 포함된다.
매크로 프로세서는 매크로 호출을 정해진 내용으로 확장하고, 어셈블러는 어셈블리 언어를 기계 코드로 번역하며, 컴파일러는 소스 프로그램을 다른 표현으로 번역하는 개발 도구이다. 이 도구들이 운영체제 위에서 실행되거나 시스템 소프트웨어에 속할 수는 있어도 운영체제의 종류가 되는 것은 아니다. 특히 모든 컴파일러가 반드시 곧바로 기계어만 출력한다고 단정하지 않는다.
선지별 해설
- ① 오답. 작업과 자원의 상태를 관리하고 실행 기회를 배분하는 기능이다.
- ② 오답. 하드웨어 자원 관리는 운영체제의 핵심 역할이다.
- ③ 정답. 나열한 것은 언어 처리·개발 도구이며 운영체제 종류가 아니다.
- ④ 오답. 프로그램 실행과 입출력 접근의 제어를 지원한다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 2 Introduction to Operating Systems — 2.1~2.3 Virtualizing CPU/Memory 및 Concurrency; 2.5 Design Goals
42. 운영체제의 성능평가 요인 중 다음 설명에 해당하는 것은?
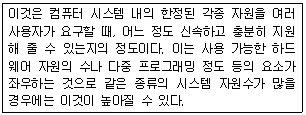
- Throughput
- Availability
- Turn around Time
- Reliability
정답과 해설 보기
정답: 2
정답은 ② Availability(가용성·사용가능도)이다. 그림은 필요한 시점에 시스템 자원을 이용할 수 있는가라는 관점을 설명한다. 처리한 작업의 수나 한 작업의 완료 시간보다, 사용자가 요청한 서비스를 이용할 수 있는 상태인가가 판단 단서이다.
Throughput은 단위 시간의 처리량, Turnaround Time은 작업 제출부터 완료까지 걸린 시간이다. Reliability는 정해진 조건과 기간 동안 기능을 올바르게 수행하는 신뢰성을 뜻한다. 가용성과 신뢰성은 관련이 있지만 고장 후 신속하게 복구되는 정도까지 생각하면 동일한 개념은 아니다. 그림의 하드웨어 증설·다중 프로그래밍은 자원 이용 가능성을 돕는 수단으로 이해해야 하며, 무조건 가용성이 높아진다는 법칙이나 가용성의 계산식으로 외우지 않는다.
선지별 해설
- ① 오답. 단위 시간 동안 완료하는 작업 수를 나타내는 처리량이다.
- ② 정답. 필요한 자원·서비스를 필요한 때 이용할 수 있는 성질이다.
- ③ 오답. 작업의 제출부터 완료까지 경과한 시간이다.
- ④ 오답. 기능을 올바르게 지속 수행하는 신뢰성과 가용성을 구별해야 한다.
편집 해설 근거: NIST CSRC Glossary, Availability — authorized users가 필요할 때 접근·사용할 수 있다는 정의
43. 분산 운영체제에 대한 설명으로 옳지 않은 것은?
- 자원 공유
- 연산속도 향상
- 신뢰성 증대
- 보안성 향상
정답과 해설 보기
정답: 4
정답은 ④ 보안성 향상이다. 분산 시스템을 구성하면 여러 노드의 자원을 공유하고, 병렬화 가능한 계산을 나누거나, 중복 자원을 통해 일부 장애에 대비할 수 있다. 이런 효과는 적절한 설계를 전제로 하는 대표적인 도입 목적이다.
보안은 단순히 노드를 분산했다는 사실만으로 좋아지지 않는다. 통신 상대를 확인하는 인증, 접근 권한, 전송 중 도청·변조 방지 등을 별도로 설계해야 한다. 따라서 이 교과서적 장점 비교에서는 ④를 고른다. 기존 해설처럼 분산하면 보안성이 반드시 떨어진다고 반대로 단정하는 것도 옳지 않다. 속도·신뢰성 역시 통신 비용이나 중복·복구 설계에 영향을 받으며 자동 보장은 아니다.
선지별 해설
- ① 오답. 서로 다른 노드의 데이터·장치를 공유하려는 목적이다.
- ② 오답. 병렬화 가능한 작업을 나누어 속도 향상을 기대할 수 있다.
- ③ 오답. 중복과 장애 대응을 설계하면 신뢰성을 높일 수 있다.
- ④ 정답. 분산 그 자체가 보안 향상을 보장하지 않으며 인증·권한·통신 보호가 필요하다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 48 Distributed Systems — 48장 도입부, 장애와 performance·security 고려
44. 은행가 알고리즘은 다음 교착상태 관련 연구 분야 중 어떤 분야에 속하는 가?
- 예방
- 발견
- 회피
- 회복
정답과 해설 보기
정답: 3
정답은 ③ 회피이다. 은행가 알고리즘은 각 프로세스의 최대 자원 요구량과 현재 할당·가용량을 바탕으로, 요청을 허용한 뒤에도 모든 프로세스가 완료할 수 있는 안전 순서가 있는지 검사한다. 안전성을 유지할 수 있을 때만 자원을 할당하여 위험한 상태에 들어가지 않도록 한다.
예방은 교착상태의 필요 조건 중 하나가 성립하지 않게 구조적으로 제한하는 접근이다. 발견은 이미 발생한 교착을 찾아내는 것이고 회복은 발견한 교착에서 벗어나기 위해 자원 회수·프로세스 종료 등을 하는 것이다. 은행가 알고리즘은 할당 전에 상태를 평가하므로 회피이다. 불안전 상태라는 말은 교착이 이미 발생했다는 뜻이 아니라 앞으로 완료를 보장할 안전 순서가 없다는 뜻이다.
선지별 해설
- ① 오답. 필요 조건 자체를 깨는 예방과 안전 상태를 검사하는 회피를 구별한다.
- ② 오답. 발생한 교착을 사후에 탐지하는 방법이 아니다.
- ③ 정답. 요청 허용 후 안전성을 검사하여 불안전한 할당을 피한다.
- ④ 오답. 이미 발생한 교착을 해소하는 복구 절차가 아니다.
편집 해설 근거: Silberschatz·Galvin·Gagne, Operating System Concepts 9판, 7 Deadlocks — 슬라이드 7.18~7.22 Safe State / Avoidance Algorithms 및 7.27 Banker’s Algorithm
45. UNIX의 특징으로 옳지 않은 것은?
- 하나 이상의 작업에 대하여 백그라운드에서 수행 가능하다.
- Multi-Tasking은 지원하지만 Multi-User는 지원하지 않는다.
- 트리 구조의 파일 시스템을 갖는다.
- 이식성이 높으며 장치 간의 호환성이 높다.
정답과 해설 보기
정답: 2
정답은 ②이다. UNIX는 여러 사용자가 시스템을 이용하면서 여러 프로세스를 실행할 수 있도록 설계된 운영체제이다. 따라서 다중 작업만 지원하고 다중 사용자는 지원하지 않는다는 설명은 틀리다.
셸에서 비동기·백그라운드 작업을 시작할 수 있고, 파일은 루트 아래의 디렉토리 계층으로 조직한다. C 언어와 비교적 일관된 인터페이스를 활용하여 이식성을 높인 것도 역사적인 특징이다. 다만 이식성이 높다는 말이 어떤 기계에서도 드라이버나 포팅 없이 똑같이 실행된다는 뜻은 아니다. 또한 여러 작업을 번갈아 진행하는 다중 작업과 여러 사용자 계정을 지원하는 다중 사용자는 서로 다른 개념이다.
선지별 해설
- ① 오답. 비동기 프로세스와 백그라운드 작업 실행이 가능하다.
- ② 정답. UNIX는 다중 사용자 기능도 지원하므로 틀린 설명이다.
- ③ 오답. 계층적 디렉토리 파일 시스템이 대표적인 특징이다.
- ④ 오답. 이식성·일관된 장치 접근을 강조한 특징이며 무조건적인 모든 장치 호환을 뜻하지 않는다.
편집 해설 근거: Ritchie·Thompson, The UNIX Time-Sharing System (1978 개정본) — Abstract의 multi-user, hierarchical file system, asynchronous processes, portability
46. 다중 처리기 운영체제 구성에서 주/종(Master/Slave) 처리기 에 대한 설명으로 옳지 않은 것은?
- 주 프로세서가 고장날 경우에도 전체 시스템은 작동한다.
- 비대칭 구조를 갖는다.
- 종 프로세서는 입출력 발생 시 주 프로세서에게 서비스를 요청한다.
- 주 프로세서는 운영체제를 수행한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 이 문제의 전통적인 주/종 구조에서는 주 처리기가 운영체제의 스케줄링·입출력 등 핵심 서비스를 맡고, 종 처리기는 필요한 서비스를 주 처리기에 요청한다. 역할이 서로 같지 않으므로 비대칭 구조이다.
주 처리기의 역할을 다른 처리기가 인계받는 별도 장치가 없다면 주 처리기 장애는 전체 운영을 중단시킬 수 있다. 종 처리기가 여러 개 있다는 사실만으로 주 처리기의 필수 서비스까지 대체되는 것은 아니다. 따라서 주 처리기가 고장 나도 시스템이 그대로 작동한다는 ①이 틀리다. 장애 인계 기능을 별도로 설계한 현대 시스템까지 모두 반드시 정지한다고 일반화하지 않는다.
선지별 해설
- ① 정답. 별도 인계 기능이 없는 이 구조에서 핵심 역할을 맡은 주 처리기의 장애는 전체 운영을 멈출 수 있다.
- ② 오답. 처리기 역할이 다르므로 비대칭이다.
- ③ 오답. 종 처리기는 주 처리기가 담당하는 입출력 서비스를 요청한다.
- ④ 오답. 주 처리기가 운영체제의 핵심 처리를 맡는다.
편집 해설 근거: Gordon College CS322, Multiple CPU Systems — Some comments about tightly-coupled systems, locus of operating system kernel functions
47. 운영체제의 목적이 아닌 것은?
- 처리 능력의 향상
- 반환 시간의 최대화
- 사용 가능도 증대
- 신뢰도 향상
정답과 해설 보기
정답: 2
정답은 ② 반환 시간의 최대화이다. 반환 시간(turnaround time)은 작업이 도착·제출된 시점부터 끝난 시점까지 걸린 시간이다. 같은 작업을 더 오래 기다리게 만드는 최대화가 아니라, 다른 요구 조건과 함께 이 시간을 줄이는 것이 일반적인 성능 목표이다.
처리 능력은 단위 시간에 완료하는 작업을 늘리는 방향, 가용성은 필요한 때 서비스를 이용할 수 있게 하는 방향, 신뢰성은 올바른 동작을 지속하는 방향으로 개선한다. 모든 목표를 동시에 극대화할 수 있는 것은 아니다. 예를 들어 빠른 첫 응답과 전체 반환 시간 사이에도 절충이 있다. 하지만 이런 절충이 반환 시간을 의도적으로 최대화하는 것을 일반 목적로 만들지는 않는다.
선지별 해설
- ① 오답. 같은 시간에 더 많은 유효 작업을 처리하는 것은 일반적인 목적이다.
- ② 정답. 반환 시간을 늘리는 것이 아니라 줄이는 방향을 추구한다.
- ③ 오답. 필요한 서비스의 이용 가능성을 높이는 목적이다.
- ④ 오답. 안정적이고 올바른 동작을 유지하려는 목적이다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 7 Scheduling: Introduction — 7.2 Scheduling Metrics 및 turnaround time 정의; NIST CSRC Glossary, Availability — 접근·사용 가능성 정의
48. 보안 유지 방식 중 사용자의 신원을 확인한 후 권한이 있는 사용자에게만 시스템에 접근하게 하는 방법은?
[학습용 개정문항]
- 운용보안
- 시설보안
- 사용자 접근 제어(인증·인가)
- 내부보안
정답과 해설 보기
정답: 3
정답은 ③ 사용자 접근 제어(인증·인가)이다. 먼저 요청자가 누구인지 확인하는 과정이 인증(authentication)이고, 그 주체가 특정 시스템·자료·기능을 사용할 권한이 있는지 결정하는 과정이 인가(authorization)이다. 지문은 이 둘을 연결해 허가된 사용자만 접근하도록 하는 상황이다.
비밀번호 확인에 성공했다고 해서 모든 파일을 읽거나 모든 관리자 기능을 실행해도 되는 것은 아니다. 인증 뒤에도 요청한 작업에 대한 권한을 검사해야 한다. 시설보안은 출입·전원·물리적 보호 등의 관점이고, 운용 절차나 내부 보호 역시 관련은 있지만 지문의 신원·권한 검사를 가장 직접 표현한 것은 ③이다. 기존의 ‘사용자 인터페이스보안’이라는 오래된 포괄 용어를 구체적인 인증·인가로 명확히 했다.
선지별 해설
- ① 오답. 보안 운영 절차 전반보다 지문은 사용자의 신원·권한 검사를 직접 묻는다.
- ② 오답. 시설의 물리적 접근·환경 보호와 구별한다.
- ③ 정답. 누구인지 인증한 다음 허용된 접근인지 인가한다.
- ④ 오답. 내부 자원 보호의 넓은 표현보다 인증·인가라는 구체적인 기능이 적절하다.
편집 해설 근거: Peter Reiher, OSTEP v1.10, 54 Authentication — 54.1 Introduction; 54.3 How To Authenticate Users?; Peter Reiher, OSTEP v1.10, 55 Access Control — 55.1 Introduction, access control decisions
49. 메모리 관리 기법 중 Worst fit 방법을 사용할 경우 10K 크기의 프로그램 실행을 위해서는 어느 부분이 할당 되는가?
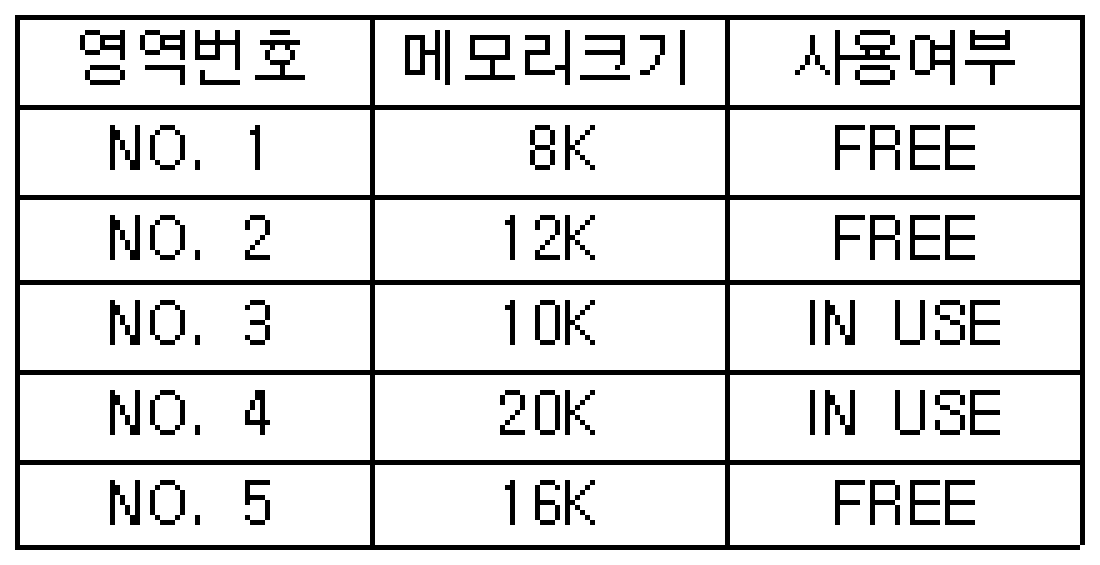
- NO.2
- NO.3
- NO.4
- NO.5
정답과 해설 보기
정답: 4
정답은 ④ NO.5이다. Worst fit은 요청을 수용할 수 있는 빈 영역 중 가장 큰 곳을 선택한다. 그림에서 NO.1은 8K, NO.2는 12K, NO.5는 16K의 빈 공간이고 NO.3·NO.4는 사용 중이다. 10K를 요구하므로 8K는 부족하며, 12K와 16K 중 큰 16K를 고른다.
따라서 NO.5에 10K를 배치하며 분할을 허용하면 6K가 남는다. NO.4가 20K로 가장 커 보여도 사용 중인 공간이므로 후보가 아니다. 가장 작은 충분한 공간 12K를 고르는 것은 Best fit이고, 순서상 처음 충분한 공간을 고르는 것은 First fit이다. 알고리즘을 비교할 때 전체 영역 크기보다 먼저 FREE/IN USE를 확인해야 한다.
선지별 해설
- ① 오답. 12K는 충분하지만 16K보다 작아 Worst fit의 선택이 아니다.
- ② 오답. NO.3은 이미 사용 중이다.
- ③ 오답. NO.4도 사용 중이므로 크기와 관계없이 제외한다.
- ④ 정답. 가용 영역 중 가장 큰 16K이다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 17 Free-Space Management — 17.3 Basic Strategies, Worst Fit
50. HRN 방식으로 스케줄링 할 경우, 입력된 작업이 다음과 같을 때 우선순위가 가장 높은 순서부터 차례로 옳게 나열한 것은?
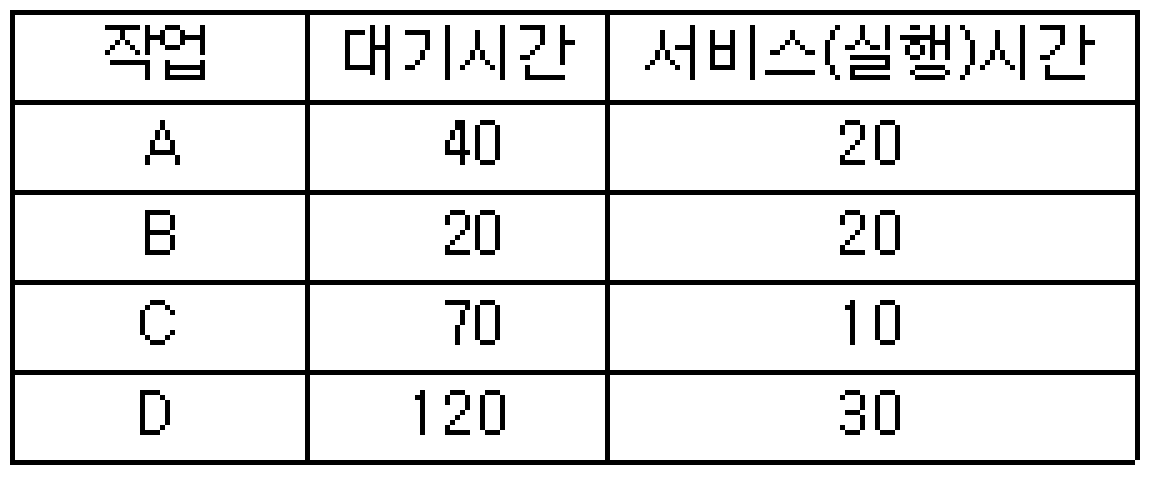
- B→A→C→D
- B→A→D→C
- C→D→A→B
- D→C→A→B
정답과 해설 보기
정답: 3
정답은 ③ C→D→A→B이다. HRN의 응답비는 (대기시간+서비스시간)/서비스시간, 즉 1+대기시간/서비스시간이다. 그림에 주어진 시점의 값으로 A=(40+20)/20=3, B=(20+20)/20=2, C=(70+10)/10=8, D=(120+30)/30=5이다.
큰 응답비부터 정렬하면 C(8), D(5), A(3), B(2)가 된다. 대기시간만 보면 D가 가장 길지만 C는 서비스시간에 비해 오래 기다려 응답비가 더 크다. 이 문제는 표의 현재 우선순위 비교이다. 실제로 한 작업을 완료한 뒤 다음 작업을 고를 때는 남은 작업의 대기시간이 더 늘어나므로 다시 응답비를 계산해야 한다. 현재 순위와 전체 실행 과정의 고정 순서를 일반적으로 같은 것으로 취급하지 않는다.
선지별 해설
- ① 오답. 가장 작은 응답비 2인 B를 먼저 배치했다.
- ② 오답. B가 첫 번째일 수 없고 C의 응답비가 가장 크다.
- ③ 정답. 계산값 8>5>3>2 순서이다.
- ④ 오답. D의 5보다 C의 8이 크다.
편집 해설 근거: Virginia Tech CS3204, Scheduling Analysis (2005) — 슬라이드 13 Highest Response Ratio Next (HRRN)
51. 초기 헤드 위치가 50 이며 트랙 0번 방향으로 이동 중이었다. 디스크 대기 큐에 다음과 같은 순서의 액세스 요청이 대기 중일 때, SSTF 스케줄링 사용하여 모든 처리를 완료하고자 한다. 가장 먼저 처리되는 트랙은? (단, 트랙 가장 안쪽 트랙 0, 가장 바깥쪽 트랙 200)
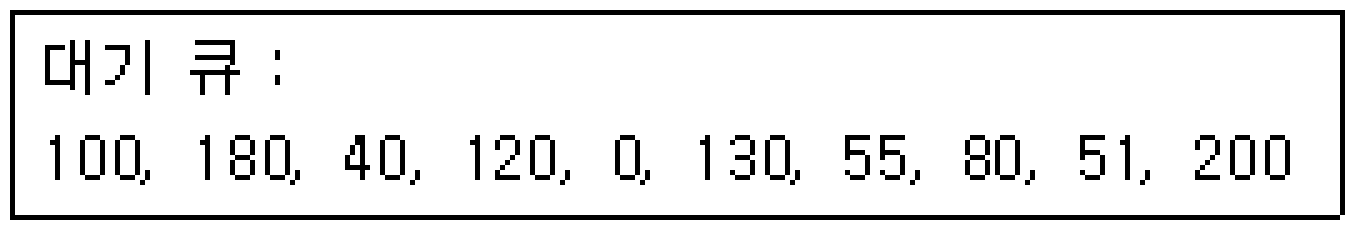
- 0
- 40
- 51
- 200
정답과 해설 보기
정답: 3
정답은 ③ 51이다. SSTF는 현재 헤드에서 탐색 거리가 가장 짧은 요청을 다음에 처리한다. 현재 위치 50에서 요청 51까지 거리는 1이고, 55까지 5, 40까지 10, 80까지 30이다. 그림의 나머지 요청들도 51보다 멀다.
따라서 첫 요청은 51이다. 이전에 0번 방향으로 이동 중이었다는 정보는 현재 방향을 유지하면서 훑는 SCAN 계열을 판단할 때 중요하지만, 이 SSTF 선택에서는 거리 1이라는 최소값을 바꾸지 않는다. 대기 큐의 첫 항목 100부터 처리하는 FCFS와도 구별한다. 동거리 요청이 있었다면 추가 규칙이 필요할 수 있으나 이 문제의 최소 거리는 유일하다.
선지별 해설
- ① 오답. 0까지 거리는 50으로 51까지의 거리 1보다 크다.
- ② 오답. 40까지는 10만큼 이동해야 한다. 이전 방향만으로 우선하지 않는다.
- ③ 정답. 50과의 거리가 1로 가장 가깝다.
- ④ 오답. 200까지는 150만큼 이동해야 한다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 37 Hard Disk Drives — 37.5 Disk Scheduling, SSTF: Shortest Seek Time First
52. UNIX 시스템에서 커널의 수행기능에 해당하지 않는 것은?
- 프로세스 관리
- 기억장치 관리
- 입출력 관리
- 명령어 해석
정답과 해설 보기
정답: 4
정답은 ④ 명령어 해석이다. 여기서 명령어 해석은 사용자가 셸에 입력하는 명령 문자열의 구문을 읽고 실행할 프로그램·리다이렉션·파이프 등을 정하는 일을 뜻한다. 이 역할은 셸이 담당하며 커널 자체의 사용자 명령 해석 기능으로 분류하지 않는다.
셸이 실행을 요청하면 커널은 프로세스 생성·스케줄링, 메모리 관리, 파일·장치 입출력 같은 서비스를 제공한다. 예를 들어 cat 명령을 해석하는 것과 cat 프로세스의 파일 읽기를 커널이 처리하는 것은 단계가 다르다. CPU의 기계 명령어 해독 장치와 셸의 명령 언어 해석도 다른 개념이다. 셸을 커널 내부의 필수 구성요소라고 혼동하지 않는다.
선지별 해설
- ① 오답. 프로세스 생성·상태·스케줄링 등은 커널의 핵심 관리 기능이다.
- ② 오답. 주소 공간과 메모리 자원의 관리는 커널 기능이다.
- ③ 오답. 장치·파일 입출력 서비스는 커널 기능이다.
- ④ 정답. 사용자 명령 언어를 해석하는 것은 셸의 역할이다.
편집 해설 근거: POSIX.1-2024 Issue 8, Shell Command Language — 2.1 Shell Introduction; Arpaci-Dusseau, OSTEP v1.10, 2 Introduction to Operating Systems — CPU·memory·persistence 설명
53. RR(Round Robin) 스케줄링에 대한 설명으로 옳지 않은 것은?
- Time slice가 작을 경우 문맥교환이 자주 일어난다.
- Time Sharing System을 위해 고안된 방식이다.
- FCFS 알고리즘을 선점 형태로 변형한 기법이다.
- 우선순위는 “(대기시간+서비스시간)/서비스시간”의 계산으로 처리한다.
정답과 해설 보기
정답: 4
정답은 ④이다. RR은 준비 큐의 작업에 일정한 시간 할당량(time quantum)을 주고, 시간이 끝나도 완료되지 않은 작업은 선점하여 다시 차례를 기다리게 하는 순환 스케줄링이다. 기다리는 작업에 반복해서 CPU 사용 기회를 주므로 대화형 시분할과 관련이 깊다.
시간 할당량을 작게 하면 각 작업이 더 빨리 차례를 받을 수 있지만 문맥 교환이 잦아져 관리 비용이 커질 수 있다. 반대로 충분히 크게 하면 작업이 차례대로 끝나는 FCFS와 비슷해질 수 있다. (대기시간+서비스시간)/서비스시간은 HRN의 응답비이며, RR의 차례를 결정하는 기본 공식이 아니다.
선지별 해설
- ① 오답. 다른 조건이 같으면 짧은 할당량은 교환 빈도를 높일 수 있다.
- ② 오답. 대화형 시분할의 응답성 확보와 관련된 방식이다.
- ③ 오답. 준비 큐 순서와 시간 할당량 선점을 결합한다는 교과서적 설명이다.
- ④ 정답. 이 공식은 RR이 아니라 HRN의 응답비이다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 7 Scheduling: Introduction — 7.7 Round Robin, time slice 및 context-switch 비용; Virginia Tech CS3204, Scheduling Analysis (2005) — 슬라이드 13 HRRN
54. 페이징 기법과 세그먼테이션 기법에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 페이징 기법에서는 주소 변환을 위한 페이지 맵 테이블이 필요하다.
- 페이지 크기로 일정하게 나누어진 주기억장치의 단위를 페이지 프레임이라고 한다.
- 페이징 기법에서는 하나의 작업을 다양한 크기의 논리적인 단위로 나눈 후 주기억장치에 적재시켜 실행한다.
- 세그먼테이션은 논리적 구간별 공유와 보호를 지원할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 페이징은 가상 주소 공간을 일정한 크기의 페이지로, 물리 메모리를 대응하는 크기의 프레임으로 나누어 매핑한다. 페이지 테이블에는 어떤 페이지가 어느 프레임에 대응되는지 등의 정보가 들어간다. 함수·배열·스택처럼 논리적인 구간마다 서로 다른 크기로 나누는 설명은 세그먼테이션에 가깝다.
세그먼테이션은 코드·데이터 등 의미 있는 구간에 별도 주소 범위와 보호 속성을 둘 수 있어 공유·보호를 표현하기 쉽다. 메모리 절약이 가능한 경우도 있지만 외부 단편화 등의 비용이 있고, 언제나 공간이 줄어드는 것도 아니다. 기존 ④의 ‘궁극적인 이유는 기억공간 절약’이라는 포괄적인 단정은 별도 오답으로 읽힐 수 있어 공유·보호 지원이라는 명확한 설명으로 수정했다.
선지별 해설
- ① 오답. 일반적인 페이징에서는 페이지별 주소 매핑을 위한 페이지 테이블을 사용한다.
- ② 오답. 물리 메모리의 일정 크기 슬롯이 페이지 프레임이다.
- ③ 정답. 가변 크기 논리 단위는 세그먼테이션 설명이며 기본 페이징과 다르다.
- ④ 오답. 세그먼트 단위로 보호 속성을 두고 공유를 지원할 수 있다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 18 Paging: Introduction — 18장 도입부 및 페이지 테이블 설명; Arpaci-Dusseau, OSTEP v1.10, 16 Segmentation — 16.1 Generalized Base/Bounds; 16.4 Support for Sharing
55. 운영체제 내부의 파일 제어 블록(FCB)과 파일 관리 정보에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 파일의 위치·크기·권한 등 관리 정보를 보관하는 자료구조이다.
- 구체적인 구조는 파일 시스템과 운영체제에 따라 다를 수 있다.
- 디스크의 파일 메타데이터를 필요에 따라 메모리에 읽거나 캐시하여 관리한다.
- 일반 응용프로그램은 커널 내부 FCB를 임의의 포인터로 직접 수정할 수 있다.
정답과 해설 보기
정답: 4
정답은 ④이다. 이 개정문항은 운영체제 내부에서 파일의 위치·크기·권한 등의 메타데이터를 관리하는 파일 제어 블록(FCB)을 묻는다. 응용프로그램이 커널의 내부 자료구조를 일반 포인터처럼 임의로 고치는 방식이 아니라, 시스템 호출을 통해 파일을 조작하고 운영체제가 관련 정보를 관리한다.
POSIX의 file descriptor는 open()이 반환하는 0 이상의 정수 핸들이다. 프로그램은 이 정수를 read·write 등에 직접 전달할 수 있다. 그러므로 ‘파일 디스크립터는 사용자가 직접 참조할 수 없다’는 기존 해설은 이 의미에서는 틀리다. FCB라는 내부 메타데이터 구조와 사용자에게 보이는 정수 핸들을 분리하여 이해해야 한다. 디스크 메타데이터가 메모리에 캐시되는 시점·구조도 구현마다 다를 수 있다.
선지별 해설
- ① 오답. FCB는 파일의 관리 정보를 보관하는 자료구조이다.
- ② 오답. 구체적인 필드와 구조는 파일 시스템·운영체제마다 다를 수 있다.
- ③ 오답. 디스크의 파일 메타데이터를 필요 시 메모리에 읽거나 캐시하여 사용할 수 있다.
- ④ 정답. 응용프로그램이 보호된 커널 내부 메타데이터를 임의로 수정하도록 허용한다는 설명은 틀리다.
편집 해설 근거: Silberschatz·Galvin·Gagne, Operating System Concepts 9판, 12 File-System Implementation — 슬라이드 12.4 File-System Structure; 12.9~12.11 File-System Implementation; POSIX.1-2024 Issue 8, open() — RETURN VALUE
56. 프로세스 제어 블록을 갖고 있으며, 현재 실행 중이거나 곧 실행 가능하며, CPU를 할당받을 수 있는 프로그램으로 정의할 수 있는 것은?
- 워킹 셋
- 세그먼테이션
- 모니터
- 프로세스
정답과 해설 보기
정답: 4
정답은 ④ 프로세스이다. 프로그램 파일은 실행할 코드와 데이터의 정적인 표현이고, 프로세스는 그것이 실행되면서 메모리·레지스터·실행 위치·상태 등과 결합한 실행 단위이다. 운영체제는 PCB 등 관리 구조에 필요한 정보를 기록하고 스케줄링으로 CPU를 배분한다.
프로세스가 존재한다고 매 순간 CPU에서 실행 중인 것은 아니다. 실행 가능 상태로 기다리거나 입출력이 끝나기를 기다리는 상태일 수도 있다. 워킹 셋은 일정 구간에 참조하는 페이지들의 집합, 세그먼테이션은 메모리 관리 방식, 모니터는 동기화와 관련된 추상화이므로 실행 중인 프로그램 자체의 이름이 아니다.
선지별 해설
- ① 오답. 워킹 셋은 프로세스의 메모리 참조 집합과 관련된다.
- ② 오답. 세그먼테이션은 주소 공간을 논리 구간으로 관리하는 방법이다.
- ③ 오답. 동기화를 위한 고수준 구성 등으로 쓰이는 용어이며 이 실행 단위의 정의와 다르다.
- ④ 정답. 실행 문맥을 가진 프로그램의 실행 인스턴스이다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 4 The Abstraction: The Process — 4.1 The Abstraction: A Process; 4.4 Process States; 4.5 Data Structures
57. UNIX에서 파일 내용을 화면에 표시하는 명령과 파일의 소유자를 변경하는 명령을 순서적으로 옳게 나열한 것은?
- dir, chown
- cat, chown
- type, chmod
- type, cat
정답과 해설 보기
정답: 2
정답은 ② cat, chown이다. cat은 지정한 파일들을 읽어 그 내용을 순서대로 표준 출력에 쓴다. 표준 출력이 터미널에 연결되어 있으면 파일 내용이 화면에 보인다. chown은 지정한 파일의 소유자 ID를 바꾸는 명령이며, 실행에는 필요한 권한이 있어야 한다.
chmod는 파일의 접근 권한 모드를 바꾸는 명령으로 소유자 변경과 다르다. type은 일반적인 UNIX 셸에서 명령이 어떻게 해석되는지 확인하는 용도로 쓰이며, 다른 운영체제의 파일 내용 출력 명령과 혼동하지 않는다. 또한 cat의 출력은 리다이렉션이나 파이프로 전달할 수도 있어 언제나 화면으로만 간다고 외울 필요는 없다.
선지별 해설
- ① 오답. dir는 일반적으로 디렉토리 항목 표시와 관련되며 파일 내용 출력에 해당하지 않는다.
- ② 정답. cat은 내용 출력, chown은 소유자 변경이다.
- ③ 오답. type은 여기서 파일 내용 출력이 아니고 chmod는 소유자가 아니라 접근 권한 모드를 변경한다.
- ④ 오답. cat은 소유자 변경 명령이 아니다.
편집 해설 근거: POSIX.1-2024 Issue 8, cat — DESCRIPTION; POSIX.1-2024 Issue 8, chown — DESCRIPTION
58. 4개의 페이지를 수용할 수 있는 주기억장치가 있으며, 초기에는 모두 비어 있다고 가정한다. 다음의 순서로 페이지 참조가 발생할 때, FIFO 페이지 교체 알고리즘을 사용할 경우 페이지 결함의 발생 횟수는?
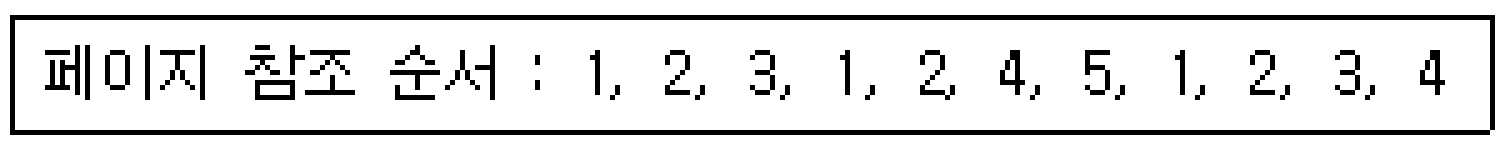
- 6회
- 7회
- 8회
- 9회
정답과 해설 보기
정답: 4
정답은 ④ 9회이다. FIFO는 가장 오래전에 들어온 페이지를 교체하며, 이미 있는 페이지를 다시 읽었다고 입장 순서를 갱신하지 않는다. 빈 네 프레임에 1·2·3을 처음 넣을 때 세 번 결함이 나고, 다음 1·2는 이미 있어 적중한다. 이어 4를 넣을 때 네 번째 결함이 난다.
그 다음 5는 가장 먼저 들어온 1을 교체한다. 이후 1은 2를, 2는 3을, 3은 4를, 4는 5를 차례로 교체하므로 다섯 번 더 결함이 난다. 총 4+5=9회이다. 참조 11번 중 네 번째·다섯 번째만 적중하므로 11−2=9로도 확인된다. 적중 때 페이지를 가장 최근으로 이동시키면 FIFO가 아니라 LRU에 가까운 다른 규칙을 적용하게 된다.
선지별 해설
- ① 오답. 처음 빈 프레임을 채우는 결함과 후반 연속 교체를 모두 세어야 한다.
- ② 오답. 전체 11번 참조 중 적중은 두 번뿐이다.
- ③ 오답. 마지막 4도 앞서 교체되어 없어 다시 결함이 난다.
- ④ 정답. 최초 적재 네 번과 그 뒤 교체 다섯 번으로 9회이다.
편집 해설 근거: Arpaci-Dusseau, OSTEP, 22 Beyond Physical Memory: Policies (2025 개정 표시본) — 22.3 A Simple Policy: FIFO 및 Figure 22.2
59. 프로세서의 상호 연결 구조 중 하이퍼 큐브 구조에서 각 CPU가 3개의 연결점을 가질 경우 총 CPU의 개수는?
- 2
- 3
- 4
- 8
정답과 해설 보기
정답: 4
정답은 ④ 8개이다. n차원 이진 하이퍼큐브의 노드는 n비트 주소로 구별하며, 한 비트만 다른 노드끼리 연결한다. 각 노드는 n개 비트 중 하나씩 바꾼 n개의 이웃을 가지므로 노드당 연결점이 3개이면 3차원 구조이다.
가능한 주소는 000부터 111까지 2의 3제곱=8개이다. 예를 들어 000의 이웃은 001·010·100으로 정확히 세 개이다. 연결점 수 3을 CPU 수라고 답하거나, 전체 링크 수와 CPU 수를 혼동하지 않는다. 이 경우 전체 무방향 링크 수는 각 노드의 세 연결을 두 번씩 세므로 8×3/2=12이며 CPU 수 8과 다르다.
선지별 해설
- ① 오답. 2노드 하이퍼큐브는 노드당 이웃이 1개이다.
- ② 오답. 연결점 수 3을 노드 수와 혼동했다.
- ③ 오답. 4노드 하이퍼큐브는 노드당 이웃이 2개이다.
- ④ 정답. 노드당 연결점 3개인 이진 하이퍼큐브는 2의 3제곱=8노드이다.
편집 해설 근거: University of Florida, Parallel Programming Pattern Language Glossary — hypercube 항목
60. 여러 사용자들이 공유하고자 하는 파일들을 하나의 디렉토리 또는 일부 서브트리에 저장해 놓고 여러 사용자들이 이를 같이 사용할 수 있도록 지원하기 위한 가장 효율적인 디렉토리 구조는?
- 비순환 그래프 디렉토리 구조
- 트리 디렉토리 구조
- 1단계 디렉토리 구조
- 2단계 디렉토리 구조
정답과 해설 보기
정답: 1
정답은 ① 비순환 그래프 디렉토리 구조이다. 순수한 트리에서는 각 하위 항목이 하나의 부모 경로에 속하지만, 공유를 나타내려면 서로 다른 디렉토리에서 같은 파일이나 하위 디렉토리를 가리킬 수 있어야 한다. 여러 부모에서 하나의 항목으로 이어지는 연결을 허용하되 순환을 만들지 않는 구조가 비순환 그래프이다.
공유 항목을 복사하여 각각 따로 관리하는 것이 아니라 같은 대상을 참조하므로 한쪽 변경이 공유 대상에 반영될 수 있다. 그만큼 삭제 시 남은 참조·별칭을 관리해야 하며, 단순히 모든 상황에서 가장 빠르다는 뜻은 아니다. 1단계는 하나의 목록, 2단계는 사용자별 목록, 트리는 계층 구조를 강조한다. 문항이 제시한 공유 파일·서브트리 표현에 맞는 선택지가 ①이다.
선지별 해설
- ① 정답. 같은 파일·서브디렉토리를 여러 경로가 공유하도록 표현할 수 있다.
- ② 오답. 순수 트리의 한 부모 원칙만으로는 같은 하위 트리의 다중 공유를 표현하기 어렵다.
- ③ 오답. 단일 이름 공간은 사용자별 계층과 공유 하위 트리를 표현하기에 제약이 크다.
- ④ 오답. 사용자별 분리는 가능하지만 공유 서브트리 연결을 표현하는 일반 구조는 아니다.
편집 해설 근거: Silberschatz·Galvin·Gagne, Operating System Concepts 9판, 11 File-System Interface — 슬라이드 11.30~11.31 Acyclic-Graph Directories
정보처리기사 필기 기출문제 · 소프트웨어 공학
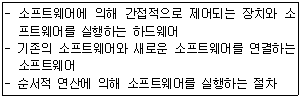
61. 소프트웨어 개발 영역을 결정하는 요인 중 다음 사항과 관계되는 것은?
- 소프트웨어에 대한 기능
- 소프트웨어에 대한 성능
- 소프트웨어에 대한 제약조건
- 소프트웨어에 대한 인터페이스
정답과 해설 보기
정답: 4
정답은 ④ 인터페이스이다. 그림은 소프트웨어가 실행될 하드웨어, 제어할 장치, 기존 소프트웨어와 새 소프트웨어 사이의 연결, 실행에 관계된 절차를 살핀다. 공통점은 소프트웨어의 경계를 넘어 무엇과 어떻게 상호작용하는가이다.
기능은 무엇을 수행하는지, 성능은 얼마나 빨리·많이 처리하는지, 제약조건은 어떤 기술·규칙·자원을 반드시 따라야 하는지를 다룬다. 인터페이스는 데이터를 주고받는 형식, 호출 규약, 장치·다른 시스템과의 접점을 구체화한다. 같은 장치 조건이 제약조건이 될 수도 있으나 이 문항의 항목들은 외부 요소와의 연결 관계를 묶어 설명하므로 ④가 가장 적절하다. 인터페이스를 사용자 화면만 뜻하는 말로 좁히지 않는다.
선지별 해설
- ① 오답. 기능은 시스템이 수행할 일을 말하며 외부 접점 전체와 구별한다.
- ② 오답. 성능은 처리시간·처리량·자원 사용 등이다.
- ③ 오답. 제약은 준수해야 할 한계·조건이고 지문은 연결 대상과 접점을 공통으로 묻는다.
- ④ 정답. 하드웨어·다른 소프트웨어 등과의 상호작용 경계에 관한 내용이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Design 1.4~1.6의 interfaces / separation of interface and implementation, PDF 85~87쪽
62. 검증 검사 기법 중 개발자의 장소에서 사용자가 개발자 앞에서 행하는 기법이며, 일반적으로 통제된 환경에서 사용자와 개발자가 함께 확인하면서 수행되는 검사는?
- 동치 분할 검사
- 형상 검사
- 알파 검사
- 베타 검사
정답과 해설 보기
정답: 3
정답은 ③ 알파 검사이다. 알파 테스트는 개발 조직의 장소에서 잠재·기존 고객이나 운영자, 독립 테스트 팀 등이 제품을 사용하며 확인하는 인수 테스트 형태이다. 지문에서 개발자 장소와 통제된 환경을 강조한 것이 단서이다.
베타 테스트는 사용자 측의 실제 환경에서 수행하여 개발 환경에서 발견하기 어려운 사용·환경 문제에 대한 피드백을 얻는다. 동치 분할은 어떤 시험 데이터를 선택할지 정하는 설계 기법으로 장소에 따른 알파·베타 구분과 다르다. 형상 검사는 제품 구성과 정해진 기준의 일치 여부를 살피는 관점이다. 알파를 개발자가 혼자 수행하는 테스트라는 뜻으로 외우면 사용자 참여라는 지문의 핵심을 놓치게 된다.
선지별 해설
- ① 오답. 입력을 동등한 그룹으로 나누는 테스트 설계 기법이다.
- ② 오답. 형상·구성이 기준과 일치하는지 확인하는 검사 관점이다.
- ③ 정답. 개발 조직의 장소에서 사용자 등의 피드백을 얻는 알파 테스트이다.
- ④ 오답. 베타는 사용자·고객 자신의 환경에서 수행하는 형태이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — 2.2.4 Acceptance Testing, Alpha and beta testing, 37쪽
63. 사용자 인터페이스 설계 시 오류 메시지나 경고에 관한 지침으로 옳지 않은 것은?
- 메시지는 이해하기 쉬워야 한다.
- 오류로부터 회복을 위한 구체적인 설명이 제공되어야 한다.
- 오류로 인해 발생될 수 있는 부정적인 내용은 가급적 피한다.
- 소리나 색 등을 이용하여 듣거나 보기 쉽게 의미 전달을 하도록 한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 오류 메시지는 사용자가 이해할 수 있는 말로 어떤 문제가 생겼는지와 취할 수 있는 조치를 알려야 한다. 저장 실패로 수정 내용이 사라질 수 있다면 그 영향을 숨기기보다, 사실에 맞게 설명하고 저장 재시도·다른 위치 선택 같은 회복 방법을 제공해야 한다.
피해야 하는 것은 사용자를 비난하거나 과도하게 겁주는 표현이지 필요한 부정적 결과 자체가 아니다. 기존 해설의 ‘부정적인 내용은 절대 사용해서는 안 된다’는 설명은 정답의 이유를 거꾸로 풀이한 오류였다. 소리·색·아이콘은 의미 전달을 도울 수 있으나 색이나 소리에만 의존하면 접근성이 떨어질 수 있다. 핵심 내용은 읽을 수 있는 텍스트 등으로도 전달해야 한다.
선지별 해설
- ① 오답. 대상 사용자가 이해할 수 있는 쉬운 표현이 필요하다.
- ② 오답. 실행 가능한 구체적인 회복 방법을 알려야 한다.
- ③ 정답. 데이터 손실 등 필요한 결과를 숨기는 것은 사용자의 판단을 방해한다.
- ④ 오답. 감각적 표시를 보조적으로 활용할 수 있다. 다만 색·소리만으로 의미를 전달해서는 안 된다.
편집 해설 근거: Microsoft, Windows 7 UX Guidelines: Error Messages — The characteristics of good error messages / messages that blame users; Microsoft, Windows 7 UX Guidelines: Warning Messages — 경고의 potential problem과 consequences 설명; W3C WCAG 2.2, Understanding 1.4.1 Use of Color — Intent, 색을 유일한 정보 전달 수단으로 사용하지 않는 설명
64. 프로토타이핑의 모형에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 프로토타이핑 모형은 발주자나 개발자 모두에게 공동의 참조 모델을 제공한다.
- 사용자의 요구사항을 충실히 반영하는 데 도움을 줄 수 있다.
- 개발 중 피드백을 반영할 수 있지만 배포 후 유지보수도 필요하다.
- 최종 결과물이 만들어지는 소프트웨어 개발 완료 시점에 최초로 오류 발견이 가능하다.
정답과 해설 보기
정답: 4
정답은 ④이다. 프로토타이핑은 완성품을 모두 구현하기 전에 주요 기능·화면·상호작용 등을 시제품으로 보여 주어 요구를 확인하는 방법이다. 사용자와 개발자가 같은 대상을 보고 논의하므로 말로만 전달했을 때의 오해를 줄이고 개발 중에 문제를 발견할 수 있다.
따라서 개발이 끝난 뒤에야 최초 오류 발견이 가능하다는 ④는 프로토타입의 목적과 반대이다. 다만 시제품이 요구 확인에 도움이 되어도 최종 시스템의 모든 성능·보안·품질을 검증한 것은 아니다. 출시 후 변화나 결함에 대한 유지보수도 여전히 필요하다. 기존 ③의 ‘유지보수가 없어진다’는 문장 역시 틀린 단정이므로, 개발 중 피드백과 출시 후 유지보수의 관계를 정확하게 바꾸었다.
선지별 해설
- ① 오답. 시제품을 공동 참조 대상으로 삼아 요구를 논의할 수 있다.
- ② 오답. 사용자 피드백으로 요구 반영을 개선할 수 있다.
- ③ 오답. 개발 중 수정은 가능하지만 배포 후 유지보수가 사라지지는 않는다는 올바른 설명이다.
- ④ 정답. 개발 완료 전 시제품 평가에서도 문제를 발견할 수 있으므로 틀리다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Engineering Foundations 6.3 Prototyping, PDF 375~376쪽; Software Maintenance 서론
65. 소프트웨어공학에 대한 설명으로 거리가 먼 것은?
- 소프트웨어공학이란 소프트웨어의 개발, 운용, 유지 보수 및 파기에 대한 체계적인 접근 방법이다.
- 소프트웨어공학은 소프트웨어의 제품의 품질을 향상시키고 소프트웨어 생산성과 작업 만족도를 증대시키는 것이 목적이다.
- 소프트웨어공학의 궁극적 목표는 최대의 비용으로 계획된 일정보다 가능한 빠른 시일 내에 소프트웨어를 개발하는 것이다.
- 소프트웨어공학은 신뢰성 있는 소프트웨어를 경제적인 비용으로 획득하기 위해 공학적 원리를 정립하고 이를 이용하는 학문이다.
정답과 해설 보기
정답: 3
정답은 ③이다. 소프트웨어공학은 요구를 충족하는 소프트웨어를 체계적으로 개발·운영·유지하며 품질·비용·일정·위험을 함께 관리하려는 접근이다. 비용을 최대한 많이 쓰고 계획보다 무조건 빨리 끝내는 것이 궁극적인 목표는 아니다.
필요한 신뢰성과 품질을 만족하면서 합리적인 비용과 일정으로 가치를 제공해야 한다. 반대로 비용을 어떤 상황에서도 최소로만 줄인다고 표현해도 정확하지 않다. 검증 비용을 줄여 안전성이나 요구 품질을 훼손하면 적절한 공학적 선택이 아니다. ①·②·④는 체계적 생명주기 관리, 품질·생산성 개선, 경제성과 신뢰성이라는 취지를 설명한다.
선지별 해설
- ① 오답. 개발·운영·유지·종료까지 체계적으로 다루는 접근과 맞다.
- ② 오답. 품질·생산성과 작업 과정의 개선은 타당한 목적이다.
- ③ 정답. 최대 비용과 무조건적인 일정 단축은 소프트웨어공학의 목표가 아니다.
- ④ 오답. 신뢰성과 경제성을 고려하여 공학적 원리를 적용한다는 취지이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Engineering Management 2.3~2.7, 비용·일정 추정/위험/품질/계획 관리
66. 바람직한 소프트웨어 설계 지침으로 볼 수 없는 것은?
- 모듈 간의 결합도는 강할수록 바람직하다.
- 모듈 간의 접속 관계를 분석하여 복잡도와 중복을 줄인다.
- 자료와 프로시저에 대한 분명하고 분리된 표현을 포함해야 한다.
- 설계는 소프트웨어 구조를 나타내어야 한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 결합도는 모듈들이 서로 얼마나 의존하는지를 나타낸다. 다른 모듈의 내부 구조와 처리 순서까지 알아야 동작한다면 한쪽 변경이 여러 곳으로 퍼지고 개별 테스트·재사용도 어려워진다. 그래서 설계에서는 필요한 연결을 명확한 인터페이스로 제한하여 과도한 결합을 줄이려 한다.
응집도는 한 모듈 내부 요소들이 하나의 목적에 얼마나 밀접하게 모여 있는가이므로 결합도와 측정 방향이 다르다. 일반적인 목표는 낮은 결합도와 높은 응집도이다. 모듈 사이의 통신 자체를 전부 없애라는 뜻은 아니며, 기능 수행에 필요한 관계는 유지하되 불필요한 의존·중복·복잡도를 줄여야 한다.
선지별 해설
- ① 정답. 모듈 사이의 강한 의존을 항상 바람직하다고 보는 주장은 틀리다.
- ② 오답. 접속 관계를 이해하여 불필요한 복잡도·중복을 줄이는 것은 적절하다.
- ③ 오답. 자료와 처리 절차를 명확히 표현하면 이해·검토에 도움이 된다.
- ④ 오답. 설계는 구성요소와 그 관계 등 소프트웨어 구조를 나타내야 한다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Design 1.6, Coupling and Cohesion, PDF 86쪽
67. 소프트웨어 형상관리의 대상으로 거리가 먼 것은?
- 소스 레벨과 수행 형태인 컴퓨터 프로그램
- 숙련자와 사용자를 목표로 한 컴퓨터 프로그램을 서술하는 문서
- 프로그램 내에 포함된 자료
- 시스템 개발 비용
정답과 해설 보기
정답: 4
정답은 ④ 시스템 개발 비용이다. 형상관리는 어떤 버전의 소스·실행 파일·명세·테스트 자료·데이터가 승인된 구성에 속하는지 식별하고, 그 변경과 상태를 추적하는 활동이다. 따라서 ①~③은 통상적인 소프트웨어 형상 항목으로 선정할 수 있는 산출물이다.
비용이라는 금액·예산·실적 지표 자체는 프로젝트의 비용 관리 대상이므로 제시한 산출물들과 구별된다. 그렇다고 비용이 기록된 계획서나 보고서를 절대로 버전 관리할 수 없다는 뜻은 아니다. 조직이 문서를 형상 항목으로 지정하면 그 문서도 변경 관리 대상이 될 수 있다. ‘비용 수치 관리’와 ‘비용 문서의 버전 관리’를 구분하면 문항의 취지가 명확해진다.
선지별 해설
- ① 오답. 소스 코드와 실행 파일은 대표적인 형상 항목이다.
- ② 오답. 설계·운용·사용자 문서는 형상 항목으로 관리할 수 있다.
- ③ 오답. 프로그램 구성에 포함되는 데이터도 형상 관리 대상이 될 수 있다.
- ④ 정답. 개발비라는 예산·실적 수치 자체는 프로젝트 비용 관리의 지표이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Configuration Management 2.1.2 Software Configuration Item, PDF 190쪽
68. 기존 소프트웨어를 재공학하면서, 아직 실제 장애로 나타나지 않은 잠재 결함을 미리 제거하는 데 초점을 둔 변경은 어느 유지보수 범주에 가장 직접 해당하는가?
[학습용 개정문항]
- 수정(Corrective) 유지보수
- 적응(Adaptive) 유지보수
- 완전화(Perfective) 유지보수
- 예방(preventive) 유지보수
정답과 해설 보기
정답: 4
정답은 ④ 예방 유지보수이다. 이 개정문항은 재공학을 수행하는 구체적인 목적이 잠재 결함을 실제 장애가 나기 전에 제거하는 것이라고 명시한다. 이미 발생한 문제의 수리가 아니라 앞으로 발생할 수 있는 문제를 미리 수정하므로 예방에 해당한다.
수정 유지보수는 발견된 문제의 수리, 적응 유지보수는 운영체제 등 환경 변화에 맞추어 계속 사용할 수 있게 하는 변경이다. 완전화는 성능·유지보수성 등을 개선하는 목적과 관련된다. 재공학은 기존 소프트웨어를 분석하고 새로운 형태로 바꾸는 방법이므로 여러 유지보수 목적에 사용될 수 있다. ‘재공학이면 무조건 예방’이라고 동일시하는 대신 변경을 수행한 목적을 기준으로 분류해야 한다.
선지별 해설
- ① 오답. 발생·발견한 문제의 수리가 아니라 장애 전 잠재 결함 제거를 명시했다.
- ② 오답. 새 운영 환경에 적응하려는 상황이 아니다.
- ③ 오답. 일반적인 성능·유지보수성 개선보다 잠재 장애 예방이 직접 목적이다.
- ④ 정답. 실제 장애가 되기 전에 잠재 결함을 제거하려는 변경이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Maintenance 1.6 Categories of Maintenance, PDF 170쪽; 4.2 Software Reengineering, PDF 179쪽
69. 다음 사항과 관계되는 결합도는?
[학습용 개정문항]
한 모듈이 다른 모듈의 내부 코드 중간으로 직접 제어를 이동한다. 또는 공개 인터페이스를 거치지 않고 다른 모듈의 내부 데이터를 직접 참조·수정한다.
- Data Coupling
- Content Coupling
- Control Coupling
- Stamp Coupling
정답과 해설 보기
정답: 2
정답은 ② Content Coupling(내용 결합도)이다. 한 모듈이 다른 모듈의 공개 인터페이스를 거치지 않고 내부 데이터나 코드 위치에 직접 의존하는 경우이다. 내부 자료를 임의로 바꾸거나 정상 진입점이 아닌 코드 중간으로 제어를 넘기면 상대 모듈의 내부 변경이 호출자까지 쉽게 깨뜨린다.
자료 결합은 필요한 값의 전달, 스탬프 결합은 자료구조의 전달, 제어 결합은 상대의 처리 방향을 지시하는 제어 정보 전달로 구별한다. 단순히 같은 숫자 상수를 사용한다는 사실만으로 내용 결합이 되는 것은 아니다. 기존 그림에 있던 그런 모호한 문장을 빼고 내부 코드·자료에 직접 접근하는 두 조건으로 개정했다.
선지별 해설
- ① 오답. 필요한 값만 인터페이스로 전달하는 것과 내부 자료 직접 접근은 다르다.
- ② 정답. 상대 모듈의 내부 코드·자료에 직접 의존한다.
- ③ 오답. 제어용 플래그 등으로 수행 내용을 지시하는 방식과 구별한다.
- ④ 오답. 복합 자료구조를 매개로 전달하는 결합이며 내부 코드로 뛰어드는 상황과 다르다.
편집 해설 근거: CMU SEI, FAA Research Project on System Complexity Effects on Aircraft Safety (2016) — Appendix A, coupling 분류 중 Content coupling
70. 소프트웨어 품질 목표 중 정해진 조건 아래에서 소프트웨어 제품의 일정한 성능과 자원 소요 정도의 관계에 관한 속성으로 시간 경제성, 자원 경제성 등의 품질 기준을 갖는 것은?
- Integrity
- Flexibility
- Efficiency
- Reliability
정답과 해설 보기
정답: 3
정답은 ③ Efficiency(효율성)이다. 지문은 같은 조건에서 필요한 성능을 어느 정도의 시간·계산 자원·저장 자원으로 제공하는가를 묻는다. 처리시간·처리량과 CPU·메모리 등의 소요를 함께 평가하는 관점이 성능 효율성이다.
무결성은 허가되지 않은 변경 등으로부터 데이터의 정확한 상태를 보호하는 관점이고, 융통성은 변화에 맞추어 바꾸거나 적용하기 쉬운 정도, 신뢰성은 주어진 조건에서 기능을 올바르게 수행하는 정도와 관련된다. 빠르지만 결과가 잘못되는 프로그램을 효율성 하나로 좋은 품질이라고 평가할 수는 없다. 이 문항은 품질 특성 중 특정한 축을 구분하며, 2015년 당시의 용어를 현재 모든 품질 모델의 분류와 동일하다고 주장하지 않는다.
선지별 해설
- ① 오답. Integrity는 무결성과 관련되며 시간·자원 대비 성능의 이름이 아니다.
- ② 오답. Flexibility는 변경·적용의 유연성과 관련된다.
- ③ 정답. 정해진 조건에서 성능과 사용 자원의 관계를 평가한다.
- ④ 오답. Reliability는 기능을 올바르게 지속 수행하는 신뢰성과 관련된다.
편집 해설 근거: ISO/IEC 25010:2011, 4.2.2 Performance efficiency (2015년 당시 모델) — 4.2.2 Performance efficiency; 4.2.2.1 Time behaviour; 4.2.2.2 Resource utilization
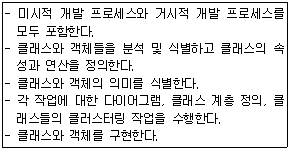
71. 객체지향 분석 기법 중 다음 설명에 해당하는 것은?
- Wirfs-Brock 방법
- Jacobson 방법
- Booch 방법
- Coad와 Yourdon 방법
정답과 해설 보기
정답: 3
정답은 ③ Booch 방법이다. 그림에서 가장 뚜렷한 식별 단서는 미시적 개발 프로세스와 거시적 개발 프로세스를 함께 구분한다는 점이다. Booch의 원 저서 2판은 개발 프로세스 장에서 이 두 수준을 별도 항목으로 다룬다.
클래스·객체·속성·연산을 찾는 활동은 여러 객체지향 방법에서 공통으로 나타날 수 있으므로 그 표현 하나만으로 방법론을 식별하면 안 된다. Wirfs-Brock은 책임 중심 설계와, Jacobson은 유스케이스 중심 접근과 연결하여 비교할 수 있다. Coad·Yourdon 역시 객체지향 분석 방법이지만 지문의 미시·거시 프로세스라는 식별 단서에 해당하는 답은 Booch이다.
선지별 해설
- ① 오답. 책임 중심으로 객체를 설계하는 방법과 관련되며 지문의 미시·거시 구분의 답은 아니다.
- ② 오답. 유스케이스 중심 접근을 강조하는 방법과 구별한다.
- ③ 정답. 원 저서의 The Process에서 Micro와 Macro Development Process를 구분한다.
- ④ 오답. 객체지향 분석이라는 공통점만으로 고를 수 없으며 제시한 미시·거시 단서는 Booch에 해당한다.
편집 해설 근거: Grady Booch, Object-Oriented Analysis and Design with Applications 2판, 출판사 목차 — 2판 목차, 6 The Process: The Micro Development Process / The Macro Development Process; Wirfs-Brock·Wilkerson, Object-Oriented Design: A Responsibility-Driven Approach (1989) — 원 논문 초록; Ivar Jacobson International, Use Case Definition — Use cases의 1992년 OOSE 저서 도입 설명
72. 소프트웨어 재공학의 주요 활동 중 기존 소프트웨어 시스템을 새로운 기술 또는 하드웨어 환경에서 사용할 수 있도록 변환하는 작업을 의미 하는 것은?
- Analysis
- Migration
- Restructuring
- Reverse Engineering
정답과 해설 보기
정답: 2
정답은 ② Migration(이주·이식)이다. 기존 응용프로그램을 다른 운영체제·하드웨어·플랫폼 등 새 실행 환경으로 옮겨 계속 사용할 수 있게 하는 활동을 말한다. 환경 차이에 따라 설정·의존성·인터페이스·데이터 변환을 함께 검토해야 할 수 있다.
Analysis는 현재 시스템의 구조·동작을 이해하는 분석이며, Restructuring은 내부 구조를 재정리하는 활동이다. Reverse Engineering은 구현에서 설계·요구 등 더 높은 수준의 정보를 복원하여 이해하는 방향이다. 이런 활동이 실제 이주 프로젝트에 함께 포함될 수는 있지만, 지문이 직접 강조한 결과는 새로운 환경에서 사용 가능하도록 옮기는 것이므로 Migration이다.
선지별 해설
- ① 오답. 분석은 이해·평가의 활동이며 새 환경으로 옮긴다는 결과를 직접 나타내지 않는다.
- ② 정답. 기존 소프트웨어를 다른 실행 환경으로 옮기고 사용할 수 있게 한다.
- ③ 오답. 구조 재정리이며 실행 환경 변경과 항상 동일하지 않다.
- ④ 오답. 구현에서 구조·설계를 이해하는 역방향 분석 활동이다.
편집 해설 근거: IBM, What is application migration? — What is application migration? 첫 정의 및 dependencies/technical requirements 설명; IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Maintenance 4.2~4.3 Reengineering / Reverse Engineering
73. 위험 모니터링(monitoring)의 의미로 가장 적절한 것은?
- 위험 요소를 인정하지 않는 것
- 위험요소들에 대하여 계획적으로 관리하는 것
- 위험 요소 징후들에 대하여 계속적으로 인지하는 것
- 첫 번째 조치로 위험을 피할 수 있도록 하는 것
정답과 해설 보기
정답: 3
정답은 ③이다. 위험 모니터링은 식별한 위험의 징후·발생 가능성·영향과 대응 조치의 진행 상태를 계속 확인하는 활동이다. 예를 들어 외부 부품 납기가 늦어질 위험을 기록했다면 공급사의 일정 변경이나 납품 진척을 주기적으로 확인하고, 악화되면 대응 계획을 조정한다.
②의 계획적인 관리는 위험 식별·분석·대응·감시를 포함하는 더 넓은 위험 관리 개념이다. ④의 회피는 위험의 원인이 되는 활동을 바꾸거나 하지 않는 대응 전략이며, 관찰을 뜻하는 monitoring과 다르다. 위험을 인정하지 않는 ①은 감시 활동이 아니다. 관찰만 하고 끝내는 것이 아니라 확인한 변화가 분석·대응 갱신으로 이어져야 한다.
선지별 해설
- ① 오답. 위험을 부정하면 징후를 추적할 수 없다.
- ② 오답. 위험 관리 전반을 포괄하여 모니터링의 직접 의미보다 넓다.
- ③ 정답. 징후와 상태 변화를 지속적으로 확인하는 활동이다.
- ④ 오답. 위험 회피라는 대응 전략과 모니터링을 구별한다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Engineering Management 3.4 Monitor Process, PDF 213쪽
74. 소프트웨어 재사용의 기대 효과에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 시스템 구조와 구축방법의 교육적 효과
- 개발기간 및 비용 절약
- 개발 시 작성된 문서의 공유
- 새로운 개발 방법에도 적합성 검토 없이 기존 자산을 항상 그대로 적용할 수 있음
정답과 해설 보기
정답: 4
정답은 ④이다. 소프트웨어 재사용은 기존의 코드·설계·문서·컴포넌트 등 적합한 자산을 다시 활용하는 것이다. 검증된 자산을 알맞게 적용하면 처음부터 다시 만드는 작업을 줄여 시간·비용을 아끼고, 기존 구조와 사용 문서에서 설계 지식을 얻을 수 있다.
하지만 자산이 새 개발 방법이나 환경에 맞는지는 별도로 확인해야 한다. 의존성·품질·라이선스·인터페이스 등의 조건을 무시해도 자동으로 적용된다는 보장은 없다. 재사용이 새 방법의 도입을 도울 때도 있으므로, 기존 ④의 막연한 ‘도입 용이성’ 대신 검토 없이 항상 적용 가능하다는 잘못된 보장으로 명확히 했다. 재사용 역시 평가·통합·검증 비용을 포함한다.
선지별 해설
- ① 오답. 기존의 잘 정리된 구조와 구축 사례는 학습 자료가 될 수 있다.
- ② 오답. 새로 작성할 부분을 줄이면 기간·비용 절감을 기대할 수 있다.
- ③ 오답. 재사용 자산의 문서를 함께 활용·공유할 수 있다.
- ④ 정답. 새 방법·환경에 대한 적합성 검토가 자동으로 면제되지는 않는다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Construction, Construction for/with Reuse; Software Architecture의 reference architectures, PDF 72~73쪽
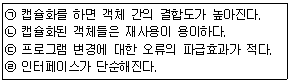
75. 객체 지향 기법에서 캡슐화(encapsulation)에 대한 옳은 내용 모두를 나열한 것은?
- (ㄱ), (ㄴ)
- (ㄱ), (ㄷ), (ㄹ)
- (ㄴ), (ㄷ), (ㄹ)
- (ㄱ), (ㄴ), (ㄷ), (ㄹ)
정답과 해설 보기
정답: 3
정답은 ③ (ㄴ), (ㄷ), (ㄹ)이다. 캡슐화는 데이터와 그에 관련된 동작을 묶고 외부에 필요한 인터페이스를 제공하여 내부 구현의 세부사항을 감추는 설계 원리이다. 사용자는 내부 자료구조를 모두 알지 않아도 정해진 동작을 요청할 수 있다.
이렇게 의존 범위를 줄이면 내부 변경이 외부에 미치는 영향을 제한하고 재사용·이해·검증을 돕는다. 그러므로 그림의 ㄴ 재사용 용이, ㄷ 변경 오류의 파급 감소, ㄹ 인터페이스 단순화는 기대 효과로 적절하다. ㄱ의 결합도 증가를 목표로 한다는 설명은 반대이다. 다만 단순히 클래스로 묶었다고 자동으로 좋은 캡슐화가 되는 것은 아니며, 내부 값을 무제한 공개하면 이런 효과가 약해진다.
선지별 해설
- ① 오답. 틀린 ㄱ을 포함하고 옳은 ㄷ·ㄹ을 빠뜨렸다.
- ② 오답. 틀린 ㄱ을 포함하고 옳은 ㄴ을 빠뜨렸다.
- ③ 정답. 기대 효과인 ㄴ·ㄷ·ㄹ만 포함한다.
- ④ 오답. 결합도를 높인다는 ㄱ도 옳다고 처리했다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Design 1.6 Encapsulation / Separation of interface and implementation / Coupling, PDF 86쪽; Wirfs-Brock·Wilkerson, Object-Oriented Design: A Responsibility-Driven Approach (1989) — 논문 초록의 encapsulation과 reuse·maintenance
76. 객체 지향 기법에서 클래스에 속한 각각의 객체를 의미하는 것은?
- instance
- message
- method
- module
정답과 해설 보기
정답: 1
정답은 ① instance(인스턴스)이다. 클래스는 객체가 가질 데이터와 동작의 공통 형식을 정의하고, 그 클래스로 만들어진 각각의 구체적인 객체를 인스턴스라고 부른다. 예를 들어 같은 학생 클래스로 만든 학생 A와 학생 B는 서로 다른 인스턴스이며 각자의 이름·학번 상태를 가질 수 있다.
메시지는 객체에 어떤 동작을 요청하는 관점의 표현이고, 메서드는 클래스·객체에 연결된 구체적인 동작이다. 모듈은 코드 등을 묶는 프로그램 구성 단위로 클래스의 개별 객체라는 뜻은 아니다. 클래스와 인스턴스를 구별하되, 모든 언어가 생성·메모리 배치를 동일한 방식으로 구현한다고 단정하지 않는다.
선지별 해설
- ① 정답. 클래스에 속하는 구체적인 개별 객체이다.
- ② 오답. 메시지는 동작을 요청·전달하는 개념이다.
- ③ 오답. 메서드는 객체의 동작을 구현하거나 정의하는 요소이다.
- ④ 오답. 모듈은 프로그램 구성 단위이며 개별 객체의 이름이 아니다.
편집 해설 근거: Python 3 공식 자습서, 9 Classes — 9.3.2 Class Objects; 9.3.3 Instance Objects; 9.3.4 Method Objects
77. 자료흐름도의 구성요소가 아닌 것은?
- 소단위명세서
- 단말
- 프로세스
- 자료저장소
정답과 해설 보기
정답: 1
정답은 ① 소단위명세서이다. 전통적인 자료흐름도(DFD)는 프로세스, 자료흐름, 자료저장소, 외부 개체(단말)를 기본 요소로 사용한다. 프로세스는 자료를 변환하는 처리, 흐름은 자료의 이동, 저장소는 보관, 단말은 모델 범위 밖의 송수신 주체이다.
소단위명세서는 최하위 프로세스가 구체적으로 어떤 처리를 하는지 글·의사코드·결정표 등으로 자세히 적는 보조 명세이다. DFD의 프로세스를 설명하는 데 쓰일 수 있지만 도형의 기본 요소 자체는 아니다. DFD는 데이터가 어디서 와서 어떻게 변환·저장되는지를 나타내므로 프로그램의 명령 실행 순서를 그리는 흐름도와도 구별한다.
선지별 해설
- ① 정답. 처리 내용을 상세히 설명하는 보조 명세이며 기본 도형 요소가 아니다.
- ② 오답. 단말은 자료를 보내거나 받는 외부 개체이다.
- ③ 오답. 프로세스는 자료를 변환하는 처리 요소이다.
- ④ 오답. 자료저장소는 자료의 보관 위치를 나타내는 기본 요소이다.
편집 해설 근거: Microsoft, Threat Modeling for Drivers: Create a data flow diagram — Create a data flow diagram의 기본 symbols 설명; IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Design, Behavioral Descriptions의 DFD 설명, PDF 91~92쪽
78. 블랙박스 테스트의 종류 중 프로그램의 입력 조건에 중점을 두고, 어느 하나의 입력 조건에 대하여 타당한 값과 그렇지 못한 값을 설정하여 해당 입력 자료에 맞는 결과가 출력되는 확인하는 테스트 기법은?
- Equivalence Partitioning Testing
- Boundary Value Analysis
- Comparison Testing
- Cause-Effect Graphic Testing
정답과 해설 보기
정답: 1
정답은 ① Equivalence Partitioning Testing(동치 분할 검사)이다. 입력 값을 비슷하게 처리될 것으로 기대하는 그룹으로 나눈 뒤 각 그룹을 대표하는 값을 선택하여 시험하는 방법이다. 유효한 값의 그룹과 거부해야 할 값의 그룹을 함께 고려한다.
예를 들어 허용 정수 범위가 1~100이면 1 미만, 1~100, 100 초과로 나누고 각각 대표 값을 시험할 수 있다. 경계값 분석은 그 경계 부근인 0·1·100·101 등에 특히 집중하는 방법으로 구별한다. 비교 검사는 다른 구현·버전의 결과를 대조하고, 원인-결과 그래프는 조건 조합과 결과 사이의 논리 관계를 모델링한다. 대표값 하나의 성공이 그룹의 모든 구현 오류가 없음을 증명하는 것은 아니다.
선지별 해설
- ① 정답. 동일하게 처리될 것으로 기대하는 유효·무효 입력 그룹을 나눈다.
- ② 오답. 범위의 끝과 바로 주변 값에 집중하는 경계값 분석이다.
- ③ 오답. 다른 구현·버전의 결과를 비교하는 관점이다.
- ④ 오답. 여러 조건과 결과의 논리 관계를 모델링하는 기법이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — 4.2.1 Equivalence Partitioning 및 4.2.2 Boundary Value Analysis, 57~58쪽
79. 소프트웨어 위기를 해결하기 위해 개발의 생산성이 아닌 유지보수의 생산성으로 해결하는 방법을 의미하는 것은?
- 소프트웨어 재사용
- 소프트웨어 재공학
- 클라이언트/서버 소프트웨어 공학
- 전통적 소프트웨어 공학
정답과 해설 보기
정답: 2
정답은 ② 소프트웨어 재공학이다. 지문은 기존 시스템을 이해하고 고쳐 유지보수 작업을 쉽게 만드는 관점에 초점을 둔다. 재공학은 기존 소프트웨어를 분석하여 구조·표현·구현을 새로운 형태로 재구성하는 활동이며, 불명확한 구조나 오래된 기술을 정리하는 데 사용할 수 있다.
재사용은 기존 자산을 다른 개발·기능에서 다시 활용하는 관점이고, 클라이언트/서버는 역할을 나누는 시스템 구성 방식이다. 전통적 소프트웨어공학은 새 개발과 유지보수를 모두 포괄하는 넓은 표현이다. 재공학을 언제나 기능 추가나 성능 향상을 반드시 수반하는 것으로 외우지 않는다. 동작을 유지한 채 구조만 개선하는 리팩터링도 관련 기법이며, 실제 재공학은 노후 시스템 대체 등 다른 목적에도 쓰인다.
선지별 해설
- ① 오답. 재사용은 기존 자산을 다시 쓰는 관점이며 지문의 기존 시스템 개선을 직접 가리키는 말은 아니다.
- ② 정답. 기존 시스템을 분석·재구성하여 유지보수 개선 등에 사용하는 접근이다.
- ③ 오답. 클라이언트/서버는 시스템 역할 구성 방식이다.
- ④ 오답. 전체 공학 활동을 포괄하는 넓은 말이며 특정한 기존 시스템 재구성 기법을 뜻하지 않는다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a (확인본) — Software Maintenance 4.2 Software Reengineering, PDF 179쪽
80. FTR의 검토 지침으로 거리가 먼 것은?
- 제품의 검토에만 집중하도록 한다.
- 논쟁과 반박을 제한해야 한다.
- 문제 영역을 명확히 표현해야 한다.
- 의제를 제한해서는 안 된다.
정답과 해설 보기
정답: 4
정답은 ④ 의제를 제한해서는 안 된다이다. 정형 기술 검토(FTR)는 검토할 산출물과 목표·범위를 미리 정하고, 준비된 근거에 따라 결함이나 개선점을 찾는 활동이다. 범위를 무한히 넓히면 준비가 어려워지고 제한된 시간에 핵심 문제를 검토하기 어렵다.
검토 대상은 사람의 능력이 아니라 제품·산출물이며, 발견한 문제는 재현·이해할 수 있도록 명확히 기록한다. ②의 논쟁·반박 제한은 소모적인 말싸움을 줄이고 회의를 진행하라는 취지이지, 기술적인 이견이나 근거 있는 반례를 금지하라는 뜻이 아니다. 해결 방안의 긴 설계 토론은 필요하면 별도로 다루어 검토 목적을 유지한다.
선지별 해설
- ① 오답. 작성자에 대한 인신 평가보다 산출물의 품질에 집중해야 한다.
- ② 오답. 소모적인 논쟁을 제한하는 진행 원칙이다. 근거 있는 이견은 검토에 필요하다.
- ③ 오답. 문제를 명확히 표현해야 검토 결과를 이해하고 조치할 수 있다.
- ④ 정답. 검토 목표·범위·의제를 정해 집중해야 하므로 무제한 의제는 부적절하다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — 3.2.1 Work Product Review Process; 3.2.5 Success Factors for Reviews, 48~54쪽
정보처리기사 필기 기출문제 · 데이터 통신
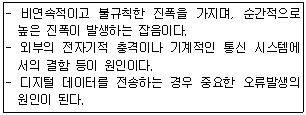
81. 다음은 데이터 통신 시스템에서 발생하는 잡음에 대한 설명이다. 어떤 잡음에 대한 설명인가?
- 열잡음
- 누화잡음
- 충격잡음
- 상호변조 잡음
정답과 해설 보기
정답: 3
정답은 ③ 충격잡음(Impulse Noise)이다. 그림의 핵심은 짧은 시간에 큰 진폭으로 나타나는 불규칙한 잡음이라는 점이다. 전기 접점의 순간적인 불안정이나 낙뢰처럼 갑작스러운 현상으로 생길 수 있으며, 여러 비트의 판독을 한꺼번에 방해할 수도 있다.
열잡음은 도체 내부 전하의 열적 운동과 관련되고, 누화는 다른 통신 회선의 신호가 섞여 들어오는 현상이다. 상호변조 잡음은 비선형 특성 때문에 여러 신호의 주파수 조합 성분이 생기는 현상이다. 문제에서는 잡음이 크다는 단서만 보지 말고 불연속적·불규칙적·순간적이라는 시간 특성을 함께 읽어야 한다.
선지별 해설
- ① 오답. 열적 운동에서 비롯되는 잡음이다.
- ② 오답. 다른 회선의 신호가 유입되는 간섭이다.
- ③ 정답. 짧고 불규칙한 큰 잡음 펄스라는 조건에 해당한다.
- ④ 오답. 비선형성에 의해 주파수 조합 성분이 생기는 현상이다.
편집 해설 근거: IIT Kharagpur NPTEL, Data Communication Fundamentals, Version 2 — 2.3.4 Noise의 네 잡음 분류
82. 피기백(Piggyback) 응답이란 무엇인가?
- 송신측이 대기시간을 설정하기 위한 목적으로 보낸 테스터 프레임용 응답을 말한다.
- 송신측이 일정한 시간 안에 수신측으로부터 ACK가 없으면 오류로 간주하는 것이다.
- 수신측이 별도의 ACK를 보내지 않고 상대편으로 향하는 데이터 전문을 이용하여 응답하는 것이다.
- 수신측이 오류를 검출한 후 재전송을 위한 프레임 번호를 알려주는 응답이다.
정답과 해설 보기
정답: 3
정답은 ③이다. 양방향 통신에서 받은 데이터에 대한 확인 응답(ACK)을 반대 방향으로 보낼 데이터에 함께 실어 보내는 것이 피기백이다. 별도의 확인 응답 전송을 줄일 수 있다는 것이 핵심이다. 예를 들어 A의 자료를 받은 B가 A에게 보낼 자료를 갖고 있다면, 그 자료와 함께 수신 확인을 전달할 수 있다.
피기백은 응답을 데이터에 결합하는 방법이다. 시간 초과로 재전송 여부를 판단하는 방식이나 오류 프레임 번호를 알리는 부정 응답과는 다르다. 반대 방향의 데이터가 오지 않는다고 확인 응답을 무한정 미룰 수는 없다. 허용된 대기 조건을 넘으면 별도로 응답해야 하며, 구체적인 시간 제한은 사용 프로토콜에 따른다.
선지별 해설
- ① 오답. 시험용 프레임의 대기시간 측정이라는 정의가 아니다.
- ② 오답. 응답이 없을 때의 시간 초과 판단이다.
- ③ 정답. 역방향 데이터에 확인 응답을 함께 담는다.
- ④ 오답. 오류와 재전송 위치를 알리는 부정 응답의 설명이다.
편집 해설 근거: IETF RFC 1122 (1989), Requirements for Internet Hosts — 4.2.3.2 When to Send an ACK Segment, Discussion
83. 자동재전송요청(ARQ)기법 중 데이터 프레임을 연속적으로 전송해 나가다가 NAK를 수신하게 되면, 오류가 발생한 프레임 이후에 전송된 모든 데이터 프레임을 재전송하는 것은?
- Selective-Repeat
- stop and wait
- Go-back-N
- Turbo Code
정답과 해설 보기
정답: 3
정답은 ③ Go-back-N이다. 여러 프레임을 연속으로 전송하던 중 오류를 알게 되면 문제가 된 프레임부터 그 뒤에 보낸 미확인 프레임들을 다시 보낸다. 예를 들어 2번이 손상된 뒤 3·4번까지 보냈다면 2번부터 다시 전송하는 방식이다. 이때 수신 측이 정상 순서로 받아들이지 못한 뒤쪽 프레임도 재전송 대상이 될 수 있다.
Selective Repeat는 필요한 프레임을 골라 재전송하고, Stop-and-Wait는 하나를 보낸 후 응답을 기다리는 구조이다. Turbo Code는 수신 오류를 정정하기 위해 중복 정보를 넣는 오류 정정 부호이므로 ARQ 재전송 절차의 이름이 아니다. Go-back-N의 재전송은 구현에 따라 부정 응답이나 시간 초과 등으로 시작될 수 있다.
선지별 해설
- ① 오답. 필요한 프레임을 선택해 재전송하는 방식이다.
- ② 오답. 한 프레임 전송 후 응답을 기다린다.
- ③ 정답. 오류 지점으로 되돌아가 뒤쪽 미확인 프레임도 다시 보낸다.
- ④ 오답. 재전송 절차가 아닌 오류 정정 부호이다.
편집 해설 근거: California State University Sacramento, Go-Back-N ARQ — 본문의 NACK 수신 후 retransmit 설명; IETF RFC 3366 (2002), Advice to Link Designers on Link ARQ — 1.4 Commonly-used ARQ Techniques
84. 다음이 설명하고 있는 디지털 전송 신호 부호화 방식은?
[학습용 개정문항]
매 비트의 중앙에서 신호가 전이한다. IEEE 802.3 규약에 따라 비트 1은 낮은 전압에서 높은 전압으로, 비트 0은 높은 전압에서 낮은 전압으로 전이한다. 수신기는 이 전이를 비트 타이밍 복원에 이용한다.
- Alternating Mark Inversion 코드
- Manchester 코드
- Bipolar 코드
- Non Return to Zero 코드
정답과 해설 보기
정답: 2
정답은 ② Manchester 코드이다. 모든 비트의 중앙에서 신호가 전이하므로 수신기가 그 전이를 시간 기준으로 삼을 수 있다. 이 개정문항에서 지정한 IEEE 802.3 규약은 1을 낮음→높음, 0을 높음→낮음으로 표현한다. 같은 이름의 맨체스터 부호라도 규약에 따라 0·1에 대응하는 전이 방향은 반대일 수 있어 규약을 함께 확인해야 한다.
AMI는 보통 0을 영 전압으로, 연속되는 1을 양·음 전압으로 번갈아 나타내는 방식이다. NRZ는 비트 중앙의 전이가 항상 보장되는 방식이 아니다. ‘Bipolar’라는 넓은 분류만으로는 지문의 중앙 전이 규칙을 특정할 수 없다. 원래 이미지가 제시한 전이 방향과 이더넷의 규약을 혼동하지 않도록 이미지 조건을 명시적 글로 교체했다.
선지별 해설
- ① 오답. AMI는 1의 극성을 교대로 사용하는 방식이다.
- ② 정답. 비트 중앙의 전이가 필수이며 지정한 규약의 전이 방향과 일치한다.
- ③ 오답. 양·음 극성 사용이라는 분류만으로 중앙 전이 부호를 뜻하지 않는다.
- ④ 오답. NRZ는 매 비트 중앙의 전이를 요구하지 않는다.
편집 해설 근거: Microchip AN2371, 2.2 IEEE 802.3 Convention — 2.2 IEEE 802.3 Convention
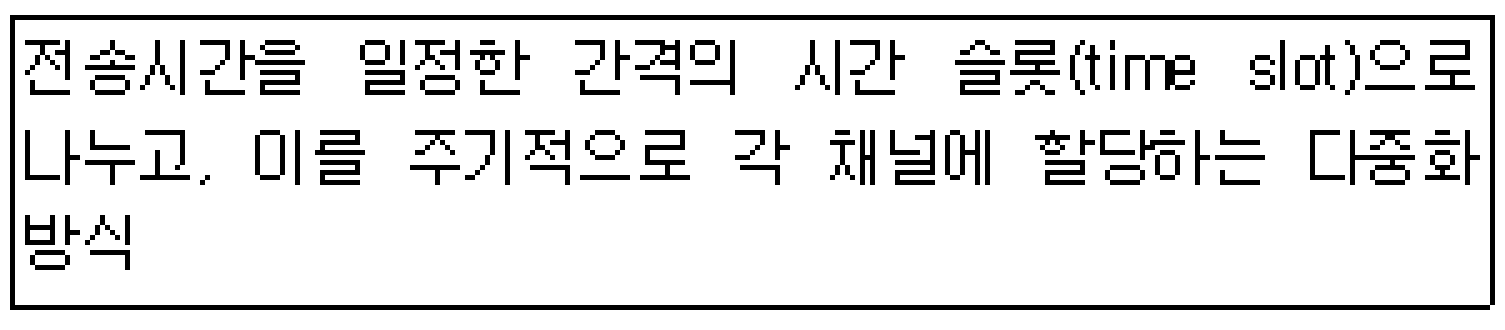
85. 다음이 설명하고 있는 다중화 방식은?
- 주파수 분할 다중화
- 동기식 시분할 다중화
- 코드 분할 다중화
- 파장 분할 다중화
정답과 해설 보기
정답: 2
정답은 ② 동기식 시분할 다중화이다. 한 전송로의 시간을 반복되는 프레임과 슬롯으로 나누고 각 입력에 정해진 슬롯을 주기적으로 배정한다. 예를 들어 A·B·C가 한 슬롯씩 쓰면 A→B→C 순서의 프레임을 반복하는 식이다. 특정 입력이 보낼 자료가 없어도 그 입력에 예약한 슬롯은 남을 수 있다.
여기서 동기식이라는 말은 슬롯이 입력에 미리 배정되어 반복된다는 뜻에 초점을 둔다. 필요할 때 슬롯을 동적으로 배정하는 통계적 시분할 다중화와 구별한다. FDM은 주파수 대역, CDM은 코드, WDM은 광 신호의 파장으로 채널을 나눈다. 지문처럼 고정된 시간 간격을 차례로 배정하는 것은 주파수나 파장을 나누는 방식이 아니다.
선지별 해설
- ① 오답. 서로 다른 주파수 대역을 나누어 사용한다.
- ② 정답. 입력별 시간 슬롯을 고정적으로 반복 배정한다.
- ③ 오답. 코드로 채널을 구분한다.
- ④ 오답. 광 신호의 서로 다른 파장을 이용한다.
편집 해설 근거: IIT Kharagpur NPTEL, Multiplexing, Version 2 — 2.7.4 Synchronous Time-division Multiplexing, PDF 8~9쪽
86. 다음 중 A, B, C, D 문자 전송 시 수직 짝수 패리티 비트 검사에서 패리티 비트 값이 옳은 문자는?
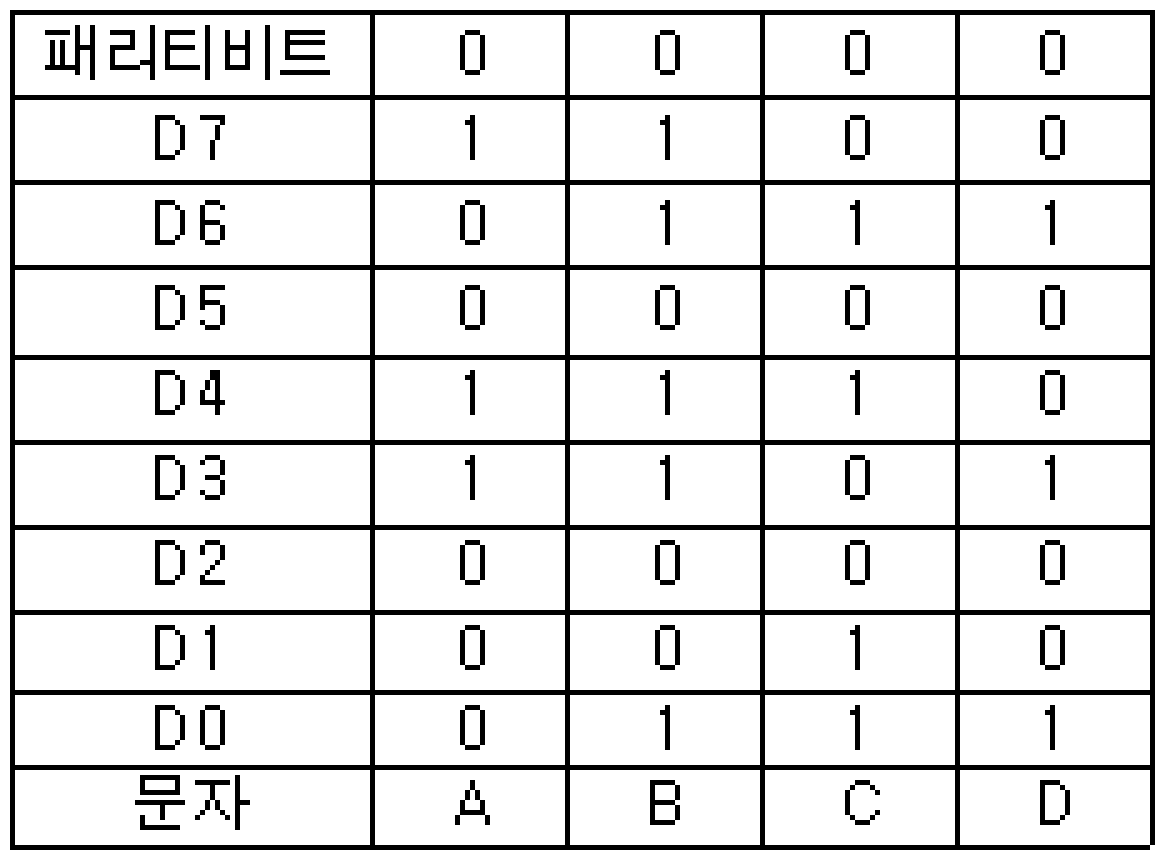
- A
- B
- C
- D
정답과 해설 보기
정답: 3
정답은 ③ C이다. 짝수 패리티는 데이터 비트와 패리티 비트를 합쳐 1의 개수가 짝수가 되도록 정하는 규칙이다. 그림의 데이터 비트에서 1을 세면 A는 3개, B는 5개, C는 4개, D는 3개이다. 따라서 필요한 패리티 비트는 A=1, B=1, C=0, D=1이다.
그림은 네 문자의 패리티 비트를 모두 0으로 표시했다. 그중 데이터에 이미 1이 4개 있어 0을 더해도 짝수를 유지하는 C만 옳다. 기존 해설에서 C의 1 개수를 서로 다르게 설명한 부분을 고쳤다. 패리티는 오류 검출 규칙이며, 검사 결과가 맞는다고 모든 비트가 정확하다는 보장은 없다. 짝수 개의 비트가 바뀌는 오류는 이 검사로 검출하지 못할 수 있다.
선지별 해설
- ① 오답. 1이 3개이므로 짝수를 만들려면 패리티 비트 1이 필요하다.
- ② 오답. 1이 5개이므로 패리티 비트 1이 필요하다.
- ③ 정답. 1이 4개이므로 표시된 패리티 비트 0이 옳다.
- ④ 오답. 1이 3개이므로 패리티 비트 1이 필요하다.
편집 해설 근거: Texas Instruments, DRV8316 parity bit 기술지원 답변 — TI 기술지원 답변의 even parity 계산 및 검출 한계
87. HDLC 프레임 형식 중 프레임의 종류를 식별하기 위해 사용 되는 것은?
- 정보영역
- 제어영역
- 주소영역
- 플래그
정답과 해설 보기
정답: 2
정답은 ② 제어영역이다. HDLC의 제어 필드는 프레임이 데이터 전달용 I 프레임인지, 감독용 S 프레임인지, 비번호 U 프레임인지 구분하고 각 형식의 제어 정보를 담는다. 따라서 프레임 종류를 묻는 질문에서는 제어 필드를 찾아야 한다.
정보영역은 전달할 내용, 주소영역은 관련 통신국의 주소, 플래그는 프레임의 경계를 나타내는 역할이다. 경계를 표시하는 플래그와 종류를 나타내는 제어 필드를 혼동하지 않는다. 프레임마다 모든 제어 정보나 정보영역이 똑같이 들어가는 것은 아니며, 필드의 세부 형식은 프레임 종류와 운용 모드에 따라 달라진다.
선지별 해설
- ① 오답. 프레임이 운반하는 정보가 놓이는 영역이다.
- ② 정답. I·S·U 등의 프레임 형식과 제어 의미를 구분한다.
- ③ 오답. 통신국 주소를 나타내는 영역이다.
- ④ 오답. 프레임의 시작·끝 경계를 표시한다.
편집 해설 근거: IIT Kharagpur NPTEL, High-Level Data Link Control, Version 2 — 3.4.5 Frame Structure의 The Control field, PDF 9~10쪽
88. 점-대-점 링크뿐만 아니라 멀티 포인트 링크를 위하여 ISO에서 개발한 국제 표준 프로토콜은?
- HDLC(High Level Data Link Control)
- BSC(Binary Synchronous Control)
- SWFC(Sliding Window Flow Control)
- LLC(Logic Link Control)
정답과 해설 보기
정답: 1
정답은 ① HDLC이다. HDLC는 ISO가 표준화한 비트 지향 데이터링크 제어 절차이며, 두 장치 사이의 점대점 구성뿐 아니라 한 주국과 여러 종국 같은 다중점 구성도 다룬다. 지문의 ISO 표준화·점대점·다중점이라는 단서를 함께 대조하면 HDLC를 고를 수 있다.
BSC는 문자 지향 통신 제어 방식으로 구별한다. 슬라이딩 윈도는 전송할 수 있는 미확인 데이터 범위를 관리하는 흐름 제어 원리로, 그 자체가 지문이 말하는 국제 표준 프로토콜의 이름은 아니다. LLC는 근거리 통신망의 논리 링크 제어 기능을 가리킨다. ‘비트 지향’은 제어 정보를 비트 패턴으로 다룬다는 뜻이며 데이터가 문자일 수 없다는 뜻은 아니다.
선지별 해설
- ① 정답. ISO의 비트 지향 데이터링크 제어 절차로 해당 구성을 지원한다.
- ② 오답. 문자 지향의 Binary Synchronous Communication 계열이다.
- ③ 오답. 슬라이딩 윈도 흐름 제어 기법을 가리키는 보기이다.
- ④ 오답. LAN의 논리 링크 제어 기능을 뜻한다.
편집 해설 근거: IIT Kharagpur NPTEL, High-Level Data Link Control, Version 2 — 3.4.1 Introduction; 3.4.2 Stations and Configurations
89. 과거 IPv4의 클래스 기반 주소 분류에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 5개의 클래스(A, B, C, D, E)로 분류되어 있다.
- A, B, C 클래스만이 네트워크 주소와 호스트 주소 체계의 구조를 가진다.
- D 클래스 주소는 멀티캐스팅(multicasting)을 사용하기 위해 예약되어 있다.
- E 클래스는 실험적 주소로 공용으로 사용된다.
정답과 해설 보기
정답: 4
정답은 ④이다. 이 문항은 IPv4의 과거 클래스 기반 주소 분류를 묻는다. 그 체계에서 A·B·C는 네트워크 부분과 호스트 부분을 나누는 일반 주소 분류이고, D는 멀티캐스트 그룹 주소이다. E는 미래 용도 등을 위해 예약한 범위로 취급했으므로 일반적인 공용 호스트 주소처럼 배정하여 쓴다는 설명은 틀리다.
이 분류를 현재의 모든 IP 주소 운영 원칙으로 확대하면 안 된다. 오늘날 IPv4의 네트워크 경계는 CIDR 접두사 길이로 표현하며, IPv6도 별도의 주소 체계를 사용한다. E 범위의 특정 주소에 대한 예외적 의미나 구현별 수용 가능성과, 당시 클래스 분류에서 일반 공용 주소라는 주장은 서로 다른 문제이다.
선지별 해설
- ① 오답. 문항이 지정한 과거 IPv4 분류에는 A~E가 있다.
- ② 오답. 그 분류에서 A·B·C는 네트워크·호스트 부분을 갖는 일반 주소 형식이다.
- ③ 오답. D는 멀티캐스트 그룹을 위한 주소이다.
- ④ 정답. E를 일반 공용 호스트 주소로 사용한다는 설명이 틀리다.
편집 해설 근거: IETF RFC 791 (1981), Internet Protocol — 3.2 Discussion의 Addressing; IETF RFC 1112 (1989), Host extensions for IP multicasting — 4 Host Group Addresses
90. 양자화 잡음에 대한 설명으로 맞는 것은?
[학습용 개정문항]
- 양자화하기 전의 입력 표본값 그 자체
- 양자화 후 선택된 대표값 그 자체
- 입력 표본값과 양자화 대표값의 합
- 입력 표본값과 양자화 대표값의 차이
정답과 해설 보기
정답: 4
정답은 ④ 표본값과 양자화 대표값의 차이이다. 양자화는 연속적인 진폭의 표본을 정해진 단계 중 하나로 대응시키는 과정이다. 원래 표본이 그 단계의 대표값과 꼭 일치하지 않으면 차이가 생기며 이것이 양자화 오차이다. 예를 들어 1.24 V를 1.2 V로 나타내면 차이의 크기는 0.04 V이다.
이 차이를 신호에 추가되는 성분으로 분석할 때 양자화 잡음이라고 부른다. 비교하는 두 값은 같은 물리 단위의 입력 진폭과 대표 진폭이어야 한다. 전압에서 비트 문자열 자체를 빼는 계산이 아니다. 표본화는 시간축을 나누고, 양자화는 진폭을 나누며, 부호화는 그 단계에 비트 표현을 부여한다는 차이를 구별한다.
선지별 해설
- ① 오답. 입력 표본 자체는 오차가 아니다.
- ② 오답. 선택된 대표값 자체도 오차가 아니다.
- ③ 오답. 두 값의 합은 입력을 얼마나 다르게 표현했는지를 나타내지 않는다.
- ④ 정답. 원래 표본값과 그에 대응시킨 대표값의 차이가 양자화 오차이다.
편집 해설 근거: Analog Devices, Chapter 20: Analog to Digital Conversion — ADC Resolution / Figure 20.4 Quantization Process
91. 아날로그 데이터를 디지털신호로 변환하는 변조방식은?
- ASK
- PSK
- PCM
- FSK
정답과 해설 보기
정답: 3
정답은 ③ PCM(Pulse Code Modulation, 펄스 부호 변조)이다. 음성과 같은 아날로그 신호를 일정한 시점마다 표본화하고, 표본 진폭을 제한된 단계로 양자화한 뒤 그 단계를 디지털 코드로 표현한다. 이 과정을 통해 아날로그 정보를 저장·처리·전송할 수 있는 디지털 데이터로 만든다.
ASK·PSK·FSK는 주어진 디지털 정보를 반송파의 진폭·위상·주파수 변화로 실어 보내는 변조 방식이다. 따라서 정보의 아날로그→디지털 변환과, 이미 있는 디지털 데이터를 물리 매체로 전달할 파형에 대응시키는 작업을 구별해야 한다. PCM으로 만든 디지털 데이터를 이후 다른 변조 방식으로 전송할 수도 있으므로 서로 배타적인 전체 통신 시스템 이름은 아니다.
선지별 해설
- ① 오답. 디지털 정보를 반송파 진폭 변화에 대응시킨다.
- ② 오답. 반송파 위상 변화에 대응시킨다.
- ③ 정답. 표본화·양자화·부호화로 아날로그 정보를 디지털 코드로 만든다.
- ④ 오답. 반송파 주파수 변화에 대응시킨다.
편집 해설 근거: Texas Instruments SPMA084 (2021), Digital Audio Playback on TM4C12x MCUs — 1 Introduction, PDF 2쪽
92. 각 노드가 수신한 패킷을 들어온 링크를 제외한 다른 모든 전송 가능한 링크로 복사해 보내는 기본 경로 전파 방식은?
[학습용 개정문항]
- 고정 경로 지정
- 플러딩
- 임의 경로 지정
- 적응 경로 지정
정답과 해설 보기
정답: 2
정답은 ② 플러딩이다. 노드가 받은 패킷을 들어온 링크를 제외한 나머지 전송 가능한 링크로 복제하여 보내는 기본 방식이다. 하나의 다음 경로만 고르는 대신 여러 방향으로 퍼뜨린다는 점이 판단 기준이다. 네트워크 전체에 정보를 알릴 때 활용할 수 있지만 복사본이 많아지는 비용이 따른다.
순환 경로가 있으면 같은 정보가 계속 돌아다닐 수 있으므로 실제 구현에서는 일련번호·중복 기록·홉 수 같은 제한을 사용한다. 고정 경로 지정은 미리 정한 경로를, 임의 경로 지정은 임의로 고른 경로를 사용한다. 적응 경로 지정은 네트워크 상태 변화에 따라 경로를 조정한다. 기존 문장의 ‘자신을 제외’는 노드 자체보다 수신한 링크를 제외한다는 뜻으로 명확히 했다.
선지별 해설
- ① 오답. 미리 정한 경로를 사용한다.
- ② 정답. 여러 링크로 패킷 복사본을 퍼뜨린다.
- ③ 오답. 다음 경로를 임의로 선택하는 방식이다.
- ④ 오답. 상태에 맞추어 경로를 조정하는 방식이다.
편집 해설 근거: Princeton COS 461 (Spring 2023), Link State Routing — Building a Map: Flooding Protocol I·II, 슬라이드 5~6
93. 각 입력 채널에 주파수 대역을 고정 배정하는 전통적인 비중첩 FDM의 설명으로 틀린 것은?
[학습용 개정문항]
- 여러 입력의 신호를 서로 다른 주파수 대역으로 동시에 전송한다.
- 인접채널 사이의 간섭을 줄이기 위해 보호대역을 둔다.
- 고정된 배정 설정을 바꾸지 않아도 입력 수에 따라 대역이 자동으로 동적 재배정된다.
- 유선방송의 여러 채널을 주파수별로 나누는 데 활용할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 이 문항의 조건은 각 입력 채널에 주파수 대역을 고정 배정하는 전통적인 FDM이다. 여러 입력의 신호는 서로 다른 대역을 동시에 사용하며, 일반적인 비중첩 방식은 인접 채널의 간섭을 줄이기 위해 보호대역을 둔다. 고정 배정이라는 조건에서 입력 수에 맞추어 대역이 자동으로 재배정된다는 ③은 맞지 않는다.
주파수 분할이라는 원리 자체가 동적 할당을 절대로 허용하지 않는 것은 아니다. 실제 다중접속에는 필요에 따라 주파수 채널을 배정하는 방식도 있다. 또한 디지털 정보를 변조한 신호도 서로 다른 주파수 대역에 실을 수 있다. 따라서 FDM은 아날로그 정보에만 쓸 수 있다거나 항상 고정 사용자 수만 가능하다고 일반화하면 안 된다.
선지별 해설
- ① 오답. 서로 다른 대역을 사용하는 신호를 동시에 전송할 수 있다.
- ② 오답. 지정한 비중첩 FDM에서는 인접 대역의 간섭을 줄이려 보호대역을 둔다.
- ③ 정답. 고정 배정 조건인데 별도 변경 없이 자동으로 동적 재배정된다고 했다.
- ④ 오답. 여러 방송 채널을 주파수별로 나누는 활용이 가능하다.
편집 해설 근거: IIT Kharagpur NPTEL, Multiplexing, Version 2 — 2.7.2 Frequency-division Multiplexing; review question의 guard bands; IIT Kharagpur NPTEL, Multiple Access, Version 2 — FDMA 설명 및 Figure 5.9.4, PDF 7쪽
94. IPv4에서 IPv6로의 천이하는데 사용되는 IETF에 의해 고안한 천이 전략 3가지에 해당하지 않는 것은?
- Dual Stack
- Tunneling
- Header Translation
- IP Control
정답과 해설 보기
정답: 4
정답은 ④ IP Control이다. IPv4와 IPv6가 함께 존재하는 환경에서 대표적으로 구분하는 전환 방법은 이중 스택, 터널링, 프로토콜 변환이다. 이중 스택은 두 버전의 프로토콜을 함께 구현하고, 터널링은 한 버전의 패킷을 다른 전송용 패킷 안에 담아 나른다. 변환은 IPv4와 IPv6의 헤더·주소·관련 제어 메시지 등을 대응 규칙에 따라 바꾼다.
따라서 단순히 IP를 제어한다는 이름의 ④는 이 세 방법의 분류명이 아니다. 터널링은 원래 패킷을 감싸는 것, 헤더 변환은 서로 다른 형식 사이를 바꾸는 것이라는 차이를 기억한다. 실제 전환 기술은 세 범주를 조합하기도 하며, 최신 세부 절차가 2015년과 모두 같다는 뜻은 아니다. 아래 2016년 RFC는 변환 원리를 후속 문서로 대조한 근거이다.
선지별 해설
- ① 오답. IPv4·IPv6를 함께 구현하는 이중 스택이다.
- ② 오답. 한 버전의 패킷을 다른 패킷 안에 실어 나르는 방법이다.
- ③ 오답. 두 버전의 헤더·주소 등을 대응 규칙에 따라 변환한다.
- ④ 정답. 지문이 묻는 세 전환 방법의 분류명에 해당하지 않는다.
편집 해설 근거: IETF RFC 4213 (2005), Basic Transition Mechanisms for IPv6 Hosts and Routers — Abstract; 2 Dual IP Layer Operation; 3 Configured Tunneling; IETF RFC 7915 (2016), IP/ICMP Translation Algorithm — 1.1 IPv4-IPv6 Translation Model; 1.2 Applicability and Limitations
95. 다음이 설명하고 있는 에러 체크 방식은?
[학습용 개정문항]
HDLC 계열 프레임에서 정해진 생성 다항식으로 FCS를 계산하는 경우를 묻는다.
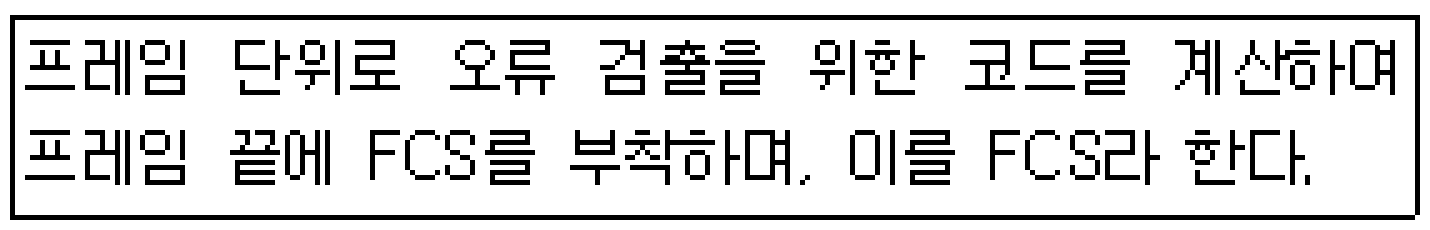
- LRC(Longitudinal Redundancy Check)
- VRC(Vertical Redundancy Check)
- CRC(Cyclic Redundancy Check)
- ARQ(Automatic Repeat Request)
정답과 해설 보기
정답: 3
정답은 ③ CRC(순환 중복 검사)이다. 추가한 조건은 HDLC 계열에서 생성 다항식으로 FCS를 계산하는 경우이다. 비트열을 다항식으로 보고 정해진 생성 다항식에 따라 검사값을 만든다. 송수신 측이 같은 규칙으로 계산한 결과를 대조해 전송 중 오류를 검출한다.
VRC는 문자별 패리티, LRC는 여러 문자에서 대응하는 비트 위치를 함께 검사하는 방식과 관련된다. ARQ는 오류나 응답 시간 초과 후 재전송을 요청·수행하는 절차이므로 검사값을 계산하는 부호 자체가 아니다. 그림의 FCS라는 이름만으로 모든 프로토콜의 계산 규칙을 CRC로 단정할 수는 없다. 따라서 학습용 조건에 적용 프로토콜과 다항식 계산을 명시했다. CRC도 모든 가능한 오류를 검출한다는 완전한 보장은 아니다.
선지별 해설
- ① 오답. 문자 블록의 대응 비트에 대한 종방향 검사이다.
- ② 오답. 문자 단위 패리티 검사이다.
- ③ 정답. 생성 다항식에 근거한 검사값을 사용하는 CRC이다.
- ④ 오답. 오류 검출 뒤 재전송하는 제어 절차이다.
편집 해설 근거: IETF RFC 1662 (1994), PPP in HDLC-like Framing — 3.1 Frame Check Sequence; Appendix C의 16-bit·32-bit FCS
96. IPv4 이더넷에서 ARP와 시간 기반으로 유효성을 관리하는 동적 ARP 캐시에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 링크에서 통신하는 장치의 IP 주소와 물리 주소 사이의 대응을 알아내는 데 사용한다.
- 같은 링크에 있는 다음 홉의 IPv4 주소에 대응하는 MAC 주소를 구한다.
- 캐시에 유효한 IP 주소·MAC 주소 대응이 있으면 그 MAC 주소를 사용할 수 있다.
- 동적 캐시 항목의 유효기간이 만료되면 그 주소 대응은 자동으로 영구 보존된다.
정답과 해설 보기
정답: 4
정답은 ④이다. IPv4 이더넷에서 ARP는 같은 링크의 다음 홉 IP 주소에 대응하는 MAC 주소를 알아내는 데 쓰인다. 캐시의 유효한 대응을 사용하면 같은 주소를 매번 다시 질의하는 일을 줄일 수 있다. 목적지가 다른 네트워크라면 최종 목적지의 MAC 주소가 아니라 다음 홉인 라우터의 MAC 주소를 알아내어 전송한다.
시간 기반으로 관리하는 동적 캐시의 유효기간이 끝났다는 사실은 주소를 영구 보존하라는 뜻이 아니다. 오래된 대응은 구현 규칙에 따라 무효화·갱신·재확인이 필요하다. ARP 패킷 자체에는 IP 헤더의 TTL 같은 필드가 없으며, 캐시의 수명과 IP 패킷의 홉 제한을 혼동하지 않아야 한다. 관리자가 별도로 지정하는 정적 항목은 동적 캐시 만료와 구별한다.
선지별 해설
- ① 오답. 링크에서 IP 주소와 물리 주소 사이의 대응을 해결한다.
- ② 오답. 같은 링크에 있는 다음 홉의 IPv4 주소에 대응하는 MAC 주소를 구한다.
- ③ 오답. 유효한 캐시 대응이 있으면 이를 사용할 수 있다.
- ④ 정답. 유효기간 만료가 자동 영구 보존을 뜻하지 않는다.
편집 해설 근거: IETF RFC 826 (1982), An Ethernet Address Resolution Protocol — Packet format; Packet Generation; IETF RFC 1122 (1989), Requirements for Internet Hosts — 2.3.2.1 ARP Cache Validation
97. 다중접속방식에 해당하지 않는 것은?
- FDMA
- QDMA
- TDMA
- CDMA
정답과 해설 보기
정답: 2
정답은 ② QDMA이다. 이 문항은 통신 채널을 여러 사용자가 나누어 쓰는 대표적인 다중접속 방식의 이름을 구별한다. FDMA는 주파수, TDMA는 시간, CDMA는 코드를 구분 기준으로 사용한다. 이 세 이름은 각각 Frequency·Time·Code Division Multiple Access의 약자이다.
QDMA는 이 문항의 기본 다중접속 분류에 속하는 표준적인 이름으로 쓰이지 않는다. 그렇다고 다른 제품이나 기술 문서에서 그 약자가 전혀 사용되지 않는다는 뜻은 아니다. 특히 제품에서 쓰는 DMA(직접 메모리 접근) 관련 이름을 통신 다중접속의 MA와 혼동하지 않는다. 약자의 뒷부분만 외우기보다 어떤 자원을 나누어 사용자를 구분하는지 함께 이해해야 한다.
선지별 해설
- ① 오답. 사용자를 주파수 대역으로 구분하는 FDMA이다.
- ② 정답. 문항의 대표적인 통신 다중접속 분류에 해당하지 않는다.
- ③ 오답. 시간 구간을 나누어 접속하는 TDMA이다.
- ④ 오답. 코드로 사용자를 구분하는 CDMA이다.
편집 해설 근거: IIT Kharagpur NPTEL, Multiple Access, Version 2 — Multiple Access의 FDMA·TDMA·CDMA 설명, PDF 7~8쪽
98. 비트 방식의 데이터링크 프로토콜이 아닌 것은?
- HDLC
- SDLC
- LAPB
- SYN
정답과 해설 보기
정답: 4
정답은 ④ SYN이다. 이 데이터링크 문맥에서 SYN은 BSC 등의 문자 지향 통신에서 동기를 맞추는 제어 문자를 가리킨다. 자체적인 비트 지향 데이터링크 프로토콜의 이름이 아니다. HDLC·SDLC·LAPB는 비트 지향 데이터링크 제어 절차 계열로 분류한다.
문자 지향 방식은 SYN 같은 특정 제어 문자로 제어 의미를 나타내고, 비트 지향 방식은 정해진 비트 필드와 패턴으로 프레임을 제어한다. SYN이라는 약자가 TCP 연결 설정 플래그에도 쓰인다는 사실은 별개이다. 이 문제를 TCP 플래그 하나로만 설명하면 데이터링크의 문자 지향·비트 지향 구분을 놓치므로 문맥에 맞는 제어 문자 의미를 먼저 확인한다.
선지별 해설
- ① 오답. HDLC는 비트 지향 데이터링크 제어 절차이다.
- ② 오답. SDLC도 비트 지향 방식이다.
- ③ 오답. LAPB도 비트 지향 링크 절차이다.
- ④ 정답. 여기서는 동기 제어 문자이며 프로토콜 이름이 아니다.
편집 해설 근거: IBM i 7.4, Change Line Description (BSC), SYN characters — SYN characters (SYNCCHARS); IIT Kharagpur NPTEL, High-Level Data Link Control, Version 2 — 3.4.1 Introduction; HDLC Subsets
99. 패킷교환에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 전송 데이터를 프로토콜의 크기 규칙에 따른 패킷 단위로 나누어 교환·전송하며, 모든 패킷 길이가 같을 필요는 없다.
- 일반적인 저장 후 전달 모델에서는 중간 노드가 패킷을 받은 뒤 다음 링크로 전달한다.
- 가상회선 패킷교환은 비연결형 서비스를 제공하고, 데이터그램 패킷교환은 연결형 서비스를 제공한다.
- 전체 메시지보다 작은 단위로 전달하여 대화형 데이터 통신의 지연을 줄이는 데 유리할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 가상회선 패킷교환은 연결을 설정하고 그 연결의 식별 정보에 따라 패킷을 전달하는 연결형 방식이다. 데이터그램은 각 패킷의 목적지 정보로 독립적인 전달 결정을 하는 비연결형 방식이다. ③은 두 성격을 반대로 적었다.
패킷교환은 데이터를 작은 단위로 나누므로, 메시지 전체가 도착하기를 기다려 다음 구간으로 넘기는 방식보다 전송 단위를 작게 다룰 수 있다. 일반적인 저장 후 전달 모델에서는 노드가 패킷을 받아 다음 링크로 보낸다. 다만 모든 패킷 길이가 항상 같다는 것은 아니다. IP에는 패킷별 길이 필드가 있고 서로 다른 길이가 가능하다. 고정 길이 셀을 쓰는 방식과 패킷교환 전체를 동일시하지 않도록 ①도 수정했다.
선지별 해설
- ① 오답. 프로토콜의 크기 규칙에 따른 단위로 나누며 길이가 항상 같은 것은 아니다.
- ② 오답. 일반적인 저장 후 전달 모델에 대한 옳은 설명이다.
- ③ 정답. 가상회선은 연결형, 데이터그램은 비연결형이므로 서로 뒤바뀌었다.
- ④ 오답. 메시지보다 작은 단위로 전달하므로 대화형 전송에 유리할 수 있다.
편집 해설 근거: Monmouth University CS 414/514 (2013), The Network Layer — Connectionless Behavior; Virtual-Circuit Networks; IETF RFC 791 (1981), Internet Protocol — 3.1 Internet Header Format, Total Length 및 3.2의 예시
100. OSI 7계층 중 응용 프로세스 간에 데이터 표현상의 차이에 상관없이 통신이 가능하도록 독립성을 제공(코드변환, 데이터 압축 등)하는 계층은?
- 물리계층
- 표현계층
- 데이터 링크계층
- 세션계층
정답과 해설 보기
정답: 2
정답은 ② 표현계층이다. OSI 참조모델에서 표현계층은 응용 개체 사이에 정보를 어떤 형식으로 표현하여 교환할지 다룬다. 서로 다른 내부 표현을 쓰더라도 합의한 전송 구문에 맞추어 변환하면 상대가 해석할 수 있다. 코드나 자료 형식 변환, 필요한 경우의 압축 같은 작업이 이 관점에 속한다.
물리계층은 매체에서 비트를 신호로 전달하는 기능, 데이터링크계층은 인접한 통신 지점 사이의 프레임 전달 기능, 세션계층은 대화·동기 관리 기능과 관련된다. 실제 인터넷 프로그램이 OSI의 각 계층을 독립된 모듈로 하나씩 구현해야 한다는 뜻은 아니다. 문항은 구현 위치를 단정하는 질문이 아니라 참조모델에서 데이터 표현 기능을 맡은 계층을 묻는다.
선지별 해설
- ① 오답. 물리 매체에서의 비트·신호 전달을 다룬다.
- ② 정답. 데이터 표현과 전송 구문, 필요한 변환을 다룬다.
- ③ 오답. 링크의 프레임 전달을 다룬다.
- ④ 오답. 통신 대화와 동기 관리 기능을 다룬다.
편집 해설 근거: ITU-T Recommendation X.200 (07/1994), OSI Basic Reference Model — 7.2.2 Purpose; 7.2.4 Functions within the Presentation Layer
정보처리기사 필기 기출문제 학습 방법
먼저 PDF 문제지를 시간에 맞춰 푼 뒤, 이 글에서 오답의 정답·해설·근거를 확인하세요. 법규 문항은 근거 기준일 이후 개정 여부도 함께 확인하는 것이 안전합니다.