
문제지 PDF · 웹 정답 해설
정보처리기사 필기 2022년 2회 공개기출 100문항
정보처리기사 필기 2022년 2회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.

© 자격증3001. 이 정보처리기사 필기 기출문제 게시물의 문제 재구성 문장, 해설, 재작성 도식, 편집 및 PDF 디자인은 자격증3001의 저작권 보호를 받습니다. 국가기술자격 시험 및 관련 명칭의 권리는 해당 기관에 있으며, 본 자료는 Q-Net 공식 문제지 또는 공식 해설이 아닙니다. 무단 복제·재배포를 금합니다.
정보처리기사 필기 2022년 2회 공개기출 100문항 안내
정보처리기사 필기 2022년 2회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.
이 회차의 100문항 해설을 문항별 기술 원문과 필요한 독립 계산으로 편집 검토했습니다. 질문·조건·보기를 고친 문항은 학습용 개정문항으로 표시합니다. 원 시험의 공식 원문이나 공식 정답표를 새로 확인한 자료는 아닙니다.
정보처리기사 필기 기출문제 · 소프트웨어 설계
1. UML 다이어그램 중 순차 다이어그램에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 객체 간의 동적 상호작용을 시간 개념을 중심으로 모델링하는 것이다.
- 주로 시스템의 정적 측면을 모델링하기 위해 사용한다.
- 일반적으로 다이어그램의 수직 방향이 시간의 흐름을 나타낸다.
- 자기 자신에게 보내는 메시지와 조건·반복을 표현하는 결합 조각을 사용할 수 있다.
정답과 해설 보기
정답: 2
정답은 ②이다. 시퀀스 다이어그램은 생명선 사이에서 메시지가 어떤 순서로 오가는지를 나타내는 상호작용 다이어그램이다. 보통 위에서 아래로 진행을 읽지만 서로 무관한 생명선의 모든 사건에 절대적인 전체 시간 순서가 생기는 것은 아니다. 자기 자신에게 보내는 메시지와 조건·반복 등을 표현하는 결합 조각도 사용할 수 있다. 클래스의 속성이나 관계 같은 정적 구조를 주로 나타내는 다이어그램과 구별한다.
선지별 해설
- 메시지와 실행을 통해 참여자 사이의 동적 상호작용을 나타낸다.
- 정적 구조보다 상호작용의 순서가 주된 관심사이다.
- 보통 생명선을 따라 위에서 아래로 사건의 진행을 읽는다.
- 자기 호출과 조건·반복을 표현하는 결합 조각을 사용할 수 있다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §17 Interactions — Lifeline, Message, CombinedFragment
2. 메시지 지향 미들웨어(Message-Oriented Middleware, MOM)에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 송신자는 수신자의 메시지 처리 완료까지 반드시 동기적으로 기다려야 한다.
- 독립적인 애플리케이션을 하나의 통합된 시스템으로 묶기 위한 역할을 한다.
- 송신측과 수신측의 연결 시 메시지 큐를 활용하는 방법이 있다.
- 상이한 애플리케이션 간 통신을 비동기 방식으로 지원한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 메시지 지향 미들웨어는 응용 사이에서 메시지를 전달하며 송신과 수신의 실행 시점을 분리하는 비동기 통신을 지원한다. 큐에 메시지를 보관하면 수신자가 나중에 처리하는 형태도 가능하다. 따라서 송신자가 수신 처리의 완료까지 반드시 동기적으로 기다려야 한다는 설명은 맞지 않는다. 비동기라는 말은 응답이 무조건 느리다는 뜻이 아니며 실제 지연과 신뢰성은 제품의 설정과 처리 조건에 따라 달라진다.
선지별 해설
- 수신 처리 완료까지의 동기 대기는 MOM의 필수 조건이 아니다.
- 서로 독립적인 응용을 메시지 교환으로 연계할 수 있다.
- 점대점 메시징에서는 큐를 이용해 송신과 수신을 연결한다.
- 응용 사이의 비동기 메시지 전달을 지원한다.
편집 해설 근거: Oracle Java EE 7 Tutorial, Overview of the JMS API — What Is Messaging?; Point-to-Point Messaging Domain
3. 익스트림 프로그래밍에 대한 설명으로 틀린 것은?
- 대표적인 구조적 방법론 중 하나이다.
- 소규모 개발 조직이 불확실하고 변경이 많은 요구를 접하였을 때 적절한 방법이다.
- 익스트림 프로그래밍을 구동시카는 원리는 상식적인 원리와 경험을 최대한 끌어 올리는 것이다.
- 구체적인 실전 방법을 정의하고 있으며, 개발 문서 보다는 소스 코드에 중점을 둔다.
정답과 해설 보기
정답: 1
정답은 ①이다. XP는 짧은 개발 주기, 지속적인 시험과 통합, 고객과의 협력 등을 통해 변화에 대응하는 애자일 개발 방법이다. 구조적 분석·설계의 대표 방법론으로 분류하는 것은 맞지 않는다. 유용한 실천을 자주 수행하고 피드백으로 개선한다는 점이 중요하다. 작동하는 코드와 시험을 중시하더라도 문서를 모두 없애라는 뜻은 아니며 팀과 제품에 필요한 설명과 기록은 유지할 수 있다.
선지별 해설
- XP는 애자일 개발 방법이며 대표적인 구조적 방법론이라는 분류는 틀리다.
- 작은 팀이 변화하는 요구에 반복적으로 대응하는 상황에 어울린다.
- 유용한 원리와 실천을 적극적으로 적용한다는 취지이다.
- 작동하는 소프트웨어와 구체적 개발 실천을 중시하되 필요한 문서를 금지하지 않는다.
편집 해설 근거: Ron Jeffries, What is Extreme Programming? (2011) — Values; Practices
4. 유스케이스 모델에서 액터의 참여 연결, 조건부 행동 추가, 상위 유스케이스의 특수화를 각각 나타내는 관계명에 해당하지 않는 것은?
[학습용 개정문항]
- 연관
- 확장
- 구체화
- 일반화
정답과 해설 보기
정답: 3
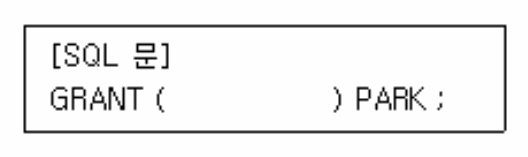
정답은 ③이다. 액터가 유스케이스에 참여하는 연결은 연관, 조건에 따라 기존 유스케이스에 행동을 덧붙이는 관계는 확장, 상위 유스케이스를 특수화하는 관계는 일반화에 해당한다. 구체화는 이 세 역할에 대응하지 않는다. UML 전체에서 실체화 관계를 사용할 수 있는지의 문제가 아니라 지문이 지정한 세 관계의 의미를 대조하는 문제이다. 별도로 포함 관계는 다른 유스케이스의 행동을 포함하는 데 사용한다.
선지별 해설
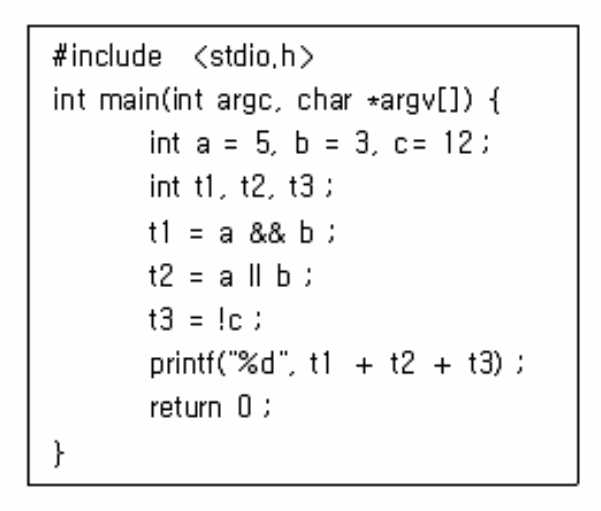
- 액터와 유스케이스의 참여 연결은 연관으로 표현할 수 있다.
- 선택적·조건부 행동 추가는 확장 관계의 역할이다.
- 지문에 지정된 세 역할에 대응하는 관계명이 아니다.
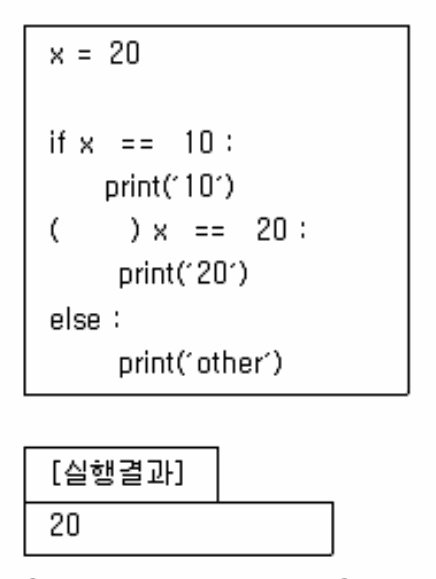
- 상위 유스케이스를 특수화하는 관계는 일반화이다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §18 UseCases — Associations, Extend, Generalization
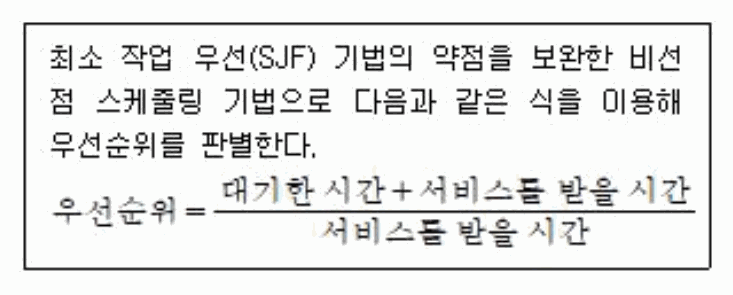
5. 요구사항 분석에서 비기능적(Nonfunctional) 요구사항에 대한 설명으로 옳은 것은?
- 시스템의 처리량(Throughput), 반응 시간 등의 성능·품질 요구는 비기능적 요구사항에 해당하지 않는다.
- 차량 대여 시스템이 제공하는 모든 화면은 3초 이내에 사용자에게 표시되어야 한다는 요구는 비기능적 요구사항이다.
- 시스템 구축과 관련된 안전·보안 요구사항은 비기능적 요구사항에 해당하지 않는다.
- 금융 시스템은 조회, 인출, 입금, 송금 기능을 제공해야 한다는 요구는 비기능적 요구사항이다.
정답과 해설 보기
정답: 2
정답은 ②이다. 화면을 3초 이내에 표시하라는 요구는 무엇을 제공하는가보다 응답 성능이 어느 수준이어야 하는가를 규정한다. 따라서 비기능적 요구사항의 예이다. 조회·인출·입금·송금의 제공은 기능 요구에 해당한다. 처리량과 반응 시간은 대표적인 성능 조건이며 안전·보안에도 품질이나 제약에 해당하는 요구가 있다. 보안 분야 전체가 언제나 비기능적이라는 뜻은 아니고 인증 기능처럼 기능으로 명세되는 요구도 있다.
선지별 해설
- 처리량과 반응 시간은 비기능적 성능 요구의 대표 사례이다.
- 화면 응답 시간이라는 품질 수준을 정한 요구이다.
- 안전·보안에 관한 품질과 제약 요구를 전부 배제할 수 없다.
- 조회·인출·입금·송금은 제공할 기능에 관한 요구이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements — Functional and Nonfunctional Requirements
6. 정보공학 방법론에서 데이터베이스 설계의 표현으로 사용하는 모델링 언어는?
- Package Diagram
- State Transition Diagram
- Deployment Diagram
- Entity-Relationship Diagram
정답과 해설 보기
정답: 4
정답은 ④이다. ER 다이어그램은 개체, 속성, 개체 사이의 관계를 표현하여 데이터베이스의 개념 구조를 설계할 때 사용한다. 예를 들어 고객과 주문을 개체로 정하고 고객이 주문한다는 관계를 연결한다. 패키지 다이어그램은 모델 요소의 묶음, 상태 전이 다이어그램은 사건에 따른 상태 변화, 배치 다이어그램은 실행 환경과 배치를 다룬다. 데이터의 개념 구조라는 지문의 목적에 직접 대응하는 것은 ER 모델이다.
선지별 해설
- 관련 모델 요소의 묶음과 의존을 나타낸다.
- 사건에 따른 상태의 변화를 나타낸다.
- 실행 노드와 소프트웨어의 배치를 나타낸다.
- 개체·속성·관계로 데이터의 개념 구조를 나타낸다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, ER Model — Conceptual Design Using the ER Model
7. 미들웨어(Middleware)에 대한 설명으로 틀린 것은?
- 여러 운영체제에서 응용 프로그램들 사이에 위치한 소프트웨어이다.
- 미들웨어의 서비스 이용을 위해 사용자가 정보 교환 방법 등의 내부 동작을 쉽게 확인할 수 있어야 한다.
- 소프트웨어 컴포넌트를 연결하기 위한 준비된 인프라 구조를 제공한다.
- 여러 컴포넌트를 1대 1, 1대 다, 다대 다등 여러 가지 형태로 연결이 가능하다.
정답과 해설 보기
정답: 2
정답은 ②이다. 미들웨어는 응용들이 통신하거나 서비스를 이용하는 데 필요한 공통 기능과 인터페이스를 제공한다. 사용자가 통신 내부의 구현 방법을 모두 알아야 서비스를 이용할 수 있는 것은 아니다. 메시지 큐나 발행·구독처럼 연결 방식도 달라질 수 있다. 내부 동작을 추상화한다는 원칙은 로그나 진단 정보를 제공하지 말라는 뜻이 아니며, 공개된 사용 계약과 내부 구현의 의존을 분리하라는 의미이다.
선지별 해설
- 운영 환경과 응용 사이 또는 응용들 사이에 공통 서비스를 제공한다.
- 내부 교환 방법을 확인하는 것을 서비스 이용의 필수 조건으로 삼지 않는다.
- 컴포넌트가 통신하고 협력하는 공통 기반을 제공할 수 있다.
- 메시징 방식에 따라 점대점과 발행·구독 등 다양한 연결을 지원한다.
편집 해설 근거: Oracle Java EE 7 Tutorial, Overview of the JMS API — What Is Messaging?; Messaging Domains
8. UI의 설계 지침으로 틀린 것은?
- 이해하기 편하고 쉽게 사용할 수 있는 환경을 제공해야 한다.
- 주요 기능을 메인 화면에 노출하여 조작이 쉽도록 하여야 한다.
- 치명적인 오류에 대한 부정적인 사항은 사용자가 인지할 수 없도록 한다.
- 사용자의 직무, 연령, 성별 등 다양한 계층을 수용하여야 한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 사용자의 작업에 영향을 주는 오류는 알아볼 수 있게 알리고 가능한 복구 방법을 제공해야 한다. 치명적인 오류를 숨기면 사용자가 현재 상태를 오해하여 잘못된 작업을 계속할 수 있다. 이해하기 쉬운 표현, 중요한 기능의 발견 가능성, 다양한 사용자의 이용 조건을 고려하는 설계는 적절하다. 다만 오류 메시지에 비밀번호나 내부 보안 정보를 그대로 노출하는 것과 오류 발생 사실을 알리는 일은 구별해야 한다.
선지별 해설
- 이해하기 쉬운 표현과 조작은 사용성을 높인다.
- 중요한 기능을 발견하고 접근하기 쉽도록 하는 취지이다.
- 작업에 영향을 주는 오류를 숨기는 것은 적절한 안내가 아니다.
- 다양한 사용자의 능력과 이용 맥락을 고려할 필요가 있다.
편집 해설 근거: W3C WCAG 2.2, Understanding SC 3.3.1 Error Identification — Understanding SC 3.3.1 Error Identification; Jakob Nielsen, 10 Usability Heuristics for User Interface Design — Help users recognize, diagnose, and recover from errors
9. 객체지향 개념에서 다형성(Polymorphism)과 관련한 설명으로 틀린 것은?
- 다형성은 현재 코드를 변경하지 않고 새로운 클래스를 쉽게 추가할 수 있게 한다.
- 다형성이란 여러 가지 형태를 가지고 있다는 의미로, 여러 형태를 받아들일 수 있는 특징을 말한다.
- 메소드 오버라이딩(Overriding)은 상위 클래스에서 정의한 일반 메소드의 구현을 하위 클래스에서 무시하고 재정의할 수 있다.
- 메소드 오버로딩(overloading)의 경우 매개변수 타입은 동일하지만 메소드명을 다르게 함으로써 구현, 구분할 수 있다.
정답과 해설 보기
정답: 4
정답은 ④이다. 오버로딩은 같은 이름의 메서드를 서로 다른 매개변수 목록으로 선언하는 것이다. 이름만 다르게 하고 매개변수 타입을 같게 만드는 것은 오버로딩의 설명이 아니다. 오버라이딩은 상위 타입의 인스턴스 메서드를 하위 타입에서 재정의하는 것으로 접근성 등의 언어 규칙을 따라야 한다. 다형성을 활용하면 공통 인터페이스를 사용하는 코드에 새 구현을 연결하기 쉬워지지만 모든 변경이 자동으로 없어지는 것은 아니다.
선지별 해설
- 공통 인터페이스를 사용하면 새 구현을 추가할 때 기존 호출 코드의 변경을 줄일 수 있다.
- 같은 추상적 사용 방식으로 여러 구체 형태를 다루는 특징이다.
- 언어의 재정의 가능 조건을 만족하는 인스턴스 메서드에 대한 설명이다.
- 오버로딩은 이름을 같게 두고 매개변수 목록을 달리하는 것이다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 8 Classes — §8.4.8 Inheritance, Overriding, and Hiding; §8.4.9 Overloading
10. 소프트웨어 개발 영역을 결정하는 요소 중 다음 사항과 관 계있는 것은?
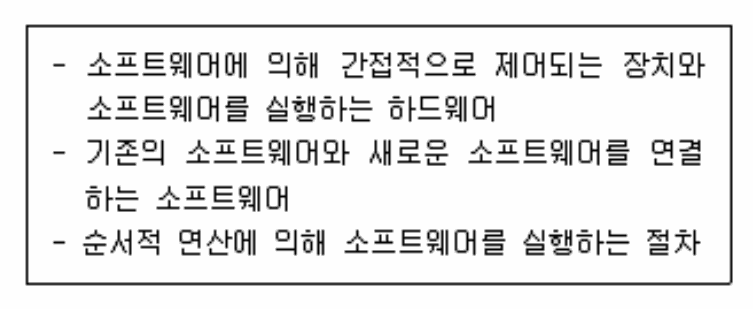
- 기능(Function)
- 성능(Performance)
- 제약조건(Constraint)
- 인터페이스(Interface)
정답과 해설 보기
정답: 4
정답은 ④이다. 제시된 하드웨어, 기존·신규 소프트웨어 및 운용 절차는 개발 대상이 외부와 어떤 접점으로 상호작용하는지를 검토할 때 다루는 대상이다. 인터페이스는 연결 상대, 교환 데이터와 신호, 호출 방식과 순서 등을 규정한다. 기능은 수행할 작업 자체, 성능은 처리 속도와 용량, 제약은 개발과 운용에서 지켜야 할 제한 조건이다. 외부 장치나 절차가 언급됐다는 이유만으로 그 대상 전체가 소프트웨어 기능이 되는 것은 아니다.
선지별 해설
- 제공할 작업 자체를 뜻하며 지문의 연결 접점이라는 공통 관점과 다르다.
- 속도·처리량 같은 성능 수준을 뜻한다.
- 허용 범위나 준수 조건을 뜻한다.
- 하드웨어·다른 소프트웨어·운용 절차와의 상호작용 접점이다.
편집 해설 근거: NASA Systems Engineering Handbook, 6.3 Interface Management — 6.3 Interface Management — interfaces between systems and elements
11. 객체에 대한 설명으로 틀린 것은?
- 객체는 상태, 동작, 고유 식별자를 가진 모든 것이라 할 수 있다.
- 객체는 공통 속성을 공유하는 클래스들의 집합이다.
- 객체는 필요한 자료 구조와 이에 수행되는 함수들을 가진 하나의 독립된 존재이다.
- 객체의 상태는 속성값에 의해 정의된다.
정답과 해설 보기
정답: 2
정답은 ②이다. 객체는 특정 식별성을 가지며 속성값으로 상태를, 연산이나 메서드로 동작을 표현하는 개별 존재이다. 클래스는 공통 구조와 동작을 갖는 객체들을 분류하고 정의하는 단위이므로 객체를 클래스들의 집합이라고 뒤집어 설명하면 틀리다. 같은 클래스의 두 객체도 속성값과 식별성이 다를 수 있다. 객체가 독립된 단위라는 말은 다른 객체와 협력하거나 참조 관계를 가질 수 없다는 뜻은 아니다.
선지별 해설
- 객체는 식별성·상태·동작이라는 관점으로 설명할 수 있다.
- 객체와 클래스를 거꾸로 설명했다. 클래스가 객체의 공통 특성을 정의한다.
- 데이터와 관련 동작을 함께 가진 개별 단위로 볼 수 있다.
- 특정 시점의 속성값이 객체의 상태를 나타낸다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §9 Classification; §11 Structured Classifiers — Class
12. 속성과 관련된 연산(operation)을 클래스 안에 묶어서 하나로 취급하는 것을 의미하는 객체지향 개념은?
- Inheritance
- Class
- Encapsulation
- Association
정답과 해설 보기
정답: 3
정답은 ③이다. 캡슐화는 관련 데이터와 그 데이터를 다루는 연산을 하나의 단위로 묶는 개념이다. 외부에는 필요한 인터페이스를 제공하고 내부 표현에 대한 직접 의존을 줄이는 데 도움이 된다. 클래스는 이러한 구조를 정의하는 언어·모델의 단위이며, 상속은 상위 타입의 특성을 이어받는 관계, 연관은 객체 사이의 구조적 연결이다. 묶는다는 개념과 묶음을 표현하는 클래스라는 수단을 구별해야 한다.
선지별 해설
- 상위 클래스의 특성을 하위 클래스가 이어받는 관계이다.
- 객체의 구조와 동작을 정의하는 단위이며 묶는 원리의 이름과 다르다.
- 관련 속성과 연산을 한 단위로 묶는 캡슐화이다.
- 객체 사이의 구조적 연결을 나타낸다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design — Design Principles, Encapsulation and Separation of Interface and Implementation
13. 애자일(Agile) 프로세스 모델에 대한 설명으로 틀린 것은?
- 변화에 대한 대응보다는 자세한 계획을 중심으로 소프트웨어를 개발한다.
- 프로세스와 도구 중심이 아닌 개개인과의 상호작용을 통해 의견을 수렴한다.
- 협상과 계약보다는 고객과의 협력을 중시한다.
- 문서 중심이 아닌, 실행 가능한 소프트웨어를 중시한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 애자일 선언은 계획을 따르는 것보다 변화에 대응하는 것에 더 큰 가치를 둔다. 개인과 상호작용, 작동하는 소프트웨어, 고객과의 협력을 중시하는 나머지 보기는 이 가치와 맞는다. 그렇다고 계획·도구·문서·계약을 쓸모없다고 선언한 것은 아니다. 필요한 계획을 세운 뒤 짧은 주기의 결과와 새 정보를 바탕으로 조정하는 태도와, 자세한 계획을 변화보다 우선하는 태도를 구별해야 한다.
선지별 해설
- 애자일 선언의 변화 대응과 계획 준수 사이의 가치 우선순위를 반대로 적었다.
- 개인과 상호작용에 더 큰 가치를 두는 취지이다.
- 계약 협상보다 고객과의 협력을 중시한다.
- 포괄적인 문서보다 작동하는 소프트웨어를 중시한다.
편집 해설 근거: Manifesto for Agile Software Development (2001) — Four values and concluding qualification
14. 명백한 역할을 가지고 독립적으로 존재할 수 있는 시스템의 부분으로 넓은 의미에서는 재사용되는 모든 단위라고 볼 수 있으며, 인터페이스를 통해서만 접근할 수 있는 것은?
- Model
- Sheet
- Component
- Cell
정답과 해설 보기
정답: 3
정답은 ③이다. 컴포넌트는 맡은 기능과 인터페이스를 통해 다른 부분과 협력하는 모듈화된 구성 단위이다. 내부 구현을 감추고 제공·요구 인터페이스를 명시하면 같은 계약을 만족하는 구현으로 교체하거나 재사용하기 쉽다. 독립적이라는 표현은 모든 컴포넌트가 다른 서비스 없이 단독 실행된다는 보장이 아니다. 모델·시트·셀은 이 문항의 인터페이스 중심 구성 단위를 직접 지칭하는 용어가 아니다.
선지별 해설
- 시스템을 특정 관점에서 표현한 모형이라는 더 넓은 용어이다.
- 문서나 표의 시트라는 용어는 지문의 구성 단위 정의와 다르다.
- 명시된 인터페이스로 협력하는 모듈화된 시스템 구성 단위이다.
- 표의 셀 같은 단위는 해당 소프트웨어 개념의 이름이 아니다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §11 Structured Classifiers — Component
15. GoF(Gang of Four) 디자인 패턴을 생성·구조·행동의 세 그룹으로 분류할 때, 구조 패턴이 아닌 것은?
- Adapter 패턴
- Bridge 패턴
- Builder 패턴
- Proxy 패턴
정답과 해설 보기
정답: 3
정답은 ③이다. 빌더는 복잡한 객체를 단계적으로 구성하는 과정을 표현 방식과 분리하는 생성 패턴이다. 어댑터는 인터페이스의 불일치를 연결하고, 브리지는 추상 부분과 구현 부분을 분리하며, 프록시는 실제 객체를 대신하는 접근 지점을 둔다. 이 세 패턴은 클래스나 객체를 결합하는 구조 패턴에 속한다. 패턴을 외울 때는 이름뿐 아니라 생성 과정, 구성 구조, 책임과 상호작용 중 무엇을 다루는지 확인한다.
선지별 해설
- 기존 인터페이스를 기대하는 인터페이스에 맞추는 구조 패턴이다.
- 추상화와 구현을 분리하는 구조 패턴이다.
- 복잡한 객체의 구성 과정을 다루는 생성 패턴이다.
- 대리 객체로 실제 객체에 대한 접근을 다루는 구조 패턴이다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — GoF pattern classification; Builder, Adapter, Bridge, Proxy
16. UI와 관련된 기본 개념 중 시스템의 상태와 사용자 조작의 결과를 알려 진행 상황을 이해하도록 돕는 것은?
- Feedback
- Posture
- Module
- Hash
정답과 해설 보기
정답: 1
정답은 ①이다. 피드백은 시스템이 무엇을 하고 있으며 사용자의 조작이 어떤 결과를 냈는지 알려 주는 반응이다. 저장 완료 표시, 업로드 진행률, 입력 오류 안내 등이 예가 된다. 사용자는 이 정보를 바탕으로 기다릴지, 수정할지, 다음 작업으로 넘어갈지 판단한다. 상태를 보여 주는 시점과 표현은 작업 맥락에 맞아야 하며 단순히 메시지를 많이 표시하는 것 자체가 좋은 피드백의 기준은 아니다.
선지별 해설
- 시스템 상태와 조작 결과를 사용자에게 알려 주는 피드백이다.
- 인터페이스가 사용되는 성격이나 자세의 개념으로 해당 반응을 뜻하지 않는다.
- 프로그램을 나누는 구성 단위라는 용어이다.
- 데이터를 해시값으로 변환하는 개념이며 상태 안내와 다르다.
편집 해설 근거: Jakob Nielsen, 10 Usability Heuristics for User Interface Design — Visibility of system status
17. 사용자 인터페이스(UI)의 종류 중 멀티터치와 동작 인식처럼 사용자의 자연스러운 움직임으로 시스템과 상호작용하는 방식은?
- GUI(Graphical User Interface)
- OUI(Organic User Interface)
- NUI(Natural User Interface)
- CLI(Command Line Interface)
정답과 해설 보기
정답: 3
정답은 ③이다. NUI는 터치, 몸짓, 음성 등 사람이 익숙하게 사용하는 행동을 입력과 상호작용에 활용하는 인터페이스를 가리킨다. 지문은 멀티터치와 동작 인식을 핵심 조건으로 제시한다. GUI는 그래픽 요소 중심의 조작, CLI는 문자 명령 입력이라는 관점이다. 하나의 제품이 그래픽 화면과 자연스러운 제스처를 함께 제공할 수 있으므로 실제 제품에서 이 분류가 반드시 서로 배타적인 것은 아니다.
선지별 해설
- 그래픽 요소를 사용하는 관점이며 자연스러운 움직임이라는 조건에 대한 직접 명칭은 아니다.
- 변형 가능한 물리적 표면 등의 상호작용을 강조하는 별도의 분류이다.
- 터치·동작 인식 등 자연스러운 행동을 활용하는 NUI이다.
- 문자 명령을 입력하는 인터페이스이다.
편집 해설 근거: Microsoft Official Blog, Behind the Scenes of NUI at Microsoft (2011) — Natural User Interface — gestures, speech and touch
18. 소프트웨어 모델링과 관련한 설명으로 틀린 것은?
- 모델링 작업의 결과물은 다른 모델링 작업에 영향을 줄 수 없다.
- 구조적 방법론에서는 DFD(Data Flow Diagram), DD(Data Dictionary) 등을 사용하여 요구 사항의 결과를 표현한다.
- 객체지향 방법론에서는 UML 표기법을 사용한다.
- 소프트웨어 모델을 사용할 경우 개발될 소프트웨어에 대한 이해도 및 이해 당사자 간의 의사소통 향상에 도움이 된다.
정답과 해설 보기
정답: 1
정답은 ①이다. 서로 다른 모델은 같은 시스템을 다른 관점에서 표현하므로 한 모델에서 바뀐 요구나 구조가 다른 모델의 수정으로 이어질 수 있다. 예를 들어 데이터 구조의 변경은 데이터 흐름과 연산 명세에 영향을 줄 수 있다. 구조적 분석에서는 자료 흐름도와 자료 사전, 객체지향 분석·설계에서는 UML 같은 표기법을 활용한다. 모델링은 복잡성을 줄이고 관계자 사이의 이해와 의사소통을 돕는 활동이다.
선지별 해설
- 모델은 서로 관련되므로 한 모델의 변경이 다른 모델에 영향을 줄 수 있다.
- DFD와 DD는 구조적 분석에서 사용하는 대표 산출물이다.
- UML은 객체지향 분석·설계에 활용할 수 있는 표준 표기법이다.
- 공유된 표현으로 이해와 의사소통을 돕는다.
편집 해설 근거: Connell·Wenneson, NASA CR-177625 Software Engineering Guidebook (1993) — §4.1.1 Structured Analysis; §4.2 Object-Oriented Analysis; OMG UML 2.5.1 (2017) — §6 Additional Information — modeling overview
19. 유스케이스 다이어그램(Use Case Diagram)에 관련된 내용으로 틀린 것은?
[학습용 개정문항]
- 시스템과 상호작용하는 외부 시스템은 액터로 파악해서는 안 된다.
- 유스케이스는 사용자 측면에서의 요구사항으로, 사용자가 원하는 목표를 달성하기 위해 수행할 내용을 기술한다.
- 대상 시스템 밖에서 데이터를 주고받는 다른 시스템도 액터 역할을 할 수 있다.
- 사용자 목표 수준의 주요 유스케이스는 액터에게 의미 있는 결과를 주는 행동을 기술한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 액터는 대상 시스템 밖에서 시스템과 상호작용하는 역할이므로 사람뿐 아니라 외부 시스템도 될 수 있다. 대상 시스템의 경계를 먼저 정해야 무엇이 액터인지 판단할 수 있다. 사용자 목표 수준의 유스케이스는 그 액터에게 의미 있는 결과를 주는 행동을 설명한다. 공통 동작을 포함 유스케이스로 분리하는 모델링도 가능하므로 모든 내부 행동의 별도 표현을 금지하는 일반 규칙으로 확대해서는 안 된다.
선지별 해설
- 외부 시스템도 대상 시스템과 상호작용하면 액터 역할을 할 수 있다.
- 액터가 얻으려는 목표와 의미 있는 결과를 중심으로 기술한다.
- 기존 구축 여부와 관계없이 외부에서 연동되는 시스템이 액터 역할을 할 수 있다.
- 사용자 목표 수준의 주요 유스케이스는 액터에게 의미 있는 결과를 표현한다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §18 UseCases — Actor, UseCase, Include
20. 소프트웨어 아키텍처 모델 중 MVC(Model-View-Controller)와 관련한 설명으로 틀린 것은?
- MVC 모델은 사용자 인터페이스 계층의 응집도를 높이고 여러 뷰 사이의 결합도를 낮출 수 있다.
- 모델(Model)은 뷰(View)와 제어기(Controller) 사이의 단순 전달자이며, 뷰마다 별도의 모델 서브시스템이 하나씩 연결된다.
- 뷰(View)는 모델의 데이터를 사용자 인터페이스에 표시하는 역할을 담당한다.
- 제어기(Controller)는 사용자 입력을 받아 모델의 상태 변경을 요청한다.
정답과 해설 보기
정답: 2
정답은 ②이다. MVC의 모델은 응용의 데이터와 업무 규칙을 담당하며 단순히 뷰와 컨트롤러 사이에서 메시지를 전달하는 역할로 제한되지 않는다. 하나의 모델을 여러 뷰에서 표현할 수도 있다. 뷰는 데이터를 사용자에게 보여 주고 컨트롤러는 입력을 받아 적절한 처리로 연결한다. 역할을 분리하면 화면 표현과 업무 규칙을 각각 변경하기 쉬워지지만 구체적인 의존 방향과 구현 방식은 사용하는 프레임워크에 따라 달라질 수 있다.
선지별 해설
- 표현과 업무 처리의 역할 분리는 응집도를 높이고 불필요한 의존을 줄이는 데 도움이 된다.
- 모델은 데이터·업무 규칙을 담당하며 뷰마다 반드시 하나씩 분리되지 않는다.
- 뷰의 주된 책임은 모델 정보를 화면 등으로 표현하는 것이다.
- 컨트롤러는 입력을 처리하고 모델 작업과 응답을 연결한다.
편집 해설 근거: Microsoft, Overview of ASP.NET Core MVC — MVC pattern — MVC architectural pattern; Model, View, Controller responsibilities
정보처리기사 필기 기출문제 · 소프트웨어 개발
21. 통합 테스트(Integration Test)와 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 시스템을 구성하는 모듈의 인터페이스와 결합을 테스트하는 것이다.
- 하향식 통합 테스트의 경우 넓이 우선 방식으로 테스트할 모듈을 선택할 수 있다.
- 상향식 통합 테스트의 경우 시스템 구조도의 최상위에 있는 모듈을 먼저 구현하고 테스트한다.
- 하향식 통합은 상위 제어 흐름을 먼저 구성하여 시험할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 상향식 통합은 낮은 수준의 모듈부터 결합하여 상위 모듈로 올라가므로 최상위 모듈부터 시작한다는 설명은 반대이다. 하향식은 상위 제어 구조부터 내려오며 넓이 우선 또는 깊이 우선 순서로 진행할 수 있다. 아직 없는 하위 모듈에는 스텁, 시험 대상을 호출할 상위 부분에는 드라이버를 사용할 수 있다. 어느 방식이 항상 우수한 것이 아니라 먼저 확인하려는 위험과 기능에 맞춰 선택한다.
선지별 해설
- 결합한 모듈 사이의 인터페이스와 상호작용을 확인한다.
- 상위 모듈 아래 같은 수준의 모듈을 먼저 통합하는 선택이 가능하다.
- 상향식은 하위 수준부터 시작하므로 순서를 거꾸로 설명했다.
- 하향식은 상위 제어 흐름을 먼저 구성하여 확인할 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Testing — Test Levels, Integration Testing
22. 다음과 같이 레코드가 구성되어 있을 때, 이진 검색 방법으 로 14를 찾을 경우 비교되는 횟수는?
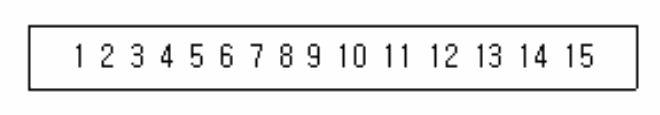
- 2
- 3
- 4
- 5
정답과 해설 보기
정답: 2
정답은 ②이다. 정렬된 1부터 15까지의 자료에서 먼저 중앙값 8과 비교한다. 14가 더 크므로 9부터 15까지로 범위를 줄이고 중앙값 12와 비교한다. 다시 오른쪽의 13부터 15까지에서 중앙값 14를 만나 검색을 마친다. 따라서 키 비교는 8, 12, 14의 세 번이다. 자료 개수나 범위를 절반으로 나눈 횟수만 세지 말고 목표값과 같다고 확인하는 마지막 비교까지 포함해야 한다.
선지별 해설
- 8과 12까지만 비교하면 아직 14를 찾았다는 확인이 끝나지 않는다.
- 비교값은 8 → 12 → 14이므로 세 번이다.
- 14와 일치한 뒤 추가 비교를 할 필요가 없다.
- 검색 종료 이후의 불필요한 비교를 더한 값이다.
편집 해설 근거: NIST DADS, binary search — Definition; binary search on a sorted array
23. 소프트웨어 공학에서 워크스루(Walkthrough)에 대한 설명으로 틀린 것은?
- 사용사례를 확장하여 명세하거나 설계 다이어그램, 원시코드, 테스트 케이스 등에 적용할 수 있다.
- 복잡한 알고리즘 또는 반복, 실시간 동작, 병행 처리와 같은 기능이나 동작을 이해하려고 할 때 유용하다.
- 인스펙션(Inspection)과 동일한 의미를 가진다.
- 단순한 테스트 케이스를 이용하여 프로덕트를 수작업으로 수행해 보는 것이다.
정답과 해설 보기
정답: 3
정답은 ③이다. 워크스루는 작성자가 산출물을 설명하며 동료들이 질문하고 문제를 찾는 검토 방식이다. 문서·설계·코드에 적용하거나 예시 입력을 따라 손으로 동작을 추적할 수 있다. 인스펙션은 정해진 역할과 절차에 따라 결함을 체계적으로 기록하고 후속 조치를 확인하는 형식적 검토이다. 목적이 일부 겹치더라도 동일한 용어는 아니며 모든 워크스루가 반드시 테스트 케이스의 수작업 실행으로만 이루어지는 것도 아니다.
선지별 해설
- 여러 개발 산출물을 대상으로 내용을 함께 따라가며 검토할 수 있다.
- 복잡한 동작을 작성자의 설명과 질문을 통해 이해하는 데 활용할 수 있다.
- 인스펙션과 검토 목적은 겹칠 수 있지만 역할과 형식성이 동일하지 않다.
- 예시 테스트 케이스를 손으로 따라가는 방식은 워크스루의 한 활용이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §3.2.3 Review Types — Walkthrough, Inspection
24. 소프트웨어의 개발 과정에서 소프트웨어의 변경 사항을 관리하기 위해 개발된 일련의 활동을 뜻하는 것은?
- 복호화
- 형상 관리
- 저작권
- 크랙
정답과 해설 보기
정답: 2
정답은 ②이다. 형상 관리는 소프트웨어 구성 항목을 식별하고 버전과 변경을 통제하며 상태를 기록하고 확인하는 일련의 활동이다. 소스 코드뿐 아니라 요구사항, 설계, 시험 자료와 배포 산출물도 관리 대상이 될 수 있다. 변경 이력과 기준선을 남기면 어떤 버전에 무엇이 포함됐는지 추적하기 쉽다. 복호화는 암호화된 정보를 푸는 동작이고 저작권이나 크랙은 이러한 개발 변경 관리 활동의 이름이 아니다.
선지별 해설
- 암호문을 평문으로 복원하는 동작이다.
- 구성 항목·버전·변경·상태를 통제하는 형상 관리이다.
- 창작물에 관한 권리로 개발 변경 관리 활동의 이름이 아니다.
- 보호 장치 우회 등을 가리키며 형상 관리와 다르다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Configuration Management — Identification, Control, Status Accounting, Auditing
25. 테스트 케이스와 관련한 설명으로 틀린 것은?
- 테스트의 목표 및 테스트 방법을 결정하기 전에 테스트 케이스를 작성해야 한다.
- 프로그램에 결함이 있더라도 입력에 따라 정상적인 결과를 낼 수 있으므로 결함을 드러내는 테스트 케이스를 찾는 것이 중요하다.
- 개발된 서비스가 정의된 요구사항을 준수하는지 확인하기 위한 입력값, 실행 조건, 예상 결과의 집합으로 볼 수 있다.
- 테스트 케이스의 실행 결과가 통과인지 실패인지 판단하는 기준을 테스트 오라클(Test Oracle)이라고 한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 테스트 케이스는 무엇을 확인할지 정한 시험 목적과 조건을 바탕으로 입력, 실행 조건과 기대 결과를 구체화한다. 따라서 목표와 방법을 정하기 전에 반드시 먼저 작성해야 한다는 순서는 타당하지 않다. 같은 결함도 입력이나 실행 상태에 따라 드러나지 않을 수 있으므로 결함을 노출할 사례를 선택해야 한다. 실제 결과의 적절성을 판단하는 데 사용하는 기준이나 정보원이 테스트 오라클이다.
선지별 해설
- 시험 목적과 조건을 무시한 선행 작성을 필수 순서로 정할 수 없다.
- 결함을 실행시키거나 실패로 드러내는 입력과 상태가 필요하다.
- 입력·실행 조건·예상 결과는 테스트 케이스의 핵심 내용이다.
- 실제 결과가 기대에 맞는지 판단할 기준을 제공한다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §1.4.2 Test Activities and Tasks; §4.1 Categories of Test Techniques
26. 객체지향 개념을 활용한 소프트웨어 구현과 관련한 설명 중 틀린 것은?
- 객체(Object)란 필요한 자료 구조와 수행되는 함수들을 가진 하나의 독립된 존재이다.
- Java에서 정보은닉(Information Hiding)을 표기할 때 private의 의미는 '공개'이다.
- 상속(Inheritance)은 개별 클래스를 상속 관계로 묶음으로써 클래스 간의 체계화된 전체 구조를 파악하기 쉽다는 장점이 있다.
- 같은 클래스에 속하는 개개의 객체이자 하나의 클래스에서 생성된 객체를 인스턴스(Instance)라고 한다.
정답과 해설 보기
정답: 2
정답은 ②이다. Java의 private은 공개를 뜻하지 않고 해당 멤버에 대한 접근을 제한한다. public과 반대되는 접근 제어의 의도를 이해해야 한다. 정확한 접근 가능 범위에는 중첩 클래스와 둘러싼 최상위 클래스에 관한 언어 규칙도 있으므로 단순히 모든 다른 클래스가 언제나 접근 불가라고 일반화하지 않는다. 객체는 개별 인스턴스이고 클래스는 공통 구조를 정의하며 상속은 클래스 사이의 특수화 관계를 구성한다.
선지별 해설
- 객체를 데이터와 동작을 갖는 개별 단위로 설명한 것이다.
- private은 비공개 접근 제한이며 공개를 뜻하지 않는다.
- 상속 관계는 상위·하위 타입의 구조를 나타낸다.
- 클래스로부터 생성된 개별 객체를 인스턴스라고 한다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 6 Names — §6.6.1 Determining Accessibility; Oracle Java SE 25 Language Specification, Chapter 8 Classes — §8.1 Class Declarations; §8.1.4 Superclasses
27. DRM(Digital Rights Management)에 관한 설명으로 틀린 것은?
- 디지털 콘텐츠와 디바이스의 사용을 제한하기 위해 하드웨어 제조업자, 저작권자, 출판업자 등이 사용할 수 있는 접근 제어 기술이다.
- 디지털 미디어의 생명 주기에서 사용 권한 관리, 과금, 유통 단계를 관리하는 기술로 볼 수 있다.
- 클리어링 하우스(Clearing House)는 사용자에게 콘텐츠 라이선스를 발급하고 이용 권한을 부여하는 역할을 한다.
- 원본을 안전하게 유통하기 위한 전자적 보안을 고려하지 않으므로 불법 유통과 복제를 방지할 수 없다.
정답과 해설 보기
정답: 4
정답은 ④이다. DRM은 콘텐츠의 이용 권한을 라이선스 등의 형태로 표현하고 정당한 이용 조건을 집행하도록 돕는 기술이다. 콘텐츠 암호화와 키의 전달, 사용 기간이나 횟수 같은 정책을 함께 다룰 수 있다. 라이선스를 발급하고 권리를 관리하는 주체는 전통적 구성 설명에서 클리어링 하우스로 불리기도 한다. 전자적 보안을 고려하지 않는다는 주장은 틀리며 DRM을 적용하면 모든 불법 복제가 완전히 사라진다는 보장도 아니다.
선지별 해설
- 콘텐츠와 장치에서 허용할 이용을 관리하는 접근 제어에 활용된다.
- 라이선스와 유통·과금 절차를 함께 관리하는 체계로 구성할 수 있다.
- 라이선스와 이용 권한을 발급·관리하는 역할을 설명한다.
- 암호화와 권한 집행 등 전자적 보호를 고려하므로 설명이 틀리다.
편집 해설 근거: Microsoft PlayReady, Licensing FAQ, 아키텍처 역할 설명 — PlayReady licensing FAQ — content distribution and license services; W3C Recommendation — ODRL Information Model 2.2 — §2 Information Model; Permissions, Prohibitions, Duties
28. 위험 모니터링의 의미로 옳은 것은?
- 위험을 이해하는 것
- 첫 번째 조치로 위험을 피할 수 있도록 하는 것
- 위험 발생 후 즉시 조치하는 것
- 위험 요소 징후들에 대하여 계속적으로 인지하는 것
정답과 해설 보기
정답: 4
정답은 ④이다. 위험 모니터링은 위험 요인과 징후, 환경 변화 및 대응 조치의 효과를 계속 관찰하는 활동이다. 이미 평가한 위험도 조건이 달라지면 가능성과 영향이 달라질 수 있으므로 주기적 또는 사건 기반으로 다시 확인한다. 위험을 이해하고 평가하는 일, 위험을 회피하는 대응, 발생 후 복구하는 조치는 서로 관련되지만 모니터링 자체의 정의는 아니다. 관찰 결과는 위험 평가와 대응 계획을 갱신하는 데 사용한다.
선지별 해설
- 위험의 식별·분석에 가까우며 지속 관찰의 정의와는 다르다.
- 위험을 피하는 대응 선택지에 해당한다.
- 발생 후의 대응 조치이며 계속 관찰하는 활동과 구분된다.
- 징후와 조건 변화를 지속적으로 확인하는 모니터링이다.
편집 해설 근거: NIST SP 800-30 Rev.1 (2012) — §3.4 Maintain the Assessment; Task 4-1 Monitor Risk Factors
29. 동시에 소스를 수정하는 것을 방지하며 다른 방향으로 진행된 개발 결과를 합치거나 변경 내용을 추적할 수 있는 소프트웨어 버전 관리 도구는?
- RCS(Revision Control System)
- RTS(Reliable Transfer Service)
- RPC(Remote Procedure Call)
- RVS(Relative Version System)
정답과 해설 보기
정답: 1
정답은 ①이다. RCS는 파일의 여러 리비전을 보관하고 변경 이력을 비교·추적하는 버전 관리 도구이다. 기본 잠금 방식에서는 특정 리비전의 후속 변경을 체크인할 권한을 잠금 보유자에게 제한하며 분기와 병합도 지원한다. 이는 잠금을 사용하는 관리 절차의 특성이지 어떤 복사본도 다른 사람이 편집할 수 없게 만든다는 뜻은 아니다. RPC는 원격 절차 호출이므로 소스 리비전 관리 도구와 목적이 다르다.
선지별 해설
- 리비전·잠금·분기·병합 기능을 제공하는 버전 관리 도구이다.
- Reliable Transfer Service는 이 소스 버전 관리 도구의 이름이 아니다.
- 원격 프로세스의 절차를 호출하는 통신 방식이다.
- 제시된 약어는 RCS의 정식 명칭과 일치하지 않는다.
편집 해설 근거: GNU RCS 5.10.1 Manual, Concepts and Usage — Concepts — revisions, branches, locks; rcsmerge
30. 화이트박스 테스트와 관련한 설명으로 틀린 것은?
- 화이트박스 테스트의 이해를 위해 논리 흐름도(Logic-Flow Diagram)를 이용할 수 있다.
- 테스트 데이터를 이용해 실제 프로그램을 실행함으로써 오류를 찾는 동적 테스트(Dynamic Test)에 해당한다.
- 프로그램의 구조를 고려하지 않기 때문에 테스트 케이스는 프로그램 또는 모듈의 요구나 명세를 기초로 결정한다.
- 테스트 데이터를 선택하기 위하여 검증 기준(Test Coverage) 을 정한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 화이트박스 테스트는 코드의 내부 구조를 이용해 시험 조건과 사례를 정한다. 문장이나 분기 등 어떤 구조를 실행했는지를 커버리지로 확인할 수 있다. 구조를 고려하지 않고 요구사항이나 명세만으로 사례를 정한다는 설명은 블랙박스 기법에 가깝다. 소스 코드를 읽어 검토하는 정적 분석과도 구별해야 하며 이 문항은 입력을 주어 프로그램을 실행하는 구조 기반 동적 테스트를 묻는다.
선지별 해설
- 제어 흐름의 구조를 도식화하면 경로와 분기를 파악하는 데 도움이 된다.
- 지문에서 다루는 구조 기반 테스트는 시험 데이터를 넣어 실행하는 동적 활동이다.
- 내부 구조를 사용하지 않는다는 설명은 화이트박스의 기준과 반대이다.
- 문장·분기 등의 실행 범위를 측정할 커버리지 기준을 정할 수 있다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §4.3 White-box Test Techniques
31. 알고리즘과 관련한 설명으로 틀린 것은?
- 주어진 작업을 수행하는 컴퓨터 명령어를 순서대로 나열한 것으로 볼 수 있다.
- 검색(Searching)은 정렬이 되지 않은 데이터 혹은 정렬이 된 데이터 중에서 키값에 해당되는 데이터를 찾는 알고리즘이다.
- 정렬(Sorting)은 흩어져있는 데이터를 키값을 이용하여 순서대로 열거하는 알고리즘이다.
- 선형 검색은 검색을 수행하기 전에 반드시 데이터의 집합이 정렬되어 있어야 한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 선형 검색은 각 원소를 차례로 확인하며 목표 키와 비교하므로 자료가 미리 정렬되어 있을 필요가 없다. 정렬된 자료에서도 사용할 수 있지만 정렬은 필수 전제와 다르다. 반면 이진 검색은 비교 결과로 검색 범위를 절반씩 제외하기 위해 정렬 순서를 이용한다. 검색은 원하는 항목을 찾는 작업, 정렬은 지정한 키의 순서에 맞게 자료를 재배열하는 작업으로 목적을 나누어 이해한다.
선지별 해설
- 알고리즘을 문제 해결을 위한 명확한 처리 절차로 설명한 취지이다.
- 검색은 자료에서 주어진 키에 대응하는 항목을 찾는다.
- 정렬은 키에 따른 순서로 자료를 배열한다.
- 선형 검색은 정렬되지 않은 자료도 순서대로 확인할 수 있다.
편집 해설 근거: NIST Dictionary of Algorithms and Data Structures, linear search — Definition; NIST DADS, binary search — Definition
32. 왼쪽부터 오른쪽으로 인접한 두 값을 비교하고 왼쪽 값이 더 크면 교환하는 버블 정렬을 수행한다. 다음 자료를 오름차순으로 정렬할 때 첫 번째 전체 패스의 결과는?
[학습용 개정문항]
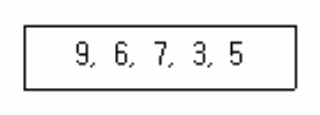
- 6,9,7,3,5
- 3,9,6,7,5
- 3,6,7,9,5
- 6,7,3,5,9
정답과 해설 보기
정답: 4
정답은 ④이다. 왼쪽부터 인접한 두 값을 비교하여 왼쪽이 더 크면 교환한다. 처음 9와 6을 바꾸면 6,9,7,3,5가 되고, 이어 9와 7, 9와 3, 9와 5를 차례로 바꾸면 6,7,3,5,9가 된다. 한 번의 전체 통과가 끝나 최대값 9가 맨 뒤에 자리한다. 첫 비교 한 번과 첫 번째 패스 전체를 혼동하지 않아야 하며 진행 방향을 반대로 정하면 중간 결과는 달라질 수 있다.
선지별 해설
- 첫 인접 비교를 마친 상태이며 전체 첫 패스의 끝은 아니다.
- 지정된 왼쪽에서 오른쪽으로의 교환 순서와 맞지 않는다.
- 한 번의 패스에서 최소값을 맨 앞으로 정렬하는 과정이 아니다.
- 네 번의 인접 비교 후 결과가 6,7,3,5,9이다.
편집 해설 근거: NIST DADS, bubble sort (2023-04-07) — Definition
33. 다음은 인스펙션(Inspection) 과정을 표현한 것이다. (가)~ (마)에 들어갈 말을 보기에서 찾아 바르게 연결한 것은?
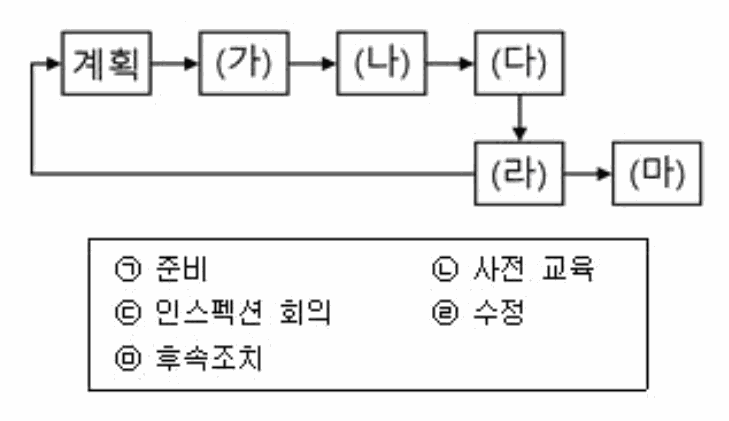
- (가) – ㉡, (나) – ㉢
- (나) – ㉠, (다) – ㉢
- (다) – ㉢, (라) – ㉤
- (라) – ㉣, (마) – ㉢
정답과 해설 보기
정답: 2
정답은 ②이다. 제시된 흐름은 계획 뒤에 사전교육·개요 설명, 개별 준비, 인스펙션 회의, 수정, 후속조치가 이어지는 절차이다. 따라서 (가)는 ㉡, (나)는 ㉠, (다)는 ㉢, (라)는 ㉣, (마)는 ㉤이다. 회의 전에 각 검토자가 자료를 읽고 결함 후보를 찾는 준비가 필요하며 회의 뒤에는 수정과 확인이 따른다. 개요 회의의 실시 여부 같은 세부 절차는 프로젝트 지침에 따라 조정될 수 있다.
선지별 해설
- (가)는 맞지만 (나)는 회의가 아니라 개별 준비인 ㉠이다.
- (나)의 준비와 (다)의 인스펙션 회의를 바르게 연결했다.
- (다)는 맞지만 (라)는 후속조치가 아니라 수정인 ㉣이다.
- (라)는 맞지만 (마)는 회의가 아니라 후속조치인 ㉤이다.
편집 해설 근거: NASA Software Engineering Handbook, 7.10 Peer Review and Inspections — §2.1–2.4, §2.6–2.7 Planning, Overview, Preparation, Inspection Meeting, Rework, Followup
34. 소프트웨어를 보다 쉽게 이해할 수 있고 적은 비용으로 수정할 수 있도록 겉으로 보이는 동작의 변화 없이 내부 구조를 변경하는 것은?
- Refactoring
- Architecting
- Specification
- Renewal
정답과 해설 보기
정답: 1
정답은 ①이다. 리팩터링은 외부에서 관찰되는 동작을 유지하면서 코드의 내부 구조를 개선하는 작업이다. 중복을 줄이거나 함수의 책임을 분리하면 이해와 수정이 쉬워질 수 있다. 기능을 새로 추가하거나 잘못된 외부 동작을 바꾸는 수정은 그 자체로 순수한 리팩터링과 구별한다. 작은 단계로 변경하고 시험으로 동작 보존을 확인하는 것이 중요하며 단순히 코드를 짧게 만드는 것만을 뜻하지 않는다.
선지별 해설
- 관찰 가능한 동작을 보존하면서 내부 구조를 개선하는 리팩터링이다.
- 전체 시스템의 주요 구조와 설계 결정을 다루는 활동이다.
- 요구되는 동작과 제약을 명세하는 활동이다.
- 일반적인 갱신이라는 말로 지문의 정확한 기술 용어가 아니다.
편집 해설 근거: Martin Fowler, Refactoring — Definition of refactoring
35. 단위 테스트(Unit Test)와 관련한 설명으로 틀린 것은?
- 구현 단계에서 각 모듈의 개발을 완료한 후 개발자가 명세서의 내용대로 정확히 구현되었는지 테스트한다.
- 모듈 내부의 구조를 구체적으로 볼 수 있는 구조적 테스트를 주로 시행한다.
- 필요 데이터를 인자를 통해 넘겨주고, 테스트 완료 후 그 결과값을 받는 역할을 하는 가상의 모듈을 테스트 스텁(Stub)이라고 한다.
- 테스트할 모듈을 호출하는 모듈도 있고, 테스트할 모듈이 호출하는 모듈도 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 시험 대상 모듈을 호출하고 입력을 전달한 뒤 결과를 확인하는 가짜 상위 모듈은 테스트 드라이버이다. 스텁은 시험 대상이 호출하는 하위 모듈을 대신하여 필요한 응답을 제공한다. 단위 테스트는 개별 구성 요소를 집중적으로 확인하며 내부 구조에 따른 사례뿐 아니라 명세에 따른 입력과 결과 사례도 사용할 수 있다. 두 보조 모듈은 시험 대상에서 본 호출 방향으로 구별하면 혼동을 줄일 수 있다.
선지별 해설
- 개별 모듈의 구현이 의도와 명세에 맞는지 확인한다.
- 개발자는 내부 구조를 이용한 테스트를 수행할 수 있다.
- 시험 대상을 호출하고 결과를 받는 역할은 드라이버이며 스텁이 아니다.
- 시험 대상의 상위 호출자와 하위 피호출자를 각각 대체할 수 있다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.4227 test driver; §3.4018 stub; ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §2.2.1 Component Testing
36. IDE(Integrated Development Environment) 도구의 각 기능에 대한 설명으로 틀린 것은?
- Coding – 프로그래밍 언어로 프로그램을 작성할 수 있는 환경을 제공한다.
- Compile – 저급 언어 프로그램을 고급 언어 프로그램으로 변환한다.
- Debugging – 프로그램의 버그를 찾아 수정할 수 있게 한다.
- Deployment – 소프트웨어를 최종 사용자에게 전달한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 컴파일은 소스 언어의 프로그램을 대상 표현으로 번역하는 과정이다. 일반적인 개발에서는 고급 언어 소스를 기계어·중간 코드 등으로 변환하므로 저급 언어를 고급 언어로 올리는 것으로 정의할 수 없다. 소스에서 다른 소스로 번역하는 경우도 있으므로 모든 컴파일이 반드시 기계어를 만든다고 한정하지 않는다. 코딩·디버깅·배포 지원은 작성, 오류 추적, 전달이라는 서로 다른 개발 작업을 돕는다.
선지별 해설
- 프로그램을 작성하고 편집하는 환경을 제공한다.
- 컴파일을 저급 언어에서 고급 언어로의 변환으로 정의한 것은 틀리다.
- 실행 흐름과 상태를 조사해 오류 원인을 찾도록 돕는다.
- 사용 환경에 소프트웨어를 전달하고 설치·실행하도록 준비하는 기능이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Construction — Construction Tools; Software Maintenance — Tools; Microsoft, Visual Studio Code Documentation (2026-10-05 확인) — Documentation — Languages, Build, Run and Debug
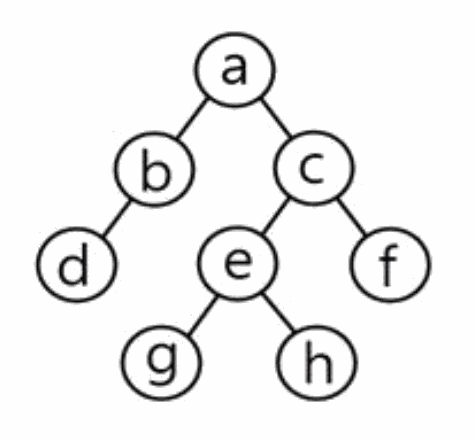
37. 아래 Tree 구조에 대하여 후위 순회(Postorder) 한 결과는?
- a → b → d → c → e → g → h → f
- d → b → g → h → e → f → c → a
- d → b → a → g → e → h → c → f
- a → b → d → g → e → h → c → f
정답과 해설 보기
정답: 2
정답은 ②이다. 후위 순회는 각 노드에서 왼쪽 서브트리, 오른쪽 서브트리, 해당 노드 순으로 방문한다. 루트 a의 왼쪽은 d를 먼저 방문한 뒤 b를 방문한다. 오른쪽 c에서는 e 아래의 g와 h를 방문하고 e, 이어 f, 마지막으로 c를 방문한다. 전체 트리의 루트 a를 맨 마지막에 더하면 d → b → g → h → e → f → c → a가 된다. 루트가 맨 앞에 나오는 전위 순회와 구별한다.
선지별 해설
- 루트를 먼저 방문한 전위 순회이다.
- 왼쪽·오른쪽 서브트리를 마친 뒤 각 루트를 방문한 후위 순회이다.
- 왼쪽 서브트리·루트·오른쪽 순으로 방문한 중위 순회이다.
- 루트 a를 먼저 방문하므로 후위 순회의 결과가 아니다.
편집 해설 근거: NIST DADS, postorder traversal — Definition
38. 인터페이스 구현 시 사용하는 기술로 속성-값 쌍(Attribute-Value Pairs)으로 이루어진 데이터 오브젝트를 전달하기 위해 사용하는 개방형 표준 포맷은?
- JSON
- AJTML
- AVPN
- DOF
정답과 해설 보기
정답: 1
정답은 ①이다. JSON은 구조화된 데이터를 교환하는 텍스트 형식이며 객체를 이름과 값의 쌍으로 표현한다. 이름은 문자열이고 값에는 문자열·수·불리언·null·배열·객체가 올 수 있다. 예를 들어 이름과 점수를 하나의 객체로 전달할 수 있다. 모든 JSON 문서가 반드시 객체여야 하는 것은 아니고 배열이나 다른 JSON 값도 가능하다. 따라서 객체 표현의 특징을 전체 형식의 유일한 형태로 확대하지 않는다.
선지별 해설
- 이름·값 쌍의 객체와 배열 등을 표현하는 표준 데이터 교환 형식이다.
- 지문이 묻는 표준 데이터 교환 형식의 이름이 아니다.
- JSON의 이름·값 쌍 데이터 형식을 나타내는 명칭이 아니다.
- 제시된 정의에 해당하는 RFC 표준 포맷의 이름이 아니다.
편집 해설 근거: IETF RFC 8259 — JSON — §2 JSON Grammar; §3 Values; §4 Objects
39. 순서가 있는 리스트에서 데이터의 삽입(push), 삭제(pop)가 한 쪽 끝에서 일어나며 LIFO(Last-In-First-Out)의 특징을 가지는 자료 구조는?
- Tree
- Graph
- Stack
- Queue
정답과 해설 보기
정답: 3
정답은 ③이다. 스택은 맨 위 한쪽 끝에서 넣기와 꺼내기를 수행하며 나중에 넣은 원소가 먼저 나오는 LIFO 구조이다. 예를 들어 A를 넣고 B를 넣은 뒤 한 번 꺼내면 B가 나온다. 큐는 보통 먼저 들어온 원소가 먼저 나오는 FIFO 구조이고, 트리와 그래프는 노드 사이의 관계를 표현한다. push와 pop은 같은 끝을 다룬다는 점이 핵심이며 내부 구현을 배열로 할지 연결 구조로 할지는 별도의 선택이다.
선지별 해설
- 계층적인 노드 관계를 나타내는 자료 구조이다.
- 노드와 간선의 일반적인 연결 관계를 나타낸다.
- 같은 끝에서 삽입·삭제하며 LIFO 순서를 따르는 스택이다.
- 보통 서로 다른 끝에서 삽입·삭제하며 FIFO 순서를 따른다.
편집 해설 근거: NIST DADS, stack — Definition; push, pop
40. 다음 도구 중 주목적이 테스트 프레임워크 제공이 아니라 파일 의존 관계에 따른 빌드 자동화인 것은?
[학습용 개정문항]
- CppUnit
- JUnit
- HttpUnit
- GNU Make
정답과 해설 보기
정답: 4
정답은 ④이다. GNU Make는 파일 사이의 의존 관계와 갱신 규칙을 바탕으로 필요한 빌드 명령을 실행하는 도구이다. CppUnit과 JUnit은 테스트 작성·실행을 위한 프레임워크이고 HttpUnit은 HTTP 기반 웹 응용의 동작을 시험하는 데 쓰인다. Make에서 테스트 명령을 실행하도록 설정할 수는 있지만 주목적과 제공하는 추상화가 테스트 프레임워크와 같아지는 것은 아니다. HttpUnit의 시험 범위도 개별 함수의 단위 시험으로만 한정되지 않는다.
선지별 해설
- C++ 테스트를 작성하고 실행하는 프레임워크이다.
- Java 등의 JVM 환경에서 테스트를 작성·실행하는 프레임워크이다.
- 웹 응용을 HTTP 동작을 통해 시험하는 도구이다.
- 의존 관계에 따라 파일을 갱신하고 빌드 명령을 실행하는 도구이다.
편집 해설 근거: GNU Make 4.4.1 Manual, Overview of make — §1 Overview of make; CppUnit 공식 문서, The Unit Testing Library — CppUnit documentation — Introduction; JUnit 공식 프로젝트, About — About JUnit; HttpUnit 공식 프로젝트, Home (보존 소개) — Introduction
정보처리기사 필기 기출문제 · 데이터베이스 구축
41. 관계에서 성립하는 모든 비자명한 함수 종속 X → Y에 대해 X가 슈퍼키일 것을 요구하는 정규형은?
[학습용 개정문항]
- BCNF
- 제1정규형
- 제2정규형
- 제3정규형
정답과 해설 보기
정답: 1
정답은 ①이다. BCNF는 관계에서 성립하는 모든 비자명한 함수 종속 X → Y에 대해 결정자 X가 슈퍼키여야 한다고 요구한다. 슈퍼키는 튜플을 유일하게 식별할 수 있는 속성 집합이며 최소성까지 요구하는 후보키와 구별한다. 제3정규형에는 우변 속성이 주속성인 경우를 허용하는 조건이 있어 BCNF보다 약하다. 제1정규형의 원자성이나 제2정규형의 부분 함수 종속 제거만으로 지문의 조건이 충족되지는 않는다.
선지별 해설
- 모든 비자명한 함수 종속의 결정자가 슈퍼키여야 하는 BCNF이다.
- 제1정규형의 원자성만으로 결정자의 슈퍼키 조건을 보장하지 않는다.
- 제2정규형은 비주속성의 부분 함수 종속을 다루는 조건이다.
- 제3정규형은 우변이 주속성인 종속을 허용할 수 있어 더 약하다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — Boyce-Codd Normal Form; Third Normal Form
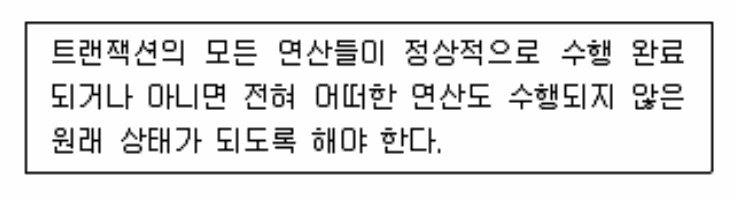
42. 데이터베이스의 트랜잭션 성질들 중에서 다음 설명에 해당 하는 것은?
- Atomicity
- Consistency
- Isolation
- Durability
정답과 해설 보기
정답: 1
정답은 ①이다. 원자성은 트랜잭션의 효과가 전부 반영되거나 실패 시 아무 효과도 남기지 않는 전부 아니면 전무의 성질이다. 일부 연산이 실제로 실행된 뒤 취소될 수도 있으므로 처음부터 어떤 명령도 실행되지 않았다는 뜻은 아니다. 일관성은 올바른 제약을 유지하는 상태 전이, 격리성은 동시 실행의 간섭 통제, 지속성은 커밋한 결과의 보존에 관한 성질이다. 제시된 설명은 실패 시 부분 결과를 남기지 않는 데 초점이 있다.
선지별 해설
- 전체 효과를 반영하거나 부분 효과를 취소하는 원자성이다.
- 정해진 무결성 규칙을 지키는 상태 전이에 관한 성질이다.
- 동시 트랜잭션 사이의 간섭을 통제하는 성질이다.
- 성공적으로 커밋한 결과를 보존하는 성질이다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 17 저자 자료 — Transaction Concept; ACID Properties; PostgreSQL 18, 3.4 Transactions — ROLLBACK and all-or-nothing transactions
43. 분산 데이터베이스 시스템과 관련한 설명으로 틀린 것은?
- 물리적으로 분산된 데이터베이스 시스템을 논리적으로 하나의 데이터베이스 시스템처럼 사용할 수 있도록 한 것이다.
- 물리적으로 분산되어 지역별로 필요한 데이터를 처리할 수 있는 지역 컴퓨터(Local Computer)를 분산 처리기(Distributed Processor)라고 한다.
- 분산 데이터베이스 시스템을 위한 통신 네트워크 구조가 데이터 통신에 영향을 주므로 효율적으로 설계해야 한다.
- 데이터베이스가 분산되어 있음을 사용자가 인식할 수 있도록 분산 투명성(Distribution Transparency)을 배제해야 한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 분산 데이터베이스는 여러 위치에 있는 데이터를 논리적으로 하나의 체계처럼 이용하도록 구성할 수 있다. 분산 투명성은 사용자가 데이터 위치나 분산의 세부 사항을 항상 직접 다루지 않아도 되도록 하는 성질이다. 따라서 분산 사실을 반드시 인식시키기 위해 투명성을 배제해야 한다는 설명은 반대이다. 실제 설계에서는 지역 처리 능력, 통신 비용, 장애와 일관성 요구를 함께 고려한다.
선지별 해설
- 물리적으로 나뉜 데이터를 논리적인 통합 체계로 제공할 수 있다.
- 지역별 처리를 담당하는 컴퓨터가 분산 처리 구성 요소가 된다.
- 통신 지연·대역폭·장애는 분산 데이터 처리에 영향을 준다.
- 분산 세부 사항을 감추는 투명성의 목적을 반대로 설명했다.
편집 해설 근거: Oracle Database — Distributed Database Concepts — Distributed Database Concepts — Location Transparency; Distributed Database Architecture
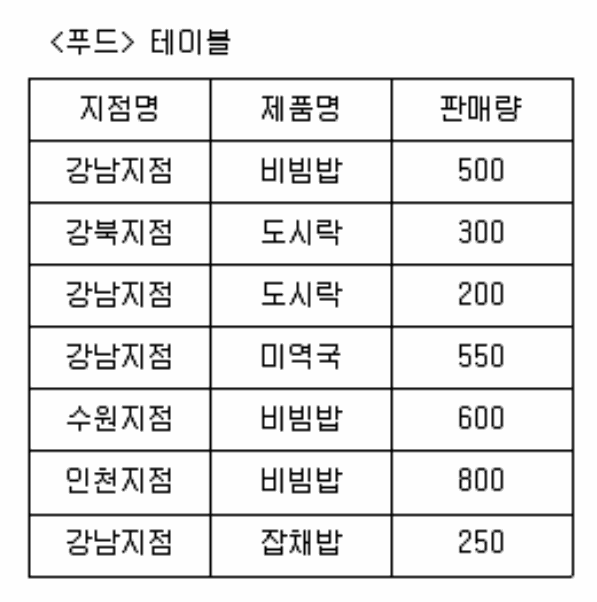
44. 다음 테이블을 보고 강남지점의 판매량이 많은 제품부터 출 력되도록 할 때 다음 중 가장 적절한 SQL 구문은? (단, 출 력은 제품명과 판매량이 출력되도록 한다.)
- SELECT 제품명, 판매량 FROM 푸드 ORDER BY 판매량 ASC;
- SELECT 제품명, 판매량 FROM 푸드 ORDER BY 판매량 DESC;
- SELECT 제품명, 판매량 FROM 푸드 WHERE 지점명='강남지점' ORDER BY 판매량 ASC;
- SELECT 제품명, 판매량 FROM 푸드 WHERE 지점명='강남지점' ORDER BY 판매량 DESC;
정답과 해설 보기
정답: 4
정답은 ④이다. WHERE 지점명='강남지점'으로 해당 지점의 행만 고른 뒤 ORDER BY 판매량 DESC로 판매량이 큰 행부터 정렬한다. SELECT에는 문제에서 요구한 제품명과 판매량을 적는다. 그림의 데이터에 적용하면 미역국 550, 비빔밥 500, 잡채밥 250, 도시락 200 순서이다. 지점 조건을 빼면 다른 지점의 제품이 섞이고 ASC를 사용하면 작은 판매량부터 나온다.
선지별 해설
- 지점 조건이 없고 정렬도 오름차순이므로 두 요구를 모두 충족하지 못한다.
- 내림차순은 맞지만 다른 지점의 행도 포함한다.
- 강남지점을 고르지만 판매량이 작은 순서로 출력한다.
- 강남지점 필터와 판매량 내림차순 정렬을 모두 적용한다.
편집 해설 근거: PostgreSQL 18 — SELECT — SELECT — WHERE Clause; ORDER BY Clause
45. 데이터베이스의 인덱스와 관련한 설명으로 틀린 것은?
- 문헌의 색인, 사전과 같이 데이터를 쉽고 빠르게 찾을 수 있도록 만든 데이터 구조이다.
- 테이블에 부여된 색인으로 데이터 검색 시 처리속도 향상에 도움이 된다.
- 인덱스의 추가, 삭제 명령어는 각각 ADD, DELETE이다.
- 대부분의 데이터베이스에서 테이블을 삭제하면 인덱스도 같이 삭제된다.
정답과 해설 보기
정답: 3
정답은 ③이다. 일반적인 SQL 인덱스 생성과 제거는 CREATE INDEX와 DROP INDEX로 수행하며 ADD와 DELETE를 인덱스의 독립 명령으로 설명하는 것은 틀리다. 인덱스는 조건에 맞는 행을 찾는 데 도움이 되지만 저장 공간과 쓰기 시 유지 비용을 요구한다. PostgreSQL에서 테이블을 제거하면 그 테이블의 인덱스도 함께 제거된다. 모든 검색이 인덱스를 사용하거나 인덱스 추가가 항상 더 빠른 실행을 보장하는 것은 아니다.
선지별 해설
- 찾을 값과 행의 위치를 연결하는 별도 검색 구조로 볼 수 있다.
- 적절한 조건과 실행 계획에서 검색 비용을 줄일 수 있다.
- 생성과 제거의 대표 명령은 CREATE INDEX와 DROP INDEX이다.
- 테이블에 종속된 인덱스는 테이블 제거 시 함께 제거된다.
편집 해설 근거: PostgreSQL 18 — Indexes — §11.1 Introduction; PostgreSQL 18, CREATE INDEX — CREATE INDEX — Synopsis; PostgreSQL 18: DROP TABLE — DROP TABLE — Description
46. 저장 레코드의 물리적 형식을 정할 때 직접 명세하는 항목에 해당하지 않는 것은?
[학습용 개정문항]
- 필드의 자료형
- 가변 길이 필드의 저장과 길이 관리 방식
- 사용자의 업무 목표를 정의한 유스케이스 목록
- 필드 배치와 정렬을 위한 패딩
정답과 해설 보기
정답: 3
정답은 ③이다. 저장 레코드의 물리적 형식은 필드의 자료형, 고정·가변 길이의 표현, 필드 배치와 정렬 경계 같은 사항을 다룬다. 이런 결정은 값을 바이트로 저장하고 다시 해석하는 방법에 직접 영향을 준다. 반면 사용자 업무 목표를 적은 유스케이스 목록은 요구 분석 산출물이며 레코드의 물리적 배치 명세 자체가 아니다. 업무 부하와 접근 패턴도 물리 설계에 영향을 줄 수 있으므로 트랜잭션을 전혀 고려하지 않는다고 일반화하면 안 된다.
선지별 해설
- 필드 값을 어떤 형태와 크기로 저장할지에 직접 관련된다.
- 길이가 달라지는 필드의 위치와 길이를 해석하는 방식이다.
- 업무 목표를 표현한 요구 산출물이며 저장 레코드의 직접적인 배치 항목이 아니다.
- 필드의 위치와 정렬 요구를 맞추는 물리적 형식의 일부이다.
편집 해설 근거: PostgreSQL 18, Database Page Layout — §66.6 Database Page Layout — Table Row Layout
47. SQL의 기능에 따른 분류 중에서 REVOKE문과 같이 데이터의 사용 권한을 관리하는데 사용하는 언어는?
- DDL(Data Definition Language)
- DML(Data Manipulation Language)
- DCL(Data Control Language)
- DUL(Data User Language)
정답과 해설 보기
정답: 3
정답은 ③이다. 권한 부여와 회수처럼 데이터 접근을 통제하는 SQL을 학습상 DCL로 분류한다. REVOKE는 이미 부여한 권한 등을 회수하며 GRANT는 권한을 부여한다. DDL은 테이블 같은 구조의 정의, DML은 데이터의 조회와 변경을 다룬다. 제품 문서에서 명령을 묶는 체계는 다를 수 있지만 이 문항은 DDL·DML·DCL이라는 기능별 분류를 전제로 하므로 사용 권한 관리는 DCL에 대응한다.
선지별 해설
- 구조와 객체 정의를 다루는 분류이다.
- 행의 조회·삽입·갱신·삭제 등을 다루는 분류이다.
- 사용 권한의 부여·회수를 다루는 데이터 제어 언어이다.
- 이 기능별 SQL 분류에서 사용하는 표준적인 그룹명이 아니다.
편집 해설 근거: PostgreSQL 18, REVOKE — REVOKE — Description; PostgreSQL 18, GRANT — GRANT — Description
48. PostgreSQL 18의 시스템 카탈로그에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 데이터베이스 구조 정보를 테이블 형태로 저장한다.
- 일반 사용자는 별도의 권한이나 제약 없이 카탈로그의 모든 행을 자유롭게 수정할 수 있다.
- 테이블·열·자료형 등의 메타데이터를 관리한다.
- CREATE TABLE 같은 객체 정의 명령을 수행하면 시스템이 관련 카탈로그 정보를 관리한다.
정답과 해설 보기
정답: 2
정답은 ②이다. PostgreSQL의 시스템 카탈로그는 테이블·열·자료형 등 데이터베이스 객체에 관한 메타데이터를 저장한다. 카탈로그도 테이블 형태이지만 일반 사용자가 권한과 제약 없이 마음대로 고칠 수 있다는 뜻은 아니다. 보통 CREATE TABLE 같은 정식 명령을 사용하면 시스템이 필요한 카탈로그 정보를 관리한다. 직접 변경은 일관성을 훼손할 수 있으며 조회 가능 범위도 객체와 접근 권한에 따라 구별해야 한다.
선지별 해설
- 카탈로그는 데이터베이스 구조에 관한 정보를 테이블 형태로 관리한다.
- 카탈로그가 테이블이라는 이유만으로 일반 사용자의 자유로운 수정을 허용하지 않는다.
- 테이블·열·자료형 같은 메타데이터를 저장한다.
- 객체 정의 명령이 관련 카탈로그 정보를 관리하는 정상적인 경로이다.
편집 해설 근거: PostgreSQL 18, Chapter 52 System Catalogs — Chapter 52 System Catalogs — introductory guidance
49. 데이터베이스에서 릴레이션에 대한 설명으로 틀린 것은?
- 모든 튜플은 서로 다른 값을 가지고 있다.
- 하나의 릴레이션에서 튜플은 특정한 순서를 가진다.
- 각 속성은 릴레이션 내에서 유일한 이름을 가진다.
- 모든 속성 값은 원자값(Atomic Value)을 가진다.
정답과 해설 보기
정답: 2
정답은 ②이다. 관계 모델의 릴레이션은 튜플의 집합이므로 튜플을 나열한 순서는 릴레이션의 의미를 바꾸지 않는다. 집합에는 중복 튜플이 없으며 속성은 이름으로 구별한다. 이 문항의 원자값 조건은 전통적인 제1정규형 관계 모델을 전제로 한다. SQL의 테이블이나 조회 결과는 중복을 허용할 수 있고 출력 순서를 보장하려면 ORDER BY가 필요하므로 이론적 릴레이션과 모든 SQL 동작을 동일시하지 않는다.
선지별 해설
- 집합인 릴레이션에는 같은 튜플이 중복해서 포함되지 않는다.
- 튜플의 특정 나열 순서는 릴레이션의 본질적인 속성이 아니다.
- 한 릴레이션에서 속성을 식별할 수 있도록 이름을 구별한다.
- 전통적 제1정규형에서는 각 속성 자리에 도메인의 원자값을 둔다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relational Model — Relations, Relation Instance, Keys; PostgreSQL 18 — SELECT — DISTINCT Clause; ORDER BY Clause
50. 데이터베이스에서의 뷰(View)에 대한 설명으로 틀린 것은?
- 뷰는 다른 뷰를 기반으로 새로운 뷰를 만들 수 있다.
- 뷰는 일종의 가상 테이블이며, update에는 제약이 따른다.
- 뷰는 기본 테이블을 만드는 것처럼 create view를 사용하여 만들 수 있다.
- 뷰는 논리적으로 존재하는 기본 테이블과 다르게 물리적으로 만 존재하며 카탈로그에 저장된다.
정답과 해설 보기
정답: 4
정답은 ④이다. 일반 뷰는 SELECT 등으로 정의한 질의를 통해 보여 주는 가상 테이블이다. 정의 정보는 카탈로그에 저장되지만 일반 뷰 자체가 조회 결과를 물리적으로만 보관하는 테이블은 아니다. 기존 뷰를 참조하여 다른 뷰를 정의할 수도 있다. 갱신 가능성은 정의한 질의와 DBMS 규칙에 따라 제한되며 집계 등이 포함된 뷰는 단순 뷰와 다를 수 있다. 결과를 저장하는 물질화 뷰는 별도 개념이다.
선지별 해설
- 뷰를 참조하는 질의로 다른 뷰를 정의할 수 있다.
- 가상 테이블이며 정의에 따라 갱신 가능성에 제한이 있다.
- CREATE VIEW로 뷰의 이름과 정의 질의를 지정한다.
- 일반 뷰의 정의 저장과 결과 데이터의 물리적 저장을 혼동했다.
편집 해설 근거: PostgreSQL 18 — CREATE VIEW — Description; Updatable Views
51. 트랜잭션의 상태 중 트랜잭션의 마지막 연산이 실행된 직후의 상태로, 모든 연산의 처리는 끝났지만 트랜잭션이 수행한 최종 결과를 데이터베이스에 반영하지 않은 상태는?
- Active
- Partially Committed
- Committed
- Aborted
정답과 해설 보기
정답: 2
정답은 ②이다. 부분 완료 상태는 트랜잭션의 마지막 문장을 실행했지만 성공적인 완료를 확정하는 절차가 아직 끝나지 않은 단계이다. 필요한 변경을 장애에도 견딜 수 있게 보장한 뒤 커밋 상태가 된다. 따라서 마지막 연산의 실행과 커밋을 같은 시점으로 취급하지 않는다. 실제 DBMS에서는 커밋 전에도 버퍼나 저장장치에 일부 데이터가 기록될 수 있으므로 아직 물리적인 쓰기가 전혀 없다는 뜻으로 해석하면 안 된다.
선지별 해설
- 트랜잭션의 연산을 수행하는 중인 활동 상태이다.
- 마지막 연산은 끝났으나 커밋을 확정하기 전의 부분 완료 상태이다.
- 정상적인 완료가 확정된 커밋 상태이다.
- 실패한 작업의 효과를 되돌린 취소 상태이다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 17 저자 자료 — Transaction State — Partially Committed, Committed, Aborted
52. SQL의 명령을 사용 용도에 따라 DDL, DML, DCL로 구분할 경우, 그 성격이 나머지 셋과 다른 것은?
- SELECT
- UPDATE
- INSERT
- GRANT
정답과 해설 보기
정답: 4
정답은 ④이다. DDL·DML·DCL의 세 분류를 사용하는 이 문항에서 SELECT·UPDATE·INSERT는 데이터의 조회 또는 변경을 위한 DML로 묶고 GRANT는 접근 권한을 부여하는 DCL로 묶는다. SELECT를 별도의 DQL로 분리하는 교육 체계도 있지만 지문은 그 분류를 채택하지 않았다. 분류명만 외우기보다 실제로 행을 읽거나 바꾸는 명령인지, 사용자에게 허용할 작업을 정하는 명령인지 확인하면 구별할 수 있다.
선지별 해설
- 지문의 세 분류에서는 데이터 조회를 위한 DML로 다룬다.
- 기존 행의 값을 바꾸는 DML이다.
- 새 행을 추가하는 DML이다.
- 권한을 부여하는 DCL이므로 나머지와 목적이 다르다.
편집 해설 근거: PostgreSQL 18 — SELECT — SELECT — Description; PostgreSQL 18 — UPDATE — UPDATE — Description; PostgreSQL 18 — INSERT — INSERT — Description; PostgreSQL 18, GRANT — GRANT — Description
53. 키의 종류 중 유일성과 최소성을 만족하는 속성 또는 속성들의 집합은?
- Atomic Key
- Super Key
- Candidate Key
- Test Key
정답과 해설 보기
정답: 3
정답은 ③이다. 후보키는 튜플을 유일하게 식별하는 속성 집합 중에서 어떤 속성도 더 제거할 수 없는 최소 슈퍼키이다. 유일성만 만족하면 슈퍼키이고 최소성까지 갖추어야 후보키가 된다. 최소성은 후보키들 가운데 속성 수가 전역적으로 가장 적어야 한다는 뜻이 아니라 해당 집합의 진부분집합 중 슈퍼키가 없어야 한다는 뜻이다. 후보키가 여러 개라면 그중 하나를 기본키로 선택할 수 있다.
선지별 해설
- 유일성과 최소성을 갖는 키의 통상적인 명칭이 아니다.
- 유일성은 보장하지만 불필요한 속성이 포함될 수 있다.
- 유일성과 집합 포함 관계상 최소성을 만족하는 후보키이다.
- 해당 관계 모델의 키 분류 명칭이 아니다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Keys — Superkey, Candidate Key, Primary Key
54. 데이터베이스에서 개념적 설계 단계에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 산출물로 E-R Diagram을 만들 수 있다.
- DBMS에 독립적인 개념 스키마를 설계한다.
- 인덱스 페이지의 물리적 저장 배치를 결정한다.
- 논리적 설계 단계의 앞 단계에서 수행된다.
정답과 해설 보기
정답: 3
정답은 ③이다. 개념적 설계는 개체, 속성, 관계와 제약을 표현하여 현실의 데이터 요구를 개념 스키마로 정리하는 단계이다. ER 다이어그램을 산출물로 사용할 수 있으며 특정 DBMS의 저장 방식과는 독립적으로 표현한다. 인덱스 페이지의 물리적 배치는 구체적인 저장과 접근 경로를 다루는 물리 설계 사항이다. 보통 개념 구조를 정리한 뒤 이를 관계 스키마 같은 논리 구조로 변환한다.
선지별 해설
- 개체와 관계를 나타낸 ER 다이어그램이 개념 설계의 산출물이 될 수 있다.
- 특정 DBMS의 저장 구현에 종속되지 않는 구조를 정리한다.
- 인덱스 페이지의 저장 위치와 배치는 물리 설계 사항이다.
- 일반적인 설계 흐름에서 개념 설계 후 논리 구조로 변환한다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, ER Model — Database Design; Conceptual Design Using the ER Model; Ramakrishnan·Gehrke, Database Management Systems 3판, Physical Database Design — Physical Database Design and Tuning — overview
55. 테이블의 기본키(Primary Key)로 지정된 속성에 관한 설명으로 가장 거리가 먼 것은?
- NOT NULL 제약으로 NULL 값을 가질 수 없다.
- 릴레이션에서 각 튜플을 유일하게 구별할 수 있다.
- 다른 릴레이션의 외래키가 참조할 수 있다.
- 데이터를 검색할 때 반드시 기본키가 필요하다.
정답과 해설 보기
정답: 4
정답은 ④이다. 기본키는 각 행을 유일하게 구별하고 NULL을 허용하지 않는 제약이다. 다른 테이블의 외래키가 참조할 수 있지만 조회가 반드시 기본키 조건으로만 이루어져야 하는 것은 아니다. 이름이나 날짜처럼 다른 열로 검색하거나 조건 없이 전체 행을 조회할 수도 있다. 기본키가 여러 열로 구성되면 그 열의 조합이 유일해야 하며 각 열이 따로따로 모두 유일해야 한다는 뜻은 아니다.
선지별 해설
- 기본키를 이루는 열에는 NULL을 허용하지 않는다.
- 키 값 또는 복합 키의 조합으로 각 행을 유일하게 식별한다.
- 외래키의 참조 대상이 될 수 있다.
- 다른 열이나 조건 없는 조회도 가능하므로 기본키는 필수 검색 조건이 아니다.
편집 해설 근거: PostgreSQL 18 — Constraints — §5.5.4 Primary Keys; §5.5.5 Foreign Keys; PostgreSQL 18 — SELECT — WHERE Clause
56. 데이터 모델의 구성 요소 중 데이터 구조에 따라 개념 세계나 컴퓨터 세계에서 실제로 표현된 값들을 처리하는 작업을 의미하는 것은?
- Relation
- Data Structure
- Constraint
- Operation
정답과 해설 보기
정답: 4
정답은 ④이다. 데이터 모델은 어떤 구조로 자료를 표현하는지, 어떤 조작을 할 수 있는지, 어떤 제약을 만족해야 하는지를 함께 다룬다. 이 중 표현된 값에 조회나 갱신 같은 처리를 수행하는 작업은 연산에 해당한다. 관계는 관계형 모델에서 자료를 표현하는 구조이고 제약은 허용되는 상태나 값의 조건이다. 무엇을 담는가와 그 값으로 무엇을 수행하는가를 구분하면 연산을 선택할 수 있다.
선지별 해설
- 관계형 모델의 자료 구조인 릴레이션을 가리킨다.
- 값을 어떻게 조직하고 표현하는가에 관한 구조이다.
- 허용되는 값과 상태에 대한 제약이다.
- 표현된 데이터에 대해 수행할 처리를 뜻하는 연산이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Introduction — Data Models — structures, operations, integrity constraints
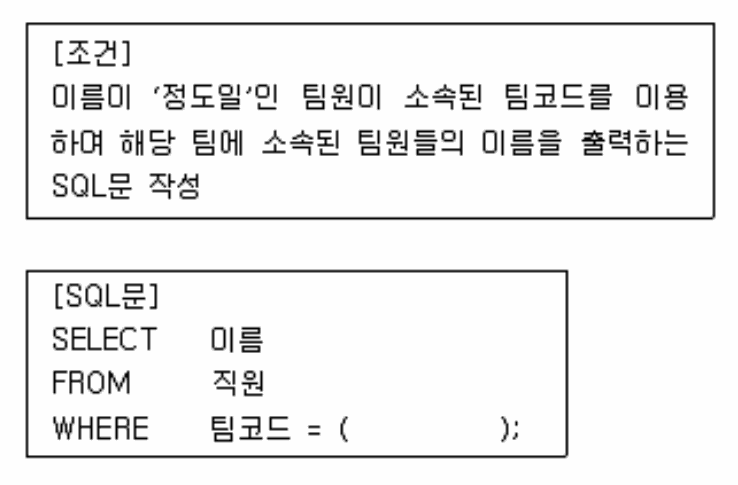
57. 다음 조건에 맞게 같은 팀 직원의 이름을 조회하려 한다. 직원 테이블에는 이름이 '정도일'인 행이 정확히 하나이고 팀코드는 NULL이 아니다. 이미지 SQL의 빈칸에 들어갈 내용은?
[학습용 개정문항]
- WHERE 이름 = '정도일'
- SELECT 팀코드 FROM 이름 WHERE 직원 = '정도일'
- WHERE 직원 = '정도일'
- SELECT 팀코드 FROM 직원 WHERE 이름 = '정도일'
정답과 해설 보기
정답: 4
정답은 ④이다. 안쪽 질의는 직원 테이블에서 이름이 정도일인 한 행의 팀코드를 반환해야 한다. 그 값을 바깥 질의의 팀코드와 비교하면 같은 팀의 직원 이름을 얻는다. 따라서 빈칸은 SELECT 팀코드 FROM 직원 WHERE 이름 = '정도일'이다. 동명이인이 여러 팀에 존재하면 등호와 스칼라 서브쿼리라는 조건이 성립하지 않을 수 있으므로 여기서는 해당 이름의 행이 정확히 하나라고 가정했다. 본인도 같은 팀이므로 결과에 포함된다.
선지별 해설
- 팀코드 값을 반환하는 SELECT 절과 FROM 절이 빠졌다.
- 테이블과 속성의 위치를 바꾸어 적었다.
- 직원은 테이블 이름이며 이름 조건과 팀코드 조회가 없다.
- 이름으로 해당 직원의 팀코드를 구하는 스칼라 서브쿼리이다.
편집 해설 근거: PostgreSQL 18, Value Expressions — Scalar Subqueries — §4.2.11 Scalar Subqueries; PostgreSQL 18 — SELECT — SELECT — Synopsis, WHERE Clause
58. 무결성 제약 조건 중 개체 무결성 제약 조건에 대한 설명으로 옳은 것은?
[학습용 개정문항]
- 각 속성의 값은 정해진 자료형과 허용 범위를 따라야 한다.
- 기본키를 이루는 열은 NULL이 아니어야 하며 기본키 값의 조합은 튜플마다 유일해야 한다.
- 외래키의 NULL이 아닌 값은 참조 대상 키와 대응해야 한다.
- 부모 키를 변경·삭제할 때 참조 중인 자식 행을 어떻게 처리할지 정해야 한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 개체 무결성은 각 튜플을 식별하는 기본키에 NULL을 허용하지 않고 키 값이 중복되지 않도록 하는 조건이다. 복합 기본키라면 구성 열은 NULL이 아니어야 하고 전체 조합이 유일해야 한다. 속성의 허용 값 범위를 지키는 것은 도메인 무결성이고 외래키가 참조 대상과 일치하도록 하는 것은 참조 무결성이다. 기본키가 테이블 전체에서 단 하나의 값만 가져야 한다는 뜻은 아니다.
선지별 해설
- 속성의 자료형과 허용 범위를 지키는 도메인 무결성이다.
- 기본키의 NULL 금지와 튜플 간 유일성이 개체 식별을 보장한다.
- 외래키와 참조 대상의 대응을 다루는 참조 무결성이다.
- 부모 키 변경 시 참조 관계의 처리를 다루는 조건이다.
편집 해설 근거: PostgreSQL 18 — Constraints — §5.5.4 Primary Keys; §5.5.5 Foreign Keys
59. 관계 데이터 모델에서 릴레이션(Relation)에 포함되어 있는 튜플 (Tuple)의 수를 무엇이라고 하는가?
- Degree
- Cardinality
- Attribute
- Cartesian product
정답과 해설 보기
정답: 2
정답은 ②이다. 릴레이션에 현재 들어 있는 튜플의 수를 카디널리티라고 한다. 예를 들어 학생 행이 30개이면 카디널리티는 30이며 이름·학번·학과의 세 속성이 있다면 차수는 3이다. 속성은 열에 해당하는 구성 요소이고 카티션 곱은 두 관계의 튜플을 가능한 모든 쌍으로 결합하는 연산이다. ER 관계의 연결 비율에서도 카디널리티라는 용어를 쓰지만 이 문항은 릴레이션의 튜플 수를 묻는다.
선지별 해설
- 차수는 릴레이션을 구성하는 속성의 수이다.
- 릴레이션에 포함된 튜플 수인 카디널리티이다.
- 속성은 튜플의 값을 구분하는 열에 해당한다.
- 두 관계에서 가능한 모든 튜플 쌍을 만드는 연산이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relation Instance — cardinality and degree; Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — Cross-Product
60. Oracle Database 19c에서 사용자 PARK에게 CREATE TABLE 시스템 권한을 부여하려 한다. 다음 이미지의 GRANT 문 빈칸에 들어갈 내용은?
[학습용 개정문항]
- CREATE TABLE TO
- CREATE TO
- CREATE FROM
- CREATE TABLE FROM
정답과 해설 보기
정답: 1
정답은 ①이다. Oracle Database의 시스템 권한 CREATE TABLE을 사용자 PARK에게 부여하는 문장은 GRANT CREATE TABLE TO PARK이다. 권한명 뒤의 TO는 권한을 받는 사용자나 역할을 지정한다. CREATE만 쓰면 여기서 요구한 시스템 권한명이 완성되지 않고 FROM은 부여 대상 지정에 쓰는 키워드가 아니다. 이 권한 부여만으로 접속 권한이나 테이블스페이스의 저장 할당량까지 모두 확보되는 것은 아니므로 실제 생성 환경의 조건은 따로 확인한다.
선지별 해설
- CREATE TABLE 권한을 TO 뒤의 사용자에게 부여하는 문법이다.
- 부여할 시스템 권한 CREATE TABLE의 TABLE이 빠졌다.
- 권한명도 불완전하고 부여 대상에 FROM을 사용할 수 없다.
- 권한명은 맞지만 대상은 FROM이 아니라 TO로 지정한다.
편집 해설 근거: Oracle Database 19c SQL Language Reference, GRANT — GRANT — System Privileges; CREATE TABLE; grant_system_privileges
정보처리기사 필기 기출문제 · 프로그래밍 언어 활용
61. C 언어 문자열 처리 함수와 기능의 연결로 틀린 것은?
[학습용 개정문항]
- strlen(s) – 문자열 s의 길이를 구한다.
- strcpy(s1, s2) – 문자열 s2를 s1에 복사한다.
- strcmp(s1, s2) – 문자열 s1 뒤에 s2를 연결한다.
- strcat(s1, s2) – 문자열 s1 뒤에 s2를 연결한다.
정답과 해설 보기
정답: 3
정답은 ③이다. strcmp는 두 문자열을 비교하여 첫 번째가 작으면 음수, 같으면 0, 크면 양수인 값을 반환한다. 문자열을 뒤에 이어 붙이는 함수는 strcat이다. strlen은 끝의 널 문자를 제외한 길이를 반환하고 strcpy는 원본의 널 종료 문자열을 목적지로 복사한다. 복사와 연결에서는 목적지 공간이 충분하고 두 영역이 겹치지 않는 등 함수의 전제 조건도 지켜야 하며 비교 결과를 반드시 -1과 1로 한정해서는 안 된다.
선지별 해설
- 끝의 널 문자를 제외한 문자열 길이를 구한다.
- s2의 널 종료 문자열을 s1에 복사한다.
- strcmp는 문자열 비교 함수이며 문자열을 이어 붙이지 않는다.
- strcat은 s1의 뒤에 s2를 이어 붙이는 함수이다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §7.24.2.3 strcpy; §7.24.3.1 strcat; §7.24.4.2 strcmp; §7.24.6.3 strlen
62. 다음 C언어 논리 연산 프로그램이 실행되었을 때 출력되는 값은?
- 0
- 2
- 5
- 14
정답과 해설 보기
정답: 2
정답은 ②이다. C에서 논리 연산의 결과는 참이면 정수 1, 거짓이면 0이다. a=5와 b=3은 모두 0이 아니므로 a && b는 1이고 a || b도 1이다. c=12 역시 참으로 해석되므로 !c는 0이다. 따라서 t1+t2+t3은 1+1+0=2가 된다. 피연산자의 원래 값 5나 3을 그대로 반환하는 연산으로 해석하거나 &&·||를 비트 연산자 &·|와 혼동하면 잘못 계산한다.
선지별 해설
- 논리 AND와 OR가 모두 참인 점을 빠뜨린 값이다.
- t1=1, t2=1, t3=0을 더한 2이다.
- C의 논리 연산 결과는 원래 피연산자 5가 아니라 0 또는 1이다.
- 피연산자 값을 그대로 산술 결합한 결과가 아니다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.3.3 Unary arithmetic operators; §6.5.13 Logical AND; §6.5.14 Logical OR
63. 다음 C 프로그램을 실행하면 출력되는 값은?
#include <stdio.h>
struct st {
    int a;
    int c[10];
};
int main(int argc, char *argv[]) {
    int i = 0;
    struct st ob1;
    struct st ob2;
    ob1.a = 0;
    ob2.a = 0;
    for (i = 0; i < 10; i++) {
        ob1.c[i] = i;
        ob2.c[i] = ob1.c[i] + i;
    }
    for (i = 0; i < 10; i = i + 2) {
        ob1.a = ob1.a + ob1.c[i];
        ob2.a = ob2.a + ob2.c[i];
    }
    printf("%d", ob1.a + ob2.a);
    return 0;
}
[학습용 개정문항]
- 30
- 60
- 80
- 120
정답과 해설 보기
정답: 2
정답은 ②이다. 첫 반복문은 ob1.c[i]에 i를, ob2.c[i]에는 i+i인 2i를 저장한다. 두 번째 반복문의 증가량은 2이므로 누적하는 인덱스는 0,2,4,6,8이다. ob1.a는 이 값들의 합인 20, ob2.a는 두 배인 40이 되고 두 누적값을 더해 60을 출력한다. 배열의 열 칸을 모두 더하는 것이 아니라 두 번째 반복문의 방문 인덱스만 더하며 두 구조체의 a가 0에서 시작한다는 점도 확인한다.
선지별 해설
- 선택한 인덱스들의 합과 두 구조체의 배율을 모두 반영하지 못한다.
- 0+2+4+6+8=20과 그 두 배 40을 더한 60이다.
- 첫 구조체와 두 번째 구조체의 누적식을 다시 구별해야 한다.
- 증가량 2에 따른 방문 원소와 누적값을 중복 계산한 값이다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.2.1 Array subscripting; §6.5.2.3 Structure members; §6.8.5.3 The for statement
64. IPv4 헤더의 필드에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- IHL은 헤더 길이를 32비트 워드 단위로 나타낸다.
- Total Length는 헤더를 제외한 패킷 길이이며 최대값은 2의 32제곱에서 1을 뺀 비트 수이다.
- TTL은 발신자가 설정하며 경유 라우터에서 감소하는 생존 한계이다.
- Version은 IP 프로토콜의 버전을 나타낸다.
정답과 해설 보기
정답: 2
정답은 ②이다. IPv4의 Total Length는 헤더를 포함한 데이터그램 전체 길이를 옥텟 단위로 나타내는 16비트 필드이므로 최대값은 65,535옥텟이다. 헤더를 제외하거나 2의 32제곱에 근거한 비트 단위로 설명한 것은 틀리다. IHL은 32비트 워드 단위의 헤더 길이이고 Version은 버전을 나타낸다. TTL은 경유 과정에서 감소하여 데이터그램이 네트워크를 무한히 도는 것을 제한한다.
선지별 해설
- IHL은 IPv4 헤더 길이를 32비트 워드 단위로 나타낸다.
- Total Length는 헤더 포함 전체 길이이며 16비트 옥텟 수이다.
- 발신자가 설정한 TTL은 경유 라우터에서 감소한다.
- Version 필드는 IP 판본을 구별한다.
편집 해설 근거: IETF RFC 791 (1981), Internet Protocol — §3.1 Internet Header Format — IHL, Total Length, Time to Live, Version; IETF RFC 1812, Requirements for IP Version 4 Routers (1995) — §5.3.1 Time to Live
65. 다음 Python 프로그램의 실행 결과가 [실행결과]와 같을 때, 빈칸에 적합한 것은?
- either
- elif
- elseif
- else
정답과 해설 보기
정답: 2
정답은 ②이다. Python에서 if 다음에 조건을 더 검사하는 절은 elif로 작성한다. x=20이므로 첫 조건 x==10은 거짓이고 elif x==20은 참이 되어 문자열 20을 출력한다. 조건을 쓰지 않는 마지막 기본 분기는 else이다. either나 elseif는 Python의 해당 문법 키워드가 아니며 else 뒤에 x==20이라는 조건을 붙일 수도 없다. 이 문제는 들여쓰기와 콜론도 함께 유지해야 하는 조건문 문법을 묻는다.
선지별 해설
- Python 조건 분기의 키워드가 아니므로 이 위치에 사용할 수 없다.
- 앞 조건이 거짓일 때 추가 조건을 검사하는 elif가 맞다.
- Python은 elseif 대신 elif라는 한 단어를 사용한다.
- else 뒤에는 이와 같은 조건식을 붙일 수 없다.
편집 해설 근거: Python 3.14 Language Reference, 8.1 The if statement — §8.1 The if statement
66. RIP 라우팅 프로토콜에 대한 설명으로 틀린 것은?
- 경로 선택 메트리은 홉 카운트(Hop count)이다.
- 라우팅 프로토콜을 IGP와 EGP로 분류했을 때 EGP에 해당한다.
- 최단 경로 탐색에 Bellman-Ford 알고리즘을 사용한다.
- 각 라우터는 이웃 라우터들로부터 수신한 정보를 이용하여 라우팅 표를 갱신한다.
정답과 해설 보기
정답: 2
정답은 ②이다. RIP는 한 자율 시스템 안에서 경로 정보를 교환하는 내부 게이트웨이 프로토콜인 IGP이다. 거리 벡터 방식으로 이웃이 알려 준 경로 정보를 갱신하고 전통적으로 홉 수를 경로 비용으로 사용한다. Bellman-Ford 계열의 갱신 원리를 따르며 RIP에서 16은 도달 불가능을 뜻해 사용할 수 있는 홉 수에 한계가 있다. 자율 시스템 사이의 외부 라우팅 프로토콜인 EGP로 분류하면 틀리다.
선지별 해설
- 기본적인 경로 거리 메트릭으로 홉 수를 사용한다.
- RIP는 EGP가 아니라 IGP이다.
- 거리 벡터의 Bellman-Ford 원리에 따라 경로를 갱신한다.
- 이웃으로부터 받은 경로 정보를 자신의 거리와 결합한다.
편집 해설 근거: IETF RFC 2453, RIP Version 2 (1998) — §1 Introduction; §3.1 Bellman-Ford Algorithm; §3.2 Limitations
67. 다음에서 설명하는 프로세스 스케줄링은?
- FIFO 스케줄링
- RR 스케줄링
- HRN 스케줄링
- MQ스케줄링
정답과 해설 보기
정답: 3
정답은 ③이다. 제시된 비율은 (대기시간+서비스시간)/서비스시간이며 HRN 또는 HRRN에서 응답률이라 부르는 우선순위 값이다. 실행할 작업을 고를 때 이 값이 가장 큰 작업을 선택하는 비선점 방식이다. 같은 서비스시간이라면 오래 기다릴수록 비율이 커지므로 짧은 작업만 계속 우대하는 SJF의 기아 문제를 완화한다. FIFO는 도착 순서, RR은 시간 할당량, 다단계 큐는 여러 준비 큐의 구성을 중심으로 한다.
선지별 해설
- 도착 순서대로 실행하는 방식이며 제시된 응답률을 계산하지 않는다.
- 시간 할당량을 나누어 순환 실행하는 방식이다.
- 대기시간과 서비스시간으로 응답률을 구하는 HRN이다.
- 준비 큐를 여러 수준으로 나누는 방식이며 지문의 단일 응답률과 다르다.
편집 해설 근거: Virginia Tech CS3204, Scheduling Analysis (2005) — Highest Response Ratio Next
68. UNIX 운영체제에 관한 특징으로 틀린 것은?
- 하나 이상의 작업에 대하여 백그라운드에서 수행이 가능하다.
- Multi-User는 지원하지만 Multi-Tasking은 지원하지 않는다.
- 트리 구조의 파일 시스템을 갖는다.
- 이식성이 높으며 장치 간의 호환성이 높다.
정답과 해설 보기
정답: 2
정답은 ②이다. UNIX는 여러 사용자가 이용하고 여러 프로세스가 번갈아 실행되는 다중 사용자·다중 작업 환경을 제공한다. 따라서 다중 작업을 지원하지 않는다는 설명은 틀리다. 셸에서 작업을 백그라운드로 실행할 수 있고 파일 이름 공간은 디렉터리 계층을 통해 조직된다. 이식성은 구현과 인터페이스의 설계가 다른 환경으로의 이전을 돕는다는 뜻이며 모든 하드웨어가 추가 작업 없이 호환된다는 보장은 아니다.
선지별 해설
- 셸은 작업을 백그라운드에서 수행하도록 요청할 수 있다.
- UNIX는 다중 사용자와 다중 작업을 함께 지원한다.
- 루트 아래 디렉터리 계층으로 파일 이름 공간을 구성한다.
- 이식성을 고려한 설계라는 특징이며 모든 장치의 무조건적 호환을 뜻하지 않는다.
편집 해설 근거: Ritchie·Thompson, The UNIX Time-Sharing System (1978 개정본) — Introduction; The File System; Processes and Images; POSIX.1-2024 Issue 8, Shell Command Language — Asynchronous Lists
69. UDP 프로토콜의 특징이 아닌 것은?
- 비연결형 서비스를 제공한다.
- 단순한 헤더 구조로 오버헤드가 적다.
- 주로 주소를 지정하고, 경로를 설정하는 기능을 한다.
- TCP와 같이 트랜스포트 계층에 존재한다.
정답과 해설 보기
정답: 3
정답은 ③이다. UDP는 IP 위에서 포트 번호를 이용해 응용 사이에 데이터그램을 전달하는 비연결형 전송 계층 프로토콜이다. 헤더가 8옥텟으로 단순하고 연결 설정이나 전송 순서·재전송의 보장을 직접 제공하지 않는다. 네트워크 주소에 따라 패킷을 전달하고 경로를 선택하는 일은 주로 IP와 라우팅 계층의 역할이다. UDP가 IP 주소를 이용한다고 해서 UDP 자체가 경로 설정 프로토콜이 되는 것은 아니다.
선지별 해설
- 데이터그램마다 전달하며 연결 설정 절차를 전제로 하지 않는다.
- 8옥텟의 단순한 기본 헤더를 사용한다.
- 네트워크 주소와 경로 선택을 UDP의 주기능으로 설명한 것은 틀리다.
- TCP와 함께 전송 계층의 프로토콜로 분류된다.
편집 해설 근거: IETF RFC 768, User Datagram Protocol (1980) — Introduction; Format; User Interface; IP Interface; IETF RFC 791 (1981), Internet Protocol — §1.2 Scope; §1.4 Operation
70. Python 데이터 타입 중 시퀀스(Sequence) 데이터 타입에 해당하며 다양한 데이터 타입들을 주어진 순서에 따라 저장할 수 있으나 저장된 내용을 변경할 수 없는 것은?
- 복소수(complex) 타입
- 리스트(list) 타입
- 사전(dict) 타입
- -튜플(tuple) 타입
정답과 해설 보기
정답: 4
정답은 ④이다. 튜플은 여러 객체를 순서대로 담는 불변 시퀀스이다. 원소를 새 값으로 바꾸거나 길이를 변경할 수 없으며 다양한 타입의 객체를 함께 참조할 수 있다. 리스트는 가변 시퀀스이고 사전은 키와 값을 대응하는 매핑, 복소수는 수치 타입이다. 불변이라는 말은 튜플 내부의 참조 배치를 바꿀 수 없다는 뜻이다. 튜플이 참조하는 리스트 같은 가변 객체의 내부 내용까지 자동으로 불변이 되는 것은 아니다.
선지별 해설
- 복소수 값을 표현하는 수치 타입이다.
- 순서가 있지만 원소 교체와 추가·삭제가 가능한 가변 시퀀스이다.
- 키와 값을 대응하는 매핑이며 불변 시퀀스가 아니다.
- 순서가 있는 불변 시퀀스인 튜플이다.
편집 해설 근거: Python 3.14, Built-in Types — Sequence Types — list, tuple, range; Tuples
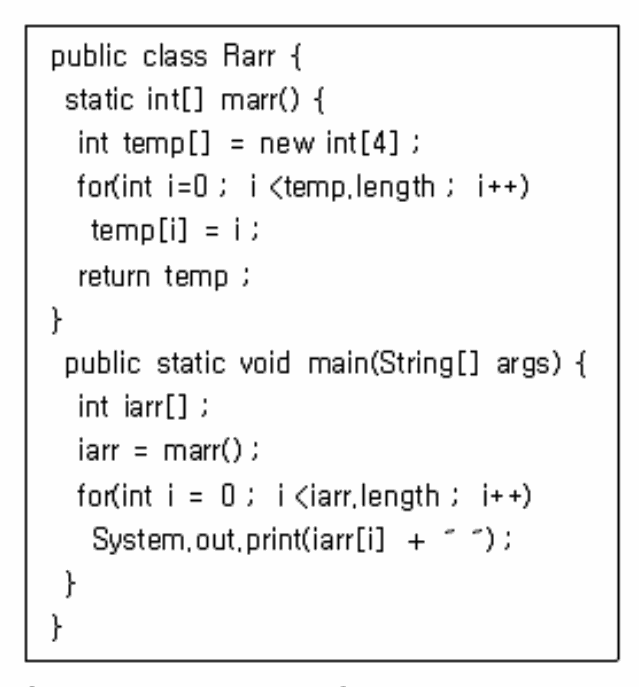
71. 다음 JAVA 프로그램이 실행되었을 때, 실행결과는?
- 1 2 3 4
- 0 1 2 3
- 1 2 3
- 0 1 2
정답과 해설 보기
정답: 2
정답은 ②이다. marr 메서드는 길이가 4인 int 배열을 만들고 i가 0,1,2,3일 때 각 위치에 i를 저장한다. 반환한 배열 참조가 iarr에 대입되고 두 번째 반복문도 길이 미만의 인덱스를 차례로 출력한다. 따라서 표시되는 값은 0 1 2 3이다. 배열 길이는 원소 수이며 마지막 인덱스는 길이에서 1을 뺀 값이다. print가 각 값 뒤에 공백을 덧붙이므로 실제 출력 끝에도 공백이 하나 있지만 값의 순서는 선택지와 같다.
선지별 해설
- 반복 인덱스는 1이 아니라 0에서 시작한다.
- 네 원소 0,1,2,3을 순서대로 출력한다.
- 0번 원소도 출력하며 전체 원소 수는 네 개이다.
- 마지막 인덱스 3도 길이 4보다 작으므로 출력한다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 15 Expressions — §15.10.1 Array Creation Expressions; §15.10.3 Array Access Expressions; Oracle Java SE 17 Language Specification, Chapter 14 Blocks and Statements — §14.14.1 The basic for Statement
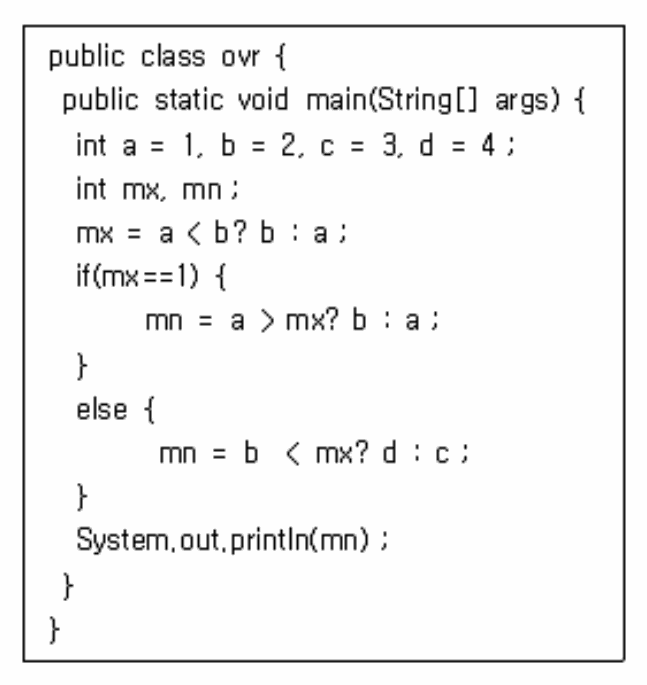
72. 다음 JAVA 프로그램이 실행되었을 때의 결과는?
- 1
- 2
- 3
- 4
정답과 해설 보기
정답: 3
정답은 ③이다. 처음 조건식 a<b는 1<2이므로 참이고 mx에는 b의 값 2가 대입된다. mx==1은 거짓이어서 else 부분을 실행한다. 여기서 b<mx는 2<2로 거짓이므로 조건 연산자는 d 대신 c를 선택하고 mn=3이 된다. 마지막 println은 3을 출력한다. 변수 이름 mx와 mn이 최댓값·최솟값을 암시하더라도 실제 수행은 작성된 조건식과 분기에 따라 결정된다.
선지별 해설
- else로 진행하므로 a의 값 1을 선택하지 않는다.
- 2는 중간 변수 mx의 값이며 마지막에 출력하는 mn의 값은 아니다.
- b<mx가 거짓이므로 c의 값 3을 선택한다.
- d=4는 b<mx가 참일 때 선택되지만 여기서는 거짓이다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 15 Expressions — §15.20.1 Numerical Comparison Operators; §15.25 Conditional Operator; Oracle Java SE 17 Language Specification, Chapter 14 Blocks and Statements — §14.9 The if Statement
73. 다음 중 Myers가 구분한 응집도(Cohesion)에서 가장 낮은 응집도를 갖는 단계는?
- 순차적 응집도(Sequential Cohesion)
- 기능적 응집도(Functional Cohesion)
- 시간적 응집도(Temporal Cohesion)
- 우연적 응집도(Coincidental Cohesion)
정답과 해설 보기
정답: 4
정답은 ④이다. 우연적 응집도는 모듈 안의 요소들이 뚜렷한 공통 목적이나 관계 없이 우연히 모인 경우로 가장 낮게 평가한다. 시간적 응집도는 같은 시기에 수행한다는 이유로, 순차적 응집도는 앞 처리의 출력이 뒤 처리의 입력이 된다는 이유로 요소가 모인다. 기능적 응집도는 하나의 명확한 기능을 수행하도록 요소들이 협력한다. 응집도는 한 모듈 내부의 관련성을 평가하며 모듈 사이의 의존인 결합도와 다르다.
선지별 해설
- 앞 처리의 결과를 뒤 처리에서 사용하는 관계가 존재한다.
- 하나의 명확한 기능에 구성 요소들이 집중하는 높은 응집도이다.
- 같은 실행 시점이라는 공통점으로 묶인 경우이다.
- 요소 사이의 의미 있는 관련성이 거의 없는 가장 낮은 단계이다.
편집 해설 근거: Lethbridge·Laganière, Object-Oriented Software Engineering, Chapter 9 (2001), 저자 강의 자료 — Cohesion — coincidental, temporal, sequential, functional
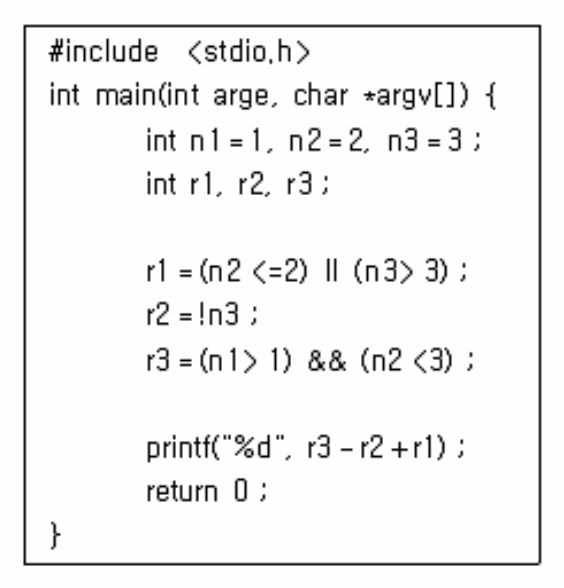
74. 다음 C언어 논리식 계산 프로그램이 실행되었을 때 출력되는 값은?
- 0
- 1
- 2
- 3
정답과 해설 보기
정답: 2
정답은 ②이다. n2<=2는 2<=2로 참이므로 r1은 1이다. n3=3은 0이 아닌 값이므로 논리 부정 !n3의 결과 r2는 0이다. n1>1은 1>1로 거짓이므로 AND 식의 r3도 0이다. 마지막 식 r3-r2+r1은 0-0+1=1이 된다. ||와 &&는 필요한 경우 오른쪽 피연산자의 평가를 생략하며 결과를 0 또는 1로 만들므로 일반 산술합이나 비트 연산처럼 계산하지 않는다.
선지별 해설
- 참인 첫 OR 식의 결과 1을 빠뜨린 값이다.
- r3=0, r2=0, r1=1이므로 최종 출력은 1이다.
- 논리식의 결과와 최종 뺄셈·덧셈 순서를 다시 적용해야 한다.
- 초기값 3을 출력하는 것이 아니라 논리 결과들을 계산한다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.3.3; §6.5.13; §6.5.14
75. IPv4 프로토콜의 주요 특징에 해당하지 않는 것은?
[학습용 개정문항]
- 체크섬(Checksum) 기능으로 데이터 체크성(Data Checksum) 만 제공한다.
- 패킷을 분할, 병합하는 기능을 수행하기도 한다.
- 비연결형 서비스를 제공한다.
- Best Effort 원칙에 따른 전송 기능을 제공한다.
정답과 해설 보기
정답: 1
정답은 ①이다. IPv4 헤더 체크섬은 헤더만을 대상으로 오류를 검사하며 페이로드 전체의 무결성을 제공하지 않는다. IP는 연결을 미리 설정하지 않는 최선형 전달 서비스이므로 도착·순서·중복 방지를 직접 보장하지 않는다. IPv4에서는 필요 조건에 따라 단편화와 재조립을 수행할 수 있다. IPv6 기본 헤더에는 같은 헤더 체크섬이 없으므로 여기서는 IPv4로 판본을 명시하여 기능을 비교한다.
선지별 해설
- IPv4 체크섬은 헤더를 검사하며 사용자 데이터만 검사하는 기능이 아니다.
- IPv4는 단편화와 목적지의 재조립을 지원한다.
- 전달 전에 종단 간 연결을 설정하는 절차를 요구하지 않는다.
- 도착을 보장하지 않는 최선형 전달을 제공한다.
편집 해설 근거: IETF RFC 791 (1981), Internet Protocol — §1.4 Operation; §3.1 Header Checksum, Fragmentation; §3.2 Discussion
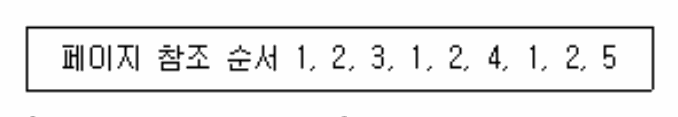
76. 4개의 페이지를 수용할 수 있는 주기억장치가 있으며, 초기 에는 모두 비어 있다고 가정한다. 다음의 순서로 페이지 참 조가 발생할 때, LRU 페이지 교체 알고리즘을 사용할 경우 몇 번의 페이지 결함이 발생하는가?
- 5회
- 6회
- 7회
- 8회
정답과 해설 보기
정답: 1
정답은 ①이다. 참조열은 1,2,3,1,2,4,1,2,5이고 프레임은 네 개이다. 처음 1,2,3에서 세 번 결함이 나고 다시 등장한 1,2는 적중한다. 4를 처음 읽을 때 네 번째 결함이 나며 이어지는 1,2는 다시 적중한다. 마지막 5에서 다섯 번째 결함이 발생하고 가장 오래 사용하지 않은 3을 교체한다. 빈 프레임을 채우는 최초 참조도 페이지 결함에 포함하며 적중할 때도 최근 사용 순서를 갱신한다.
선지별 해설
- 1·2·3·4·5의 최초 참조에서 모두 다섯 번 결함이 발생한다.
- 이미 메모리에 있는 1이나 2의 적중을 결함으로 더하면 안 된다.
- 프레임에 존재하는 반복 참조는 추가 결함을 만들지 않는다.
- 아홉 참조 중 네 번은 적중하므로 여덟 번이 아니다.
편집 해설 근거: Arpaci-Dusseau, OSTEP, 22 Beyond Physical Memory: Policies (2025 개정 표시본) — §22.5 Using History — LRU
77. 여러 사용자 수준 스레드를 하나의 커널 실행 단위에 대응시키는 다대일 모형에서, 사용자 공간의 스레드 관리가 가지는 장점은?
[학습용 개정문항]
- 한 스레드가 시스템 호출로 대기해도 같은 프로세스의 모든 스레드가 항상 계속 실행된다.
- 여러 사용자 수준 스레드가 커널 시스템 호출을 동시에 수행할 수 있다.
- 커널이 각 사용자 수준 스레드를 독립적으로 스케줄링한다.
- 커널 모드로 전환하지 않고 스레드를 교환할 수 있어 오버헤드가 작다.
정답과 해설 보기
정답: 4
정답은 ④이다. 여러 사용자 스레드를 하나의 커널 실행 단위 위에서 관리하는 다대일 모형에서는 사용자 공간 라이브러리가 스레드 전환을 처리할 수 있다. 매번 커널 모드로 들어갈 필요가 없어 전환 비용을 줄일 수 있다. 반면 커널이 각 사용자 스레드를 별도로 스케줄링하지 않으며 한 스레드의 블로킹 시스템 호출이 전체 실행을 멈출 수 있다. 다대다나 일대일 모형까지 같은 제한을 무조건 적용하지 않도록 지문에서 모형을 고정했다.
선지별 해설
- 다대일에서는 블로킹 시스템 호출로 전체 실행 단위가 대기할 수 있다.
- 하나의 커널 실행 단위를 공유하므로 동시에 여러 커널 호출을 수행하는 장점이 아니다.
- 커널은 개별 사용자 스레드를 독립된 스케줄링 단위로 인식하지 않는다.
- 사용자 공간에서 전환하므로 커널 진입 비용을 피할 수 있다.
편집 해설 근거: University of Illinois Chicago, Operating Systems Course Notes, Threads — §4.3 Multithreading Models — Many-to-One
78. 한 모듈이 다른 모듈의 내부 기능 및 그 내부 자료를 참조하는 경우의 결합도는?
- 내용 결합도(Content Coupling)
- 제어 결합도(Control Coupling)
- 공통 결합도(CorⅧ11이1 Coupling)
- 스탬프 결합도(Stamp Coupling)
정답과 해설 보기
정답: 1
정답은 ①이다. 내용 결합은 한 모듈이 다른 모듈의 내부 자료나 구현 내용에 직접 의존하는 경우이다. 내부 코드를 바꾸면 외부의 의존 모듈까지 쉽게 영향을 받으므로 모듈의 독립성을 해친다. 제어 결합은 상대 처리의 분기를 정하는 제어 정보를 전달하는 경우, 공통 결합은 전역 자료를 공유하는 경우, 스탬프 결합은 구조 전체를 전달하면서 일부 필드를 사용하는 경우로 구별한다.
선지별 해설
- 다른 모듈의 내부 구현과 자료에 직접 의존하는 내용 결합이다.
- 호출받은 모듈의 처리 방향을 제어하는 값을 전달하는 경우이다.
- 모듈들이 공통의 전역 자료를 공유하는 경우이다.
- 자료 구조 전체를 전달하되 일부 요소만 이용하는 구조적 의존이다.
편집 해설 근거: CMU SEI, Candidate Complexity Metrics (2016), Appendix A.6 — Appendix A.6 Coupling
79. 추상적인 바이트 주소 모형에서 int 배열 a = [14, 22, 30, 38]이 연속 배치되어 있다. a[0]의 시작 주소는 10이고 int 하나의 크기는 4바이트이다. a[2]와 a[0]의 시작 주소를 차례로 나열한 것은?
[학습용 개정문항]
- 10, 18
- 22, 14
- 18, 10
- 30, 14
정답과 해설 보기
정답: 3
정답은 ③이다. 바이트 주소 모형에서 배열 원소는 연속으로 배치되므로 a[i]의 주소는 시작 주소에 i×원소 크기를 더한 값이다. 시작 주소가 10이고 int가 4바이트이면 a[2]의 주소는 10+2×4=18이며 a[0]의 주소는 그대로 10이다. 이는 추상적인 주소 계산이며 실제 C 실행에서 포인터를 %u로 출력한 결과를 예측하는 문제가 아니다. 원소 값 14·22·30·38과 해당 원소의 주소를 구별해야 한다.
선지별 해설
- 두 주소의 순서를 반대로 적었다.
- 배열 원소의 값이나 인덱스를 주소 증가량과 혼동한 값이다.
- a[2]는 10+8=18이고 a[0]은 10이다.
- 30과 14는 원소의 값이며 추상 주소 계산 결과가 아니다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.2.5 Types — array type; §6.5.6 Additive operators; §7.21.6.1 fprintf
80. 모듈화(Modularity)와 관련한 설명으로 틀린 것은?
- 시스템을 모듈로 분할하면 각각의 모듈을 별개로 만들고 수정할 수 있기 때문에 좋은 구조가 된다.
- 응집도는 모듈과 모듈 사이의 상호의존 또는 연관 정도를 의미한다.
- 모듈 간의 결합도가 약해야 독립적인 모듈이 될 수 있다.
- 모듈 내 구성 요소들 간의 응집도가 강해야 좋은 모듈 설계이다.
정답과 해설 보기
정답: 2
정답은 ②이다. 응집도는 한 모듈 내부의 구성 요소들이 같은 목적을 위해 얼마나 밀접하게 관련되는지를 나타낸다. 모듈 사이의 상호 의존은 결합도이므로 두 용어를 뒤바꾼 설명이 틀리다. 일반적으로 내부 책임이 명확한 높은 응집도와 외부 의존이 적은 낮은 결합도를 지향한다. 단순히 모듈의 개수만 늘리는 것으로 좋은 구조가 보장되지는 않으며 적절한 책임과 인터페이스 경계를 함께 설계해야 한다.
선지별 해설
- 적절한 책임으로 나누면 각 부분의 개발과 수정이 쉬워질 수 있다.
- 모듈 사이의 의존은 결합도이며 응집도는 내부 관련성이다.
- 외부 의존을 줄이면 변경의 파급을 제한하기 쉽다.
- 구성 요소가 한 책임에 집중하면 응집도가 높아진다.
편집 해설 근거: CMU SEI, Candidate Complexity Metrics (2016), Appendix A.6 — Appendix A.6 Coupling; Lethbridge·Laganière, Object-Oriented Software Engineering, Chapter 9 (2001), 저자 강의 자료 — Cohesion and Coupling
정보처리기사 필기 기출문제 · 정보시스템 구축관리
81. 소프트웨어 개발에서 정보보안 3요소에 해당하지 않는 설명은?
- 기밀성 : 인가된 사용자에 대해서만 자원 접근이 가능하다.
- 무결성 : 인가된 사용자에 대해서만 자원 수정이 가능하며 전송 중인 정보는 수정되지 않는다.
- 가용성 : 인가된 사용자는 가지고 있는 권한 범위 내에서 언제든 자원 접근이 가능하다.
- 휘발성 : 인가된 사용자가 수행한 데이터는 처리 완료 즉시 폐기 되어야 한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 정보보안의 기본 세 요소는 기밀성, 무결성, 가용성이다. 기밀성은 허가되지 않은 공개를 막는 것, 무결성은 부적절한 변경과 파괴를 막는 것, 가용성은 필요한 때 신뢰할 수 있게 접근하고 사용하는 것을 뜻한다. 처리 완료 즉시 데이터를 폐기해야 한다는 휘발성은 이 세 요소에 포함되지 않는다. 적법한 보관이나 변경도 필요할 수 있으므로 무결성을 모든 변경의 금지로, 가용성을 무제한 접근 권한으로 해석하지 않는다.
선지별 해설
- 허가된 범위에서만 정보를 공개·이용하게 하는 기밀성의 취지이다.
- 허가되지 않거나 부적절한 변경을 막는 무결성의 취지이다.
- 필요한 때 허용된 서비스를 이용할 수 있게 하는 가용성의 취지이다.
- 즉시 폐기라는 조건은 CIA 세 요소의 구성 개념이 아니다.
편집 해설 근거: NIST FIPS 199 — §2 Information and Information Systems Security Objectives
82. 어떤 외부 컴퓨터가 접속되면 접속 인가 여부를 점검해서 인가된 경우에는 접속이 허용되고, 그 반대의 경우에는 거부할 수 있는 접근제어 유틸리티는?
- tcp wrapper
- trace checker
- token finder
- change detector
정답과 해설 보기
정답: 1
정답은 ①이다. TCP Wrappers는 tcpd와 접근 제어 규칙 등을 이용해 지원되는 네트워크 서비스에 대한 접속을 허용하거나 거부한다. 전통적인 구성에서는 요청한 호스트 정보를 규칙과 대조하고 접속을 기록할 수 있다. 모든 프로그램이나 현대 운영체제가 이 기능을 자동으로 사용하는 것은 아니며 해당 서비스의 연동 지원이 필요하다. 이 문항은 호스트 기반 접근 제어 유틸리티를 식별하는 문제이며 방화벽 전체를 대체한다는 의미는 아니다.
선지별 해설
- tcpd와 호스트 접근 규칙으로 지원 서비스의 접속을 통제하는 도구이다.
- 제시된 TCP Wrappers의 정식 도구명이 아니다.
- 토큰 검색이라는 표현은 해당 호스트 접근 제어 유틸리티와 다르다.
- 변경 탐지와 접속 허가 여부의 규칙 판정은 다른 기능이다.
편집 해설 근거: Debian tcpd(8) package manual — tcpd(8) — DESCRIPTION; ACCESS CONTROL
83. 기기를 키오스크에 가까이 대면 10cm 이내에서 기가급 속도로 대용량 데이터를 전송할 수 있는 초고속 근접 무선통신 기술은?
- BcN(Broadband Convergence Network)
- Zing
- Marine Navi
- C-V2X(Cellular Vehicle-to-Everything)
정답과 해설 보기
정답: 2
정답은 ②이다. Zing은 ETRI가 소개한 초고속 근접 무선통신 기술로 가까운 거리에서 대용량 데이터를 빠르게 전달하는 사용 장면을 제시했다. 키오스크에 기기를 가까이 대어 콘텐츠를 받는다는 조건이 그 사례와 맞는다. BcN은 광대역 통합망, C-V2X는 차량과 주변 주체의 통신이라는 다른 범위를 다룬다. 제시된 거리와 속도는 해당 기술 소개의 조건이며 모든 기기와 환경에서 보장되는 무선 성능으로 일반화하지 않는다.
선지별 해설
- 광대역 통합망을 가리키며 제시된 근접 콘텐츠 전송 기술명이 아니다.
- ETRI가 소개한 기가급 초고속 근접 무선통신 Zing이다.
- 해양 항해 관련 명칭으로 제시된 통신 기술과 다르다.
- 차량과 다른 차량·인프라 등의 통신에 관한 기술이다.
편집 해설 근거: ETRI Webzine Vol.72, 초고속 근접 무선통신 Zing (2016-11) — ETRI Webzine Vol.72, Special — 초고속 근접 무선통신
84. 다음 중 운영체제·응용 소프트웨어의 권한이나 구성 설정보다 물리적 시설 보안에 해당하는 것은?
[학습용 개정문항]
- 서버 관리실 출입 통제
- 실행 프로세스 권한 설정
- 운영체제의 접근 제한
- 운영체제의 정보 수집 제한
정답과 해설 보기
정답: 1
정답은 ①이다. 서버실 출입 통제는 사람이 장비와 시설에 물리적으로 접근하는 것을 제한하는 보안 대책이다. 실행 프로세스의 권한, 운영체제의 접근 설정, 노출 정보의 제한은 소프트웨어와 운영체제의 구성·권한을 조정하는 대책에 해당한다. 물리 보안도 취약점과 위험 관리에서 중요하지만 설정 대상이 다르다. 서버의 보안을 실제로 확보하려면 시설 보호와 시스템 설정을 함께 적용해야 한다.
선지별 해설
- 시설과 장비에 대한 사람의 접근을 통제하는 물리 보안이다.
- 프로세스가 할 수 있는 작업을 제한하는 소프트웨어 권한 설정이다.
- 계정과 주체의 시스템 접근을 제한하는 운영체제 설정이다.
- 불필요한 시스템 정보의 노출을 줄이는 소프트웨어 설정이다.
편집 해설 근거: NIST SP 800-123 — General Server Security — §4 Securing the Server Operating System; §5 Securing the Server Software
85. 소프트웨어 개발 프레임워크와 관련한 설명으로 가장 적절하지 않은 것은?
[학습용 개정문항]
- 공통 구조와 서비스를 제공하여 도메인별 응용 개발에서 재사용을 돕는다.
- 라이브러리와 달리 사용자 코드가 프레임워크를 호출하며 전체 제어 흐름도 항상 사용자 코드가 가진다.
- 반복되는 설계 구조와 컴포넌트 협력 방식을 공통 기반으로 제공할 수 있다.
- 프레임워크가 필요한 시점에 사용자 코드를 호출하는 구조를 제어의 역전으로 설명할 수 있다.
정답과 해설 보기
정답: 2
정답은 ②이다. 프레임워크는 재사용 가능한 구조와 확장 지점을 제공하고 실행 중 필요한 시점에 응용의 코드를 호출하는 형태를 취할 수 있다. 응용이 전체 흐름을 직접 지휘하며 라이브러리 함수만 호출하는 형태와 구별되는 이 특징을 제어의 역전이라고 한다. 프레임워크의 API를 사용자 코드가 호출하는 경우도 있지만 전체 제어를 항상 사용자 코드가 가진다는 일반화는 맞지 않는다. 재사용 효과가 특정 성능의 무조건적 보장인 것도 아니다.
선지별 해설
- 공통 구조와 서비스를 재사용하여 응용 개발을 돕는다.
- 사용자 코드가 전체 제어를 항상 보유한다는 설명은 프레임워크의 대표 특성과 반대이다.
- 반복되는 구조와 협력을 공통 기반으로 구현해 제공할 수 있다.
- 프레임워크가 확장된 응용 코드를 호출하는 제어의 역전을 설명한다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — Frameworks versus Class Libraries; Inversion of Control
86. 클라우드 기반 HSM(Cloud-based Hardware Security Module)에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 클라우드 데이터센터의 전용 하드웨어에서 암호화 키와 관련 연산을 보호한다.
- 인증된 클라이언트가 소프트웨어 인터페이스를 통해 암호 기능을 이용할 수 있다.
- 키의 생성·저장·사용을 하드웨어 보안 모듈에서 관리하도록 구성할 수 있다.
- 하드웨어 없이 소프트웨어만으로 구현되므로 하드웨어 보안 모듈의 보호를 제공하지 않는다.
정답과 해설 보기
정답: 4
정답은 ④이다. 클라우드 HSM은 클라우드에서 제공하는 하드웨어 보안 모듈로 키 생성·보호와 암호 연산을 전용 하드웨어 안에서 수행하도록 돕는다. 사용자는 인증된 소프트웨어 인터페이스로 그 기능을 이용한다. 클라우드 서비스라는 이유로 하드웨어가 사라지거나 소프트웨어만으로 구현된 모듈이 되는 것은 아니다. 키의 반출 가능 여부, 복제와 백업 조건은 제품과 키 속성에 따라 다르므로 모든 키가 절대로 반출되지 않는다고 단정하지 않는다.
선지별 해설
- 전용 하드웨어에서 암호 키와 관련 연산을 보호하는 서비스이다.
- 허가된 클라이언트는 제공되는 API와 라이브러리로 암호 기능을 사용할 수 있다.
- 운영 정책에 따라 키의 생성·저장·사용을 하드웨어 모듈에서 관리한다.
- HSM은 하드웨어 보안 모듈이며 클라우드라는 이유로 소프트웨어만으로 바뀌지 않는다.
편집 해설 근거: AWS CloudHSM User Guide, What is AWS CloudHSM? — What is AWS CloudHSM? — Hardware security modules and supported cryptographic APIs
87. A, B, C, D 네 노드가 있고 모든 서로 다른 노드 쌍을 직접 연결한다. 이처럼 완전 연결 형태로 구성한 네트워크 토폴로지에 해당하는 것은?
[학습용 개정문항]
- Virtual Local Area Network
- Simple Station Network
- Mesh Network
- Modem Network
정답과 해설 보기
정답: 3
정답은 ③이다. 모든 노드 쌍 사이에 직접 연결을 두는 구조는 완전 메시 구조이다. 네 노드라면 각 노드가 나머지 세 노드와 연결되고 중복을 제외한 연결은 4×3÷2=6개이다. 일부 쌍에만 연결이 있는 부분 메시도 있으므로 모든 메시 네트워크가 완전 연결이라는 뜻은 아니다. VLAN은 논리적 네트워크 분리 기능이며 직접 연결의 토폴로지와는 다른 분류이다. 연결 수가 많아지면 구성과 관리 비용도 증가한다.
선지별 해설
- 논리적인 LAN 분리 기능이며 모든 노드 쌍의 직접 연결 구조명이 아니다.
- 지문의 표준적인 완전 메시 토폴로지를 가리키는 명칭이 아니다.
- 노드 쌍이 직접 연결된 완전 메시 형태의 Mesh Network이다.
- 모뎀 사용 여부는 제시된 연결 토폴로지를 정의하지 않는다.
편집 해설 근거: Cisco Security Cloud Control, Full mesh VPN topology — Full mesh VPN topology
88. 물리적 위협으로 인한 문제에 해당하지 않는 것은?
- 화재, 홍수 등 천재지변으로 인한 위협
- 하드웨어 파손, 고장으로 인한 장애
- 방화, 테러로 인한 하드웨어와 기록장치를 물리적으로 파괴하는 행위
- 방화벽 설정의 잘못된 조작으로 인한 네트워크, 서버 보안 위협
정답과 해설 보기
정답: 4
정답은 ④이다. 화재·홍수, 장비 고장, 시설에 대한 파괴 행위는 하드웨어나 기록 매체에 직접 손상을 주는 물리적 위협이다. 반면 방화벽 규칙을 잘못 설정하는 것은 논리적인 접근 통제와 시스템 구성의 문제이다. 잘못된 설정으로 서비스가 중단되거나 침해될 수 있지만 원인의 분류가 물리적 파괴와 다르다. 자연재해뿐 아니라 사람의 고의적 파괴와 우발적 장비 손상도 물리적 위협에 포함할 수 있다.
선지별 해설
- 자연 현상이 시설과 장비를 직접 손상할 수 있다.
- 장비의 물리적 고장과 손상으로 인한 장애이다.
- 장치와 매체를 직접 파괴하는 물리적 공격이다.
- 방화벽의 논리적 접근 규칙 설정 문제이다.
편집 해설 근거: NIST SP 800-30 Rev.1 (2012) — Appendix D — Threat Sources; Appendix E — Threat Events
89. 악성코드의 유형 중 다른 컴퓨터의 취약점을 이용하거나 메일을 통해 스스로 전파·증식하는 것은?
- Worm
- Rogue Ware
- Adware
- Reflection Attack
정답과 해설 보기
정답: 1
정답은 ①이다. 웜은 스스로 복제되어 네트워크 등으로 다른 시스템에 전파되는 프로그램이다. 다른 실행 파일에 자신을 붙여야만 증식하는 바이러스와 구별되는 독립적 전파 성격이 핵심이다. 취약점이나 메일을 이용하는 경로는 웜의 구현에 따라 다를 수 있다. Rogue Ware는 가짜 보안 경고 등으로 사용자를 속이는 소프트웨어, 애드웨어는 광고를 표시하는 소프트웨어이며 반사 공격은 악성코드의 자기 복제 방식이 아니라 트래픽 유도 공격이다.
선지별 해설
- 다른 시스템으로 스스로 복제·전파하는 웜의 특징이다.
- 가짜 경고나 보안 제품으로 속이는 유형이며 자기 전파가 정의의 핵심은 아니다.
- 광고 표시가 중심 특징이며 자동 증식과 동일한 분류가 아니다.
- 응답 트래픽을 대상에 향하게 하는 공격 방식으로 웜의 명칭이 아니다.
편집 해설 근거: NIST CSRC Glossary, worm: SP 800-28 Version 2 및 SP 800-82 Rev. 3 정의 — Definitions — SP 800-28 Version 2; SP 800-82 Rev.3
90. 조각난 ICMP 데이터그램을 재조립했을 때 허용 가능한 IP 패킷 크기를 넘도록 만들어, 이를 잘못 처리하는 시스템 구현의 결함으로 서비스 장애를 유발하는 공격은?
[학습용 개정문항]
- Ping of Death
- Session Hijacking
- Piggyback Attack
- XSS
정답과 해설 보기
정답: 1
정답은 ①이다. Ping of Death는 비정상적으로 큰 패킷을 처리하거나 재조립하는 구현의 결함을 악용하는 서비스 거부 공격의 대표적 사례이다. 단순히 정상 크기의 ping을 많이 보내 대역폭을 소모하는 공격과 구별한다. 재조립 뒤 허용 크기를 넘는 데이터그램을 잘못 처리하는 취약한 구현에서 문제가 발생하며 모든 현대 시스템이 같은 입력으로 멈춘다는 뜻은 아니다. 세션 탈취와 스크립트 삽입은 공격하는 대상과 원리가 다르다.
선지별 해설
- 허용 범위를 넘는 패킷 크기·재조립 처리 결함을 노리는 Ping of Death이다.
- 이미 성립한 세션의 권한이나 상태를 탈취하는 공격이다.
- 다른 주체의 허용된 접근 등에 편승하는 공격을 뜻한다.
- 웹 페이지에 스크립트를 주입하는 공격이며 패킷 재조립 결함과 다르다.
편집 해설 근거: IETF RFC 4732, Internet Denial-of-Service Considerations (2006) — §2.1.1 — malformed packets and ping of death
91. 다음 설명에 해당하는 소프트웨어는?
- 전역 함수 라이브러리
- 소프트웨어 개발 프레임워크
- 컨테이너 아키텍처
- 어휘 분석기
정답과 해설 보기
정답: 2
정답은 ②이다. 프레임워크는 응용 개발에 반복해서 필요한 구조와 기본 동작을 제공하고 개발자가 정해진 확장 지점에 코드를 추가하도록 돕는다. Spring은 의존성 주입을 포함한 공통 기반을 제공하는 Java 생태계의 대표적 예이다. 함수 라이브러리의 단순한 집합과 달리 객체의 협력 구조나 생명주기에도 관여할 수 있다. 컨테이너 기술이나 어휘 분석기는 각각 배포·격리 및 언어 처리라는 다른 목적을 가지므로 지문과 맞지 않는다.
선지별 해설
- 재사용 함수를 묶을 수 있지만 지문의 응용 구조와 확장 기반 전체를 뜻하지 않는다.
- 공통 구조를 확장하여 응용을 만드는 소프트웨어 개발 프레임워크이다.
- 프로세스의 패키징·격리 같은 실행 구조에 관한 개념이다.
- 문자열을 토큰으로 나누는 언어 처리 구성 요소이다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — Application Frameworks — reuse and extension; Spring Framework 6.2, Introduction to the Spring IoC Container and Beans — The IoC Container
92. 소프트웨어 개발 방법론 중 애자일(Agile) 방법론의 특징과 가장 거리가 먼 것은?
- 각 단계의 결과가 완전히 확인된 후 다음 단계 진행
- 소프트웨어 개발에 참여하는 구성원들 간의 의사소통 중시
- 환경 변화에 대한 즉시 대용
- 프로젝트 상황에 따른 주기적 조정
정답과 해설 보기
정답: 1
정답은 ①이다. 애자일은 작동하는 결과를 짧은 주기로 확인하고 구성원과 고객의 피드백을 받아 계획과 작업을 조정하는 접근이다. 단계의 모든 결과가 완전히 확정될 때까지 다음 활동을 일절 진행하지 않는 방식은 이런 반복과 적응을 대표하지 않는다. 변화에 대응한다는 말은 검토 없이 변경하거나 계획을 버린다는 뜻이 아니다. 의사소통과 주기적인 점검을 통해 무엇을 바꿀지와 그 영향을 판단한다.
선지별 해설
- 모든 단계의 완전 확정을 전제하는 순차 진행은 애자일의 대표 특징과 거리가 멀다.
- 직접적인 의사소통과 협력을 중시한다.
- 바뀐 요구와 환경에 적응하려는 특징이다.
- 반복 결과와 회고를 통해 계획과 방식을 조정한다.
편집 해설 근거: Principles behind the Agile Manifesto — Welcome changing requirements; Deliver working software frequently; Regular reflection
93. 대칭 암호 알고리즘과 비대칭 암호 알고리즘에 대한 설명으로 틀린 것은?
- 대칭 암호 알고리즘은 비교적 실행 속도가 빠르기 때문에 다양한 암호의 핵심 함수로 사용될 수 있다.
- 대칭 암호 알고리즘은 비밀키 전달을 위한 카 교환이 필요하지 않아 암호화 및 복호화의 속도가 빠르다.
- 비대칭 암호 알고리즘은 자신만이 보관하는 비밀키를 이용하여 인증, 전자서명 등에 적용이 가능하다.
- 대표적인 대칭키 암호 알고리즘으로는 AES, IDEA 등이 있다.
정답과 해설 보기
정답: 2
정답은 ②이다. 대칭키 암호를 양쪽이 사용하려면 허가된 참여자가 같은 비밀키를 안전하게 보유하도록 사전 배포·키 전송·키 합의 등의 방법을 마련해야 한다. 따라서 키 관리가 필요 없기 때문에 빠르다는 설명은 틀리다. 대칭키 연산은 일반적으로 대량 데이터 처리에 효율적이고 비대칭키 체계는 서로 다른 공개키·개인키를 사용한다. 전자서명에서는 개인키로 서명하고 공개키로 검증하며 비밀키를 상대에게 공개하는 것이 아니다.
선지별 해설
- 대칭키 연산은 일반적으로 대량 데이터 처리에 효율적이다.
- 공유 비밀키를 안전하게 설정·관리할 필요가 없다는 주장이 잘못이다.
- 개인키로 생성한 서명 등을 공개키로 검증하여 인증에 활용할 수 있다.
- AES와 IDEA는 대칭키 블록 암호의 예이다.
편집 해설 근거: NIST SP 800-57 Part 1 Revision 5, Recommendation for Key Management — §4.1 Cryptographic Algorithms; §8.1.5 Key Establishment; NIST FIPS 197-upd1, Advanced Encryption Standard (2023) — §3 Definitions; §5 Algorithm Specification
94. 두 명의 개발자가 5개월에 걸쳐 10000 라인의 코드를 개발하였을 때, 월별(man-month) 생산성 측정을 위한 계산 방식으로 가장 적합한 것은?
- 10,000 ÷ 2
- 10,000 ÷ (5 × 2)
- 10,000 ÷ 5
- (2 × 10,000) ÷ 5
정답과 해설 보기
정답: 2
정답은 ②이다. 두 개발자가 모두 5개월 동안 일했다면 투입 노력은 2명×5개월=10인월이다. 생산성은 산출한 코드 10,000줄을 이 노력으로 나눈 1,000 LOC/인월이므로 계산식은 10,000÷(5×2)이다. 달력상 기간인 5개월과 사람 수를 반영한 노력인 10인월을 구분해야 한다. 코드 줄 수로 계산한 생산성이 품질이나 업무 가치를 그대로 측정하는 지표는 아니며 지문에서는 단순한 산출량 대비 노력만 구한다.
선지별 해설
- 사람 수로만 나누어 1인당 전체 기간의 산출량을 구한다.
- 총 코드 줄 수를 총 투입 인월로 나누는 올바른 계산식이다.
- 팀 전체의 월간 산출량이며 인월당 생산성이 아니다.
- 인원 수를 분자가 아니라 노력의 분모에 반영해야 한다.
편집 해설 근거: Barry W. Boehm, Software Engineering Economics (1984), 저자 논문 보존 사본 — Software Cost Estimation — effort in person-months and source size
95. 접근 통제 방법 중 조직 내에서 직무, 직책 등 개인의 역할에 따라 결정하여 부여하는 접근 정책
- RBAC
- DAC
- MAC
- QAC
정답과 해설 보기
정답: 1
정답은 ①이다. RBAC는 권한을 역할에 연결하고 사용자에게 역할을 부여하여 접근을 관리한다. 예를 들어 회계 담당 역할에 지급 내역 조회 권한을 주면 해당 역할을 가진 사용자가 정책에 따라 접근한다. DAC는 자원 소유자의 재량, MAC는 중앙의 강제 정책이라는 통제 기준과 구별한다. 직책 이름만 적는 것으로 충분한 것은 아니며 역할별 허용 작업과 사용자 배정, 필요하면 역할 활성화 조건도 정의해야 한다.
선지별 해설
- 조직의 역할을 통해 사용자와 권한을 연결하는 역할 기반 접근 통제이다.
- 자원 소유자의 재량으로 권한을 부여하는 방식이다.
- 주체와 객체의 보안 속성 등을 중앙 정책으로 강제하는 방식이다.
- 지문에 대응하는 통상적 역할 기반 접근 통제의 약어가 아니다.
편집 해설 근거: NIST CSRC, Role Based Access Control FAQ — RBAC FAQ — users, roles and permissions; What is RBAC?
96. COCOMO(Constructive Cost Model) 모형의 특징이 아닌 것은?
[학습용 개정문항]
- 프로젝트를 완성하는 데 필요한 노력을 인월로 나타낼 수 있다.
- Boehm이 제안한 전통적 모형은 원시 코드 규모를 비용 추정의 주요 입력으로 사용한다.
- 기본 개발 모드는 유기형·반분리형·내장형으로 나뉜다.
- 프로젝트 개발 유형을 object·dynamic·function의 세 모드로 나눈다.
정답과 해설 보기
정답: 4
정답은 ④이다. 전통적 COCOMO는 소스 코드 규모와 프로젝트 조건을 이용하여 개발 노력과 일정을 추정하는 모형이다. 기본적인 개발 모드는 유기형, 반분리형, 내장형이며 팀의 경험과 개발 제약 같은 특성을 반영한다. object·dynamic·function은 COCOMO의 세 모드가 아니라 OMT의 모델 구분과 관련된 용어이다. 추정값은 실제 프로젝트 데이터에 맞춰 보정할 필요가 있으며 코드 규모만으로 모든 개발 조건이 결정되지는 않는다.
선지별 해설
- 노력의 추정 결과를 인월로 나타낼 수 있다.
- Boehm의 전통적 COCOMO는 소스 코드 규모를 주요 입력으로 사용한다.
- 유기형·반분리형·내장형이라는 세 개발 모드로 구분한다.
- 객체·동적·기능은 COCOMO의 개발 모드 이름이 아니다.
편집 해설 근거: Barry W. Boehm, Software Engineering Economics (1984), 저자 논문 보존 사본 — Basic COCOMO; Organic, Semidetached, Embedded modes; Dov Dori, On Bridging the Analysis–Design and Structure–Behavior Grand Canyons with Object Paradigms (1996), 저자 제공 원문 — OMT description, p.26
97. 사용자 인증에 활용하는 정보의 성격에 대한 설명으로 가장 적절하지 않은 것은?
[학습용 개정문항]
- 지식: 비밀번호나 PIN처럼 본인이 알고 있는 정보를 사용한다.
- 소유: 토큰이나 스마트카드처럼 본인이 가진 인증기를 사용한다.
- 존재: 사람 대신 제시하는 QR 이미지는 그 자체로 사람의 생체 특성에 해당한다.
- 행동적 생체 특성: 타이핑 리듬과 같은 개인의 행동 패턴을 사용할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 암기한 비밀번호나 PIN은 지식, 소지한 인증기나 스마트카드는 소유에 관한 정보이다. 지문에서 존재로 표현한 생체 특성은 지문·얼굴과 같은 개인의 특성이지 단순히 대신 보여 주는 QR 이미지가 아니다. 타이핑 리듬처럼 행동에 기반한 생체 특성도 있다. NIST는 생체 정보를 독립된 비밀처럼 취급하지 않으며 정해진 조건에서 물리적 인증기와 결합하도록 한다. 행동을 언제나 별개의 독립 인증 요소로 세는 것도 주의해야 한다.
선지별 해설
- 본인이 기억하고 있는 비밀을 사용하는 지식 기반 정보이다.
- 본인이 보유한 인증기와 그 제어를 사용하는 소유 기반 정보이다.
- QR은 표현 형식이며 그 자체가 사람의 생체적 존재 특성을 뜻하지 않는다.
- 타이핑의 시간적 패턴 등은 행동 기반 생체 특성의 예이다.
편집 해설 근거: NIST SP 800-63B-4, Digital Identity Guidelines — Authentication (2025) — §2 Authentication Assurance Levels; §3.2.3 Use of Biometrics
98. 시스템의 사용자가 로그인하여 명령을 내리는 과정에 대한 시스템의 동작 중 다음 설명에 해당하는 것은?
- Aging
- Accounting
- Authorization
- Authentication
정답과 해설 보기
정답: 4
정답은 ④이다. 인증은 요청자가 주장한 계정이나 신원에 연결된 인증 정보를 제어하고 있는지 확인하는 과정이다. ID를 제시하고 비밀번호를 검증하는 로그인이 대표적인 예이다. 인가는 인증 후 해당 주체가 어떤 명령이나 자원 사용을 허용받는지 결정하는 일이며 계정 기록은 사용 내역을 남기는 활동이다. 비밀번호 검증만으로 오프라인의 실명 신원을 새로 증명한 것과 같다고 해석하지 않도록 인증과 신원 확인 절차를 구별한다.
선지별 해설
- 운영체제의 대기 우선순위 조정 등에 쓰이는 용어이며 로그인 인증이 아니다.
- 사용·접속 내역을 기록하고 집계하는 활동이다.
- 인증된 주체에게 어떤 작업을 허용할지 결정하는 인가이다.
- 제시한 인증 정보를 검증하여 계정의 정당한 사용자인지 확인하는 인증이다.
편집 해설 근거: NIST SP 800-63B-4, Digital Identity Guidelines — Authentication (2025) — §1.1 Purpose and Scope; Authentication model; Peter Reiher, OSTEP v1.10, 55 Access Control — Access Control — authorization
99. 네트워크의 제어 기능과 패킷 전달 기능을 분리하고, 정의된 인터페이스를 통해 소프트웨어가 전달 동작과 정책을 프로그래밍하도록 하는 접근은?
[학습용 개정문항]
- SDN(Software Defined Networking)
- NFS(Network File System)
- Network Mapper
- AOE Network
정답과 해설 보기
정답: 1
정답은 ①이다. SDN은 네트워크의 제어 기능과 패킷을 실제 전달하는 기능을 구분하고 소프트웨어와 인터페이스로 동작을 프로그래밍하도록 하는 접근이다. 제어 기능은 논리적으로 중앙화할 수 있으나 실제 구현은 여러 장치에 분산될 수도 있다. NFS는 파일 공유 프로토콜이고 Network Mapper는 네트워크 탐색 도구를 가리킨다. 기존 장비의 펌웨어만 올리면 영향 없이 모든 SDN 기능을 얻는다는 보장은 없으며 지원 인터페이스와 설계가 필요하다.
선지별 해설
- 제어·전달 기능을 분리하고 네트워크 동작을 프로그래밍하는 SDN이다.
- 네트워크를 통한 파일 접근과 공유를 위한 프로토콜이다.
- 호스트와 서비스 등을 탐색하는 도구이며 제어 평면 분리 구조가 아니다.
- 지문의 소프트웨어 정의 네트워크를 가리키는 표준 약어가 아니다.
편집 해설 근거: RFC 7426 — SDN: Layers and Architecture Terminology — §2 Terminology; §3.1 Overview; §3.3 Control Plane
100. 프로젝트 일정 관리 시 사용하는 PERT 차트에 대한 설명에 해당하는 것은?
- 각 작업들이 언제 시작하고 언제 종료되는지에 대한 일정을 막대 도표를 이용하여 표시한다.
- 시간선(Time-Line) 차트라고도 한다.
- 수평 막대의 길이는 각 작업의 기간을 나타낸다.
- 작업들 간의 상호 관련성, 결정경로, 경계시간, 자원할당 등을 제시한다.
정답과 해설 보기
정답: 4
정답은 ④이다. PERT의 네트워크 표현은 작업 사이의 선후 관계와 경로를 분석하여 일정에 영향을 주는 의존성을 이해하도록 돕는다. 기간을 추정하고 경로를 계산하면 전체 완료를 지배하는 임계경로와 여유시간을 검토할 수 있다. 수평 막대로 작업의 시작·종료와 기간을 나타내는 나머지 보기는 간트 차트의 표현 방식이다. 자원 배정까지 다루려면 별도의 자원 조건도 있어야 하므로 그림의 연결만으로 모든 자원 문제가 자동 해결되지는 않는다.
선지별 해설
- 작업의 기간을 막대로 표현하는 간트 차트의 특징이다.
- 시간축에 작업을 배치하는 막대 차트에 가까운 설명이다.
- 수평 막대의 길이로 기간을 나타내는 간트 차트이다.
- 작업 의존성과 경로·여유시간 등을 분석하는 네트워크 일정 표현에 해당한다.
편집 해설 근거: U.S. GAO, Schedule Assessment Guide GAO-16-89G (2015) — Best Practice 2 Sequencing All Activities; Best Practice 6 Confirming That the Critical Path Is Valid; Best Practice 7 Ensuring Reasonable Total Float
정보처리기사 필기 기출문제 학습 방법
먼저 PDF 문제지를 시간에 맞춰 푼 뒤, 이 글에서 오답의 정답·해설·근거를 확인하세요. 법규 문항은 근거 기준일 이후 개정 여부도 함께 확인하는 것이 안전합니다.