
문제지 PDF · 웹 정답 해설
정보처리기사 필기 2021년 1회 공개기출 100문항
정보처리기사 필기 2021년 1회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.

© 자격증3001. 이 정보처리기사 필기 기출문제 게시물의 문제 재구성 문장, 해설, 재작성 도식, 편집 및 PDF 디자인은 자격증3001의 저작권 보호를 받습니다. 국가기술자격 시험 및 관련 명칭의 권리는 해당 기관에 있으며, 본 자료는 Q-Net 공식 문제지 또는 공식 해설이 아닙니다. 무단 복제·재배포를 금합니다.
정보처리기사 필기 2021년 1회 공개기출 100문항 안내
정보처리기사 필기 2021년 1회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.
이 회차의 100문항 해설을 문항별 기술 원문과 필요한 독립 계산으로 편집 검토했습니다. 질문·조건·보기를 고친 문항은 학습용 개정문항으로 표시합니다. 원 시험의 공식 원문이나 공식 정답표를 새로 확인한 자료는 아닙니다.
정보처리기사 필기 기출문제 · 소프트웨어 설계
1. 실행 중인 Linux 커널의 릴리스 문자열을 -r 옵션으로 출력하는 명령어는?
[학습용 개정문항]
- ls
- cat
- pwd
- uname
정답과 해설 보기
정답: 4
정답은 ④이다. uname의 -r 옵션은 실행 중인 커널의 릴리스 문자열을 출력한다. -s는 커널 이름, -v는 커널 버전 정보이며 -a는 여러 정보를 함께 보여 준다. 배포판의 제품명과 버전은 커널 릴리스와 다른 정보다. cat으로 /etc/os-release 같은 파일의 내용을 읽을 수도 있지만 cat 자체의 -r 옵션이 커널 릴리스를 출력하는 것은 아니다. 원문의 막연한 버전 정보 질문과 확인되지 않은 복수정답 주석을 그대로 단정하지 않고, 개정 문항은 명령의 구체적인 옵션과 출력 대상을 지정했다.
선지별 해설
- 파일과 디렉터리의 목록을 표시하며 -r은 정렬 순서와 관련된다.
- 파일 내용을 출력하는 명령으로 지정한 커널 릴리스 조회 옵션의 주체가 아니다.
- 현재 작업 디렉터리의 경로를 표시한다.
- uname -r은 실행 중인 커널의 릴리스를 출력한다.
편집 해설 근거: GNU Coreutils — uname: Print system information — uname invocation — -r, –kernel-release; -v, –kernel-version; POSIX.1-2024 Issue 8, cat — DESCRIPTION
2. TCP 서버가 통신 종단점을 만들고 주소·포트에 결합한 뒤, 클라이언트의 연결 요청을 수락하여 송수신하는 데 사용하는 기술은?
[학습용 개정문항]
- DB링크 기술
- 소켓 기술
- 스크럼 기술
- 프로토타입 기술
정답과 해설 보기
정답: 2
정답은 ②이다. TCP 서버는 소켓을 만들고 로컬 주소와 포트를 결합한 뒤 연결 요청을 기다린다. 일반적으로 socket, bind, listen을 사용하며 accept는 도착한 요청을 수락하여 해당 클라이언트와 통신할 새 연결 소켓을 반환한다. 원래의 수신 대기 소켓은 다른 연결도 받을 수 있다. DB 링크는 데이터베이스 사이의 접근, 스크럼은 개발을 운영하는 프레임워크, 프로토타입은 요구나 설계안을 확인하는 시제품과 관련되므로 이 통신 인터페이스의 명칭과 다르다.
선지별 해설
- 다른 데이터베이스의 자료에 접근하는 연결 방식과 관련된다.
- 주소·포트에 결합하여 연결 요청과 데이터 송수신을 처리하는 통신 인터페이스다.
- 개발 작업을 운영하는 프레임워크다.
- 요구나 설계안을 확인하기 위한 시제품이다.
편집 해설 근거: Python 3.14, socket — Low-level networking interface — socket.socket; socket.bind; socket.listen; socket.accept; Example
3. 객체지향 개념에서 연관된 데이터와 함수를 함께 묶어 외부 와 경계를 만들고 필요한 인터페이스만을 밖으로 드러내는 과정은?
- 메시지(Message)
- 캡슐화(Encapsulation)
- 다형성(Polymorphism)
- 상속(Inheritance)
정답과 해설 보기
정답: 2
정답은 ②이다. 캡슐화는 관련된 데이터와 그 데이터를 다루는 동작을 하나의 경계 안에 묶는 것이다. 외부는 공개한 연산을 통해 객체를 사용하며 내부 표현을 직접 알아야 하는 의존성을 줄일 수 있다. 예를 들어 계좌의 잔액을 직접 변경하기보다 입금·출금 연산을 통해 상태를 바꾸게 할 수 있다. 메시지는 동작 요청의 전달, 다형성은 같은 인터페이스에 대한 다양한 구현, 상속은 상위 형식의 특성과 동작을 이어받는 관계이므로 자료와 연산을 묶는 과정과 구별된다.
선지별 해설
- 객체 사이에서 동작을 요청하거나 정보를 전달하는 개념이다.
- 관련 자료와 연산을 한 경계에 묶고 공개 인터페이스를 제공한다.
- 같은 인터페이스나 연산에 서로 다른 구현이 대응하는 성질이다.
- 상위 형식의 특성과 동작을 이어받는 관계다.
편집 해설 근거: Harry C. Harrison, NASA Guide to Object-Oriented Analysis and Design (1992) — Terminology, printed pp. XVII-1–XVII-2 — encapsulation; inheritance; polymorphism; IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles
4. GoF(Gangs of Four) 디자인 패턴의 생성패턴에 속하지 않는 것은?
- 추상 팩토리(Abstract Factory)
- 빌더(Builder)
- 어댑터(Adapter)
- 싱글턴(Singleton)
정답과 해설 보기
정답: 3
정답은 ③이다. GoF 패턴은 목적에 따라 생성·구조·행동 패턴으로 구분한다. Adapter는 이미 존재하는 클래스나 객체의 인터페이스를 사용자가 기대하는 인터페이스에 맞추어 연결하는 구조 패턴이다. Abstract Factory는 관련된 객체군을 만드는 인터페이스, Builder는 복잡한 객체를 단계적으로 구성하는 방식, Singleton은 한 클래스의 인스턴스 수와 접근을 통제하는 생성 패턴이다. 패턴 내부에서 객체를 새로 만든다는 사실만으로 생성 패턴이 되는 것은 아니며 주된 설계 목적을 기준으로 판정한다.
선지별 해설
- 관련된 객체군을 생성하는 인터페이스를 제공하는 생성 패턴이다.
- 복잡한 객체의 구성 과정을 분리하는 생성 패턴이다.
- 기존 인터페이스를 변환하여 연결하는 구조 패턴이다.
- 인스턴스 수와 접근을 통제하는 생성 패턴이다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — p. 15 Design Space for GoF Patterns
5. 응용프로그램의 프로시저를 사용하여 원격 프로시저를 로컬 프로시저처럼 호출하는 방식의 미들웨어는?
- WAS(Web Application Server)
- MOM(Message Oriented Middleware)
- RPC(Remote Procedure Call)
- ORB(Object Request Broker)
정답과 해설 보기
정답: 3
정답은 ③이다. RPC는 호출자가 원격 프로시저의 이름과 인자를 담은 요청을 보내고, 서버가 해당 연산을 수행한 결과를 응답하도록 하는 호출 모델이다. 호출 측에서는 함수 호출에 가까운 인터페이스를 사용할 수 있지만 실제로는 네트워크와 다른 프로세스를 거친다. 따라서 통신 지연, 서버 장애, 응답을 받지 못한 경우의 재시도와 중복 실행 가능성을 고려해야 한다. MOM은 메시지 전달을 중심으로 하며 ORB는 분산 객체의 요청을 중개하고 WAS는 웹 응용 실행 환경이라는 범위가 다르다.
선지별 해설
- 웹 응용 프로그램의 실행과 관련 서비스를 제공하는 서버 환경이다.
- 메시지를 주고받는 방식의 통신 중개를 중심으로 한다.
- 원격 프로시저 호출의 인자·요청·결과 전달을 중개한다.
- 분산 객체에 대한 요청과 객체 접근을 중개하는 구조다.
편집 해설 근거: RFC 5531, Remote Procedure Call Protocol Version 2 — §3 Terminology; §4 The RPC Model; §5 Transports and Semantics
6. 바람직한 소프트웨어 설계 지침이 아닌 것은?
- 모듈의 기능을 예측할 수 있도록 정의한다.
- 이식성을 고려한다.
- 적당한 모듈의 크기를 유지한다.
- 가능한 모듈을 독립적으로 생성하고 결합도를 최대화한 다.
정답과 해설 보기
정답: 4
정답은 ④이다. 모듈 사이의 결합도는 서로의 자료나 동작에 의존하는 정도와 관련된다. 이를 불필요하게 높이면 하나를 수정할 때 다른 모듈까지 영향을 받기 쉬우므로, 모듈 독립성을 추구하면서 결합도를 최대화한다는 지침은 맞지 않는다. 모듈 내부에는 관련된 책임을 모아 응집도를 높이고 외부와는 필요한 인터페이스로 협력하게 한다. 기능의 예측 가능성, 목표 환경으로의 이식성, 이해하고 관리할 수 있는 크기도 설계에서 고려할 수 있다. 무조건 가장 작은 모듈로 쪼개는 것이 목표는 아니다.
선지별 해설
- 기능과 계약을 이해할 수 있으면 호출 결과를 예측하고 변경 영향을 파악하기 쉽다.
- 목표 환경의 차이를 고려하면 필요한 이식성을 확보하는 데 도움이 된다.
- 책임과 이해 가능성에 맞는 크기는 유지보수를 돕는다.
- 결합도 최대화는 모듈 간 의존성을 키워 독립성을 해친다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Coupling and cohesion; Decomposition and modularization; CMU SEI, Candidate Complexity Metrics (2016), Appendix A.6 — Appendix A.6 Coupling
7. 객체지향 분석 방법론 중 Coad-Yourdon 방법에 해당하는 것은?
[학습용 개정문항]
- 객체·클래스, 구조, 속성, 서비스와 주제 영역을 중심으로 문제 영역을 분석한다.
- 객체, 동적, 기능 모델로 나누어 수행하는 방법이다.
- 미시적 개발 프로세스와 거시적 개발 프로세스를 모두 사용하는 방법이다.
- Use-Case를 강조하여 사용하는 방법이다.
정답과 해설 보기
정답: 1
정답은 ①이다. Coad–Yourdon의 객체지향 분석은 객체·클래스와 구조, 속성, 서비스, 주제 영역을 중심으로 문제 영역을 표현한다. 일반화·특수화 및 전체·부분 관계와 객체가 제공하는 동작도 함께 다룬다. 따라서 단순히 E-R 다이어그램으로 객체의 행위를 데이터 모델링한다는 원문의 설명은 범위와 표현이 부정확하다. 객체·동적·기능의 세 모델은 Rumbaugh의 OMT, 미시·거시 프로세스는 Booch 방법, 유스케이스 중심의 접근은 Jacobson 계열과 구별하는 단서다.
선지별 해설
- 객체·클래스, 구조, 속성, 서비스와 주제 영역을 통해 문제 영역을 분석한다.
- 객체·동적·기능의 세 모델은 Rumbaugh OMT의 구분이다.
- 미시·거시 개발 프로세스는 Booch 방법의 구분이다.
- 유스케이스 중심의 분석은 Jacobson 계열을 구별하는 단서다.
편집 해설 근거: Harry C. Harrison, NASA Guide to Object-Oriented Analysis and Design (1992) — The Object-Oriented Approach; Object Diagrams, printed pp. XVII-2–XVII-3; Dov Dori, On Bridging the Analysis–Design and Structure–Behavior Grand Canyons with Object Paradigms (1996), 저자 제공 원문 — printed p. 26 — object, dynamic and functional models; Booch et al., Object-Oriented Analysis and Design with Applications 3판, 출판사 목차 — Chapter 6 Process — §6.2 Macro Process; §6.3 Micro Process; Ivar Jacobson, Use Case Definition — Use Case Definition; reference 2, Object-Oriented Software Engineering: A Use Case Driven Approach
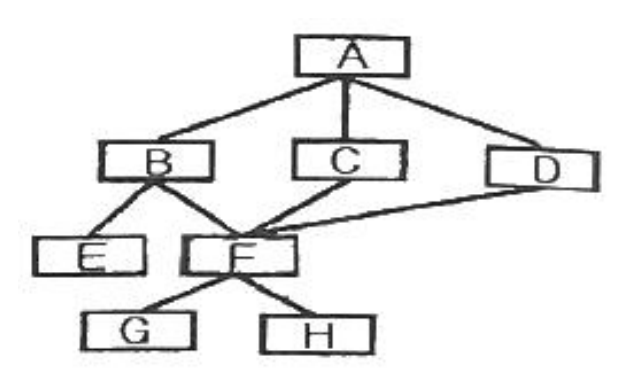
8. 이미지의 프로그램 구조에서 모듈 F의 fan-in과 fan-out은 각각 얼마인가?
- fan-in : 2, fan-out : 3
- fan-in : 3, fan-out : 2
- fan-in : 1, fan-out : 2
- fan-in : 2, fan-out : 1
정답과 해설 보기
정답: 2
정답은 ②이다. 그림에서 F로 들어오는 직접 호출 연결은 B→F, C→F, D→F의 세 개이므로 fan-in은 3이다. F에서 나가는 직접 호출 연결은 F→G와 F→H의 두 개이므로 fan-out은 2다. A는 B·C·D를 거쳐 F와 연결되지만 F를 직접 호출하는 선이 없으므로 이 계산에 추가하지 않는다. fan-in과 fan-out은 그림상 위아래의 모든 모듈 수가 아니라 해당 모듈에 직접 연결되는 호출 방향을 구분하여 센다.
선지별 해설
- 들어오는 세 연결과 나가는 두 연결을 반대로 적었다.
- B·C·D의 세 호출을 받고 G·H 두 모듈을 호출한다.
- F에 들어오는 세 직접 연결 중 둘을 빠뜨렸다.
- 직접 호출하는 쪽과 호출받는 쪽의 수가 모두 맞지 않는다.
편집 해설 근거: CMU SEI, Candidate Complexity Metrics (2016) — Appendix A.7 Fan-in and Fan-out
9. 현행 시스템의 기술 환경을 운영체제·DBMS·네트워크 같은 기술 구성요소로 분류할 때, 이 분류와 성격이 다른 항목은?
[학습용 개정문항]
- DBMS 분석
- 네트워크 분석
- 운영체제 분석
- 인적 자원 분석
정답과 해설 보기
정답: 4
정답은 ④이다. 운영체제, 데이터베이스 관리 시스템, 네트워크는 현재 시스템이 어떤 소프트웨어와 통신 기반 위에서 동작하는지 확인하는 기술 환경 항목이다. 인적 자원은 담당자의 역량과 역할, 인력 배치 등을 다루므로 제시한 기술 구성요소의 목록과 구별된다. 그렇다고 사람을 분석하지 않아도 된다는 뜻은 아니다. 실제 현행 업무와 시스템을 이해하려면 사용자, 운영자, 조직의 업무와 제약도 중요한 요구 수집 대상이다. 개정 문항은 기술 구성요소 분류라는 비교 범위를 명시한다.
선지별 해설
- 데이터의 저장·조회 환경을 구성하는 기술 항목이다.
- 시스템 사이의 통신과 연결을 구성하는 기술 항목이다.
- 프로세스·메모리·장치 등 실행 기반을 제공하는 기술 항목이다.
- 사람의 역량·역할·배치는 기술 구성요소 자체와 구별되는 조직·인력 항목이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §2 Requirements Elicitation — stakeholders and requirements sources; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — operating system; database management system; computer network
10. 분산 컴퓨팅 환경에서 서로 다른 기종 간의 하드웨어나 프 로토콜, 통신환경 등을 연결하여 응용프로그램과 운영환경 간에 원만한 통신이 이루어질 수 있게 서비스를 제공하는 소프트웨어는?
- 미들웨어
- 하드웨어
- 오픈허브웨어
- 그레이웨어
정답과 해설 보기
정답: 1
정답은 ①이다. 미들웨어는 운영체제와 응용 프로그램 사이 또는 서로 다른 응용 구성요소 사이에서 공통 서비스를 제공하는 소프트웨어다. 분산 환경에서는 통신, 메시지 전달, 원격 호출, 트랜잭션 등의 기능을 제공하여 각 응용이 환경 차이를 모두 직접 처리해야 하는 부담을 줄일 수 있다. 모든 제품이 모든 기종과 프로토콜을 자동 지원한다는 뜻은 아니며 지원 범위와 설정을 확인해야 한다. 하드웨어는 물리 장치이고 나머지 보기의 명칭은 이 중개 소프트웨어 계층을 뜻하지 않는다.
선지별 해설
- 응용과 운영 환경 사이에 공통 서비스와 통신 중개 기능을 제공하는 소프트웨어다.
- 프로세서·메모리·네트워크 장치 같은 물리적 구성요소다.
- 문항이 설명하는 중개 소프트웨어 계층의 표준 용어가 아니다.
- 일반적으로 원치 않는 소프트웨어의 성격을 가리키며 통신 중개 계층의 이름과 다르다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.2459 middleware; RFC 5531, Remote Procedure Call Protocol Version 2 — §4 The RPC Model
11. CASE(Computer Aided Software Engineering)에 대한 설명 으로 틀린 것은?
[학습용 개정문항]
- 소프트웨어 모듈과 산출물의 재사용을 지원할 수 있다.
- 자동화된 검사와 일관성 관리로 품질 개선을 지원할 수 있다.
- 완성된 소프트웨어의 최종 사용자에게 사용법을 교육하는 것만이 주된 목적이다.
- 소프트웨어 유지보수와 변경 영향의 관리를 지원할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. CASE는 요구 분석, 설계, 구현, 시험, 문서 및 산출물 관리 같은 소프트웨어 공학 활동을 도구로 지원하는 접근이다. 모델과 산출물의 연결, 재사용 가능한 요소의 관리, 자동화된 검사 등을 통해 개발과 유지보수를 도울 수 있다. 최종 사용자에게 완성된 프로그램의 사용법을 빠르게 교육하는 것만이 CASE의 주된 목적이라는 설명은 다르다. 도구를 도입했다고 품질과 재사용성이 자동으로 보장되는 것은 아니며 적절한 방법과 검토가 함께 필요하다.
선지별 해설
- 재사용 가능한 모듈이나 산출물의 관리로 재사용을 지원할 수 있다.
- 자동 검사와 일관성 관리가 품질 개선을 지원할 수 있다.
- 최종 사용자 교육만을 주된 목적으로 하는 도구로 한정할 수 없다.
- 산출물과 변경 영향의 관리로 유지보수를 지원할 수 있다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.485 CASE tool; §3.737 computer-aided software engineering; IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §8.1 Requirements Management Tools; §8.2 Requirements Modeling Tools
12. UML(Unified Modeling Language)에 대한 설명 중 틀린 것 은?
- 기능적 모델은 사용자 측면에서 본 시스템 기능이며, UML에서는 Use case Diagram을 사용한다.
- 정적 모델은 객체, 속성, 연관관계, 오퍼레이션의 시스템 의 구조를 나타내며, UML에서는 Class Diagram을 사용 한다.
- 동적 모델은 시스템의 내부 동작을 말하며, UML에서는 Sequence Diagram, State Diagram, Activity Diagram을 사용한다.
- State Diagram은 객체들 사이의 메시지 교환을 나타내 며, Sequence Diagram은 하나의 객체가 가진 상태와 그 상태의 변화에 의한 동작순서를 나타낸다.
정답과 해설 보기
정답: 4
정답은 ④이다. 시퀀스 다이어그램은 상호작용하는 참여자 사이의 메시지와 그 순서를 나타낸다. 상태 머신 다이어그램은 상태와 사건에 따른 전이를 표현하므로 ④는 두 역할을 뒤바꾼 설명이다. 유스케이스 다이어그램은 외부 역할과 시스템이 제공하는 기능의 관계를, 클래스 다이어그램은 클래스와 속성·연산·정적 관계를 보여 준다. 활동 다이어그램도 동작의 흐름을 표현할 수 있다. 이들은 서로 다른 관점을 보완하며 한 다이어그램으로 모든 구조와 동작을 완전히 기술하는 것은 아니다.
선지별 해설
- 유스케이스는 외부 액터 관점의 기능과 상호작용을 나타낼 수 있다.
- 클래스 다이어그램은 클래스와 속성·연산·관계의 정적 구조를 나타낸다.
- 상호작용, 상태 전이, 활동 흐름은 각각 동적인 관점을 표현한다.
- 메시지 교환의 순서와 상태 전이에 대한 다이어그램의 역할을 뒤바꿨다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §11.4 Classes; §14 StateMachines; §15 Activities; §17 Interactions; §18 UseCases
13. 기본 유스케이스의 확장 지점에 추가 행동을 넣으며, 명시된 조건이 성립할 때 그 행동을 수행하도록 표현하는 UML 관계는?
[학습용 개정문항]
- 연관
- 확장
- 선택
- 특화
정답과 해설 보기
정답: 2
정답은 ②이다. UML의 extend 관계는 기본 유스케이스의 정해진 확장 지점에서 추가 행동을 삽입할 수 있음을 나타낸다. 조건이 주어진 확장이라면 그 조건이 성립할 때 추가 행동을 수행한다. 기본 유스케이스는 확장 행동을 빼더라도 독립적으로 의미 있는 행위를 정의한다. 모든 확장에 반드시 명시적인 조건이 있어야 한다는 뜻은 아니며 UML은 조건이 없는 경우도 다룬다. 연관은 액터와 유스케이스 등의 참여 관계, 일반화·특수화는 공통된 행위와 특수한 행위의 관계와 구별한다.
선지별 해설
- 액터 등의 참여·연결을 나타내며 조건부 추가 행동의 삽입 관계와 다르다.
- 기본 유스케이스의 확장 지점에 추가 행동을 넣는 extend 관계다.
- 이 상황을 나타내는 UML 유스케이스 관계의 정식 명칭이 아니다.
- 일반화의 반대 관점에 해당하며 확장 지점에 행동을 넣는 관계와 다르다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §18.1 Use Cases — Extending UseCases; §18.2.2 Extend
14. 요구사항을 표현하는 데 사용할 수 있는 UML 2.5.1 다이어그램의 종류가 아닌 것은?
[학습용 개정문항]
- 활동 다이어그램(Activity Diagram)
- 유스케이스 다이어그램(Use Case Diagram)
- 시퀀스 다이어그램(Sequence Diagram)
- 단계 다이어그램(Phase Diagram)
정답과 해설 보기
정답: 4
정답은 ④이다. UML의 다이어그램 목록에는 활동, 유스케이스, 시퀀스 다이어그램이 포함되지만 Phase Diagram이라는 이름의 다이어그램은 포함되지 않는다. 활동은 처리와 제어의 흐름, 유스케이스는 외부 역할과 기능, 시퀀스는 참여자 사이의 메시지 순서를 표현하므로 요구사항을 설명하는 데 사용할 수 있다. 원문의 Agile은 개발 접근이지 UML 다이어그램의 종류가 아니어서 같은 기준의 보기로 비교하기 어려웠다. 개정 문항은 UML 종류끼리 비교하도록 그 보기를 활동 다이어그램으로 바꾸었다.
선지별 해설
- 활동과 제어·객체 흐름을 표현하는 UML 다이어그램이다.
- 액터와 시스템 기능의 관계를 나타내는 UML 다이어그램이다.
- 상호작용하는 참여자의 메시지 순서를 나타내는 UML 다이어그램이다.
- UML 2.5.1 다이어그램 분류에 포함된 명칭이 아니다.
편집 해설 근거: OMG UML 2.5.1 (2017) — Annex A Diagrams; §15 Activities; §17 Interactions; §18 UseCases
15. 디자인 패턴을 이용한 소프트웨어 재사용으로 얻어지는 장 점이 아닌 것은?
- 소프트웨어 코드의 품질을 향상시킬 수 있다.
- 개발 프로세스를 무시할 수 있다.
- 개발자들 사이의 의사소통을 원활하게 할 수 있다.
- 소프트웨어의 품질과 생산성을 향상시킬 수 있다.
정답과 해설 보기
정답: 2
정답은 ②이다. 디자인 패턴은 반복되는 설계 문제에서 사용할 수 있는 구조와 협력 방식, 적용 조건과 장단점을 이름 붙여 공유한 것이다. 상황에 맞게 적용하면 설계 의도를 전달하고 이미 알려진 해결 방식을 재사용하는 데 도움이 된다. 그러나 요구사항 확인, 구현, 시험, 검토 같은 개발 활동을 대신하지는 않는다. 패턴을 사용한다는 이유로 개발 프로세스를 무시하면 실제 요구와 맞지 않는 구조를 만들 수 있다. 재사용과 품질·생산성 향상은 적절한 선택과 적용에 따라 기대할 수 있는 효과다.
선지별 해설
- 적합한 구조를 재사용하면 코드 품질 개선에 도움이 될 수 있다.
- 패턴을 사용해도 요구 확인·구현·시험·검토 등의 개발 활동은 필요하다.
- 패턴의 공통 이름은 설계 의도를 전달하는 어휘가 될 수 있다.
- 적절한 재사용은 품질과 생산성 개선에 기여할 수 있다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — p. 18 Benefits & Limitations of Patterns; IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §5.1 General Strategies
16. Rumbaugh OMT의 세 모델인 Object·Dynamic·Functional 중, 요구되는 객체를 찾아 클래스·속성·연산과 객체 사이의 관계를 구조적으로 표현하는 모델은?
[학습용 개정문항]
- Object
- Dynamic
- Function
- Static
정답과 해설 보기
정답: 1
정답은 ①이다. Rumbaugh OMT의 객체 모델은 객체와 클래스의 구조, 속성, 연산 및 클래스 사이의 관계를 나타낸다. 동적 모델은 사건과 시간에 따른 상태 변화를 다루고, 기능 모델은 입력이 처리되어 출력으로 바뀌는 자료 변환을 나타낸다. 객체 모델이 정적인 구조를 표현한다고 설명할 수는 있지만, OMT의 세 모델이라는 명칭을 묻는 문항에서 Static을 별도의 네 번째 모델로 세지 않는다. 개정 질문은 세 가지 공식 모델 명칭 가운데 해당하는 것을 고르도록 범위를 명확히 했다.
선지별 해설
- 클래스·속성·연산과 관계의 구조를 표현하는 객체 모델이다.
- 시간과 사건에 따른 상태 변화의 관점이다.
- 자료의 변환과 기능적 처리의 관점이다.
- 객체 모델의 정적 성격을 설명할 수는 있으나 제시한 세 모델 중 별도 명칭이 아니다.
편집 해설 근거: Dov Dori, On Bridging the Analysis–Design and Structure–Behavior Grand Canyons with Object Paradigms (1996), 저자 제공 원문 — printed p. 26 — object, dynamic and functional models
17. 소프트웨어를 개발하기 위한 비즈니스(업무)를 객체와 속성, 클래스와 멤버, 전체와 부분 등으로 나누어서 분석해 내는 기법은?
- 객체지향 분석
- 구조적 분석
- 기능적 분석
- 실시간 분석
정답과 해설 보기
정답: 1
정답은 ①이다. 객체지향 분석은 업무 영역의 대상을 객체와 클래스로 식별하고, 객체의 상태를 이루는 속성과 제공해야 할 동작, 다른 객체와의 관계를 모델링한다. 예를 들어 주문과 주문 항목을 전체·부분 관계로 보고 각 항목의 수량과 가격 및 주문의 처리 동작을 함께 분석할 수 있다. 구조적·기능적 분석은 주로 기능의 분해와 자료 흐름에 초점을 둔다는 점에서 관점이 다르다. 실시간이라는 말은 시간 제약의 성격을 나타내며 그 자체가 문제에 제시된 객체 중심 분류의 이름은 아니다.
선지별 해설
- 객체·클래스·속성·동작과 관계를 중심으로 업무를 분석한다.
- 주요 기능과 자료 흐름을 분해하는 관점에 가깝다.
- 수행해야 하는 기능과 기능의 구성을 중심으로 보는 관점이다.
- 시간 제약이 중요한 시스템의 성격으로 객체 중심 분석 기법의 명칭과 다르다.
편집 해설 근거: Harry C. Harrison, NASA Guide to Object-Oriented Analysis and Design (1992) — Terminology; Object Diagrams, printed pp. XVII-1–XVII-3
18. 애자일 소프트웨어 개발 기법의 가치가 아닌 것은?
[학습용 개정문항]
- 프로세스와 도구보다 개인과 상호작용에 더 가치를 둔다.
- 계약 협상보다 고객과의 협력에 더 가치를 둔다.
- 작동하는 소프트웨어보다 포괄적인 문서에 더 가치를 둔다.
- 계획을 따르기보다 변화에 대응하는 것에 더 가치를 둔다.
정답과 해설 보기
정답: 3
정답은 ③이다. 애자일 선언은 포괄적인 문서보다 작동하는 소프트웨어에 더 높은 가치를 둔다. 따라서 문서 쪽을 더 중시한다고 한 ③은 선언의 우선순위를 거꾸로 표현했다. 다른 가치쌍은 프로세스와 도구보다 개인과 상호작용, 계약 협상보다 고객과의 협력, 계획 준수보다 변화에 대한 대응이다. 오른쪽 항목을 아무 가치도 없는 것으로 보지는 않는다. 필요한 문서와 계획, 도구, 계약을 유지하면서 실제 동작과 협력 및 상황 변화에 맞춘 판단을 더 중시한다.
선지별 해설
- 프로세스와 도구보다 개인과 상호작용을 더 중시한다.
- 계약 협상보다 고객과의 협력을 더 중시한다.
- 문서와 작동하는 소프트웨어의 가치 우선순위를 뒤집었다.
- 계획 자체의 고수보다 변화에 대응하는 능력을 더 중시한다.
편집 해설 근거: Manifesto for Agile Software Development (2001) — Four values; statement about valuing the items on the right
19. UML 다이어그램 중 시스템 내 클래스의 정적 구조를 표현 하고 클래스와 클래스, 클래스의 속성 사이의 관계를 나타 내는 것은?
[학습용 개정문항]
- Activity Diagram
- Sequence Diagram
- State Machine Diagram
- Class Diagram
정답과 해설 보기
정답: 4
정답은 ④이다. 클래스 다이어그램은 클래스의 이름, 속성, 연산과 클래스 사이의 연관·일반화 등의 관계를 통해 시스템의 정적인 구조를 표현한다. 객체가 특정 시점에 갖는 실제 값과 연결을 그리는 인스턴스 관점과도 구별된다. 활동 다이어그램은 처리 흐름, 시퀀스 다이어그램은 참여자의 메시지 순서, 상태 머신 다이어그램은 상태와 전이를 표현한다. 원문의 불분명한 Modea 명칭을 시퀀스 다이어그램으로 바꾸어 네 가지 명확한 UML 종류의 목적을 비교하도록 했다.
선지별 해설
- 활동과 처리·제어 흐름을 표현한다.
- 참여자 사이의 메시지와 상호작용 순서를 표현한다.
- 상태와 사건에 따른 전이를 표현한다.
- 클래스의 속성·연산과 클래스 사이의 정적인 관계를 표현한다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §11.4 Classes; Annex A Diagrams
20. 소프트웨어 설계시 제일 상위에 있는 main user function에 서 시작하여 기능을 하위 기능들로 분할해 가면서 설계하는 방식은?
- 객체 지향 설계
- 데이터 흐름 설계
- 상향식 설계
- 하향식 설계
정답과 해설 보기
정답: 4
정답은 ④이다. 하향식 설계는 상위 수준의 주요 기능에서 출발하여 이를 더 작은 하위 기능으로 분해하고 세부 내용을 구체화한다. 전체 목적과 하위 기능의 책임 관계를 먼저 정리한다는 특징이 있다. 반대로 이미 사용할 수 있는 작은 구성요소를 조합해 상위 기능을 만드는 방향은 상향식이다. 객체지향은 무엇을 기준으로 구조를 나눌지에 관한 설계 관점이고 하향식은 구체화하는 방향이므로 둘이 항상 배타적인 것은 아니다. 이 문항은 상위에서 하위로 분할하는 방향을 묻는다.
선지별 해설
- 객체와 책임·협력을 중심으로 구조를 잡는 관점이며 분해 방향의 이름과 다르다.
- 자료 흐름을 바탕으로 구조를 설계하는 관점으로 방향 자체의 이름이 아니다.
- 작은 구성요소를 조합하여 상위 구조를 만드는 반대 방향이다.
- 주요 상위 기능을 하위 기능으로 나누며 구체화하는 방향이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §5.1 General Strategies; §5.2 Function-Oriented (or Structured) Design
정보처리기사 필기 기출문제 · 소프트웨어 개발
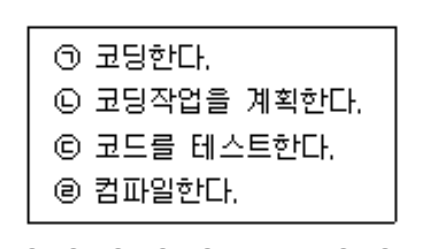
21. 이미지의 네 작업을 컴파일 언어 프로그램의 일반적인 구현 순서로 나열한 것은? 여기서 ㉢은 컴파일을 마친 프로그램을 실행하여 시험하는 작업이다.
[학습용 개정문항]
- ㉠-㉡-㉢-㉣
- ㉡-㉠-㉣-㉢
- ㉢-㉠-㉡-㉣
- ㉣-㉡-㉠-㉢
정답과 해설 보기
정답: 2
정답은 ②이다. 제시된 네 작업을 컴파일 언어의 일반적인 구현 흐름으로 나열하면 작업 계획 ㉡, 코딩 ㉠, 컴파일 ㉣, 실행을 통한 테스트 ㉢ 순서다. 먼저 구현할 기능과 작업을 정하고 소스 코드를 작성한 뒤, 컴파일에서 구문과 형식 등의 오류를 확인한다. 컴파일이 성공하더라도 요구한 동작이 보장되는 것은 아니므로 테스트가 필요하다. 실제 개발에서는 오류를 발견하면 코딩과 컴파일·테스트를 반복하며, 이 순서가 테스트 설계를 코딩 후에만 해야 한다는 뜻은 아니다.
선지별 해설
- 작업 계획보다 코딩이 먼저이고 컴파일 전에 실행 테스트를 배치했다.
- 계획→코딩→컴파일→실행 테스트의 순서다.
- 이 문항의 실행 테스트를 코드 작성보다 앞에 배치했다.
- 소스 코드 작성보다 컴파일을 먼저 배치했다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Construction §3.3 Coding; §3.4 Construction Testing
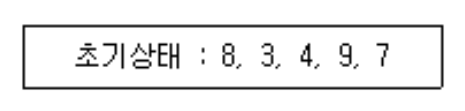
22. 이미지의 초기 배열 [8, 3, 4, 9, 7]을 선택 정렬로 오름차순 정렬한다. 각 PASS에서 미정렬 구간의 최소값을 그 구간의 첫 원소와 교환할 때 PASS 3 직후의 배열은?
[학습용 개정문항]
- 3, 4, 7, 9, 8
- 3, 4, 8, 9, 7
- 3, 8, 4, 9, 7
- 3, 4, 7, 8, 9
정답과 해설 보기
정답: 1
정답은 ①이다. 미정렬 구간에서 최소값을 골라 그 구간의 첫 원소와 교환하는 선택 정렬을 적용한다. 초기 배열은 [8, 3, 4, 9, 7]이다. PASS 1에서 3과 8을 교환하여 [3, 8, 4, 9, 7], PASS 2에서 남은 최소값 4와 8을 교환하여 [3, 4, 8, 9, 7]이 된다. PASS 3에서는 7과 8을 교환하므로 [3, 4, 7, 9, 8]이다. 마지막 두 원소 9와 8은 아직 정렬되지 않았으며 그 교환은 다음 PASS에서 이루어진다.
선지별 해설
- 세 번째 최소값 7을 세 번째 위치에 놓은 PASS 3의 결과다.
- PASS 2를 마친 결과다.
- PASS 1을 마친 결과다.
- PASS 4까지 진행한 최종 오름차순 결과다.
편집 해설 근거: NIST DADS — selection sort — Definition; Note — swapping the least remaining item
23. 하향식 통합시험을 위해 일시적으로 필요한 조건만을 가지 고 임시로 제공되는 시험용 모듈은?
- Stub
- Driver
- Procedure
- Function
정답과 해설 보기
정답: 1
정답은 ①이다. 하향식 통합시험은 상위 모듈에서 하위 모듈 방향으로 통합하므로 아직 준비되지 않은 하위 모듈을 대신할 시험 대역이 필요할 수 있다. 스텁은 상위 모듈의 호출을 받아 정해진 결과를 반환하는 등 해당 시험에 필요한 동작을 제공한다. 반대로 시험 대상 모듈을 호출하고 입력을 전달하는 상위 호출자 역할은 드라이버다. 스텁이 실제 하위 모듈의 모든 동작을 구현해야 하는 것은 아니지만, 시험 목적에 필요한 인터페이스와 응답을 충족해야 한다.
선지별 해설
- 호출받는 하위 모듈을 대신하여 필요한 응답을 제공한다.
- 시험 대상 모듈을 호출하는 상위 호출자 역할을 한다.
- 일반적인 처리 절차 또는 프로그램 단위를 가리키며 해당 시험 대역의 명칭이 아니다.
- 일반적인 함수 단위를 가리키며 하위 모듈 대역의 역할명과 다르다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Testing §8.2 Categories of Tools — Test harnesses
24. 이미지의 전위식을 후위식으로 바르게 변환한 것은?
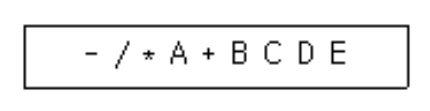
- A B C + D / * E –
- A B * C D / + E –
- A B * C + D / E –
- A B C + * D / E –
정답과 해설 보기
정답: 4
정답은 ④이다. 전위식 – / * A + B C D E에서 맨 앞의 -가 전체 식의 연산자다. 왼쪽 피연산자는 / * A + B C D이고 오른쪽은 E이다. 안쪽부터 보면 + B C는 B+C, * A + B C는 A×(B+C), 이어서 그 값을 D로 나누고 E를 뺀다. 후위식은 각 부분식의 두 피연산자를 먼저 적고 연산자를 뒤에 적으므로 B C +, A B C + *, A B C + * D /, 마지막으로 A B C + * D / E – 순서로 구성된다.
선지별 해설
- A×((B+C)/D)-E의 트리이며 원래 곱셈·나눗셈의 묶음과 다르다.
- A×B+C/D-E의 구조로 바뀐다.
- (A×B+C)/D-E의 구조로 바뀐다.
- (A×(B+C))/D-E의 연산 트리를 그대로 보존한다.
편집 해설 근거: GNU dc manual — reverse Polish notation — Introduction; Arithmetic — reverse Polish notation
25. 그래프의 특수한 형태로 노드(Node)와 선분(Branch)으로 되 어 있고, 정점 사이에 사이클(Cycle)이 형성되어 있지 않으 며, 자료 사이의 관계성이 계층 형식으로 나타나는 비선형 구조는?
- tree
- network
- stack
- distributed
정답과 해설 보기
정답: 1
정답은 ①이다. 트리는 연결되어 있으면서 사이클이 없는 그래프이며, 루트를 정하면 각 노드의 부모와 자식 관계를 통해 계층을 표현할 수 있다. 예를 들어 폴더 구조를 상위 폴더와 하위 폴더의 관계로 나타낼 때 이러한 계층적 관점을 사용한다. 스택처럼 모든 원소를 하나의 순서로 다루는 선형 구조와는 다르다. 사이클이 없다는 조건만으로는 서로 떨어진 여러 트리의 집합인 포리스트도 가능하므로, 한 트리를 정의할 때에는 연결성 조건도 함께 살핀다.
선지별 해설
- 연결되고 사이클이 없는 그래프로 계층 관계를 표현한다.
- 일반적인 네트워크는 사이클과 여러 경로를 가질 수 있다.
- 한쪽 끝에서 삽입·삭제하는 선형 구조다.
- 분산이라는 배치 방식이지 제시한 계층형 자료구조의 명칭이 아니다.
편집 해설 근거: NIST DADS, tree — Definition; formal definition
26. 스택에 대한 설명으로 틀린 것은?
- 입출력이 한쪽 끝으로만 제한된 리스트이다.
- Head(front)와 Tail(rear)의 2개 포인터를 갖고 있다.
- LIFO 구조이다.
- 더 이상 삭제할 데이터가 없는 상태에서 데이터를 삭제 하면 언더플로(Underflow)가 발생한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 기본 스택은 top이라는 한쪽 끝에서만 원소를 넣고 빼는 후입선출 구조다. A를 넣은 다음 B를 넣으면 먼저 꺼내는 것은 B이다. front와 rear로 삽입·삭제할 양쪽 끝을 관리하는 설명은 일반적인 큐 구현에 해당한다. 스택이 비어 있는데 삭제나 팝을 시도하는 상황은 언더플로로 부르며 실제 처리 방식은 구현에 따라 예외·오류 값 등이 될 수 있다. 내부에 어떤 포인터나 필드를 두는지는 구현 선택이므로, 스택의 핵심은 저장 변수의 개수보다 접근 규칙이다.
선지별 해설
- 기본 스택은 동일한 끝에서 삽입과 삭제를 수행한다.
- 큐의 front·rear 관리 방식을 스택의 필수 특성으로 설명했다.
- 가장 나중에 넣은 항목을 먼저 꺼내는 LIFO다.
- 빈 스택에서 원소를 꺼내려는 상황은 언더플로다.
편집 해설 근거: NIST DADS, stack — Definition; NIST DADS — queue — Definition
27. 다음 중 콘텐츠의 이용 권한을 직접 집행하는 DRM 기능보다 네트워크 트래픽의 허용·차단을 주된 목적으로 하는 기술은?
[학습용 개정문항]
- 키관리
- 방화벽
- 암호화
- 크랙방지
정답과 해설 보기
정답: 2
정답은 ②이다. DRM에서 콘텐츠 암호화는 권한 없이 내용을 읽는 일을 어렵게 하고, 키 관리는 허용된 사용자나 기기에 필요한 복호화 권한을 전달하고 관리한다. 라이선스 조건을 우회하거나 클라이언트를 변조하는 행위에 대응하는 보호 기능도 권리 집행을 돕는다. 방화벽의 직접적인 역할은 네트워크 사이의 트래픽을 정책에 따라 허용하거나 차단하는 것이다. DRM 서비스를 운영하는 서버를 방화벽으로 보호할 수는 있지만, 그것이 콘텐츠의 사용 권한을 직접 집행하는 기능과 같지는 않다.
선지별 해설
- 콘텐츠 키와 라이선스의 발급·보관·사용을 관리한다.
- 네트워크 트래픽 통제 기능으로 콘텐츠 권리 집행 기능과 구별된다.
- 허가되지 않은 콘텐츠 열람을 제한하는 데 사용한다.
- 라이선스 집행을 우회하는 변조에 대응하는 보호를 뜻한다.
편집 해설 근거: Microsoft PlayReady, Content Encryption (2026-10-05 확인) — Content Encryption; Microsoft PlayReady, Licensing FAQ, 아키텍처 역할 설명 — How does Microsoft PlayReady work?; renewability; NIST SP 800-41 Rev.1, Guidelines on Firewalls and Firewall Policy (2009) — §2 Overview of Firewall Technologies
28. 여러 개의 선택 항목 중 하나의 선택만 가능한 경우 사용하 는 사용자 인터페이스(UI)요소는?
- 토글 버튼
- 텍스트 박스
- 라디오 버튼
- 체크 박스
정답과 해설 보기
정답: 3
정답은 ③이다. 라디오 버튼 그룹은 관련된 여러 선택지 가운데 한 항목을 선택하도록 구성한다. 같은 그룹에서 다른 항목을 선택하면 이전 항목의 선택이 해제된다. 배송 방법 중 일반 배송과 빠른 배송을 고르는 상황이 예다. 체크박스는 여러 독립 항목을 각각 선택할 때, 텍스트 박스는 글자를 입력할 때, 토글 버튼은 특정 상태를 켜거나 끌 때 주로 사용한다. 처음부터 반드시 하나가 선택되어야 하는지는 초기값과 필수 입력 검증으로 정하며, 그룹에 아직 선택된 항목이 없는 초기 상태도 가능하다.
선지별 해설
- 하나의 상태를 켜거나 끄는 조작에 주로 사용한다.
- 자유로운 문자 입력을 받는 요소다.
- 같은 그룹의 선택지 가운데 하나를 고르는 요소다.
- 서로 독립된 여러 항목의 선택 여부를 각각 정할 수 있다.
편집 해설 근거: W3C WAI-ARIA Authoring Practices, Radio Group Pattern — About This Pattern; Keyboard Interaction
29. 소프트웨어의 일부분을 다른 시스템에서 사용할 수 있는 정 도를 의미하는 것은?
- 신뢰성(Reliability)
- 유지보수성(Maintainability)
- 가시성(Visibility)
- 재사용성(Reusability)
정답과 해설 보기
정답: 4
정답은 ④이다. 재사용성은 한 시스템을 위해 만든 자산이나 구성요소를 다른 시스템 또는 다른 자산의 구축에 활용할 수 있는 정도다. 예를 들어 특정 화면과 강하게 결합되지 않은 날짜 검증 모듈은 여러 프로그램에서 다시 사용할 수 있다. 신뢰성은 주어진 조건에서 요구한 기능을 계속 수행하는 성질이고 유지보수성은 수정·분석·시험 등을 수행하기 쉬운 성질이다. 재사용성은 두 특성과 관련될 수 있지만 같은 뜻은 아니다. 재사용할 수 있다는 판단에는 인터페이스와 의존성, 사용 조건도 함께 고려한다.
선지별 해설
- 지정한 조건과 기간에서 기능을 수행하는 능력에 관한 특성이다.
- 제품을 효과적·효율적으로 수정하고 관리하는 정도다.
- 진행 상태나 내부 정보를 볼 수 있는 정도라는 문맥에 쓰이며 이 정의와 다르다.
- 구성요소나 자산을 다른 시스템에서도 사용할 수 있는 정도다.
편집 해설 근거: ISO/IEC 25010:2011, Software quality model (문항에 명시한 구판) — §4.2.7.2 Reusability
30. 자료구조에 대한 설명으로 틀린 것은?
- 큐는 비선형구조에 해당한다.
- 큐는 First In – First Out 처리를 수행한다.
- 스택은 Last In – First out 처리를 수행한다.
- 스택은 서브루틴 호출, 인터럽트 처리, 수식 계산 및 수 식 표기법에 응용된다.
정답과 해설 보기
정답: 1
정답은 ①이다. 기본 큐는 원소를 선형적인 순서로 관리하며 먼저 넣은 원소를 먼저 꺼내는 FIFO 규칙을 따른다. 원형 배열이나 연결 리스트로 구현하더라도 이러한 논리적 순서는 유지된다. 스택 역시 선형 구조지만 가장 나중에 넣은 원소를 먼저 꺼내는 LIFO 규칙을 따른다. 함수 호출에서 복귀할 정보를 역순으로 회수하거나 후위 표기식을 계산할 때 스택을 사용할 수 있다. 트리나 일반 그래프처럼 여러 갈래의 연결 관계를 직접 표현하는 구조를 비선형 구조로 구별한다.
선지별 해설
- 기본 큐는 선형 자료구조이므로 비선형이라는 설명이 틀렸다.
- 기본 큐는 먼저 들어온 원소를 먼저 꺼낸다.
- 스택은 마지막에 들어온 원소를 먼저 꺼낸다.
- 복귀 정보 관리와 수식 처리 등에 스택을 활용할 수 있다.
편집 해설 근거: NIST DADS — queue — Definition; NIST DADS, stack — Definition; Note
31. 다음 중 블랙박스 검사 기법은?
- 경계값 분석
- 조건 검사
- 기초 경로 검사
- 루프 검사
정답과 해설 보기
정답: 1
정답은 ①이다. 경계값 분석은 입력이나 출력 영역을 순서가 있는 동등 분할로 나누고 그 경계와 가까운 값을 선택하는 명세 기반 시험 기법이다. 허용 나이가 정수 18부터 65까지라면 17·18·19와 64·65·66처럼 경계의 안팎을 확인할 수 있다. 내부 소스 코드의 분기 구조를 알지 않아도 요구사항의 범위로 시험값을 정할 수 있다는 점에서 블랙박스 기법이다. 조건, 기초 경로, 루프 검사는 프로그램 내부의 제어 구조를 살피는 구조 기반 시험에 해당한다.
선지별 해설
- 명세에 정의된 유효·무효 구간의 경계를 시험한다.
- 프로그램 조건식의 참·거짓 등을 살피는 구조 기반 시험이다.
- 제어 흐름 그래프의 독립적인 경로를 살피는 구조 기반 시험이다.
- 반복문의 수행 횟수와 경계를 코드 구조에 따라 살피는 시험이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §4.2.2 Boundary Value Analysis; §4.3 White-box Test Techniques
32. 이진 검색 알고리즘에 대한 설명으로 틀린 것은?
- 탐색 효율이 좋고 탐색 시간이 적게 소요된다.
- 검색할 데이터가 정렬되어 있어야 한다.
- 피보나치 수열에 따라 다음에 비교할 대상을 선정하여 검색한다.
- 비교횟수를 거듭할 때마다 검색 대상이 되는 데이터의 수가 절반으로 줄어든다.
정답과 해설 보기
정답: 3
정답은 ③이다. 이진 검색은 정렬된 검색 구간의 중간 원소와 목표값을 비교한다. 같으면 찾은 것이고, 다르면 정렬 순서에 따라 왼쪽 또는 오른쪽 절반만 다음 검색 구간으로 남긴다. 따라서 임의 접근이 가능한 배열에서는 비교 횟수가 로그 규모로 증가한다. 피보나치 수열에 따라 비교 지점을 고르는 것은 이진 검색의 정의가 아니다. 원소 수가 홀수이거나 중간 원소를 제외할 때에는 남은 수가 정확히 절반은 아닐 수 있으므로, 매번 대략 절반 이하로 줄인다는 의미로 이해한다.
선지별 해설
- 정렬된 배열에서 비교 횟수가 로그 규모로 증가하여 효율적이다.
- 중간값으로 어느 쪽을 버릴지 판단하려면 정렬되어 있어야 한다.
- 피보나치 수열로 비교 지점을 정하는 것은 이진 검색의 규칙이 아니다.
- 중간 원소 비교 뒤 한쪽 구간을 버려 남은 범위를 줄인다.
편집 해설 근거: NIST DADS, binary search — Definition; Note
33. 소프트웨어 품질목표 중 쉽게 배우고 사용할 수 있는 정도 를 나타내는 것은?
- Correctness
- Reliability
- Usability
- Integrity
정답과 해설 보기
정답: 3
정답은 ③이다. 사용성은 사용자가 목적을 달성하도록 제품을 이해하고 배우고 조작할 수 있는 성질과 관련된다. 처음 사용하는 사람이 주요 기능을 쉽게 찾고, 수행 순서를 배우며, 오류를 알아차리고 복구할 수 있는지가 대표적인 판단 대상이다. 정확성은 명세에 맞는 결과를 내는지, 신뢰성은 주어진 조건에서 기능을 지속적으로 수행하는지, 무결성은 허가되지 않은 변경 등으로부터 정보를 지키는지에 초점을 둔다. 이 문항의 핵심 단서인 배우기 쉬움과 사용하기 쉬움은 사용성을 가리킨다.
선지별 해설
- 요구·명세와 결과가 맞는지에 관한 정확성이다.
- 지정한 조건에서 기능을 지속적으로 수행하는 신뢰성이다.
- 배우고 이해하고 조작하기 쉬운 사용성이다.
- 정보의 정확성·완전성과 부적절한 변경 방지에 관한 무결성이다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.4451 usability; ISO/IEC 25010:2011, Software quality model (문항에 명시한 구판) — §4.2.4 Usability — Learnability; Operability
34. 테스트 케이스에 일반적으로 포함되는 항목이 아닌 것은?
- 테스트 조건
- 테스트 데이터
- 테스트 비용
- 예상 결과
정답과 해설 보기
정답: 3
정답은 ③이다. 테스트 케이스는 어떤 조건에서 무엇을 입력하거나 수행하고 어떤 결과를 기대하는지를 구체적으로 정한 것이다. 실행 전 필요한 상태, 입력 데이터, 수행 조건과 예상 결과 등을 기록하면 다른 사람이 같은 시험을 반복하고 통과 여부를 판단할 수 있다. 테스트 비용은 예산 산정과 시험 계획에서 관리할 수 있지만, 개별 케이스의 동작과 기대 결과를 정의하는 기본 요소는 아니다. 조직의 양식에 비용 필드를 추가할 수 없다는 뜻은 아니며, 문항은 일반적인 핵심 구성요소를 묻는다.
선지별 해설
- 시험할 조건이나 실행 전·실행 중 필요한 조건을 기록한다.
- 시험에 사용할 입력값과 관련 자료를 정한다.
- 예산·계획에서 관리할 수 있으나 케이스 정의의 기본 요소는 아니다.
- 실제 결과와 비교할 기준을 미리 명시한다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.4210 test case; ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §1.4.3 Test Design; §1.4.4 Test Work Products
35. 사용자가 제품을 설치·초기 설정하고 필요할 때 제거하도록 안내하는 설치 매뉴얼의 핵심 내용과 가장 관련성이 낮은 것은?
[학습용 개정문항]
- 제품 소프트웨어 개요
- 설치 관련 파일
- 프로그램 삭제
- 소프트웨어 개발 기간
정답과 해설 보기
정답: 4
정답은 ④이다. 설치 매뉴얼의 목적은 사용자가 필요한 환경과 파일을 준비하여 제품을 설치하고 초기 설정을 마칠 수 있게 하는 것이다. 제품의 역할과 지원 환경, 설치 파일의 위치, 순서별 작업, 설치 확인과 제거 방법은 이 목적에 직접 도움이 된다. 소프트웨어를 개발하는 데 걸린 기간은 개발 이력이나 프로젝트 관리 정보에 가깝다. 그러한 정보를 부록에 적을 수는 있어도 사용자의 설치 작업에 필요한 핵심 안내와는 거리가 있으므로 네 보기 중 가장 관련성이 낮다.
선지별 해설
- 무엇을 설치하는지와 제품의 적용 범위를 이해하는 데 도움이 된다.
- 설치 패키지와 필요한 파일을 준비하는 데 필요하다.
- 설치된 프로그램을 안전하게 제거하는 절차를 안내할 수 있다.
- 개발 이력에 가까우며 설치 수행을 위한 핵심 정보가 아니다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.2006 installation manual; Google Developer Documentation Style Guide, Procedures (2026-10-05 확인) — Introductory sentences; Steps with results or justifications
36. 소프트웨어 형상관리(Configuration management)에 관한 설명으로 틀린 것은?
[학습용 개정문항]
- 소프트웨어의 수정·변경을 식별하고 통제하는 활동을 포함한다.
- 변경 혼란과 재작업을 줄여 개발·유지보수 비용 관리에 도움을 준다.
- 형상관리를 위하여 구성된 조직의 일반 명칭은 chief programmer team이다.
- 버전 제어와 변경 이력 관리가 형상관리 기능에 포함된다.
정답과 해설 보기
정답: 3
정답은 ③이다. 형상관리는 관리할 항목과 버전을 식별하고, 변경을 통제하며, 변경 상태를 기록하고, 실제 결과가 승인 내용과 일치하는지 확인한다. 변경 요청을 검토하고 승인하는 조직은 형상통제위원회 또는 변경통제위원회로 구성할 수 있다. Chief programmer team은 책임 프로그래머와 보조 프로그래머 등으로 이루어진 소프트웨어 개발팀 구조를 가리키며 형상관리 조직의 일반 명칭이 아니다. 형상관리는 혼란과 재작업을 줄이는 데 도움이 되지만 모든 비용 감소와 방해 요인 제거를 보장하지는 않는다.
선지별 해설
- 변경을 식별하고 승인·기록·통제하는 활동을 포함한다.
- 변경 혼란과 재작업을 줄여 개발과 유지보수를 지원한다.
- 책임 프로그래머 중심 개발팀의 이름을 형상관리 조직의 일반 명칭으로 잘못 설명했다.
- 형상 항목의 버전과 이력을 관리하는 기능을 포함한다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Configuration Management — Configuration Identification; Configuration Control; Status Accounting; Auditing; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.565 chief programmer team; configuration control board
37. 퀵 정렬에 관한 설명으로 옳은 것은?
[학습용 개정문항]
- 키의 자릿값 등을 기준으로 버킷에 분배하고 버킷 순서대로 모으는 과정을 반복한다.
- 인접한 두 원소를 비교하여 순서가 맞지 않으면 교환하는 과정을 반복한다.
- 피벗을 기준으로 원소를 분할하고 각 부분을 재귀적으로 정렬한다.
- 간격 h만큼 떨어진 원소들로 이루어진 부분열을 정렬하고 간격을 줄여 반복한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 퀵 정렬은 피벗을 기준으로 원소들을 분할한 뒤 각 부분을 다시 정렬하는 분할 정복 방식이다. 분할하면서 실제 원소 교환이나 이동이 일어날 수 있으므로 자료 이동을 없애는 알고리즘이라고 정의하지는 않는다. 버킷으로 분배했다가 모으는 설명은 분배 계열 정렬, 인접 원소를 반복 비교·교환하는 설명은 버블 정렬, 일정 간격으로 떨어진 원소를 처리하는 설명은 셸 정렬과 관련된다. 피벗 선택과 분할이 크게 불균형하면 퀵 정렬의 수행 시간은 최악에 이차 규모가 될 수 있다.
선지별 해설
- 버킷을 이용한 분배 계열 정렬의 접근이다.
- 인접 원소의 반복 비교·교환은 버블 정렬의 특징이다.
- 피벗을 기준으로 분할하고 각 부분을 다시 정렬하는 퀵 정렬의 특징이다.
- 간격을 둔 부분열을 정렬하는 셸 정렬의 접근과 관련된다.
편집 해설 근거: NIST DADS, quicksort — Definition; Note
38. 해싱 함수(Hashing Function)의 종류가 아닌 것은?
- 제곱법(mid-square)
- 숫자분석법(digit analysis)
- 개방주소법(open addressing)
- 제산법(division)
정답과 해설 보기
정답: 3
정답은 ③이다. 해시 함수는 키로부터 처음 접근할 테이블 위치를 계산한다. 제곱법은 키를 제곱한 결과의 중간 부분을 사용하고, 숫자분석법은 키의 자릿값 분포를 분석하여 주소 구성에 적합한 일부 자리를 고른다. 제산법은 일반적으로 키를 테이블 크기 등에 대해 나눈 나머지를 사용한다. 개방주소법은 서로 다른 키가 같은 위치에 배정되는 충돌이 생겼을 때 같은 테이블 안의 다른 위치들을 탐사하는 해결 방식이다. 주소 생성 규칙과 충돌 뒤의 처리 전략을 구별해야 한다.
선지별 해설
- 키 제곱값의 중간 부분에서 해시 주소를 구성한다.
- 키 자릿값의 분포를 분석하여 주소에 사용할 부분을 정한다.
- 초기 해시값 계산 방식보다 충돌 후 다른 위치를 찾는 전략이다.
- 나눗셈의 나머지로 초기 위치를 계산하는 방법이다.
편집 해설 근거: Sartaj Sahni, Data Structures, Algorithms, & Applications in C++ (2004), Hash Functions — Hash Functions — Middle Of Square; Digit Analysis; introductory paragraph; NIST DADS, open addressing — Definition
39. 실제 또는 잠재적 사용자가 자신의 사용 환경에 소프트웨어를 설치하여 수행하며 현장 시험(field testing)으로도 부르는 인수시험 형태는?
[학습용 개정문항]
- 베타 검사
- 알파 검사
- 형상 검사
- 복구 검사
정답과 해설 보기
정답: 1
정답은 ①이다. 베타 테스트는 실제 또는 잠재적 사용자 측 환경에서 사용자가 수행하는 인수시험 형태다. 개발 조직의 시험 환경만으로 드러나지 않는 사용상의 문제와 실제 환경의 적합성을 확인하는 데 도움이 된다. 알파 테스트는 개발 조직의 환경에서 잠재적·기존 사용자 또는 독립적인 시험자가 수행하는 경우로 구별한다. 베타 테스트에서 개발자가 현장에 상주하지 않을 수 있지만 피드백 수집과 결함 지원에 관여하지 않는다는 뜻은 아니다. 형상 감사와 장애 복구 능력 시험은 이 환경 기반 분류와 다르다.
선지별 해설
- 사용자 측 환경에서 실제·잠재적 사용자가 수행하는 인수시험이다.
- 개발 조직의 환경에서 수행하는 인수시험 형태다.
- 승인된 형상과 실제 산출물의 일치 등을 확인하는 활동이다.
- 장애 뒤 기능과 상태를 복원하는 능력을 확인하는 시험이다.
편집 해설 근거: ISTQB CTFL Syllabus 2018 v3.1.1 — §2.2.4 Acceptance Testing — Alpha and Beta Testing
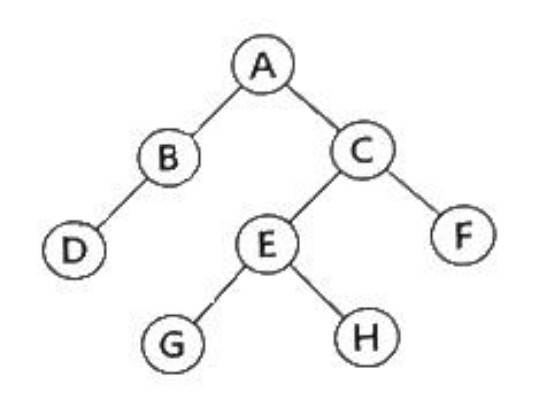
40. 이미지의 트리를 전위 순회할 때 다섯 번째로 방문하는 노드는?
- C
- E
- G
- H
정답과 해설 보기
정답: 2
정답은 ②이다. 이진 트리의 전위 순회는 현재 노드를 먼저 방문한 후 왼쪽 부분 트리, 오른쪽 부분 트리를 같은 규칙으로 처리한다. 그림에서 A를 방문한 뒤 왼쪽의 B와 그 자식 D를 방문한다. 왼쪽 부분을 마치면 오른쪽의 C로 이동하고 그 왼쪽 자식 E, 이어서 E의 자식 G와 H, 마지막으로 C의 오른쪽 자식 F를 방문한다. 전체 순서는 A→B→D→C→E→G→H→F이므로 다섯 번째는 E이다. 단순히 깊이가 낮은 노드부터 읽는 레벨 순회와 구별한다.
선지별 해설
- C는 네 번째 방문 노드다.
- E는 다섯 번째 방문 노드다.
- G는 여섯 번째 방문 노드다.
- H는 일곱 번째 방문 노드다.
편집 해설 근거: NIST DADS, preorder traversal — Definition; binary tree pseudocode
정보처리기사 필기 기출문제 · 데이터베이스 구축
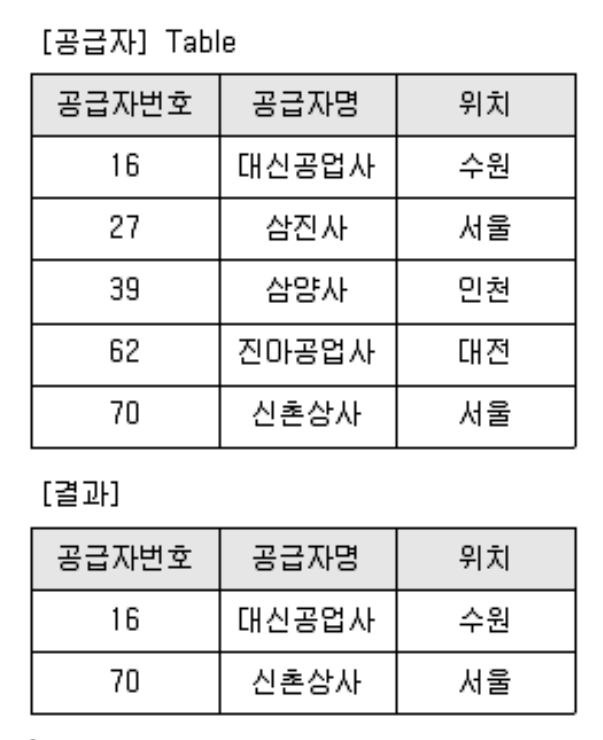
41. 이미지의 공급자 테이블과 결과를 만드는 SQL 질의는?
- SELECT * FROM 공급자 WHERE 공급자명 LIKE '%신%';
- SELECT * FROM 공급자 WHERE 공급자명 LIKE '%대%';
- SELECT * FROM 공급자 WHERE 공급자명 LIKE '%사%';
- SELECT * FROM 공급자 WHERE 공급자명 IS NOT NULL;
정답과 해설 보기
정답: 1
정답은 ①이다. LIKE에서 %는 길이가 0 이상인 임의의 문자열을 뜻하므로 %신%은 이름 안에 신이 포함된 행을 찾는다. 그림의 대신공업사와 신촌상사가 조건을 만족하여 공급자번호 16과 70의 행이 남는다. %대%는 대신공업사만, %사%는 그림의 다섯 공급자 모두를 선택한다. IS NOT NULL은 공급자명에 특정 글자가 있는지를 검사하는 것이 아니라 값이 NULL이 아닌지를 검사하므로 역시 다섯 행을 선택한다. SELECT *는 선택된 행의 모든 열을 반환한다.
선지별 해설
- 신이 들어 있는 대신공업사와 신촌상사 두 행을 선택한다.
- 대가 들어 있는 대신공업사 한 행만 선택한다.
- 그림의 모든 공급자명에 사가 있으므로 다섯 행을 선택한다.
- 그림의 모든 공급자명이 NULL이 아니므로 다섯 행을 선택한다.
편집 해설 근거: PostgreSQL 18, 9.7 Pattern Matching — §9.7.1 LIKE; PostgreSQL 18, Comparison Functions and Operators — IS NULL; IS NOT NULL
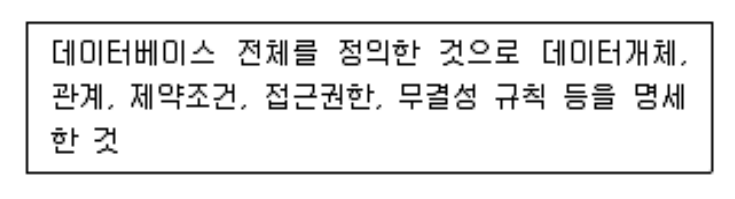
42. 이미지의 설명에 해당하는 데이터베이스 스키마는?
- 개념 스키마
- 내부 스키마
- 외부 스키마
- 내용 스키마
정답과 해설 보기
정답: 1
정답은 ①이다. 3단계 스키마 구조에서 개념 스키마는 데이터베이스 전체를 논리적인 관점으로 설명한다. 어떤 개체와 관계가 존재하는지, 어떤 제약조건과 무결성 규칙을 지켜야 하는지 등을 통합하여 정의한다. 외부 스키마는 특정 사용자나 응용이 보는 일부 관점이고 내부 스키마는 파일 조직과 저장 구조 등 물리적인 표현에 가깝다. 따라서 그림의 전체 데이터와 관계·제약을 정의한다는 설명은 개념 스키마에 해당한다. SQL의 CREATE SCHEMA가 만드는 이름공간과 이 추상화 단계의 용어는 문맥을 구별해야 한다.
선지별 해설
- 데이터베이스 전체의 논리적인 구조와 제약을 정의한다.
- 실제 저장 방식과 접근 구조를 설명하는 관점이다.
- 사용자나 응용별로 필요한 데이터 관점이다.
- 표준적인 3단계 스키마 분류의 이름이 아니다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Introduction — Levels of Abstraction
43. 데이터베이스 설계 단계 중 저장 레코드 양식설계, 레코드 집중의 분석 및 설계, 접근 경로 설계와 관계되는 것은?
- 논리적 설계
- 요구 조건 분석
- 개념적 설계
- 물리적 설계
정답과 해설 보기
정답: 4
정답은 ④이다. 물리적 설계는 논리적으로 정의한 데이터가 실제 저장 장치와 DBMS에서 어떻게 배치되고 접근될지를 정한다. 저장 레코드의 형식, 관련 레코드를 가까이 두는 조직 방식, 인덱스 등의 접근 경로가 여기에 포함된다. 요구 분석은 필요한 데이터와 업무를 파악하고, 개념적 설계는 업무 개체와 관계를 모델링하며, 논리적 설계는 선택한 데이터 모델의 테이블과 제약 등으로 구체화한다. 물리 설계에서는 조회 성능뿐 아니라 갱신 비용과 저장 공간도 함께 고려해야 한다.
선지별 해설
- 테이블·키·관계 등 논리 데이터 구조를 정하는 단계다.
- 필요한 업무와 데이터·처리 요구를 조사하는 단계다.
- 업무 개체와 관계를 추상화하는 단계다.
- 저장 형식·배치·인덱스와 접근 경로를 정하는 단계다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Physical Database Design — Overview; Decisions to Make
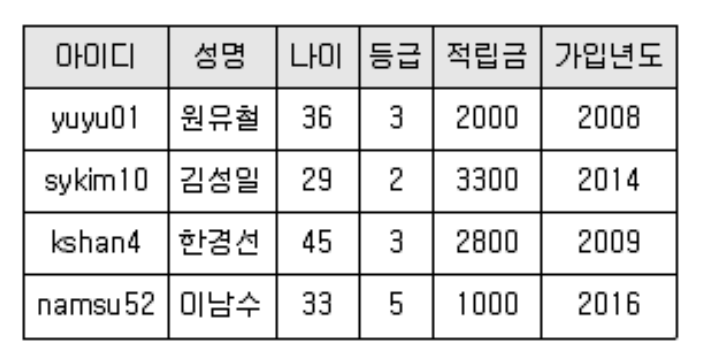
44. 이미지의 릴레이션에서 카디널리티와 차수는 각각 얼마인가?
- 카디널리티 : 4, 차수 : 4
- 카디널리티 : 4, 차수 : 6
- 카디널리티 : 6, 차수 : 4
- 카디널리티 : 6, 차수 : 6
정답과 해설 보기
정답: 2
정답은 ②이다. 릴레이션의 카디널리티는 현재 들어 있는 튜플의 수이고 차수는 속성의 수다. 그림에는 yuyu01, sykim10, kshan4, namsu52에 해당하는 네 데이터 행이 있으므로 카디널리티는 4다. 속성은 아이디·성명·나이·등급·적립금·가입년도의 여섯 열이므로 차수는 6이다. 맨 위의 열 이름은 데이터 튜플로 세지 않는다. 행을 삽입하거나 삭제하면 카디널리티가 달라지지만, 차수를 바꾸려면 속성을 추가하거나 제거하는 스키마 변경이 필요하다.
선지별 해설
- 행 수는 맞지만 여섯 속성을 네 개로 잘못 셌다.
- 데이터 행 4개, 속성 6개다.
- 카디널리티와 차수의 수치를 서로 바꿨다.
- 속성 수는 맞지만 행 수를 여섯 개로 잘못 셌다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relational Database: Definitions
45. 다음 설명에 해당하는 트랜잭션의 ACID 특성은?
[학습용 개정문항]
트랜잭션은 데이터베이스를 무결성 제약을 만족하는 상태에서 다시 그 제약을 만족하는 상태로 옮겨야 한다. 개별 데이터 값이 실행 전후 모두 같아야 한다는 뜻은 아니다.
- 원자성(atomicity)
- 일관성(consistency)
- 격리성(isolation)
- 영속성(durability)
정답과 해설 보기
정답: 2
정답은 ②이다. 일관성은 올바른 트랜잭션이 데이터베이스를 무결성 조건을 만족하는 상태에서 다시 그 조건을 만족하는 상태로 옮기는 성질이다. 계좌 간 이체에서 총액 보존이 규칙이라면 출금과 입금 후에도 총액이 유지되어야 하지만 각 계좌의 잔액 자체는 달라질 수 있다. 원자성은 작업 전체의 성공 또는 취소, 격리성은 동시 실행의 간섭 제어, 영속성은 커밋된 결과의 보존을 뜻한다. 모든 값이 실행 전후 동일해야 한다는 의미로 일관성을 이해해서는 안 된다.
선지별 해설
- 트랜잭션의 일부만 남기지 않고 전체를 완료하거나 취소하는 성질이다.
- 지켜야 할 제약과 무결성 규칙을 완료 후에도 만족하는 성질이다.
- 병행 실행이 서로 부적절하게 간섭하지 않도록 하는 성질이다.
- 성공적으로 커밋한 결과를 장애 뒤에도 보존하는 성질이다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 17 저자 자료 — ACID Properties — Consistency; Fund transfer example
46. 병행제어의 로킹(Locking) 단위에 대한 설명으로 옳지 않은 것은?
- 데이터베이스, 파일, 레코드 등은 로킹 단위가 될 수 있 다.
- 로킹 단위가 작아지면 로킹 오버헤드가 증가한다.
- 한꺼번에 로킹할 수 있는 단위를 로킹단위라고 한다.
- 로킹 단위가 작아지면 병행성 수준이 낮아진다.
정답과 해설 보기
정답: 4
정답은 ④이다. 잠금 단위가 작으면 각 트랜잭션이 실제 필요한 일부 레코드만 잠글 수 있어 서로 다른 부분을 처리하는 작업들이 함께 진행하기 쉬워진다. 반면 같은 양의 데이터를 처리할 때 관리해야 할 잠금 수가 많아져 잠금 획득·해제와 상태 관리 비용이 커질 수 있다. 큰 단위로 잠그면 관리할 잠금 수는 줄지만 서로 관련 없는 데이터까지 함께 잠겨 동시성이 낮아질 수 있다. 실제 효과는 접근 패턴과 DBMS 구현에 따르므로 세밀한 잠금이 언제나 더 빠르다는 뜻은 아니다.
선지별 해설
- 테이블·페이지·레코드 등 여러 크기의 단위를 사용할 수 있다.
- 같은 데이터 범위를 처리하면 더 많은 잠금을 관리하게 될 수 있다.
- 한 번의 잠금 대상으로 삼는 데이터의 범위를 말한다.
- 일반적으로 작은 단위는 서로 다른 데이터에 대한 병행 작업을 늘릴 수 있다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Concurrency Control — Multiple-Granularity Locks
47. PostgreSQL의 일반 뷰(VIEW)에 대한 설명으로 옳지 않은 것은? 물리화 뷰(MATERIALIZED VIEW)는 제외한다.
[학습용 개정문항]
- DBA는 보안 측면에서 뷰를 활용할 수 있다.
- 뷰 위에 또 다른 뷰를 정의할 수 있다.
- 뷰에 대한 삽입, 갱신, 삭제 연산 시 제약사항이 따르지 않는다.
- 독립적인 인덱스를 가질 수 없다.
정답과 해설 보기
정답: 3
정답은 ③이다. 일반 뷰는 질의 정의를 저장하고 참조할 때 기반 테이블에서 결과를 구한다. 특정 행과 열만 노출하도록 구성하여 접근 제한에 활용할 수 있고, 다른 뷰를 참조하는 뷰도 정의할 수 있다. 그러나 집계·그룹화·집합 연산 등이 들어간 뷰는 자동 갱신에 제한이 있으며 어떤 뷰든 자유롭게 삽입·갱신·삭제할 수 있는 것은 아니다. 여기서는 결과를 별도로 저장하는 물리화 뷰를 제외한 PostgreSQL의 일반 뷰를 대상으로 하므로 뷰 자체의 별도 인덱스도 만들지 않는다.
선지별 해설
- 적절한 권한 설정과 함께 공개할 행·열을 제한하는 데 활용할 수 있다.
- 다른 뷰를 질의하는 형태로 정의할 수 있다.
- 일반 뷰도 정의 형태에 따라 갱신 가능 여부에 제약이 있다.
- 결과를 저장하지 않는 일반 뷰 자체에는 별도 인덱스를 만들지 않는다.
편집 해설 근거: PostgreSQL 18 — CREATE VIEW — Description; Notes; Updatable Views; PostgreSQL 18, CREATE INDEX — Description
48. 이미지의 정의에 해당하는 기본 정규형은?
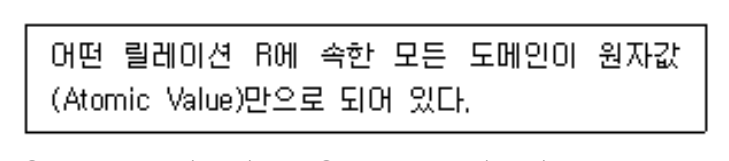
- 제1정규형(1NF)
- 제2정규형(2NF)
- 제3정규형(3NF)
- 보이스/코드 정규형(BCNF)
정답과 해설 보기
정답: 1
정답은 ①이다. 제1정규형은 각 속성의 값이 해당 모델에서 하나의 원자값으로 취급되는 기본 조건을 다룬다. 한 칸에 여러 전화번호를 반복 그룹으로 넣는 형태를 피하고 각각의 값을 적절한 속성과 행으로 표현하는 것이 대표적인 예다. 원자성은 문자열을 문자로 나눌 수 없다는 물리적 뜻이 아니라 관계 모델에서 그 값을 하나로 취급한다는 뜻이다. 제2·제3정규형과 BCNF는 여기에 함수 종속에 관한 더 강한 조건을 추가한다. 따라서 그림에 제시된 조건만으로 그 상위 정규형까지 판정할 수는 없다.
선지별 해설
- 모든 속성값을 원자값으로 취급하는 기본 정규형이다.
- 제1정규형 외에 부분 함수 종속에 관한 조건을 더 요구한다.
- 부분·이행 종속 문제를 통제하는 더 강한 함수 종속 조건을 요구한다.
- 모든 비자명한 함수 종속의 결정자가 슈퍼키여야 한다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — First Normal Form
49. 릴레이션 R1의 외래키가 R2의 기본키를 참조한다. 허용된 NULL을 제외한 R1의 외래키 값은 R2의 참조 대상 키에 존재해야 한다는 제약은?
[학습용 개정문항]
- 정보 무결성
- 고유 무결성
- 널 제약성
- 참조 무결성
정답과 해설 보기
정답: 4
정답은 ④이다. 참조 무결성은 외래키가 가리키는 값이 참조 대상 키에 존재하도록 유지하는 제약이다. 허용되는 NULL 외래키는 별도로 다루며, 참조 대상 키를 바꿀 때에는 설정된 정책에 따라 변경을 거절하거나 참조하는 값도 갱신할 수 있다. 외래키를 다른 기존 키 값으로 바꾸었다고 참조 대상의 기본키까지 항상 바꿔야 하는 것은 아니다. 원문의 참조 방향과 변경 의무 표현을 고쳐, 외래키와 참조 대상 사이의 일치 조건을 묻도록 했다.
선지별 해설
- 이 문항에서 외래키 관계의 일치 조건을 가리키는 구체적인 명칭이 아니다.
- 키 등의 중복을 제한하는 고유성 제약과 구별된다.
- 값을 NULL로 둘 수 있는지에 관한 제약과 구별된다.
- 외래키와 참조 대상 키 사이의 일치를 유지하는 제약이다.
편집 해설 근거: PostgreSQL 18: Constraints — §5.5.5 Foreign Keys
50. 시스템 카탈로그에 대한 설명으로 틀린 것은?
- 시스템 카탈로그의 갱신은 무결성 유지를 위하여 SQL을 이용하여 사용자가 직접 갱신하여야 한다.
- 데이터베이스에 포함되는 데이터 객체에 대한 정의나 명 세에 대한 정보를 유지관리한다.
- DBMS가 스스로 생성하고 유지하는 데이터베이스 내의 특별한 테이블의 집합체이다.
- 카탈로그에 저장된 정보를 메타 데이터라고도 한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 시스템 카탈로그는 테이블·열·자료형·제약·권한 등 데이터베이스 객체에 관한 메타데이터를 DBMS가 관리하는 구조다. CREATE TABLE이나 ALTER TABLE 같은 명령을 실행하면 DBMS가 필요한 검사를 거쳐 카탈로그를 함께 갱신한다. 일반 사용자가 카탈로그의 내부 행을 직접 수정하는 방식으로 객체를 관리해야 한다는 설명은 틀렸다. 제품과 권한에 따라 내부 카탈로그에 접근할 수 있는 경우가 있어도 직접 수정은 일관성을 깨뜨릴 수 있다. 조회 가능성과 직접 갱신의 권장 여부를 구별해야 한다.
선지별 해설
- 지원되는 DDL 등을 사용하면 DBMS가 갱신하며 내부 행의 직접 수정이 일반적인 관리 절차가 아니다.
- 데이터 객체의 정의와 구조에 관한 정보를 보관한다.
- DBMS가 생성·관리하는 특수 테이블 등으로 구현한다.
- 데이터를 설명하는 정보이므로 메타데이터라고 부른다.
편집 해설 근거: PostgreSQL 18, Chapter 52 System Catalogs — Chapter 52 introduction
51. 조건을 만족하는 릴레이션의 수평적 부분집합으로 구성하 며, 연산자의 기호는 그리스 문자 시그마(σ)를 사용하는 관 계대수 연산은?
- Select
- Project
- Join
- Division
정답과 해설 보기
정답: 1
정답은 ①이다. 관계대수의 선택 연산 σ는 주어진 조건을 만족하는 튜플만 남겨 릴레이션의 수평적인 부분집합을 만든다. 예를 들어 나이가 20 이상이라는 조건을 적용하면 그 조건에 맞는 행을 남기고 원래 속성들은 유지한다. 투영 π는 지정한 속성만 남기는 열 방향의 연산이다. 조인은 두 릴레이션의 관련 튜플을 결합하고, 디비전은 주어진 집합의 모든 값과 관련되는 대상을 찾는 상황에 활용한다. 관계대수의 Select와 SQL의 SELECT 문 전체는 역할 범위가 같지 않으며 행 선택은 보통 SQL의 WHERE 조건에 대응한다.
선지별 해설
- 조건을 만족하는 행을 고르는 σ 연산이다.
- 필요한 속성만 고르는 열 방향의 π 연산이다.
- 관련되는 두 릴레이션의 튜플을 결합한다.
- 제수 릴레이션의 모든 값과 대응하는 대상을 찾는 연산이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — Selection; Projection; Division
52. SQL에서 스키마(schema), 도메인(domain), 테이블(table), 뷰(view), 인덱스(index)를 정의하거나 변경 또는 삭제할 때 사용하는 언어는?
- DML(Data Manipulation Language)
- DDL(Data Definition Language)
- DCL(Data Control Language)
- IDL(Interactive Data Language)
정답과 해설 보기
정답: 2
정답은 ②이다. 데이터 정의 언어인 DDL은 데이터베이스 객체의 구조를 생성·변경·제거한다. CREATE TABLE은 테이블을 만들고 ALTER TABLE은 열이나 제약 등을 변경하며 DROP TABLE은 테이블 정의를 제거하는 예다. DML은 이미 정의된 구조 안의 행을 조회하거나 삽입·갱신·삭제하는 조작과 관련된다. DCL은 권한 부여와 회수 같은 접근 통제를 가리킨다. 구체적인 명령과 객체 지원 범위는 DBMS마다 차이가 있지만 구조를 정의하는지, 저장된 데이터를 조작하는지를 기준으로 구별할 수 있다.
선지별 해설
- 테이블 안의 행을 조회·삽입·수정·삭제하는 데이터 조작에 관한 분류다.
- 스키마와 테이블 등 객체의 구조를 정의·변경·삭제하는 분류다.
- 사용 권한을 부여하거나 회수하는 제어에 관한 분류다.
- 제시한 뜻으로 구조 정의 명령을 묶는 일반적인 SQL 분류가 아니다.
편집 해설 근거: PostgreSQL 18: Data Definition — Chapter 5 Data Definition; PostgreSQL 18 — Data Manipulation — Chapter 6 Data Manipulation
53. 정규화를 거치지 않아 발생하게 되는 이상(anomaly) 현상의 종류에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 삭제 이상은 한 사실을 삭제할 때 함께 저장되어 있던 보존할 다른 사실도 잃는 현상이다.
- 삽입 이상은 불필요한 다른 정보 없이는 원하는 새 사실을 기록하기 어려운 현상이다.
- 갱신 이상은 중복 저장된 정보의 일부만 수정되어 불일치가 생기는 현상이다.
- 종속 이상은 함수 종속이 하나라도 존재하는 모든 릴레이션에서 발생하는 이상 현상이다.
정답과 해설 보기
정답: 4
정답은 ④이다. 함수 종속이 존재한다는 사실 자체는 이상 현상이 아니다. 키가 다른 속성을 결정하는 정상적인 관계도 함수 종속으로 표현한다. 문제는 여러 사실을 한 릴레이션에 중복해서 저장할 때 일부 값만 고쳐 모순이 생기는 갱신 이상, 다른 사실도 있어야 새 사실을 넣을 수 있는 삽입 이상, 마지막 행을 지우며 보존할 사실까지 잃는 삭제 이상 등이다. 삭제 이상은 반드시 외래키의 ON DELETE CASCADE 동작을 뜻하지 않는다. 정규화는 종속성을 분석하여 이러한 중복과 이상을 줄이도록 구조를 분해한다.
선지별 해설
- 특정 행을 지우면서 그 안에만 기록된 다른 사실까지 잃는 문제다.
- 불필요한 다른 정보 없이는 원하는 새 사실을 기록하기 어려운 문제다.
- 중복된 정보 중 일부만 갱신하여 불일치가 생기는 문제다.
- 함수 종속의 존재 자체를 별도의 이상 현상으로 보지는 않는다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Chapter 19 저자 자료 — The Evils of Redundancy; Functional Dependencies
54. 전통적인 제1정규형 관계 데이터 모델의 릴레이션에 관한 설명으로 옳은 것은?
[학습용 개정문항]
- 릴레이션의 각 행을 스키마(schema)라 하며, 예로 도서 릴레이션을 구성하는 스키마에서는 도서번호, 도서명, 저 자, 가격 등이 있다.
- 릴레이션의 각 열을 튜플(tuple)이라 하며, 하나의 튜플 은 각 속성에서 정의된 값을 이용하여 구성된다.
- 도메인(domain)은 하나의 속성이 가질 수 있는 같은 타 입의 모든 값의 집합으로 각 속성의 도메인은 원자값을 갖는다.
- 속성(attribute)은 한 개의 릴레이션의 논리적인 구조를 정의한 것으로 릴레이션의 이름과 릴레이션에 포함된 속 성들의 집합을 의미한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 관계 모델에서 도메인은 어떤 속성이 가질 수 있는 허용 값의 집합이다. 전통적인 제1정규형 관계에서는 각 속성값을 하나의 원자값으로 취급한다. 한 행은 각 속성의 값을 모은 튜플이고 한 열이 속성에 대응한다. 릴레이션의 이름과 속성 및 그 정의를 묶어 나타낸 논리 구조는 릴레이션 스키마다. 따라서 행을 스키마, 열을 튜플이라고 한 보기는 용어를 뒤바꿨고 속성 하나가 릴레이션 전체 구조를 뜻한다는 설명도 틀렸다.
선지별 해설
- 행은 스키마가 아니라 튜플이다.
- 열은 튜플이 아니라 속성에 대응한다.
- 도메인은 속성에 허용되는 값의 집합이다.
- 전체 논리 구조는 속성 하나가 아니라 릴레이션 스키마다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relational Database: Definitions; Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — First Normal Form
55. 제3정규형 릴레이션이 BCNF를 만족하도록 검토할 때 필요한 조건은?
[학습용 개정문항]
- 이행적 함수 종속 제거만으로 충분하다.
- 부분적 함수 종속 제거만으로 충분하다.
- 모든 다치 종속을 제거해야 한다.
- 모든 비자명한 함수 종속의 결정자가 슈퍼키가 되도록 한다.
정답과 해설 보기
정답: 4
정답은 ④이다. BCNF는 모든 비자명한 함수 종속 X→Y에서 결정자 X가 슈퍼키여야 한다는 조건이다. 슈퍼키는 릴레이션의 튜플을 유일하게 식별할 수 있는 속성 집합이며 반드시 최소 집합일 필요는 없다. 3NF가 허용하는 일부 종속에서도 X가 슈퍼키가 아니면 BCNF를 위반하므로 적절한 분해를 검토한다. 부분 종속 제거는 제2정규형, 이행 종속 문제는 제3정규형 학습과 관련되고, 다치 종속은 제4정규형에서 다룬다. 후보키가 아닌 모든 결정자를 제거한다고만 표현하면 슈퍼키의 상위 집합까지 잘못 배제할 수 있다.
선지별 해설
- 제3정규형을 설명할 때 다루는 이행 종속 문제와 관련된다.
- 제2정규형에서 다루는 부분 함수 종속 문제와 관련된다.
- 함수 종속을 넘어 다치 종속을 다루는 제4정규형과 관련된다.
- 슈퍼키가 아닌 결정자의 비자명한 함수 종속이 없도록 해야 한다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — Boyce-Codd Normal Form; Third Normal Form; Fourth Normal Form
56. 데이터베이스 성능에 많은 영향을 주는 DBMS의 구성 요소 로 테이블과 클러스터에 연관되어 독립적인 저장 공간을 보 유하며, 데이터베이스에 저장된 자료를 더욱 빠르게 조회하 기 위하여 사용되는 것은?
- 인덱스(Index)
- 트랜잭션(Transaction)
- 역정규화(Denormalization)
- 트리거(Trigger)
정답과 해설 보기
정답: 1
정답은 ①이다. 인덱스는 검색 키와 데이터 위치 등에 관한 별도의 구조를 유지하여 필요한 행을 찾는 비용을 줄이는 데 사용한다. 특정 값이나 범위의 소수 행을 자주 찾는 경우 유용할 수 있다. 그러나 추가 저장 공간이 필요하고 삽입·수정·삭제 시 관련 인덱스도 관리해야 하므로 모든 테이블에 많은 인덱스를 만드는 것이 최선은 아니다. 트랜잭션은 논리적인 작업 단위, 역정규화는 구조를 조정하여 중복 등을 도입하는 설계 선택, 트리거는 특정 사건에 따라 실행되는 동작으로 구별한다.
선지별 해설
- 키를 이용해 필요한 데이터를 효율적으로 찾도록 돕는 별도 접근 구조다.
- 원자적으로 처리할 논리적 작업 단위다.
- 성능 등의 목적에 따라 정규화된 구조를 조정하는 설계 기법이다.
- 데이터 변경 등 사건에 반응하여 실행되는 동작이다.
편집 해설 근거: PostgreSQL 18 — Indexes — Chapter 11 introduction; PostgreSQL 18, CREATE INDEX — Description
57. 다음 두 테이블에서 SQL을 실행했을 때 반환되는 이름의 집합은? 행 순서는 비교하지 않는다.
-- R1: 학번 / 이름 / 학년 / 학과 / 주소
-- 1000 / 홍길동 / 4 / 컴퓨터 / 서울
-- 2000 / 김철수 / 3 / 전기 / 경기
-- 3000 / 강남길 / 1 / 컴퓨터 / 경기
-- 4000 / 오말자 / 4 / 컴퓨터 / 경기
-- 5000 / 장미화 / 2 / 전자 / 서울
-- R2: 학번 / 과목번호 / 학점 / 점수
-- 1000 / C100 / A / 91
-- 1000 / C200 / A / 94
-- 2000 / C300 / B / 85
-- 3000 / C400 / A / 90
-- 3000 / C500 / C / 75
-- 3000 / C100 / A / 90
-- 4000 / C400 / A / 95
-- 4000 / C500 / A / 91
-- 4000 / C100 / B / 80
-- 4000 / C200 / C / 74
-- 5000 / C400 / B / 85
SELECT 이름 FROM R1
WHERE 학번 IN (
    SELECT 학번 FROM R2
    WHERE 과목번호 = 'C100'
);
[학습용 개정문항]
- 이름 홍길동 강남길 장미화
- 이름 홍길동 강남길 오말자
- 이름 홍길동 김철수 강남길 오말자 장미화
- 이름 홍길동 김철수
정답과 해설 보기
정답: 2
정답은 ②이다. 안쪽 질의는 R2에서 과목번호가 C100인 행의 학번을 고른다. 해당 학번은 1000, 3000, 4000이다. 바깥 질의는 R1의 각 학생에 대해 학번이 그 집합 안에 있는지를 검사하므로 홍길동·강남길·오말자의 이름이 반환된다. IN은 일치하는 값이 있는지를 판단하므로 같은 학번이 안쪽 결과에 여러 번 있더라도 그것 때문에 바깥 행이 여러 번 늘어나지는 않는다. ORDER BY가 없는 질의이므로 결과 행의 표시 순서는 보장되지 않으며 여기서는 반환되는 이름의 집합을 비교한다.
선지별 해설
- 장미화의 학번 5000에는 C100 수강 기록이 없으며 오말자가 빠졌다.
- C100을 수강한 학번 1000·3000·4000의 이름 집합이다.
- C100 수강 여부와 관계없이 모든 학생을 포함했다.
- 김철수는 C100을 수강하지 않았고 강남길·오말자가 빠졌다.
편집 해설 근거: PostgreSQL 18, Subquery Expressions — §9.24.2 IN; PostgreSQL 18 — SELECT — ORDER BY Clause
58. 『회원』테이블 생성 후 『주소』 필드(컬럼)가 누락되어 이 를 추가하려고 한다. 이에 적합한 SQL명령어는?
- DELETE
- RESTORE
- ALTER
- ACCESS
정답과 해설 보기
정답: 3
정답은 ③이다. 이미 존재하는 테이블의 구조를 바꿀 때 ALTER TABLE을 사용한다. 예를 들어 ALTER TABLE 회원 ADD COLUMN 주소 VARCHAR(200);은 회원 테이블에 주소 열을 추가하는 SQL의 한 예다. 기존 행이 있을 때 새 열에 어떤 값이 들어가며 NULL을 허용할지는 기본값과 제약조건 등에 따라 달라지므로 함께 검토해야 한다. DELETE는 테이블의 행을 삭제하는 명령으로 새 열을 만들지 않는다. RESTORE나 ACCESS는 이 문항에서 요구한 열 추가 명령이 아니다.
선지별 해설
- 조건에 맞는 데이터 행을 삭제하며 열을 추가하지 않는다.
- 일반적으로 백업 복구 맥락의 이름이며 열 추가 구문이 아니다.
- ALTER TABLE에 ADD COLUMN 절을 사용하여 열을 추가한다.
- 제시한 용도의 일반적인 SQL 열 추가 명령이 아니다.
편집 해설 근거: PostgreSQL 18, ALTER TABLE — Synopsis; ADD COLUMN
59. 트랜잭션을 수행하는 도중 장애로 인해 손상된 데이터베이 스를 손상되기 이전에 정상적인 상태로 복구시키는 작업은?
- Recovery
- Commit
- Abort
- Restart
정답과 해설 보기
정답: 1
정답은 ①이다. 회복은 트랜잭션 수행이나 저장 과정에서 장애가 발생했을 때 데이터베이스를 올바른 상태로 되돌리는 작업이다. 로그와 백업 등을 이용하여 커밋되지 않은 변경을 취소하고 필요한 커밋 결과를 다시 반영할 수 있다. 커밋은 트랜잭션의 성공을 확정하는 것이고 중단은 해당 트랜잭션을 끝내고 그 효과를 취소하는 것과 관련된다. 재시작은 실행을 다시 시작하는 행위로 회복 절차를 동반할 수 있지만 회복 전체와 같은 뜻은 아니다. 무조건 장애 직전의 모든 변경을 보존하는 것이 회복의 목표는 아니다.
선지별 해설
- 로그·백업 등을 활용하여 일관된 데이터 상태를 회복하는 작업이다.
- 트랜잭션을 성공적으로 확정하는 작업이다.
- 트랜잭션을 중단하고 미완료 효과를 취소하는 것과 관련된다.
- 시스템이나 작업의 실행을 다시 시작하는 행위다.
편집 해설 근거: Silberschatz, Korth, Sudarshan, Database System Concepts 7th ed., Chapter 19 Recovery System — Recovery Algorithms; Log-Based Recovery
60. 전통적인 Chen 방식 E-R 다이어그램의 기본 표기법으로 옳지 않은 것은?
[학습용 개정문항]
- 개체타입 – 사각형
- 속성 – 타원
- 관계집합 – 삼각형
- 개체타입과 속성을 연결 – 선
정답과 해설 보기
정답: 3
정답은 ③이다. 전통적인 Chen 방식 ER 표기에서는 개체 집합을 사각형, 관계 집합을 마름모, 속성을 타원으로 나타내고 필요한 연결을 선으로 표시한다. 예를 들어 학생과 과목을 사각형으로 놓고 수강 관계를 마름모로 연결할 수 있다. 따라서 관계 집합을 삼각형으로 나타낸다는 설명이 틀렸다. 확장 ER 모델의 일반화·특수화나 다른 도구의 표기에서는 별도 기호를 쓰기도 하므로 모든 ER 계열 다이어그램이 완전히 같은 도형 규칙을 쓰는 것은 아니다. 문항은 기본 Chen 표기법을 전제로 판단한다.
선지별 해설
- Chen 표기에서 개체 집합을 사각형으로 표현한다.
- 속성은 타원으로 표현한다.
- 관계 집합은 삼각형이 아니라 마름모로 표현한다.
- 개체와 속성 등 관련 요소를 선으로 연결한다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, ER Model — ER Model Basics
정보처리기사 필기 기출문제 · 프로그래밍 언어 활용
61. 다음 중 응집도가 가장 높은 것은?
- 절차적 응집도
- 순차적 응집도
- 우연적 응집도
- 논리적 응집도
정답과 해설 보기
정답: 2
정답은 ②이다. 순차적 응집도에서는 한 처리의 출력이 다음 처리의 입력으로 이어져 모듈 안의 작업들이 자료 흐름으로 연결된다. 제시된 보기 중에서는 단순히 실행 순서만 관련된 절차적 응집도보다 강하다. 논리적 응집도는 비슷한 종류의 여러 작업을 하나로 모아 선택해서 수행하는 경우이고, 우연적 응집도는 의미 있는 연관이 거의 없는 작업을 묶은 경우다. 단일한 기능에 모든 요소가 기여하는 기능적 응집도는 보통 더 강한 형태로 다루지만 이번 보기에는 없으므로 순차적 응집도를 고른다.
선지별 해설
- 실행 순서로 연결되지만 반드시 앞 작업의 결과를 뒤 작업이 쓰는 것은 아니다.
- 앞 처리의 출력이 뒤 처리의 입력으로 이어져 보기 중 가장 강한 관련성을 갖는다.
- 의미 있는 연관 없이 작업을 모은 가장 약한 쪽의 형태다.
- 유사한 종류의 여러 동작을 선택하여 수행하도록 묶는 형태다.
편집 해설 근거: Lethbridge·Laganière, Object-Oriented Software Engineering, Chapter 9 (2001), 저자 강의 자료 — Sequential cohesion; Procedural cohesion; Logical cohesion; Coincidental cohesion; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.3697 sequential cohesion
62. OSI 7계층에서 물리적 연결을 이용해 신뢰성 있는 정보를 전송하려고 동기화, 오류제어, 흐름제어 등의 전송에러를 제 어하는 계층은?
- 데이터 링크 계층
- 물리 계층
- 응용 계층
- 표현 계층
정답과 해설 보기
정답: 1
정답은 ①이다. 데이터 링크 계층은 물리 계층이 제공하는 전송 수단을 이용하여 링크 수준의 데이터 전달을 구성한다. 프레임 경계와 순서, 오류 검출 및 필요한 오류 회복·흐름 제어 등을 다루어 바로 연결된 구간의 전송을 지원한다. 물리 계층은 비트와 전기적·광학적 신호 전송에 가깝고 표현 계층은 데이터 표현 방식, 응용 계층은 응용에 필요한 통신 기능을 다룬다. 모든 실제 데이터 링크 프로토콜이 재전송과 흐름 제어를 똑같이 제공하는 것은 아니므로 계층의 일반적인 역할을 기준으로 판단한다.
선지별 해설
- 물리 연결 위에서 프레임 전달과 링크 수준의 오류·흐름 제어 등을 다룬다.
- 물리 매체를 통한 비트 신호의 전달을 다룬다.
- 응용에 필요한 통신 서비스를 제공하는 상위 계층이다.
- 데이터의 구문과 표현 형식 등을 다룬다.
편집 해설 근거: ITU-T X.200 (07/1994), OSI Basic Reference Model — §7.6 Data Link Layer; §7.7 Physical Layer
63. 운영체제 기능을 전통적으로 제어 프로그램과 처리·지원 프로그램으로 나누는 분류에서, 다음 중 사용자 편의를 위한 유틸리티를 뜻하며 제어 프로그램에 해당하지 않는 것은?
[학습용 개정문항]
- 데이터 관리 프로그램: 입출력과 데이터 취급을 관리한다.
- 서비스 프로그램: 파일 복사·정렬 등 사용자 지원 유틸리티를 제공한다.
- 작업 제어 프로그램: 작업의 시작과 실행 순서를 제어한다.
- 감시 프로그램: 다른 프로그램의 실행과 시스템 작업 흐름을 통제한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 전통적인 운영체제 기능 분류에서는 프로그램 실행과 자원·입출력을 통제하는 제어 기능과 사용자의 작업을 돕는 서비스 기능을 구별한다. 감시 프로그램은 다른 프로그램의 실행과 작업 흐름을 관리하고, 작업 제어는 작업의 실행 순서를 조정하며, 데이터 관리는 입출력과 데이터 취급을 지원하는 제어 역할로 설명한다. 파일 복사·정렬 같은 유틸리티를 제공하는 서비스 프로그램은 이 문항의 분류에서 처리·지원 기능에 해당한다. 현대 운영체제의 실제 구성요소가 반드시 이 명칭으로 분리되어 있다는 뜻은 아니다.
선지별 해설
- 이 분류에서는 데이터 취급과 입출력을 관리하는 제어 기능이다.
- 파일 복사·정렬 같은 사용자 지원 유틸리티를 제공하는 기능이다.
- 작업의 시작과 실행 순서 등을 제어하는 기능이다.
- 다른 프로그램의 실행과 시스템 작업 흐름을 통제하는 기능이다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.4050 supervisory program / control program
64. 공유 매체를 사용하는 전통적인 반이중 IEEE 802.3 이더넷의 매체 접근 제어 방식은?
[학습용 개정문항]
- CSMA/CD
- Token Bus
- Token Ring
- Slotted Ring
정답과 해설 보기
정답: 1
정답은 ①이다. 공유 매체를 사용하는 반이중 이더넷은 전송 전에 매체의 사용 여부를 감지하고, 동시에 전송하여 충돌이 생기면 이를 검출한 뒤 대기하고 재시도하는 CSMA/CD를 사용한다. 토큰 버스와 토큰 링은 전송 권한을 나타내는 토큰을 넘기는 방식으로 접근 제어 원리가 다르다. 현대의 스위치 기반 전이중 이더넷 링크에서는 송신과 수신이 분리되어 충돌을 전제로 한 CSMA/CD를 사용하지 않는다. 따라서 IEEE 802.3이라는 이름만으로 모든 이더넷 환경이 충돌 검출을 사용한다고 일반화하면 안 된다.
선지별 해설
- 공유 매체 반이중 이더넷의 반송파 감지·충돌 검출 방식이다.
- 토큰을 전달하여 전송 권한을 제어하는 버스 계열 방식이다.
- 토큰을 전달하여 전송 권한을 제어하는 링 계열 방식이다.
- 링의 슬롯을 이용하는 별도의 접근 방식이다.
편집 해설 근거: Cisco, Troubleshooting Ethernet: Ethernet and IEEE 802.3; Full-Duplex Operation — Ethernet and IEEE 802.3; Full-Duplex Operation 10/100/1000
65. 크기가 15K, 23K, 22K, 21K인 빈 고정 분할을 이 순서로 탐색한다. First Fit으로 17K 프로그램에 분할 하나를 통째로 배정하며 남은 부분을 다시 분할하지 않을 때 내부 단편화는?
[학습용 개정문항]
- 5K
- 6K
- 7K
- 8K
정답과 해설 보기
정답: 2
정답은 ②이다. First Fit은 정해진 탐색 순서에서 요청을 수용할 수 있는 첫 공간을 선택한다. 17K 요청에 대해 15K는 작으므로 건너뛰고 다음 23K 분할을 고른다. 문항처럼 고정 분할 전체를 하나의 프로그램에 배정하고 남은 부분을 다시 나누지 않는다면, 배정된 분할 내부의 미사용 공간은 23K−17K=6K다. 가변 크기의 빈 공간을 나누어 남은 6K를 자유 공간으로 돌려주는 방식이라면 같은 수치를 그대로 내부 단편화라고 부를 수 없다. 분할 정책을 확인한 뒤 차이를 계산해야 한다.
선지별 해설
- 22K 분할을 선택했을 때의 차이로 First Fit의 첫 적합 위치가 아니다.
- 처음 맞는 23K 분할 전체를 배정한 뒤 내부에 6K가 남는다.
- 선택되는 23K 분할과 17K 요청의 차이가 아니다.
- 선택되는 23K 분할과 17K 요청의 차이가 아니다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 17 Free-Space Management — Introduction — internal and external fragmentation; First Fit
66. 교착상태가 발생할 수 있는 조건이 아닌 것은?
- Mutual exclusion
- Hold and wait
- Non-preemption
- Linear wait
정답과 해설 보기
정답: 4
정답은 ④이다. 자원 교착상태의 고전적인 필요 조건은 상호 배제, 점유 및 대기, 비선점, 순환 대기다. 여러 작업이 서로가 가진 자원을 기다리는 닫힌 고리를 이루는 조건은 Circular wait이며 Linear wait가 아니다. 예를 들어 A가 자원 1을 가진 채 자원 2를 기다리고 B가 자원 2를 가진 채 자원 1을 기다리면 대기가 순환한다. 예방 기법은 필요 조건 중 하나가 성립하지 못하게 하여 교착 가능성을 막는다. 순환 대기 조건의 이름과 단순히 일렬로 기다리는 상황을 구별해야 한다.
선지별 해설
- 한 번에 하나의 작업만 사용하는 배타적 자원이 존재하는 조건이다.
- 자원을 가진 채 다른 자원을 추가로 기다리는 조건이다.
- 다른 작업이 점유한 자원을 강제로 빼앗지 않는 조건이다.
- 고전적인 필요 조건은 선형 대기가 아니라 순환 대기다.
편집 해설 근거: Arpaci-Dusseau & Arpaci-Dusseau, OSTEP Chapter 32 Common Concurrency Problems — §32.3 Deadlock Bugs — Why Do Deadlocks Occur?
67. IPv6에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 멀티캐스트 대신 브로드캐스트 주소를 사용한다.
- IPsec의 AH·ESP 기능을 적용할 수 있으나 모든 통신이 자동으로 암호화되는 것은 아니다.
- 애니캐스트는 같은 주소를 가진 인터페이스들 중 라우팅 기준으로 가까운 하나에 전달한다.
- 주소 길이는 128비트다.
정답과 해설 보기
정답: 1
정답은 ①이다. IPv6에는 브로드캐스트 주소가 없으며 해당 기능은 멀티캐스트로 대신한다. 주소 길이는 128비트이고, 애니캐스트는 같은 주소를 가진 여러 인터페이스 중 라우팅 기준으로 가까운 하나에 전달하는 방식이다. 여기서 가까움은 반드시 지리적 거리나 실제 응답 지연이 가장 짧다는 뜻은 아니다. IPsec의 인증·암호화 기능을 이용할 수 있지만 IPv6 패킷이 자동으로 모두 암호화되는 것은 아니다. 따라서 멀티캐스트 대신 브로드캐스트를 사용한다고 한 설명은 관계를 반대로 표현했다.
선지별 해설
- IPv6에는 브로드캐스트 주소가 없으며 멀티캐스트가 그 역할을 대신한다.
- IPsec을 적용할 수 있지만 모든 통신이 자동으로 암호화되는 것은 아니다.
- 라우팅 프로토콜의 거리 기준으로 선택된 인터페이스 하나에 전달한다.
- IPv6 주소는 128비트다.
편집 해설 근거: IETF RFC 4291, IP Version 6 Addressing Architecture — §2 IPv6 Addressing; §2.6 Anycast Addresses; IETF RFC 8200, Internet Protocol Version 6 Specification (2017) — §4 Extension Headers; §10 Security Considerations
68. TCP/IP 프로토콜에서 TCP가 해당하는 계층은?
- 데이터 링크 계층
- 네트워크 계층
- 트랜스포트 계층
- 세션 계층
정답과 해설 보기
정답: 3
정답은 ③이다. TCP는 IP가 제공하는 패킷 전달 위에서 응용 프로세스 사이의 신뢰성 있는 순서화된 바이트 스트림을 제공하는 전송 계층 프로토콜이다. 포트 번호로 통신 끝점을 구별하고 순서 번호·확인 응답·재전송 등을 이용한다. IP는 인터넷 계층의 주소 지정과 패킷 전달을 담당하며 링크 계층은 연결된 매체 구간의 통신을 다룬다. TCP/IP의 일반적인 계층 구분은 OSI의 일곱 계층과 일대일 대응하지 않으므로 OSI 세션 계층의 이름을 그대로 TCP의 위치로 선택하면 안 된다.
선지별 해설
- 링크 구간의 프레임 전달을 다루며 TCP의 계층이 아니다.
- IP 등 패킷 주소 지정과 전달의 계층이다.
- TCP가 위치하는 전송 계층이다.
- OSI의 계층 이름이며 TCP를 분류하는 위치가 아니다.
편집 해설 근거: IETF RFC 1122 (1989), Requirements for Internet Hosts — §1.1.3 Internet Protocol Suite — Transport Layer; IETF RFC 9293, Transmission Control Protocol (2022) — §2.2 Key TCP Concepts
69. C11에서 일반 함수 내부의 블록 범위에 선언하는 자동 지역 변수의 식별자로 사용할 수 없는 것은? 같은 이름의 매크로 등은 없다고 가정한다.
[학습용 개정문항]
- data02
- int01
- _sub
- short
정답과 해설 보기
정답: 4
정답은 ④이다. short는 C의 자료형 지정에 사용하는 키워드이므로 사용자가 선언하는 변수의 식별자로 쓸 수 없다. data02와 int01은 문자로 시작하고 뒤에 숫자가 오는 식별자이며, int01은 int라는 키워드와 다른 하나의 이름이다. _sub는 밑줄 뒤에 소문자가 오는 형태로, 문항에 명시한 함수 내부 블록 범위의 지역 변수 이름으로는 사용할 수 있다. 다만 밑줄로 시작하는 이름은 범위와 뒤따르는 문자에 따라 구현에 예약될 수 있으므로 일반적인 사용자 코드에서는 피하는 편이 이해하기 쉽다.
선지별 해설
- 문자로 시작하고 숫자를 포함하는 유효한 식별자다.
- 키워드 int 전체와 같지 않은 별개의 유효한 식별자다.
- 제시한 함수 내부 블록 범위에서는 사용할 수 있다.
- 자료형을 나타내는 예약 키워드이므로 변수 식별자로 쓸 수 없다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.4.1 Keywords; §6.4.2.1 General; §7.1.3 Reserved identifiers
70. 다음 두 Java 문장이 순서대로 출력하는 결과는?
System.out.println("5 + 2 = " + 3 + 4);
System.out.println("5 + 2 = " + (3 + 4));
[학습용 개정문항]
- 첫 줄: 5 + 2 = 34 / 둘째 줄: 5 + 2 = 34
- 첫 줄: 5 + 2 + 3 + 4 / 둘째 줄: 5 + 2 = 7
- 첫 줄: 7 = 7 / 둘째 줄: 7 + 7
- 첫 줄: 5 + 2 = 34 / 둘째 줄: 5 + 2 = 7
정답과 해설 보기
정답: 4
정답은 ④이다. Java의 +는 피연산자 중 하나가 문자열이면 문자열 연결을 수행하며 같은 우선순위의 +는 왼쪽부터 묶인다. 첫 문장은 문자열에 3을 이어 붙여 "5 + 2 = 3"을 만든 뒤 4를 붙이므로 "5 + 2 = 34"를 출력한다. 문자열 안의 5 + 2는 계산식이 아니라 그대로 표시되는 문자다. 두 번째 문장은 괄호 안의 정수 덧셈 3+4를 먼저 계산한 7을 문자열에 붙여 "5 + 2 = 7"을 출력한다. println은 각 결과 뒤에 줄바꿈을 추가한다.
선지별 해설
- 두 번째 문장의 괄호 안 정수 덧셈을 문자열 연결로 잘못 처리했다.
- 첫 문장은 + 기호를 추가 출력하지 않고 숫자 3과 4를 이어 붙인다.
- 문자열 리터럴 안의 5 + 2를 산술식처럼 계산할 수 없다.
- 첫 줄은 문자열 연결 34, 둘째 줄은 정수 덧셈 결과 7이다.
편집 해설 근거: Oracle Java SE 17 Language Specification, Chapter 15 Expressions — §15.18.1 String Concatenation Operator +; §15.18.2 Additive Operators
71. C언어에서 문자열을 정수형으로 변환하는 라이브러리 함수 는?
- atoi( )
- atof( )
- itoa( )
- ceil( )
정답과 해설 보기
정답: 1
정답은 ①이다. C 표준 라이브러리의 atoi는 문자열 앞부분의 정수 표현을 int 값으로 변환하며 stdlib.h에 선언되어 있다. 예를 들어 "123"을 넘기면 정수 123을 얻는다. atof는 부동소수점 값으로 변환하고 ceil은 부동소수점 수를 그 값 이상인 가장 작은 정수값으로 올리는 수학 함수다. itoa는 일부 구현이 제공하는 비표준 정수→문자열 변환 이름이다. atoi는 오류 검출과 범위 확인에 적합하지 않으므로 신뢰할 수 없는 입력을 처리할 때에는 strtol과 종료 포인터·범위 검사를 활용하는 편이 적절하다.
선지별 해설
- 문자열의 정수 표현을 int로 변환하는 표준 함수다.
- 문자열을 double 값으로 변환한다.
- 일부 구현에 있는 정수→문자열 변환 함수이며 ISO C 표준 함수가 아니다.
- double 값을 그 값 이상인 가장 작은 정수값으로 올려 double로 반환한다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §7.22.1.2 The atoi, atol, and atoll functions; §7.22.1.4; §7.12.9.1
72. 가상기억장치 관리에서, 프로세스가 최근 일정한 참조 구간 동안 접근한 페이지들의 집합을 뜻하는 것은?
[학습용 개정문항]
- Locality
- Deadlock
- Thrashing
- Working Set
정답과 해설 보기
정답: 4
정답은 ④이다. 작업 집합은 정해진 최근 참조 구간에서 프로세스가 접근한 페이지들의 집합이다. 같은 페이지를 여러 번 참조해도 집합에는 한 번만 포함된다. 예를 들어 최근 참조가 2, 5, 2, 7이라면 작업 집합은 {2, 5, 7}이다. 지역성은 가까운 시간이나 주소의 자료를 집중해서 참조하는 경향이고, 작업 집합은 그러한 사용 범위를 구간에 따라 구체화한 것이다. 필요한 페이지를 유지할 프레임이 부족하면 잦은 페이지 교체로 스래싱이 발생할 수 있으나 스래싱 자체가 페이지 집합의 이름은 아니다.
선지별 해설
- 참조가 시간·공간적으로 집중되는 경향이다.
- 서로 필요한 자원을 기다려 진행하지 못하는 상태다.
- 페이지 교체가 과도해져 유효한 실행이 크게 줄어드는 상태다.
- 최근 정해진 참조 구간에서 사용한 페이지들의 집합이다.
편집 해설 근거: Peter J. Denning, The Working Set Model for Program Behavior (1968), 저자 공개본 — §3 Working Set; Figure 2, printed p. 326
73. 이미지에 제시된 결합도를 낮은 것부터 높은 순서로 배열한 것은?
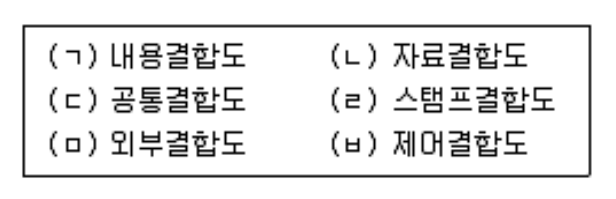
- (ㄱ) → (ㄴ) → (ㄹ) → (ㅂ) → (ㅁ) → (ㄷ)
- (ㄴ) → (ㄹ) → (ㅁ) → (ㅂ) → (ㄷ) → (ㄱ)
- (ㄴ) → (ㄹ) → (ㅂ) → (ㅁ) → (ㄷ) → (ㄱ)
- (ㄱ) → (ㄴ) → (ㄹ) → (ㅁ) → (ㅂ) → (ㄷ)
정답과 해설 보기
정답: 3
정답은 ③이다. 그림의 명칭을 전통적인 결합도 분류에서 낮은 쪽부터 나열하면 자료(ㄴ)→스탬프(ㄹ)→제어(ㅂ)→외부(ㅁ)→공통(ㄷ)→내용(ㄱ)이다. 자료 결합은 필요한 값을 인자로 전달하고, 스탬프 결합은 자료구조의 내부 형태에 의존한다. 제어 결합은 다른 모듈의 동작을 지정하는 제어값 전달, 외부 결합은 외부 형식이나 장치·프로토콜에 대한 공통 의존, 공통 결합은 전역 자료 공유, 내용 결합은 다른 모듈 내부의 직접 변경 등을 가리킨다. 이 분류는 설계 판단을 돕는 전통적 순서이지 성능의 절대 순위는 아니다.
선지별 해설
- 가장 강한 내용 결합(ㄱ)을 첫 위치에 놓았다.
- 제어(ㅂ)와 외부(ㅁ)의 전통적 순서를 뒤바꿨다.
- 자료→스탬프→제어→외부→공통→내용 순서다.
- 내용 결합(ㄱ)을 첫 위치에 놓고 제어·외부 순서도 바꿨다.
편집 해설 근거: University of Texas at El Paso, CS4311 Lecture 6 — Cohesion and Coupling — slide 23 Type of Coupling; slides 24–32
74. 이미지의 가상기억장치 구분 방법 ㉠과 ㉡에 들어갈 용어는?
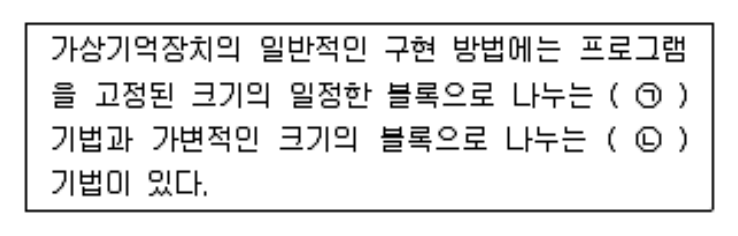
- ㉠ : Paging, ㉡ : Segmentation
- ㉠ : Segmentation, ㉡ : Allocation
- ㉠ : Segmentation, ㉡ : Compaction
- ㉠ : Paging, ㉡ : Linking
정답과 해설 보기
정답: 1
정답은 ①이다. 페이징은 가상 주소 공간을 일정한 크기의 페이지로 나누고 같은 크기의 물리 프레임에 대응시키는 방식이다. 세그먼테이션은 코드·힙·스택 등의 논리적 영역을 서로 크기가 다를 수 있는 세그먼트로 나누어 관리한다. 따라서 고정 크기 구분은 Paging, 가변 크기 구분은 Segmentation에 해당한다. 할당은 메모리를 배정하는 일반적인 행위이고 압축은 흩어진 빈 공간을 모으는 작업, 링킹은 코드와 기호를 결합하는 작업이다. 실제 시스템에서는 페이징과 세그먼테이션을 함께 사용할 수도 있다.
선지별 해설
- 고정 크기의 페이지와 가변 크기의 논리 세그먼트를 올바르게 대응했다.
- 고정 크기를 세그먼테이션으로 잘못 대응했고 Allocation은 일반적인 배정 행위다.
- Compaction은 빈 공간을 모으는 작업으로 가변 구분 방식의 명칭이 아니다.
- Linking은 프로그램 요소의 결합으로 세그먼테이션과 다르다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 18 Paging: Introduction — §18.1 A Simple Example and Overview; Arpaci-Dusseau, OSTEP v1.10, 16 Segmentation — §16.1 Segmentation: Generalized Base/Bounds
75. 라이브러리의 개념과 구성에 대한 설명 중 틀린 것은?
[학습용 개정문항]
- 재사용할 수 있는 함수·클래스 등의 기능을 모듈화하여 제공할 수 있다.
- 라이브러리 배포에는 문서·예제·설치 안내 등이 함께 제공될 수 있다.
- 언어의 표준·기본 배포 기능은 외부 라이브러리이고 별도 공급자가 제공하는 기능은 표준 라이브러리이다.
- Python에서는 모듈과 패키지 등을 이용하여 라이브러리 코드를 조직할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 표준 라이브러리는 해당 언어의 표준이나 기본 배포 환경에서 제공하는 기능 집합이고, 외부 라이브러리는 별도 프로젝트나 공급자가 제공하여 필요에 따라 도입하는 기능 집합이다. 따라서 두 설명을 반대로 한 ③이 틀렸다. 라이브러리는 재사용 가능한 함수·클래스·모듈 등을 제공하며 문서와 예제 또는 설치 도구가 함께 배포될 수 있다. Python에서는 모듈과 패키지를 통해 코드를 조직하지만, 모든 언어의 모듈을 개별 파일 하나로, 모든 패키지를 폴더 하나로 고정하여 정의할 수는 없다.
선지별 해설
- 반복 사용할 수 있는 기능을 모듈화하여 제공할 수 있다.
- 문서·예제·배포 또는 설치 자료를 함께 제공할 수 있다.
- 표준 라이브러리와 외부 라이브러리의 일반적인 의미를 뒤바꿨다.
- Python 등의 언어에서는 모듈과 패키지를 이용하여 기능을 조직한다.
편집 해설 근거: Python 3.14 Tutorial, Modules — §6 Modules; §6.2 Standard Modules; §6.4 Packages; Python Packaging User Guide, Packaging Python Projects — Packaging Python Projects
76. C언어에서 산술 연산자가 아닌 것은?
- %
- *
- /
- =
정답과 해설 보기
정답: 4
정답은 ④이다. =는 오른쪽 값을 왼쪽 객체에 저장하는 대입 연산자다. 예를 들어 x=3은 x와 3이 같은지 비교하는 식이 아니라 x에 3을 저장한다. 두 값의 같음을 비교하는 연산자는 ==이다. 나머지 %, 곱셈 *, 나눗셈 /는 두 피연산자 사이에서 산술 연산을 수행한다. 다만 *는 문맥에 따라 단항 역참조 연산자나 포인터 선언에도 쓰이므로 기호만 보고 역할을 단정하지 않고, 이 문항에서는 두 값의 곱셈이라는 사용을 전제로 구별한다.
선지별 해설
- 정수 나눗셈의 나머지를 구하는 산술 연산자다.
- 두 피연산자의 곱을 구할 때 산술 연산자다.
- 두 피연산자의 나눗셈을 수행하는 산술 연산자다.
- 오른쪽 값을 왼쪽 객체에 저장하는 대입 연산자다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.5 Multiplicative operators; §6.5.16 Assignment operators
77. UDP 특성에 해당되는 것은?
[학습용 개정문항]
- TCP와 같은 양방향 연결형 서비스를 자체 제공한다.
- 송신 중 연결과 재전송을 관리하여 전달을 보장한다.
- TCP와 같은 순서 보장·재전송·흐름 제어를 자체 제공한다.
- 연결 설정·순서 보장·흐름 제어를 자체 제공하지 않아 프로토콜 처리 부담이 작을 수 있다.
정답과 해설 보기
정답: 4
정답은 ④이다. UDP는 데이터그램을 보내는 비교적 간단한 전송 계층 프로토콜로 TCP와 같은 연결 설정, 재전송, 순서 보장, 흐름 제어를 자체적으로 제공하지 않는다. 그래서 프로토콜 처리 부담이 작을 수 있지만 언제나 더 높은 속도나 낮은 지연을 보장하는 것은 아니다. 체크섬은 전송 중 손상을 검출하는 데 쓰일 수 있으므로 UDP에는 오류 검출 기능조차 전혀 없다고 말하면 부정확하다. 필요한 신뢰성이나 혼잡 대응은 상위 프로토콜과 응용 설계가 보완해야 한다.
선지별 해설
- UDP 자체는 TCP와 같은 연결형 서비스를 제공하지 않는다.
- UDP 자체가 링크를 유지하고 재전송하여 신뢰성을 보장하는 것은 아니다.
- 순서 보장·흐름 제어·재전송을 자체 제공하지 않는다.
- 해당 제어를 자체 제공하지 않아 처리 부담이 작을 수 있다.
편집 해설 근거: IETF RFC 768, User Datagram Protocol (1980) — Introduction; Format; User Interface; IETF RFC 9293, Transmission Control Protocol (2022) — §2.2 Key TCP Concepts
78. JAVA에서 변수와 자료형에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 변수는 값을 보관하는 저장 위치를 나타내는 개념이다.
- 자료형에 따라 변수에 담을 수 있는 값과 허용 연산이 달라진다.
- char 변수 하나는 여러 문자로 이루어진 일반 문자열을 저장하는 데 사용한다.
- boolean은 true 또는 false를 나타낸다.
정답과 해설 보기
정답: 3
정답은 ③이다. Java의 char는 16비트 부호 없는 값으로 UTF-16 코드 단위 하나를 표현한다. 여러 문자로 된 문자열은 보통 String 객체로 다루며, 일부 유니코드 문자는 두 char 값으로 표현되므로 char 하나가 언제나 눈에 보이는 문자 하나와 같다고 단정해서도 안 된다. 변수의 자료형은 담을 수 있는 값의 범위와 사용할 연산을 제한한다. boolean은 true와 false 두 값을 갖는다. 변수는 값을 보관하는 저장 위치라는 언어 차원의 개념이며 실제 물리적 배치는 실행 환경의 구현에 따른다.
선지별 해설
- 변수는 값을 보관하는 저장 위치라는 언어 차원의 개념이다.
- 자료형에 따라 허용 값과 연산이 달라진다.
- char 하나가 여러 문자로 이루어진 문자열을 저장하는 것은 아니다.
- boolean은 true와 false의 두 값을 표현한다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 4 Types, Values, and Variables — §4.2 Primitive Types and Values; §4.2.5 boolean; §4.12 Variables
79. 다음 Python 3 코드를 외부 중단이나 출력 예외 없이 실행한다고 할 때 출력 동작은?
while True:
    print('A')
    print('B')
    print('C')
    continue
    print('D')
[학습용 개정문항]
- A, B, C 출력이 반복된다.
- A, B, C 까지만 출력된다.
- A, B, C, D 출력이 반복된다.
- A, B, C, D 까지만 출력된다.
정답과 해설 보기
정답: 1
정답은 ①이다. while True의 조건은 반복해서 참이므로 코드 내부에서 종료시키지 않는 한 반복이 계속된다. 각 반복에서 A, B, C를 한 줄씩 출력한 다음 continue를 만나 현재 반복의 남은 부분을 건너뛰고 다음 조건 검사로 이동한다. 따라서 아래에 있는 print('D')는 실행되지 않는다. continue는 반복문 전체를 끝내는 break와 다르다. 외부에서 프로그램을 중단하거나 출력 과정에서 예외가 발생하지 않는 정상 실행을 가정하면 A→B→C의 세 줄이 계속 반복된다.
선지별 해설
- continue 앞의 A·B·C 출력 후 다음 반복을 계속한다.
- continue는 반복문 종료 명령이 아니므로 한 번만 출력하고 끝나지 않는다.
- D 출력문은 continue 뒤에 있어 실행되지 않는다.
- D도 출력되지 않으며 반복문도 스스로 종료되지 않는다.
편집 해설 근거: Python 3.14 Language Reference, Simple statements — §7.10 The break statement; §7.11 The continue statement; Python 3.14 Language Reference, The while statement — §8.2 The while statement
80. 다음 중 웹 컨테이너를 포함한 웹 애플리케이션 실행 서버 제품이 아니라 Java 클래스 파일의 명령을 실행하는 가상 머신을 뜻하는 것은?
[학습용 개정문항]
- JEUS
- JVM
- Tomcat
- WebSphere
정답과 해설 보기
정답: 2
정답은 ②이다. JVM은 클래스 파일에 담긴 명령을 실행하는 추상 머신과 그 구현을 뜻하며, 그 자체로 웹 요청을 받아 웹 애플리케이션을 관리하는 서버 제품의 명칭은 아니다. JEUS와 WebSphere Application Server는 애플리케이션 서버 제품이고, Tomcat은 서블릿 등의 웹 기술을 구현하는 웹 컨테이너다. Tomcat을 전체 Jakarta EE 기능을 모두 갖춘 서버와 동일하게 보아서는 안 되지만, 웹 애플리케이션을 배포·실행하는 서버라는 이 문항의 범위에는 들어간다. Java 기반 서버가 내부 실행 환경으로 JVM을 이용할 수 있다는 점도 구별한다.
선지별 해설
- 웹·기업용 애플리케이션을 실행하는 서버 제품이다.
- 바이트코드 실행 환경으로 웹 애플리케이션 서버 제품과 구별된다.
- 서블릿 등의 웹 애플리케이션을 실행하는 웹 컨테이너다.
- 웹·기업용 애플리케이션을 실행하는 서버 제품이다.
편집 해설 근거: Oracle Java SE 25 Virtual Machine Specification, Chapter 1 Introduction — §1.2 The Java Virtual Machine; Apache Tomcat, official project overview — Project introduction; TmaxSoft, JEUS 제품 소개 — Product introduction; IBM, WebSphere Application Server Overview — Java EE application components
정보처리기사 필기 기출문제 · 정보시스템 구축관리
81. 다음 암호 알고리즘 중 성격이 다른 하나는?
- MD4
- MD5
- SHA-1
- AES
정답과 해설 보기
정답: 4
정답은 ④이다. MD4, MD5, SHA-1은 입력으로부터 정해진 길이의 메시지 요약값을 만드는 해시 알고리즘이다. 원문을 복원하기 위한 복호화 키를 짝으로 두는 가역적 암호화와는 다르다. AES는 같은 비밀키를 사용하는 대칭키 블록 암호로 128비트 블록을 처리하며 키 길이는 128·192·256비트 중 하나다. 따라서 네 보기의 주된 기능을 분류하면 AES만 암호화 알고리즘이다. 이 분류가 오래된 MD4·MD5·SHA-1을 현대 보안 용도에 안전하게 사용할 수 있다는 권고를 의미하지는 않는다.
선지별 해설
- 128비트 요약값을 만드는 오래된 메시지 다이제스트 알고리즘이다.
- 128비트 요약값을 만드는 오래된 메시지 다이제스트 알고리즘이다.
- 160비트 요약값을 만드는 해시 알고리즘이다.
- 복호화가 가능한 대칭키 블록 암호다.
편집 해설 근거: IETF RFC 1320, The MD4 Message-Digest Algorithm (1992) — §1 Executive Summary; IETF RFC 1321, The MD5 Message-Digest Algorithm (1992) — §1 Executive Summary; NIST FIPS 180-4, Secure Hash Standard (2015) — §1 Introduction; §5.3.1 SHA-1; NIST FIPS 197-upd1 (2023), Advanced Encryption Standard — §1 Introduction; §5 Algorithm Specification
82. 설정 파일이나 실행 파일의 상태를 신뢰할 수 있는 기준 데이터베이스와 비교하여 무단 변경 의심 사항을 찾는 파일 무결성 검사 도구는?
[학습용 개정문항]
- tripwire
- tcpdump
- cron
- netcat
정답과 해설 보기
정답: 1
정답은 ①이다. Tripwire는 감시 대상으로 정한 파일과 디렉터리의 상태를 신뢰할 수 있는 기준 데이터베이스와 비교하여 변경을 찾는 무결성 검사 도구다. 설정 파일이나 실행 파일이 예기치 않게 바뀌었다면 침해 여부를 조사할 단서로 사용할 수 있다. tcpdump는 네트워크 패킷을 수집·분석하고 cron은 정해진 시각에 작업을 실행하며 netcat은 네트워크 연결과 데이터 입출력을 다룬다. 파일 변경은 정상 업데이트 때문일 수도 있으므로 Tripwire의 경고만으로 백도어 존재를 확정하거나 모든 침입을 자동으로 검출한다고 볼 수는 없다.
선지별 해설
- 파일 상태를 기준 데이터베이스와 비교하여 변경을 찾는다.
- 주로 네트워크 패킷을 캡처하고 살피는 도구다.
- 작업을 정해진 일정에 실행하는 스케줄러다.
- 네트워크 연결을 통한 데이터 송수신에 사용하는 도구다.
편집 해설 근거: Tripwire, Open Source Tripwire 공식 저장소 README (2026-10-05 확인) — README — Open Source Tripwire
83. 다음 설명에 해당하는 메시징 프로토콜은?
[학습용 개정문항]
자원이 제한되거나 통신 대역폭이 작은 환경에도 활용되는 경량 메시징 프로토콜이다. 클라이언트가 브로커에 토픽별 메시지를 발행하고, 브로커가 해당 토픽을 구독한 클라이언트에 전달하는 발행·구독 구조를 사용한다.
- GRID
- TELNET
- GPN
- MQTT
정답과 해설 보기
정답: 4
정답은 ④이다. MQTT는 클라이언트가 서버인 브로커를 통해 메시지를 발행하고 관심 있는 토픽을 구독하는 발행·구독 프로토콜이다. 발행자가 모든 수신자를 직접 지정할 필요가 없으며 제한된 자원이나 통신 여건을 가진 환경의 메시징에 활용할 수 있다. OASIS MQTT 5.0 표준은 이러한 클라이언트·서버 구조와 메시지 전달 품질 수준을 정의한다. TELNET은 원격 터미널 통신 프로토콜이며 GRID는 분산 자원을 이용하는 컴퓨팅 개념이다. IBM 단독 개발이라는 역사적 단정은 프로토콜을 식별하는 핵심 조건이 아니다.
선지별 해설
- 분산 컴퓨팅 자원의 활용 개념으로 제시한 메시징 프로토콜이 아니다.
- 원격 터미널 통신을 위한 프로토콜이다.
- 제시한 발행·구독 프로토콜의 명칭이 아니다.
- 브로커와 토픽을 사용하는 경량 발행·구독 메시징 프로토콜이다.
편집 해설 근거: OASIS, MQTT Version 5.0 Standard (2019) — §1.1 Organization of the MQTT Specification; Abstract; §1.2 Terminology
84. 나선형(Spiral) 모형의 주요 태스크에 해당되지 않는 것은?
- 버전 관리
- 위험 분석
- 개발
- 평가
정답과 해설 보기
정답: 1
정답은 ①이다. Boehm의 나선형 모형은 각 반복에서 목표·대안·제약을 정하고 위험을 분석·완화한 뒤 다음 수준의 제품을 개발·검증하고 다음 반복을 계획하는 위험 중심 접근이다. 결과를 이해관계자가 검토하여 다음 진행 판단에 반영하는 평가 활동도 중요하다. 버전 관리는 이런 개발 과정에서 실제로 수행할 수 있는 형상관리 활동이지만 나선형 모형을 특징짓는 반복의 주요 구역으로 따로 분류하는 항목은 아니다. 따라서 버전 관리를 사용하지 않는다는 의미로 정답을 해석해서는 안 된다.
선지별 해설
- 형상관리 활동이며 나선형 반복을 특징짓는 주요 구역의 명칭은 아니다.
- 대안의 위험을 확인하고 줄이는 나선형의 핵심 활동이다.
- 다음 수준 제품을 만들고 검증하는 활동이 포함된다.
- 진행 결과를 검토하여 다음 단계 판단에 반영한다.
편집 해설 근거: Barry W. Boehm, A Spiral Model of Software Development and Enhancement (1988), 논문 보존 사본 — Figure 2 A spiral model of the software process; A typical cycle of the spiral
85. 정보 보안을 위한 접근통제 정책 종류에 해당하지 않는 것 은?
- 임의적 접근 통제
- 데이터 전환 접근 통제
- 강제적 접근 통제
- 역할 기반 접근 통제
정답과 해설 보기
정답: 2
정답은 ②이다. 임의적 접근 통제는 객체 소유자 등에게 권한 부여에 관한 재량을 허용하는 방식이다. 강제적 접근 통제는 중앙 정책과 보안 등급·레이블 등에 따라 접근을 제한하며 일반 사용자가 임의로 정책을 바꾸지 못하게 한다. 역할 기반 접근 통제는 사용자를 업무 역할에 배정하고 역할에 권한을 연결한다. 데이터 전환 접근 통제는 이들과 나란히 제시되는 일반적인 접근 통제 정책 분류가 아니다. 암호화나 데이터 변환은 보호 수단으로 활용될 수 있지만 누가 어떤 객체에 접근할 수 있는지 정하는 정책 분류와 구별한다.
선지별 해설
- 객체 소유자 등의 재량을 반영하여 접근 권한을 정하는 분류다.
- 이 문항의 일반적인 접근 통제 정책 분류에 해당하지 않는다.
- 보안 레이블과 중앙 정책 등으로 접근을 강제하는 분류다.
- 업무 역할에 권한을 연결하고 사용자에게 역할을 배정하는 분류다.
편집 해설 근거: NIST CSRC Glossary, mandatory access control — Definitions; NIST CSRC, Role Based Access Control FAQ — What is Role Based Access Control?; RBAC and DAC/MAC
86. 예상 코드량은 36,000라인이고 개발자는 6명, 1인당 생산성은 월 300라인이다. 전원이 같은 기간 작업하며 일을 완전히 나눌 수 있고 협업 손실은 없다고 가정할 때 예상 개발 기간은?
[학습용 개정문항]
- 5개월
- 10개월
- 15개월
- 20개월
정답과 해설 보기
정답: 4
정답은 ④이다. 한 명이 한 달에 300라인을 작성한다는 생산성 가정에서 전체 36,000라인에 필요한 노력은 36,000÷300=120인월이다. 여섯 명이 같은 생산성으로 동시에 일하고 작업을 완전히 나눌 수 있다고 가정하면 월간 팀 생산량은 6×300=1,800라인이며 기간은 36,000÷1,800=20개월이다. 인월은 투입 노력의 단위이고 개월은 달력상 기간의 단위이므로 구별해야 한다. 실제 프로젝트에는 협업 비용과 작업 의존성이 있으므로 인원을 늘린 만큼 기간이 항상 반비례하여 줄지는 않는다.
선지별 해설
- 이 가정에서 5개월 동안 생산할 수 있는 양은 9,000라인이다.
- 10개월이면 18,000라인으로 목표의 절반이다.
- 15개월이면 27,000라인으로 목표보다 적다.
- 월 1,800라인으로 36,000라인을 만들려면 20개월이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Management §2.3 Effort, Schedule, and Cost Estimation
87. 정형화된 분석 절차에 따라 사용자 요구사항을 파악, 문서 화하는 체계적 분석방법으로 자료흐름도, 자료사전, 소단위 명세서의 특징을 갖는 것은?
- 구조적 개발 방법론
- 객체지향 개발 방법론
- 정보공학 방법론
- CBD 방법론
정답과 해설 보기
정답: 1
정답은 ①이다. 구조적 분석은 기능과 자료의 흐름을 중심으로 시스템을 단계적으로 분해하여 요구사항을 명확히 한다. 자료흐름도는 외부 개체·처리·저장소 사이의 자료 이동을, 자료사전은 그 자료의 이름과 의미·구조를, 소단위 명세서는 더 나누지 않은 처리의 상세 논리를 설명하는 데 사용한다. 객체지향 접근은 객체의 상태와 책임·관계에, 정보공학은 조직의 정보와 데이터 중심 계획·모델링에, 컴포넌트 기반 개발은 인터페이스를 가진 구성요소의 조립·재사용에 초점을 둔다. 도구 하나의 사용 여부만으로 모든 방법론을 완전히 구분하지는 않는다.
선지별 해설
- 자료 흐름과 기능 분해, 자료사전 및 처리 명세를 사용하는 구조적 접근이다.
- 객체와 클래스의 상태·동작·관계를 중심으로 하는 접근이다.
- 조직의 정보와 데이터 모델을 중심으로 개발을 조직하는 접근이다.
- 재사용 가능한 컴포넌트를 조립하는 접근이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Models and Methods §4.1 Heuristic Methods — Structured analysis and design methods; Software Design §5.2
88. 정보보호를 위한 암호화에 대한 설명으로 틀린 것은?
- 평문 – 암호화되기 전의 원본 메시지
- 암호문 – 암호화가 적용된 메시지
- 복호화 – 평문을 암호문으로 바꾸는 작업
- 키(Key) – 적절한 암호화를 위하여 사용하는 값
정답과 해설 보기
정답: 3
정답은 ③이다. 암호화는 평문을 암호문으로 바꾸는 과정이고 복호화는 암호문을 다시 평문으로 되돌리는 과정이다. 따라서 평문에서 암호문으로 바꾸는 작업을 복호화라고 한 보기는 방향이 반대다. 키는 암호 알고리즘의 동작을 정하는 매개값으로, 대칭키 방식에서는 공유 비밀키를 사용하고 공개키 방식에서는 서로 관련된 공개키와 개인키를 구별한다. 평문은 암호화 전 데이터라는 뜻으로 반드시 사람이 읽을 수 있는 문장일 필요는 없으며 그림·실행 파일 등도 암호화 대상이 될 수 있다.
선지별 해설
- 암호화되기 전 데이터로 문장뿐 아니라 여러 형태의 데이터가 될 수 있다.
- 암호화 과정의 결과로 얻은 데이터다.
- 평문→암호문은 암호화이며 복호화는 그 반대 방향이다.
- 알고리즘의 변환을 결정하는 키 값을 사용한다.
편집 해설 근거: NIST SP 800-57 Part 1 Revision 5, Recommendation for Key Management — §2.1 Glossary — encryption, decryption, plaintext, ciphertext, key
89. 이미지의 설명에 해당하는 클라우드 서비스 개념은?
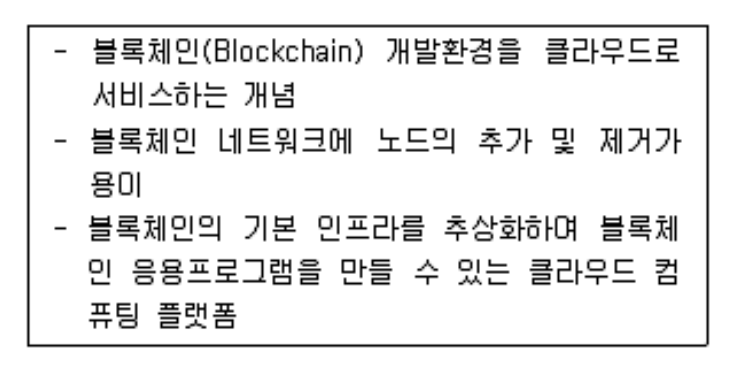
- OTT
- Baas
- SDDC
- Wi-SUN
정답과 해설 보기
정답: 2
정답은 ②이다. 이 문항의 BaaS는 Blockchain as a Service, 즉 블록체인 서비스형 제공을 뜻한다. 공급자가 컴퓨팅·저장소·노드 배포와 운영 도구 같은 기반 환경을 제공하여 사용자가 블록체인 응용과 네트워크 구성에 집중하도록 돕는다. 노드를 추가하거나 관리하는 구체적인 범위는 제품과 권한에 따라 다르므로 모든 서비스를 아무 제약 없이 변경할 수 있다는 뜻은 아니다. 같은 BaaS 약어가 Backend as a Service 등에도 쓰이므로, 블록체인 기반 환경이라는 설명을 함께 읽고 의미를 결정해야 한다.
선지별 해설
- 인터넷을 통해 영상 등의 콘텐츠를 제공하는 서비스 개념이다.
- 여기서는 Blockchain as a Service를 뜻한다.
- 컴퓨팅·저장·네트워크를 소프트웨어로 제어하는 데이터센터 개념이다.
- 스마트 유틸리티 네트워크 분야의 무선 통신 기술과 관련된다.
편집 해설 근거: Oracle Blockchain Platform, What Are the Advantages? (2026-10-05 확인) — Introduction; Provisioning and Integration; Management and Operations Console
90. 초기 1981 COCOMO 계열에서 개발 모드를 Organic, Semidetached, Embedded로 구분하는 비용 추정 모형은?
[학습용 개정문항]
- PUTNAM
- COCOMO
- FP
- SLIM
정답과 해설 보기
정답: 2
정답은 ②이다. 초기 COCOMO 모형은 개발 환경과 프로젝트의 성격에 따라 Organic, Semidetached, Embedded의 세 모드를 구별하고 규모와 조정 요소를 이용하여 노력을 추정했다. 비교적 익숙하고 제약이 적은 환경, 중간 성격의 환경, 강한 하드웨어·운영 제약과 결합된 환경을 구별하는 데 사용한 분류다. PUTNAM은 별도의 소프트웨어 자원·일정 모형이고 SLIM은 그 계열의 추정 도구다. 기능점수는 제공 기능을 중심으로 크기를 측정하는 접근이다. 이 세 모드 분류를 후속 COCOMO II의 분류와 그대로 혼동하지 않도록 한다.
선지별 해설
- Putnam의 자원·일정 추정 모형으로 제시한 세 모드 명칭과 다르다.
- 초기 COCOMO 모형의 Organic·Semidetached·Embedded 모드다.
- 사용자에게 제공하는 기능을 중심으로 소프트웨어 크기를 측정한다.
- Putnam 계열의 소프트웨어 추정 도구다.
편집 해설 근거: Barry W. Boehm, Software Engineering Economics (1984), 저자 논문 보존 사본 — Step 1—Nominal Effort Estimation; Table IV COCOMO Development Modes
91. 이미지의 LAN 네트워크 토폴로지는?
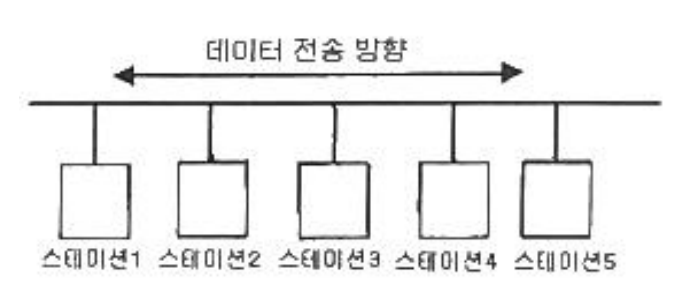
- 그물형
- 십자형
- 버스형
- 링형
정답과 해설 보기
정답: 3
정답은 ③이다. 그림에서는 하나의 공통 선로를 따라 여러 스테이션이 연결되어 있다. 이처럼 공통 백본을 공유하는 물리적 배치는 버스형 토폴로지다. 링형은 각 노드가 이웃과 이어져 닫힌 고리를 만들고, 그물형은 노드 사이에 여러 직접 연결이 존재한다. 전송 방향 화살표가 양쪽을 가리킨다는 사실만으로 링이나 그물형이 되지는 않는다. 토폴로지는 주로 어떤 노드와 링크가 연결되는지를 살피며, 실제 프레임의 전달 방식이나 충돌 제어 규칙과도 구별하여 판단한다.
선지별 해설
- 여러 노드 사이에 복수의 직접 연결이 있는 그물 구조가 아니다.
- 그림의 단일 공통 백본 배치를 뜻하는 일반적인 명칭이 아니다.
- 하나의 공통 선로에 여러 스테이션이 접속하는 버스형이다.
- 연결 선로가 닫힌 고리를 이루지 않으므로 링형이 아니다.
편집 해설 근거: IBM, What is network topology? — Bus topology
92. 전기 및 정보통신기술을 활용하여 전력망을 지능화, 고도화 함으로써 고품질의 전력서비스를 제공하고 에너지 이용효율 을 극대화하는 전력망은?
- 사물 인터넷
- 스마트 그리드
- 디지털 아카이빙
- 미디어 빅뱅
정답과 해설 보기
정답: 2
정답은 ②이다. 스마트 그리드는 전력망에 정보통신과 측정·제어 기술을 결합하여 전력의 공급과 수요를 더 정밀하게 파악하고 운영하는 개념이다. 계량과 상태 정보의 교환, 분산 자원의 연계, 장애 대응과 효율적인 운영 등이 관련된다. 사물인터넷은 여러 사물의 연결이라는 더 넓은 개념으로 전력망에 활용될 수 있지만 전력망 자체를 가리키는 이 문항의 명칭은 아니다. 디지털 아카이빙은 자료의 장기 보존에 관한 개념이다. 실제 효과는 상호운용성과 보안, 설비 및 운영 정책의 적절한 설계에 달려 있다.
선지별 해설
- 연결된 사물의 범용 개념으로 전력망 지능화 자체의 이름은 아니다.
- 전력망과 정보통신·측정·제어를 결합한 스마트 그리드다.
- 디지털 자료를 보존하고 관리하는 개념이다.
- 제시한 전력망의 기술적 명칭이 아니다.
편집 해설 근거: NIST, Smart Grid Program — Summary; Description
93. 다음 설명에 해당하는 소프트웨어 생명주기 모형은?
[학습용 개정문항]
요구 분석, 설계, 구현, 시험 등의 활동을 구분된 단계로 조직하고 앞 단계 산출물을 다음 단계의 입력으로 사용하는 선형·순차적 관점의 모형이다.
- 프로토타입 모형
- 나선형 모형
- 폭포수 모형
- RAD 모형
정답과 해설 보기
정답: 3
정답은 ③이다. 폭포수 모형은 요구 분석, 설계, 구현, 시험 등 주요 활동을 단계적으로 구분하고 앞 단계의 산출물을 다음 단계의 입력으로 사용하는 순차적 생명주기 관점이다. 단계별 산출물과 완료 기준을 분명히 관리하기 쉽지만 뒤늦은 요구 변경이 생기면 이전 산출물과 후속 작업을 함께 수정해야 할 수 있다. 프로토타입은 모형으로 요구나 해법을 확인하고, 나선형은 반복마다 위험을 중심으로 진행을 정하며, RAD는 빠른 개발 주기와 도구·재사용 등을 강조한다. 실제 폭포수 적용에서도 검토와 수정 피드백이 완전히 금지되는 것은 아니다.
선지별 해설
- 시제품을 만들어 요구와 해법을 확인하는 접근이다.
- 위험 분석을 중심으로 여러 차례 발전시키는 접근이다.
- 주요 개발 활동을 순차적인 단계로 조직하는 폭포수 모형이다.
- 빠른 반복 개발과 도구·재사용 등을 강조하는 접근이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Process §2.4 Some Paradigms for Development Life Cycle Models
94. 스트림 암호화 방식의 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 비트·바이트 등 작은 단위의 데이터를 순차적으로 처리할 수 있다.
- 해시 요약값을 키로 원래 평문으로 복호화하는 방식이다.
- RC4는 역사적인 스트림 암호의 예이다.
- 대칭키 암호 방식에 속한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 스트림 암호는 비밀키 등에 따라 생성한 키스트림을 이용하여 비트나 바이트 등의 작은 단위로 데이터를 순차 처리하는 대칭키 암호 방식이다. 해시 함수가 만든 요약값을 원래 평문으로 복호화하는 방식은 아니므로 ②는 다르다. 내부 구성 요소로 해시 계열 기능을 활용할 수 있는 설계가 있더라도 해시와 스트림 암호의 목적을 같은 것으로 보아서는 안 된다. RC4는 역사적인 스트림 암호의 예이지만 알려진 약점 때문에 TLS에서는 사용이 금지되어 있으며 신규 보안 설계의 권장 예로 제시하는 것은 아니다.
선지별 해설
- 비트·바이트 등 작은 단위의 연속된 데이터를 처리할 수 있다.
- 복호화 가능한 키스트림 암호와 일방향 요약인 해시를 혼동했다.
- 역사적인 스트림 암호의 예이지만 현재 TLS 사용은 금지되어 있다.
- 공유된 비밀키를 사용하는 대칭키 방식이다.
편집 해설 근거: NIST CSRC Glossary, stream cipher — Definitions; IETF RFC 6229, Test Vectors for the Stream Cipher RC4 — §1 Introduction; IETF RFC 7465, Prohibiting RC4 Cipher Suites — §2 Changes to TLS
95. 고전적인 TCP 연결 가로채기로 인한 순서 번호 비동기화를 조사할 때, 다음 중 기존 연결의 이상을 보여 주는 직접적인 단서로 보기 가장 어려운 것은?
[학습용 개정문항]
- 정상적으로 새 연결을 시작하는 SYN 세그먼트 하나를 관찰했다.
- 기존 연결 양 끝의 순서 번호 상태가 비정상적으로 어긋난다.
- 기존 연결에서 비정상적인 ACK 폭주가 관찰된다.
- 기존 연결에서 원인 불명의 재전송이 급증한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 고전적인 TCP 연결 가로채기 중 양 끝의 순서 번호 상태를 어긋나게 만드는 방식에서는 비동기화, 반복 확인 응답인 ACK 폭주, 비정상적인 재전송 등을 조사 단서로 볼 수 있다. 반면 새 연결을 시작하는 정상적인 SYN 하나를 관찰한 사실만으로 기존 연결의 가로채기나 비동기화를 판정할 수는 없다. SYN은 FTP 고유 패킷이 아니라 TCP 플래그다. 이 단서들은 혼잡·손실이나 다른 구현 문제로도 나타날 수 있고 모든 세션 탈취가 이를 발생시키지도 않으므로 패킷 흐름과 맥락을 함께 분석해야 한다.
선지별 해설
- 정상적인 새 연결의 SYN 하나는 기존 연결 탈취의 직접 증거가 아니다.
- 서로 맞지 않는 TCP 순서 번호 상태는 이 공격 유형의 조사 단서가 될 수 있다.
- 과도하게 반복되는 ACK는 고전적인 비동기화 공격의 흔적이 될 수 있다.
- 비정상적 재전송 증가는 다른 단서와 함께 확인할 대상이다.
편집 해설 근거: Laurent Joncheray, A Simple Active Attack Against TCP, USENIX Security 1995 — §5 Detection and Side Effects, PDF pp. 11–12 — desynchronized state, ACK storm and packet loss; IETF RFC 9293, Transmission Control Protocol (2022) — §3.5 Establishing a Connection
96. 소프트웨어공학에 대한 설명으로 거리가 먼 것은?
- 소프트웨어공학이란 소프트웨어의 개발, 운용, 유지보수 및 파기에 대한 체계적인 접근 방법이다.
- 소프트웨어공학은 소프트웨어 제품의 품질을 향상시키고 소프트웨어 생산성과 작업 만족도를 증대시키는 것이 목 적이다.
- 소프트웨어공학의 궁극적 목표는 최대의 비용으로 계획 된 일정보다 가능한 빠른 시일 내에 소프트웨어를 개발 하는 것이다.
- 소프트웨어공학은 신뢰성 있는 소프트웨어를 경제적인 비용으로 획득하기 위해 공학적 원리를 정립하고 이를 이용하는 것이다.
정답과 해설 보기
정답: 3
정답은 ③이다. 소프트웨어공학은 소프트웨어의 개발·운영·유지보수 등에 체계적이고 규율 있으며 측정 가능한 공학적 접근을 적용하는 분야다. 필요한 품질과 기능을 주어진 비용·일정·자원 제약 안에서 달성하도록 방법과 근거를 사용한다. 비용을 최대한 많이 쓰거나 검증을 생략하면서 무조건 빨리 만드는 것이 목표는 아니다. 품질, 생산성, 유지보수 가능성, 이해관계자의 필요 사이에서 합리적인 균형을 찾아야 한다. 계획보다 빨리 완료하는 것 자체가 잘못은 아니지만 최대 비용과 무조건적인 속도를 궁극 목표로 삼는 설명은 부적절하다.
선지별 해설
- 생명주기 활동에 체계적인 공학적 접근을 적용한다.
- 품질과 생산성 등 개발·운영 결과를 개선하려는 목적과 관련된다.
- 비용 최대화와 일정 무조건 단축은 소프트웨어공학의 목표가 아니다.
- 신뢰성과 경제성을 함께 고려하는 공학적 접근이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Introduction — Software Engineering; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — software engineering — vocabulary entry
97. 소프트웨어 개발 방법론 중 CBD(Component Based Development)에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 적절히 검증된 컴포넌트의 재사용은 생산성과 품질 개선에 도움을 줄 수 있다.
- 재사용 가능한 컴포넌트를 제작하고 조립하여 활용한다.
- CBD는 하향식 기능 분해만을 뜻하며 컴포넌트 인터페이스와 조립은 핵심 요소가 아니다.
- 명시적 인터페이스를 가진 컴포넌트 단위 관리로 복잡성 관리를 도울 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 컴포넌트 기반 개발은 명시적인 인터페이스와 계약을 가진 구성요소를 선택·개발하고 조립하여 시스템을 만드는 접근이다. 검증된 요소를 재사용하면 생산성과 품질에 도움이 될 수 있고, 책임과 인터페이스가 분리되어 있으면 교체·유지보수 범위를 줄일 수 있다. 하지만 버전 호환성이나 통합 비용 때문에 비용과 복잡성이 항상 최소화되는 것은 아니다. 하향식 기능 분해는 설계 전략의 하나로 함께 사용할 수 있지만, 그것만으로 컴포넌트의 인터페이스·조립·재사용을 중심으로 한 CBD를 정의할 수는 없다.
선지별 해설
- 검증된 요소의 적절한 재사용은 생산성과 품질 개선에 기여할 수 있다.
- 재사용 가능한 컴포넌트를 제작하고 활용하는 접근이다.
- 하향식 기능 분해만으로 CBD의 특징을 충분히 정의할 수 없다.
- 인터페이스를 통한 독립적 관리로 변경과 복잡성 관리를 도울 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §5.6 Component-Based Design (CBD); OMG UML 2.5.1 (2017) — §11.6 Components
98. 정보 보안의 3요소에 해당하지 않는 것은?
- 기밀성
- 무결성
- 가용성
- 휘발성
정답과 해설 보기
정답: 4
정답은 ④이다. 정보보안의 대표적인 세 목표는 기밀성·무결성·가용성이다. 기밀성은 허가되지 않은 정보 공개를 막고, 무결성은 부적절한 변경이나 파괴로부터 정보의 정확성과 완전성을 지키며, 가용성은 필요한 사람이 적시에 신뢰할 수 있게 접근하고 사용할 수 있도록 하는 성질이다. 휘발성은 전원이나 시간 조건에 따라 정보가 유지되는 특성 등을 설명할 때 쓰며 이 세 목표 중 하나가 아니다. 인증·책임추적성 등 다른 보안 성질도 중요하지만 여기서는 CIA라는 세 목표의 묶음을 묻는다.
선지별 해설
- 허가되지 않은 공개를 막는 기밀성이다.
- 부적절한 변경·파괴로부터 정보를 보호하는 무결성이다.
- 적시에 신뢰할 수 있게 접근·사용할 수 있는 가용성이다.
- CIA 보안 목표의 구성요소가 아니다.
편집 해설 근거: NIST FIPS 199 — §2 Information and Information System Categorization
99. 공격자가 정상 무선망과 같은 SSID 등을 사용한 가짜 Wi-Fi 액세스 포인트를 만들어 사용자의 연결을 유도한다. 이 무선망 사칭 공격을 직접 가리키는 명칭은?
[학습용 개정문항]
- Evil Twin Attack
- Phishing
- Logic Bomb
- Cyberbullying
정답과 해설 보기
정답: 1
정답은 ①이다. 무선망에서 Evil Twin은 신뢰하는 정상 네트워크를 흉내 낸 가짜 액세스 포인트로 사용자의 연결을 유도하는 공격 유형이다. 정상망과 같은 SSID 등을 내세워 사용자가 올바른 네트워크로 착각하게 만들 수 있다. 피싱은 신뢰 대상을 사칭하여 민감한 정보 제출 등을 유도하는 더 넓은 사회공학 기법으로, 가짜 무선망에서 피싱 페이지를 함께 보여 주는 경우도 있어 두 개념이 결합될 수 있다. 논리폭탄은 특정 조건에서 동작하는 악성 코드, 사이버불링은 온라인 괴롭힘을 뜻한다. 이 문항은 무선 액세스 포인트 사칭을 직접 묻는다.
선지별 해설
- 정상 무선망을 흉내 낸 가짜 액세스 포인트를 뜻하는 구체적인 공격 유형이다.
- 정보 제출 등을 속여 유도하는 사회공학 기법으로 함께 사용될 수 있지만 무선망 사칭 자체의 명칭과 다르다.
- 특정 조건에서 발동하는 악성 코드다.
- 온라인 매체를 이용한 괴롭힘이다.
편집 해설 근거: MITRE ATT&CK, Adversary-in-the-Middle: Evil Twin, T1557.004 — Description; Detection Strategy; NIST CSRC Glossary — phishing — Definitions
100. 수신자 10명이 각자 독립적인 공개키·개인키 쌍을 하나씩 사용하는 공개키 암호화에 관한 설명으로 틀린 것은? 전자서명은 별도로 생각한다.
[학습용 개정문항]
- 10명이 공개키 암호를 사용할 경우 5개의 키가 필요하 다.
- 복호화키는 비공개 되어 있다.
- 송신자는 수신자의 공개키로 문서를 암호화한다.
- 공개키 암호로 널리 알려진 알고리즘은 RSA가 있다.
정답과 해설 보기
정답: 1
정답은 ①이다. 공개키 암호화에서 각 수신자는 서로 관련된 공개키와 개인키의 한 쌍을 가진다. 수신자의 공개키로 암호화한 내용을 해당 개인키로 복호화하며 개인키는 비밀로 관리한다. 열 명이 각자 독립적인 키 쌍 하나씩을 가진다는 가정이면 10쌍, 개별 키로는 20개이므로 5개라는 계산은 틀리다. RSA는 공개키 암호 시스템의 예이며 실제 암호화에는 적절한 패딩과 검증 절차를 포함해야 한다. 전자서명의 생성·검증에서 키를 사용하는 목적과 기밀성용 암호화의 목적도 구별한다.
선지별 해설
- 각자 한 쌍이면 10쌍, 개별 키 20개이므로 5개가 아니다.
- 수신자는 복호화에 사용하는 개인키를 비밀로 관리한다.
- 기밀성용 암호화에서는 수신자의 공개키를 사용한다.
- RSA는 공개키 암호 체계의 대표적인 예다.
편집 해설 근거: IETF RFC 8017, PKCS #1: RSA Cryptography Specifications Version 2.2 (2016) — §3 Key Types; §7 Encryption Schemes; NIST SP 800-57 Part 1 Revision 5, Recommendation for Key Management — §2.1 Glossary — asymmetric-key algorithm, public key, private key, key pair
정보처리기사 필기 기출문제 학습 방법
먼저 PDF 문제지를 시간에 맞춰 푼 뒤, 이 글에서 오답의 정답·해설·근거를 확인하세요. 법규 문항은 근거 기준일 이후 개정 여부도 함께 확인하는 것이 안전합니다.