
문제지 PDF · 웹 정답 해설
정보처리기사 필기 2020년 3회 공개기출 100문항
정보처리기사 필기 2020년 3회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.

© 자격증3001. 이 정보처리기사 필기 기출문제 게시물의 문제 재구성 문장, 해설, 재작성 도식, 편집 및 PDF 디자인은 자격증3001의 저작권 보호를 받습니다. 국가기술자격 시험 및 관련 명칭의 권리는 해당 기관에 있으며, 본 자료는 Q-Net 공식 문제지 또는 공식 해설이 아닙니다. 무단 복제·재배포를 금합니다.
정보처리기사 필기 2020년 3회 공개기출 100문항 안내
정보처리기사 필기 2020년 3회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.
이 회차의 100문항 해설을 문항별 기술 원문과 필요한 독립 계산으로 편집 검토했습니다. 질문·조건·보기를 고친 문항은 학습용 개정문항으로 표시합니다. 원 시험의 공식 원문이나 공식 정답표를 새로 확인한 자료는 아닙니다.
정보처리기사 필기 기출문제 · 소프트웨어 설계
1. 요구사항 분석 시에 필요한 기술로 가장 거리가 먼 것은?
- 청취와 인터뷰 질문 기술
- 분석과 중재기술
- 설계 및 코딩 기술
- 관찰 및 모델 작성 기술
정답과 해설 보기
정답: 3
정답은 ③이다. 요구사항을 이끌어내고 분석할 때에는 이해관계자의 말을 듣고 적절한 질문을 하며, 실제 업무를 관찰하고 모델로 정리하는 능력이 중요하다. 서로 다른 요구가 충돌하면 의미와 우선순위를 분석하고 조정해야 한다. 설계와 코딩은 요구를 해결 방법과 실행 가능한 프로그램으로 구체화하는 활동이므로 보기 중 요구사항 분석의 직접적인 중심 기술과 가장 거리가 멀다. 다만 기술적 실현 가능성을 판단하거나 시제품을 만들 때 설계·코딩 지식이 도움이 될 수 있으므로 분석가에게 전혀 필요하지 않다는 뜻은 아니다.
선지별 해설
- 인터뷰에서 요구와 배경을 정확히 파악하는 데 필요하다.
- 모호하거나 충돌하는 요구를 분석하고 합의하는 데 필요하다.
- 해결 구조와 프로그램을 구현하는 기술로, 요구를 직접 도출·분석하는 중심 활동과 구별한다.
- 업무의 실제 모습을 파악하고 요구의 구조를 표현하는 데 활용한다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §2.2 Common Requirements Elicitation Techniques; §3.4 Addressing Conflict in Requirements
2. 이미지의 설명에 해당하는 디자인 패턴은?
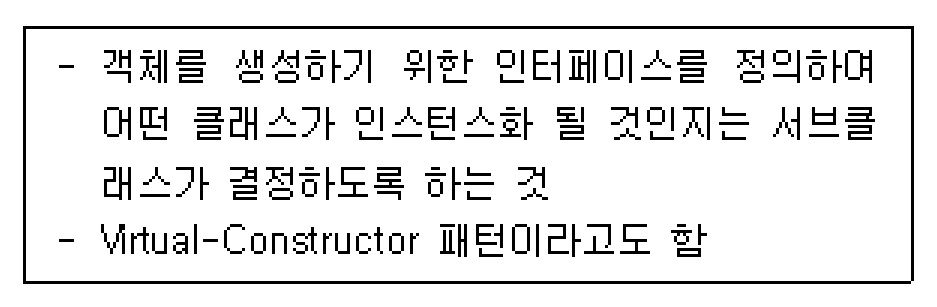
- Visitor패턴
- Observer패턴
- Factory Method 패턴
- Bridge 패턴
정답과 해설 보기
정답: 3
정답은 ③이다. Factory Method는 객체를 생성하는 공통 인터페이스를 정의하고 구체적으로 어떤 종류의 객체를 만들지는 하위 클래스가 정하도록 하는 생성 패턴이다. 이미지의 핵심 단서는 생성 인터페이스와 하위 클래스의 구체 타입 선택이며, Virtual Constructor라는 별칭도 이 패턴을 가리킨다. Visitor는 객체 구조에 적용하는 연산을 분리하고, Observer는 상태 변화에 대한 통지를 연결하며, Bridge는 추상 인터페이스와 구현이 독립적으로 변할 수 있게 한다. 단순히 여러 객체를 만든다는 이유만으로 모든 생성 코드를 Factory Method라고 부르는 것은 아니다.
선지별 해설
- 객체 구조에 수행할 연산을 별도 방문자로 분리하는 행위 패턴이다.
- 대상 변화에 관심 있는 객체들을 연결하여 통지하는 행위 패턴이다.
- 생성 인터페이스를 두고 하위 클래스가 구체 객체 타입을 선택하는 생성 패턴이다.
- 추상 인터페이스와 구현의 변화를 분리하는 구조 패턴이다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — pp. 11–14 Observer; p. 68 Bridge; p. 82 Visitor; p. 96 Factory Method
3. Rumbaugh의 OMT에서 제시하는 세 가지 주요 모델의 명칭에 포함되지 않는 것은?
[학습용 개정문항]
- 기능 모델링
- 동적 모델링
- 객체 모델링
- 정적 모델링
정답과 해설 보기
정답: 4
정답은 ④이다. Rumbaugh의 OMT는 객체 모델, 동적 모델, 기능 모델이라는 세 가지 주요 모델로 시스템을 바라본다. 객체 모델은 객체와 관계의 구조, 동적 모델은 사건과 상태 변화, 기능 모델은 입력 자료가 처리되어 출력으로 변하는 기능을 표현한다. 객체 모델이 정적인 구조를 다룬다는 설명은 맞지만, 정적 모델링을 나머지 세 모델과 별개의 네 번째 주요 모델 명칭으로 추가하지는 않는다. 따라서 개정 문항은 정적 관점이 객체지향 분석과 무관한지를 묻는 대신, OMT의 세 모델 명칭을 구별하도록 범위를 명확히 했다.
선지별 해설
- 입력·처리·출력의 자료 변환을 다루는 주요 모델이다.
- 사건에 따른 상태와 행동의 변화를 다루는 주요 모델이다.
- 객체와 관계의 정적인 구조를 다루는 주요 모델이다.
- 정적인 구조는 객체 모델의 관점이며, 세 주요 모델과 나란히 추가되는 독립 명칭이 아니다.
편집 해설 근거: Dov Dori, On Bridging the Analysis–Design and Structure–Behavior Grand Canyons with Object Paradigms (1996), 저자 제공 원문 — printed p. 26 — object, dynamic and functional models
4. 애자일 기법에 대한 설명으로 맞지 않은 것은?
- 절차와 도구보다 개인과 소통을 중요하게 생각한다.
- 계획에 중점을 두어 변경 대응이 난해하다.
- 소프트웨어가 잘 실행되는데 가치를 둔다.
- 고객과의 피드백을 중요하게 생각한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 애자일 선언은 개인과 상호작용, 작동하는 소프트웨어, 고객과의 협력, 변화에 대한 대응을 중요한 가치로 제시한다. 처음 세운 계획을 무조건 유지하여 변경 대응을 어렵게 만드는 태도는 이 방향과 맞지 않는다. 짧은 주기의 실행 결과와 고객 피드백을 이용해 요구와 계획을 조정할 수 있어야 한다. 그렇다고 애자일에서 계획·문서·계약·도구가 쓸모없다는 뜻은 아니다. 선언은 이 요소들의 가치도 인정하면서 상황에 맞는 협력과 실제 결과, 변화 대응에 더 큰 가치를 둔다는 비교를 담고 있다.
선지별 해설
- 개인과 상호작용을 중요하게 보는 선언의 방향과 맞는다.
- 고정 계획만 강조하여 변경에 대응하지 못하는 태도는 애자일 가치와 맞지 않는다.
- 실제로 작동하는 소프트웨어를 중요한 결과로 본다.
- 고객과 협력하고 피드백으로 방향을 조정하는 활동과 연결된다.
편집 해설 근거: Manifesto for Agile Software Development (2001) — Manifesto — four value comparisons and final qualification
5. 교육부 NCS 「애플리케이션 설계」(2018)의 미들웨어 솔루션 유형표에 별도 유형으로 나열되지 않은 것은?
[학습용 개정문항]
- WAS
- Web Server
- RPC
- ORB
정답과 해설 보기
정답: 2
정답은 ②이다. 이 문항에서 기준으로 삼은 NCS 학습모듈의 미들웨어 유형표는 데이터베이스, RPC, MOM, TP 모니터, ORB, WAS를 나열한다. WAS는 응용 프로그램의 실행과 연동을 지원하고, RPC는 원격 프로시저 호출, ORB는 객체 사이의 요청 중개와 관련된다. 표는 일반 웹 서버를 이들과 나란한 별도 미들웨어 유형으로 열거하지 않는다. 다만 실제 제품은 웹 서버와 응용 서버 기능을 함께 제공하거나 확장 모듈로 연동 기능을 수행할 수 있으므로, 웹 서버가 어떤 의미에서도 미들웨어가 될 수 없다는 보편적 정의로 확대해서는 안 된다.
선지별 해설
- 기준 표에 웹 응용 실행을 지원하는 미들웨어 유형으로 나열된다.
- 기준 표에 별도 유형으로 나열되지 않으며 웹 서버와 WAS의 역할을 구별한다.
- 원격 프로시저 호출을 지원하는 미들웨어 유형이다.
- 객체 요청을 중개하는 미들웨어 유형이다.
편집 해설 근거: 교육부, NCS 학습모듈 애플리케이션 설계 LM2001020221_16v4 (2018), 목원대학교 제공본 — printed pp. 51–52 — 미들웨어 솔루션의 유형; 웹서버와 웹 애플리케이션 서버
6. UML 2.5.1에서 시퀀스 상호작용의 기본 구성 요소가 아니라 프로파일 확장에 사용하는 요소는?
[학습용 개정문항]
- 생명선(Lifeline)
- 실행 명세(ExecutionSpecification)
- 확장(Extension)
- 메시지(Message)
정답과 해설 보기
정답: 3
정답은 ③이다. UML 상호작용에서 Lifeline은 참여 인스턴스의 생존선을, Message는 참여자 사이에서 전달되는 메시지를 나타낸다. ExecutionSpecification은 생명선 위에서 행동이나 동작을 실행하는 구간을 표현할 수 있다. 반면 Extension은 UML 프로파일에서 스테레오타입과 확장 대상 메타클래스를 연결하는 관계이며 시퀀스 상호작용의 기본 구성 요소와 성격이 다르다. 일상적인 의미의 기능 확장이나 시퀀스 다이어그램에 추가 표기를 사용하는 가능성과, Extension이라는 UML 메타모델 요소의 용도를 구별해야 한다.
선지별 해설
- 상호작용에 참여하는 개별 인스턴스를 나타내는 생명선이다.
- 상호작용 중 동작을 실행하는 구간을 표현한다.
- 프로파일의 스테레오타입과 메타클래스 확장을 연결하는 요소이다.
- 생명선 사이의 의사소통을 나타내는 상호작용 요소이다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §17.3 Lifelines; §17.4 Messages; §17.12.8 ExecutionSpecification; §12.4.1 Extension
7. 객체지향에서 정보 은닉과 가장 밀접한 관계가 있는 것은?
- Encapsulation
- Class
- Method
- Instance
정답과 해설 보기
정답: 1
정답은 ①이다. 캡슐화는 관련 데이터와 동작을 하나의 경계 안에 묶고, 외부가 정해진 인터페이스를 통해 사용하도록 구성하는 개념이다. 구현 세부 사항을 외부에서 직접 의존하지 않게 만드는 정보 은닉과 밀접하게 연결된다. 클래스는 이런 경계를 구현하는 수단이 될 수 있고 메서드는 동작을, 인스턴스는 구체 객체를 가리키지만, 보기 중 정보 은닉의 목적과 직접 연결되는 설계 개념은 캡슐화이다. 단지 데이터를 클래스에 넣는 것만으로 모든 내부 정보가 자동으로 숨겨지는 것은 아니며 공개 범위와 의존 관계를 함께 설계해야 한다.
선지별 해설
- 공개 인터페이스 뒤로 구현을 숨기는 정보 은닉과 직접 연결되는 설계 개념이다.
- 공통 특성을 가진 객체를 기술하는 구조이며, 존재 자체가 정보 은닉을 보장하지는 않는다.
- 객체가 제공하는 개별 동작을 가리킨다.
- 클래스 등에 따라 만들어진 구체 객체를 가리킨다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Encapsulation; Separation of interface and implementation
8. 디자인 패턴 중에서 행위적 패턴에 속하지 않는 것은?
- 커맨드 (Command) 패턴
- 옵저버 (Observer) 패턴
- 프로토타입 (Prototype) 패턴
- 상태 (State) 패턴
정답과 해설 보기
정답: 3
정답은 ③이다. GoF 패턴의 목적별 분류에서 Prototype은 생성 패턴에 속한다. 원형이 되는 인스턴스를 바탕으로 복사하여 새 객체를 만드는 책임에 초점을 두기 때문이다. Command는 요청을 객체로 표현하고, Observer는 변화 통지를 연결하며, State는 내부 상태에 따라 행동이 달라지도록 구성하는 행위 패턴이다. Prototype을 개발 초기에 만드는 시제품이라는 일반적인 말과 혼동해서는 안 된다. 또한 복사로 생성한다는 목적이 곧 모든 내부 참조까지 무조건 깊은 복사해야 한다는 규칙을 뜻하지는 않는다.
선지별 해설
- 요청을 객체로 캡슐화하는 행위 패턴이다.
- 관심 있는 대상의 변화 통지를 연결하는 행위 패턴이다.
- 원형 인스턴스의 복사를 통해 새 객체를 생성하는 생성 패턴이다.
- 내부 상태에 따라 객체의 행동을 바꾸는 행위 패턴이다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — p. 15 Design Space for GoF Patterns; p. 90 Command; p. 107 State; p. 129 Prototype
9. UI 설계 원칙 중 누구나 쉽게 이해하고 사용할 수 있어야 한다는 원칙은?
- 희소성
- 유연성
- 직관성
- 멀티운용성
정답과 해설 보기
정답: 3
정답은 ③이다. 이 문항에서 직관성은 사용자가 화면을 보고 조작 방법과 다음 행동을 비교적 쉽게 이해할 수 있게 하는 성질을 뜻한다. 익숙한 표현과 일관된 조작, 명확한 정보 구조는 사용자의 예상과 화면의 동작을 연결하는 데 도움이 된다. 유연성은 다양한 상황이나 요구에 적응할 수 있는 성질로 초점이 다르며, 희소성이나 멀티운용성은 여기서 말하는 쉬운 이해의 직접적인 명칭이 아니다. 모든 사람이 아무런 경험이나 설명 없이 모든 기능을 이해해야 한다는 절대 조건으로 해석하기보다, 대상 사용자의 맥락에서 이해 부담을 줄이는 방향으로 판단한다.
선지별 해설
- 자원이나 대상이 드문 성질을 뜻하며 쉬운 조작 이해를 가리키지 않는다.
- 다양한 조건과 요구에 적응하는 성질로, 직접적인 설명 대상과 다르다.
- 화면의 의미와 조작 방법을 쉽게 짐작하고 이해할 수 있게 하는 성질이다.
- 여러 환경에서의 운용 가능성과 혼동하기 쉬우나 직관적인 이해의 명칭은 아니다.
편집 해설 근거: Microsoft Learn, Key UI/UX design principles — Consistency; Simplicity — Make navigation intuitive; User-centricity
10. 데이터의 식별·분류를 위해 부여하는 코드 체계의 기본 기능으로 보기 어려운 것은?
[학습용 개정문항]
- 복잡성
- 표준화
- 분류
- 식별
정답과 해설 보기
정답: 1
정답은 ①이다. 여기서 코드는 프로그램의 소스 코드가 아니라 대상을 구분하기 위해 숫자·문자·기호를 부여하는 식별 체계를 말한다. 예를 들어 상품이나 부서에 일관된 번호를 부여하면 같은 대상을 식별하고 유형별로 분류하며 공통 형식으로 표준화하기 쉬워진다. 복잡성을 높이는 것 자체는 이런 코드 체계의 기본 기능으로 보기 어렵다. 코드에는 분류 정보나 검사 숫자 등을 포함할 수 있어 구조가 복잡해질 수도 있지만, 이는 필요에 따른 설계 결과일 뿐 복잡성 증가가 기능상의 목적이라는 뜻은 아니다.
선지별 해설
- 복잡성을 높이는 것 자체는 코드 체계의 기본 기능이 아니다.
- 공통된 규칙과 형식으로 대상을 표현하는 데 도움이 된다.
- 대상을 기준이나 유형에 따라 묶는 기능이다.
- 각 대상을 서로 구별하는 기능이다.
편집 해설 근거: 교육부, NCS 학습모듈 애플리케이션 설계 LM2001020221_16v4 (2018), 목원대학교 제공본 — printed p. 29 — 코드(Code); 코드의 기능
11. 선행조건과 후행조건으로 호출자와 제공자의 책임을 명시하고, 공개된 정상 상태에서 클래스 불변조건을 만족하도록 설계하는 Design by ( )의 빈칸은?
[학습용 개정문항]
- 협약(Contract)
- 프로토콜(Protocol)
- 패턴(Pattern)
- 관계(Relation)
정답과 해설 보기
정답: 1
정답은 ①이다. 계약에 의한 설계는 호출자가 지켜야 할 선행조건과 작업을 마친 제공자가 보장해야 할 후행조건을 명시하여 양쪽의 책임을 표현한다. 클래스 불변조건은 외부에 공개되는 정상 상태에서 인스턴스가 만족해야 할 제약이다. 예를 들어 잔액을 변경하는 작업은 허용된 입력을 전제로 실행하고 완료 후 잔액 관계와 객체의 유효 상태를 보장하도록 설계할 수 있다. 내부 구현의 중간 단계에서 불변조건이 잠시 깨질 수 있으므로 모든 기계 명령을 실행하는 내내 항상 참이어야 한다고 설명하면 지나치게 강한 조건이 된다.
선지별 해설
- 선행조건·후행조건·불변조건으로 책임을 명시하는 설계 개념이다.
- 통신이나 상호작용의 규약을 뜻할 수 있지만 여기서 묻는 설계 기법의 명칭은 아니다.
- 반복되는 문제의 일반적인 해결 구조를 가리키며 계약에 의한 설계의 빈칸을 직접 완성하지 않는다.
- 요소 사이의 연결을 가리키는 일반 표현으로 조건에 따른 책임 명세의 이름이 아니다.
편집 해설 근거: Eiffel Software, Design by Contract and Assertions — The Contract for a Routine; Valid State for Instances; The Contract for a Class
12. UML에서 활용되는 다이어그램 중, 시스템의 동작을 표현하는 행위(Behavioral) 다이어그램에 해당하지 않는 것은?
- 유스케이스 다이어그램(Use Case Diagram)
- 시퀀스 다이어그램(Sequence Diagram)
- 활동 다이어그램(Activity Diagram)
- 배치 다이어그램(Deployment Diagram)
정답과 해설 보기
정답: 4
정답은 ④이다. UML의 다이어그램 분류에서 배치 다이어그램은 실행 환경의 노드와 그곳에 배치되는 산출물 등의 구조를 나타낸다. 시스템이 어떤 장치나 실행 환경에 구성되는지를 다루므로 구조 다이어그램으로 분류한다. 유스케이스는 외부 행위자가 시스템을 통해 얻는 기능을, 시퀀스는 참여자 사이의 상호작용을, 활동은 행동의 흐름을 표현하므로 행위 다이어그램 계열이다. 배치라는 말에 실행 시점이 연상되더라도 배치 구조 자체와 시간에 따른 동작의 흐름을 구별해야 한다.
선지별 해설
- 행위자와 시스템이 제공하는 기능의 관계를 나타내는 행위 다이어그램이다.
- 메시지 교환 순서를 표현하는 상호작용 다이어그램으로 행위 계열에 속한다.
- 행동과 제어·객체 흐름을 표현하는 행위 다이어그램이다.
- 노드와 산출물의 배치 구조를 표현하는 구조 다이어그램이다.
편집 해설 근거: OMG UML 2.5.1 (2017) — Annex A, Figure A.5 — UML diagram taxonomy; §19 Deployments
13. 객체 지향 소프트웨어 공학에서 하나 이상의 유사한 객체들을 묶어서 하나의 공통된 특성을 표현한 것은?
- 트랜지션
- 클래스
- 시퀀스
- 서브루틴
정답과 해설 보기
정답: 2
정답은 ②이다. 클래스는 객체들이 공유하는 속성과 연산 등 공통 특성을 기술하는 분류자이다. 예를 들어 여러 고객 객체는 서로 다른 이름이나 번호를 갖더라도 고객이라는 클래스가 정의한 공통 속성과 동작을 따를 수 있다. 따라서 공통된 구조와 행동을 기술하는 클래스와 실제 값을 가진 개별 인스턴스를 구별한다. 트랜지션은 상태 사이의 전이, 시퀀스는 순서나 상호작용의 흐름, 서브루틴은 호출하여 실행하는 코드 단위를 가리키므로 유사 객체의 공통 형식을 나타내는 답과 다르다.
선지별 해설
- 상태에서 다른 상태로 바뀌는 전이를 가리킨다.
- 공통 특성을 가진 객체의 구조와 동작을 기술한다.
- 순서 또는 상호작용의 흐름을 가리키는 표현이다.
- 호출 가능한 처리 단위로, 객체의 공통 형식을 정의하는 클래스와 다르다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §11.4 Classes — semantics of class features and instances
14. 이미지의 차 클래스와 각 하위 클래스 사이 UML 관계는?
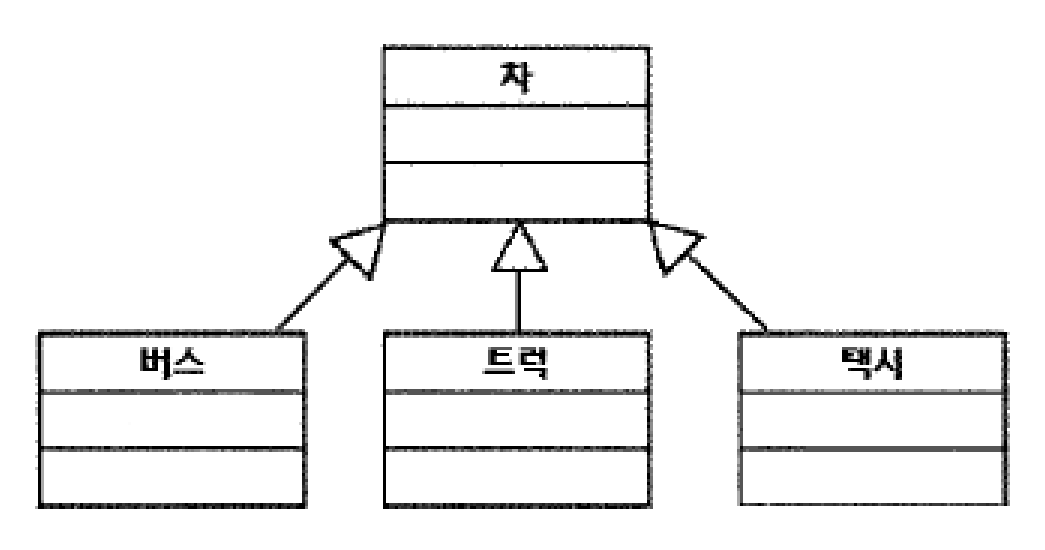
- 추상화 관계
- 의존 관계
- 일반화 관계
- 그룹 관계
정답과 해설 보기
정답: 3
정답은 ③이다. 그림의 버스·트럭·택시는 차라는 상위 개념의 특수한 종류로 해석할 수 있다. UML 일반화는 이런 하위 분류자와 더 일반적인 상위 분류자의 관계를 나타내며, 실선 끝의 속이 빈 삼각형이 상위 분류자 쪽을 향한다. 따라서 그림에서는 구체 차종에서 차 클래스로 향하는 일반화 관계를 읽는다. 공통 특성을 뽑는 사고 과정에는 추상화가 활용될 수 있지만, 주어진 선과 삼각형으로 표시한 UML 관계의 명칭은 일반화이다. 단순 사용 의존이나 임의의 그룹 묶음으로 읽지 않는다.
선지별 해설
- 공통 특성을 뽑는 추상화 과정과 관련될 수 있으나 제시 표기의 관계명은 일반화이다.
- 한 요소가 다른 요소를 사용하는 의존은 일반화의 실선·빈 삼각형 표기와 다르다.
- 하위의 구체 차종과 상위 차 클래스를 연결하는 일반화이다.
- 단순한 그룹이라는 표현은 그림의 상위·하위 분류 관계를 특정하지 못한다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §9.2 Classifiers — Generalization semantics and notation
15. GoF 디자인 패턴 설명 템플릿의 기본 항목으로 나열되지 않는 것은?
[학습용 개정문항]
- 개발자이름
- 문제 및 배경
- 사례
- 샘플코드
정답과 해설 보기
정답: 1
정답은 ①이다. GoF 패턴을 설명하는 전형적인 템플릿에는 의도, 동기, 적용 가능한 상황, 구조, 참여자, 협력, 결과, 구현 방법, 샘플 코드, 알려진 사용 사례 등이 포함된다. 문제와 배경은 패턴이 필요한 이유를, 사례와 코드는 해결 구조를 이해하고 적용하는 방법을 보여 준다. 개발자 이름은 이 템플릿의 기본 항목으로 열거되지 않는다. 그렇다고 문서에 저자나 기여자를 적으면 안 된다는 뜻은 아니며, 저작 정보와 패턴의 문제·해결 구조를 설명하는 구성 항목을 구별하는 문제이다.
선지별 해설
- 저작 정보로 기록할 수 있으나 기준 템플릿의 패턴 설명 항목에는 포함되지 않는다.
- 동기와 적용 상황을 통해 해결할 문제와 배경을 설명한다.
- 알려진 사용 사례는 실제 적용을 보여 주는 템플릿 항목이다.
- 샘플 코드는 구현 방법을 이해하도록 돕는 템플릿 항목이다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — pp. 16–17 — GoF Pattern Template, first and second half
16. 구조적 분석의 자료 사전에서 =는 정의, ( )는 생략 가능한 항목, [ ]는 대안의 선택을 나타내도록 한다. 자료 항목의 반복을 표시하는 기호는?
[학습용 개정문항]
- =
- ( )
- { }
- [ ]
정답과 해설 보기
정답: 3
정답은 ③이다. 구조적 분석의 자료 사전에서 반복되는 항목이나 묶음은 중괄호로 표현할 수 있다. 예를 들어 주문 안에 여러 주문항목이 포함되는 구조를 주문 = 주문번호 + {주문항목}처럼 적으면, 주문항목 부분이 반복될 수 있다는 의미를 전달한다. 등호는 정의이고, 문항에서 지정한 소괄호는 생략 가능한 항목, 대괄호는 대안 가운데 선택하는 항목을 나타내므로 반복과 구별한다. 프로그래밍 언어나 다른 문법 표기에서 같은 괄호를 다른 용도로 쓸 수 있어 반드시 현재 자료 사전의 표기 규칙을 기준으로 해석한다.
선지별 해설
- 항목의 내용을 정의하는 기호이다.
- 문항에 지정한 표기에서는 생략 가능한 항목을 묶는다.
- 항목이나 묶음의 반복을 나타내는 기호이다.
- 문항에 지정한 표기에서는 여러 대안 중 선택을 나타낸다.
편집 해설 근거: Francis T. Marchese, Pace University SE616 Lecture 4 — Data Dictionary Contents — Data Dictionary Contents — Notation table: Repetition {}, Definition =, Selection [ | ]
17. 상위 타입을 사용하는 문맥에서 하위 타입의 객체로 대체해도 기대한 계약과 올바른 동작이 유지되어야 한다는 객체지향 설계 원칙은?
[학습용 개정문항]
- ISP(Interface Segregation Principle)
- DIP(Dependency Inversion Principle)
- LSP(Liskov Substitution Principle)
- SRP(Single Responsibility Principle)
정답과 해설 보기
정답: 3
정답은 ③이다. 리스코프 치환 원칙은 상위 타입을 사용하는 문맥에 하위 타입의 객체를 넣어도 기대한 계약과 올바른 동작이 유지되어야 한다는 원칙이다. 핵심은 단순히 문법적으로 상속할 수 있는지가 아니라 클라이언트가 의존하는 의미를 지키는지에 있다. 하위 타입이 상위 타입의 허용 입력을 부당하게 거부하거나 약속한 결과를 지키지 못하면 치환 가능성을 해칠 수 있다. 기존 표현처럼 하위 타입을 어디서나 상위 타입으로 바꾼다는 반대 방향으로 읽으면 하위 타입만의 기능을 사용하는 문맥까지 포함하게 되어 원칙을 정확히 설명하지 못한다.
선지별 해설
- 클라이언트가 사용하지 않는 인터페이스에 의존하지 않도록 분리하는 원칙이다.
- 고수준·저수준 모듈이 적절한 추상화에 의존하도록 하는 원칙이다.
- 상위 타입을 기대하는 문맥에서 하위 타입을 올바르게 대체 사용할 수 있어야 한다는 원칙이다.
- 하나의 변경 이유에 대응하도록 책임을 응집하는 원칙이다.
편집 해설 근거: Robert C. Martin, Solid Relevance (2020-10-18) — LSP; ISP; DIP; SRP sections
18. 자료흐름도(Data Flow Diagram)의 구성요소로 옳은 것은?
- process, data flow, data store, comment
- process, data flow, data store, terminator
- data flow, data store, terminator, data dictionary
- process, data store, terminator, mini-spec
정답과 해설 보기
정답: 2
정답은 ②이다. 자료흐름도는 자료를 변환하는 처리, 처리를 연결하는 자료 흐름, 자료를 보관하는 저장소, 시스템 경계 밖에서 자료를 주고받는 외부 개체로 구성한다. 여기서 terminator는 외부의 자료 원천이나 목적지를 뜻하며 프로그램을 종료하는 명령이라는 뜻이 아니다. 자료 사전은 흐름과 저장소의 자료 내용을 정의하고 미니 명세는 세부 처리 논리를 설명하는 데 활용되지만, 둘을 자료흐름도 자체의 네 가지 기본 도형 요소로 세지는 않는다. 주석도 이해를 돕는 부가 설명과 기본 구성 요소를 구별해야 한다.
선지별 해설
- 외부 개체 대신 주석이 들어 있어 네 가지 기본 요소 목록과 다르다.
- 처리·자료 흐름·자료 저장소·외부 개체를 모두 포함한다.
- 자료 사전은 보조 명세이며 목록에서 처리가 빠져 있다.
- 미니 명세는 처리 내용을 설명하는 보조 명세이며 자료 흐름이 빠져 있다.
편집 해설 근거: Connell·Wenneson, NASA CR-177625 Software Engineering Guidebook (1993) — §4.1.1.1 Dataflow Models
19. CASE(Computer-Aided Software Engineering)도구에 대한 설명으로 거리가 먼 것은?
[학습용 개정문항]
- 소프트웨어 개발 활동의 일부 또는 여러 부분을 지원할 수 있다.
- 모델과 문서의 일관된 형식 적용을 지원할 수 있다.
- 작업 결과와 자료의 공유를 통해 협업을 도울 수 있다.
- 어떤 프로젝트에서도 사람의 판단 없이 모든 개발 활동을 자동으로 완성한다.
정답과 해설 보기
정답: 4
정답은 ④이다. CASE는 컴퓨터를 이용해 소프트웨어 공학 활동을 지원하는 도구와 기법을 말한다. 요구 추적, 모델 작성, 코드 생성, 시험, 문서 생성 등 일부 또는 여러 활동을 지원할 수 있다. 통합된 환경은 공통 자료와 작업 결과를 공유하고 일관된 형식을 적용하는 데 도움이 되지만 모든 제품이 같은 기능을 제공하는 것은 아니다. 도구를 사용한다고 요구 판단과 설계 의사결정 등 모든 업무가 자동으로 끝나는 것도 아니다. 따라서 어떠한 프로젝트든 사람의 판단 없이 전체 개발을 완성한다고 단정하는 설명은 성립하지 않는다.
선지별 해설
- 요구·설계·구현·시험 등 개발 활동의 일부 또는 여러 부분을 지원할 수 있다.
- 도구와 설정에 따라 표준 형식의 모델·문서 작성을 지원할 수 있다.
- 통합 환경의 공유 자료와 산출물은 협업을 도울 수 있다.
- 도구 사용만으로 모든 판단과 개발이 자동 완료된다고 보장할 수 없다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.485 CASE tool; §3.737 computer-aided software engineering
20. 소프트웨어 산출물의 검토 및 개선 활동에 대한 설명으로 옳은 것은?
[학습용 개정문항]
- 리팩터링은 요구사항 명세서를 읽는 공식 검토 회의이다.
- 동료 검토는 업무를 이해하는 동료가 산출물의 결함과 개선점을 검토하는 활동이다.
- 인스펙션은 사람의 검토 없이 자동 요구사항 도구만 실행하는 것이다.
- CASE 도구는 자료를 사전 배포한 뒤 사람이 검토 회의를 여는 절차 자체이다.
정답과 해설 보기
정답: 2
정답은 ②이다. 동료 검토는 해당 업무를 이해하는 동료가 산출물을 읽고 결함이나 개선점을 검토하는 활동이다. 작성자가 설명을 이끄는 워크스루는 하나의 검토 방식이며, 모든 동료 검토가 반드시 이런 형식으로 진행되는 것은 아니다. 인스펙션은 정해진 역할과 절차, 개별 검토 준비 등을 갖춘 체계적인 검토 방식이다. 리팩터링은 외부 동작을 유지하면서 내부 코드 구조를 개선하는 활동이고, CASE 도구는 공학 작업을 지원하는 소프트웨어이다. 사람의 검토 방식과 구조 개선 작업, 지원 도구를 구별하면 정답을 판단할 수 있다.
선지별 해설
- 리팩터링은 외부 동작을 유지하는 내부 구조 개선으로, 요구사항 검토 회의의 이름이 아니다.
- 업무를 이해하는 동료가 산출물의 결함과 개선점을 검토하는 설명이다.
- 인스펙션은 역할과 절차를 갖춘 검토이며 자동 도구 실행만을 뜻하지 않는다.
- CASE 도구는 공학 활동을 지원하는 도구로, 사람의 회의 절차 자체가 아니다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §3.2.3 Review Types — peer reviews, walkthrough and inspection; Martin Fowler, Refactoring — Definition; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.485 CASE tool
정보처리기사 필기 기출문제 · 소프트웨어 개발
21. 다음 프로토콜의 본래 목적을 비교할 때, 통신 보호보다 전자우편 전송을 기본 목적으로 하는 것은?
[학습용 개정문항]
- IPSec
- SSL
- SMTP
- S-HTTP
정답과 해설 보기
정답: 3
정답은 ③이다. SMTP의 기본 목적은 전자우편을 전달하는 것이며 통신 보안을 제공하는 방식 자체의 이름이 아니다. IPsec은 IP 계층에서 보안 서비스를 제공하고, SSL과 S-HTTP는 통신이나 HTTP 메시지를 보호하려고 정의된 과거의 기술이다. 다만 이 분류를 현재 제품의 보안 설정 권고로 받아들이면 안 된다. SSL 3.0은 사용이 금지된 낡은 프로토콜이고 S-HTTP는 실험적 문서로 발표되었다. SMTP 통신도 별도의 보안 확장이나 TLS를 적용해 보호할 수 있으므로 SMTP가 어떤 경우에도 암호화될 수 없다는 뜻은 아니다.
선지별 해설
- IP 계층의 인증·무결성·기밀성 등 보안 서비스를 위한 아키텍처이다.
- 과거의 통신 보호 프로토콜 계열이며 SSL 3.0은 현재 사용하면 안 된다.
- 기본 목적이 전자우편 전송인 프로토콜이다.
- HTTP 메시지 보호를 목적으로 발표된 실험적 보안 프로토콜이다.
편집 해설 근거: IETF RFC 5321, Simple Mail Transfer Protocol (2008) — §1 Introduction; §2 The SMTP Model; IETF RFC 4301, Security Architecture for the Internet Protocol (2005) — §2.1 Goals/Objectives/Requirements/Problem Description; IETF RFC 2660, The Secure HyperText Transfer Protocol (1999), Experimental — Abstract; Status of this Memo; IETF RFC 7568, Deprecating Secure Sockets Layer Version 3.0 (2015) — §3 Do Not Use SSL Version 3.0
22. 소프트웨어 공학의 기본 원칙이라고 볼 수 없는 것은?
- 품질 높은 소프트웨어 상품 개발
- 지속적인 검증 시행
- 결과에 대한 명확한 기록 유지
- 최대한 많은 인력 투입
정답과 해설 보기
정답: 4
정답은 ④이다. 소프트웨어 공학에서는 요구에 맞는 품질을 확보하고 개발 과정에서 결과를 검증하며, 필요한 기록으로 판단과 변경을 추적할 수 있게 하는 것이 중요하다. 인력은 작업의 성격과 일정, 구성원의 능력, 팀 간 의존 관계를 고려하여 배치해야 한다. 인원수를 무조건 최대로 늘리는 것 자체는 품질이나 납기 달성을 보장하는 원칙이 아니다. 새 인력의 교육과 업무 조정, 소통에도 시간이 필요할 수 있다. 반대로 인력을 늘리는 것이 언제나 나쁘다는 뜻도 아니며, 목표를 달성하는 데 필요한 자원을 적절히 배치하는 판단이 핵심이다.
선지별 해설
- 요구와 목적을 만족하는 품질은 소프트웨어 공학의 중요한 목표이다.
- 생명주기 중 검증 활동을 반복하여 문제를 확인하는 방향이다.
- 필요한 결과와 판단 기록은 추적과 관리에 도움이 된다.
- 필요성과 조정 비용을 고려하지 않고 인력만 최대화하는 것은 일반 원칙이 아니다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Management §2.4 Resource Allocation; §2.6 Quality Management; §2.7 Plan Management
23. 1994년에 발행되어 소프트웨어 패키지의 품질 요구사항과 시험 지침을 다루었고, 이후 ISO/IEC 25051 계열로 대체된 과거 국제 표준은?
[학습용 개정문항]
- ISO/IEC 2196
- IEEE 19554
- ISO/IEC 12119
- ISO/IEC 14959
정답과 해설 보기
정답: 3
정답은 ③이다. ISO/IEC 12119:1994는 소프트웨어 패키지의 품질 요구사항과 그 요구에 대한 시험 지침을 다룬 과거 표준이다. 제공되고 인도되는 패키지를 대상으로 하며 공급자의 모든 개발 과정이나 품질 시스템 전체를 규정하는 표준으로 확대해서는 안 된다. 이 표준은 2006년에 폐지되어 ISO/IEC 25051:2006으로 대체되었고, 후속 2014판은 사용 준비가 된 소프트웨어 제품의 품질 요구사항과 시험 문서·적합성 평가를 다룬다. 따라서 현재 유효한 표준을 묻는 문제와 과거 표준의 번호를 식별하는 문제를 구별해야 한다.
선지별 해설
- 문항에 제시한 1994년 패키지 품질·시험 표준의 식별 번호와 일치하지 않는다.
- 문항이 묻는 ISO/IEC 표준의 기관 표기와 번호에 맞지 않는다.
- 과거 패키지 소프트웨어의 품질 요구사항과 시험 지침을 다룬 표준 번호이다.
- 문항에 제시한 과거 표준의 식별 번호와 다르다.
편집 해설 근거: ISO, ISO/IEC 12119:1994 공식 개요 및 상태 — Abstract; General information; Life cycle — withdrawn 2006-03-31, revised by ISO/IEC 25051:2006; ISO, ISO/IEC 25051:2014 공식 개요 및 상태 — Abstract; Life cycle; 2026 confirmation
24. 다음 중 클린 코드 작성원칙으로 거리가 먼 것은?
- 누구든지 쉽게 이해하는 코드 작성
- 중복이 최대화된 코드 작성
- 다른 모듈에 미치는 영향 최소화
- 단순, 명료한 코드 작성
정답과 해설 보기
정답: 2
정답은 ②이다. 읽기 쉬운 코드는 이름과 구조가 의도를 드러내고, 필요한 기능을 불필요하게 복잡하게 만들지 않는 방향으로 작성한다. 같은 업무 규칙을 여러 곳에 복제하면 규칙을 바꿀 때 일부만 수정하여 동작이 달라지는 문제가 생길 수 있으므로 중복을 최대화하는 것은 목표가 아니다. 변경 영향을 줄이도록 책임과 의존 관계를 정리하는 것도 이해와 유지보수에 도움이 된다. 다만 중복을 한 줄도 남기지 않으려고 서로 다른 개념을 억지로 추상화하면 복잡성이 커질 수 있으므로 실제 의미가 같은지를 판단하면서 개선해야 한다.
선지별 해설
- 의도를 이해할 수 있는 이름과 구조를 선택하는 방향이다.
- 동일 규칙의 불필요한 복제를 늘리는 것은 유지보수와 일관성을 해칠 수 있다.
- 책임과 의존 관계를 정리하여 변경의 파급을 줄이는 방향이다.
- 필요한 동작을 명료하게 표현하고 불필요한 복잡성을 줄이는 방향이다.
편집 해설 근거: Google Engineering Practices, What to look for in a code review — Design; Complexity; Naming; Comments; Martin Fowler, Refactoring — Definition
25. 다음 중 명세의 입력·출력 조건이나 테스터의 경험보다 프로그램 내부의 제어 구조를 직접 이용하는 시험은?
[학습용 개정문항]
- 경계값 분석
- 오류 예측
- 동등 분할 기법
- 조건, 루프 검사
정답과 해설 보기
정답: 4
정답은 ④이다. 조건이나 반복문의 실행 구조를 직접 살펴 시험하는 방식은 내부 구현을 이용하는 구조 기반 시험에 해당한다. 동등 분할과 경계값 분석은 입력·출력의 명세에서 같은 성질의 집합이나 경계를 찾아 시험값을 고를 수 있다. 오류 추정은 테스터가 경험으로 예상한 실수와 결함을 이용하는 기법이다. ISTQB는 오류 추정을 경험 기반 기법으로 따로 분류하므로 이를 엄밀한 의미의 명세 기반 블랙박스 기법이라고 단정하지 않는다. 개정 문항은 이런 분류 차이를 반영하여 내부 조건·반복 구조를 직접 이용하는 선택지를 찾도록 했다.
선지별 해설
- 명세에서 정의한 유효·무효 범위의 경계 부근 값을 이용할 수 있다.
- 경험으로 예상하는 오류와 결함을 바탕으로 시험을 설계한다.
- 같은 방식으로 처리될 것으로 기대하는 입력·출력 집합을 나누는 기법이다.
- 코드의 조건과 반복 구조를 직접 이용하는 구조 기반 시험이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §4.2.1 Equivalence Partitioning; §4.2.2 Boundary Value Analysis; §4.3 White-box Test Techniques; §4.4.1 Error Guessing
26. 이미지의 정점 수를 N, 방향별 간선 수를 E라 한다. 이 문항에서 McCabe 순환복잡도 계산식 V=E−N+2를 적용한 값은?
[학습용 개정문항]
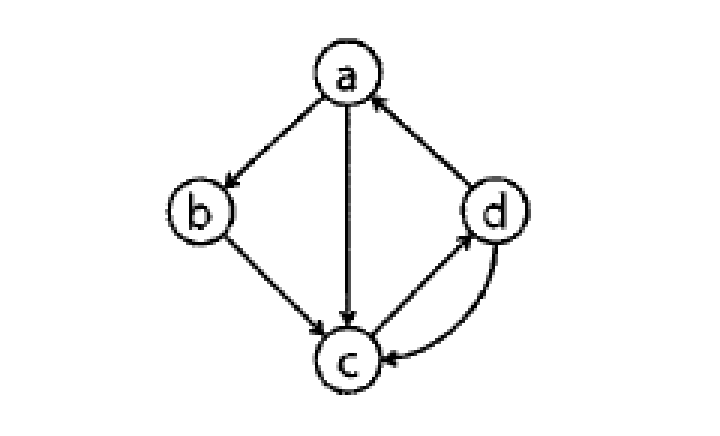
- 3
- 4
- 5
- 6
정답과 해설 보기
정답: 2
정답은 ②이다. 그림의 정점은 a, b, c, d의 네 개이고 간선은 a→b, b→c, a→c, c→d, d→c, d→a의 여섯 개이다. 문항에서 지정한 단일 모듈의 계산식 E−N+2에 대입하면 6−4+2=4가 된다. c와 d 사이의 두 화살표는 방향이 반대인 서로 다른 간선이므로 하나로 합쳐 세면 안 된다. 또한 일반 그래프의 순환 계수 E−N+1을 그대로 쓰면 3이 되어 다른 값을 얻게 된다. 제시 그림은 진입·종료 표시가 충분하지 않으므로 실제 실행 가능한 모든 제어 경로를 추정하기보다 명시된 계산 규칙을 적용한다.
선지별 해설
- E−N+1을 적용하면 나오지만 이 문항에 지정한 식과 다르다.
- 간선 6개, 정점 4개를 E−N+2에 넣은 결과이다.
- 그림과 계산식에서 이 값을 얻으려면 간선이나 정점을 잘못 세어야 한다.
- 간선 수만 제시한 값으로 정점 수에 대한 보정이 빠져 있다.
편집 해설 근거: NIST SP 500-235, Structured Testing (1996) — §2.2 Definition of cyclomatic complexity, v(G), printed p. 10
27. 이미지의 배열 37, 14, 17, 40, 35를 오름차순 선택정렬한다. 각 회전에서 남은 구간의 최솟값을 그 구간 첫 원소와 교환할 때 3회전 직후의 배열은?
[학습용 개정문항]
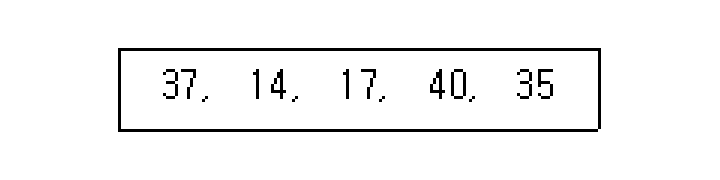
- 14, 17, 37, 40, 35
- 14, 37, 17, 40, 35
- 17, 14, 37, 35, 40
- 14, 17, 35, 40, 37
정답과 해설 보기
정답: 4
정답은 ④이다. 오름차순 선택정렬에서 아직 정렬하지 않은 구간의 최솟값을 찾아 그 구간의 첫 원소와 교환한다. 처음에는 14를 찾아 37과 바꾸므로 14, 37, 17, 40, 35가 된다. 두 번째에는 남은 구간의 최솟값 17을 37과 바꾸어 14, 17, 37, 40, 35가 된다. 세 번째에는 35를 37과 바꾸므로 14, 17, 35, 40, 37이 된다. 각 회전은 비교 한 번이 아니라 최솟값을 찾고 위치를 확정하는 한 단계이며, 3회전이 끝나도 뒤쪽의 40과 37은 아직 정렬되지 않을 수 있다.
선지별 해설
- 두 번째 회전까지 진행한 결과이다.
- 첫 번째 회전에서 14를 앞으로 옮긴 결과이다.
- 최솟값 14가 첫 위치에 오지 않아 지정한 오름차순 선택정렬의 결과가 아니다.
- 세 번째 회전에서 35를 세 번째 위치로 교환한 결과이다.
편집 해설 근거: NIST DADS — selection sort — Definition; Note — swapping the least remaining item into the next position
28. 형상 관리 도구의 주요 기능으로 거리가 먼 것은?
- 정규화(Normalization)
- 체크인(Check-in)
- 체크아웃(Check-out)
- 커밋(commit)
정답과 해설 보기
정답: 1
정답은 ①이다. 형상 관리 도구에 포함되는 버전 관리 기능은 파일과 산출물의 변경 이력을 보관하고 필요한 버전을 가져오거나 변경 결과를 기록하게 한다. 체크아웃은 저장소에서 작업 사본 등을 얻는 동작으로, 체크인이나 커밋은 변경을 관리 이력에 반영하는 동작으로 쓰인다. 구체적인 의미와 저장 위치는 도구마다 다르므로 모든 시스템에서 커밋이 곧 원격 전송이라고 생각하면 안 된다. 데이터베이스 정규화는 종속 관계를 고려하여 관계 구조를 정리하는 설계 활동이며 이런 기본적인 변경 이력 관리 명령과는 목적이 다르다.
선지별 해설
- 데이터베이스의 관계 구조를 정리하는 설계 활동으로 버전 관리의 기본 명령이 아니다.
- 일반적으로 작업 결과를 관리 저장소에 반영하는 동작을 가리킨다.
- 버전 관리 대상의 작업 사본을 얻는 등의 동작을 가리킨다.
- 변경 내용을 하나의 관리 이력으로 기록하는 동작이다.
편집 해설 근거: Subversion 개발자 저술, Version Control with Subversion 1.7 — Version Control Basics — The Repository; The Working Copy; Versioning Models; Collins-Sussman·Fitzpatrick·Pilato, Version Control with Subversion 1.7, svn commit — Name; Description
29. 이미지의 트리를 전위 순회할 때 가장 먼저 탐색되는 노드는?
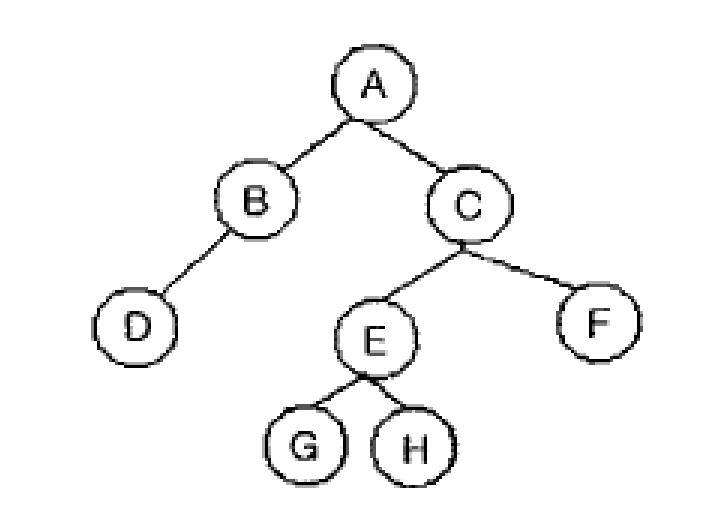
- A
- B
- D
- G
정답과 해설 보기
정답: 1
정답은 ①이다. 전위 순회는 현재 노드를 먼저 방문한 다음 그 노드의 하위 트리를 정해진 순서대로 순회한다. 그림의 루트가 A이므로 자식 쪽으로 내려가기 전에 가장 먼저 A를 방문한다. 자식들을 왼쪽부터 처리하면 전체 방문 순서는 A, B, D, C, E, G, H, F가 된다. D나 G처럼 더 깊은 노드를 먼저 선택하는 것은 전위 순회의 현재 노드 우선 규칙과 맞지 않는다. 문항은 전체 순서가 아니라 첫 노드만 묻고 있으므로 루트를 먼저 찾고 전위의 방문 시점을 연결하면 충분하다.
선지별 해설
- 전위 순회는 루트 A를 먼저 방문한다.
- B는 A를 방문한 뒤 왼쪽 하위 트리에서 방문한다.
- D는 A와 B를 방문한 뒤에 도달한다.
- G는 A의 오른쪽 하위 트리로 이동한 뒤에 방문한다.
편집 해설 근거: NIST DADS, preorder traversal — Definition
30. 소프트웨어 품질 목표 중 주어진 시간동안 주어진 기능을 오류없이 수행하는 정도를 나타내는 것은?
- 직관성
- 사용 용이성
- 신뢰성
- 이식성
정답과 해설 보기
정답: 3
정답은 ③이다. 신뢰성은 정해진 조건과 기간 동안 시스템이나 구성 요소가 요구된 기능을 수행하는 능력 또는 정도를 뜻한다. 기능이 한 번 성공한 사실만으로 장시간의 신뢰성을 모두 판단할 수 없으며 운용 조건과 관찰 기간을 함께 정해야 한다. 직관성과 사용 용이성은 사용자가 이해하고 조작하는 경험에, 이식성은 다른 환경으로 옮겨 적용하는 데 초점이 있다. 또한 신뢰성이 높다는 표현을 소프트웨어에 결함이 하나도 없다는 절대 보장으로 읽기보다, 정해진 환경에서 요구 동작을 지속적으로 제공하는 성질로 이해한다.
선지별 해설
- 사용자가 기능과 조작을 쉽게 짐작하는 성질에 가깝다.
- 사용자가 배우고 조작하는 부담과 관련된다.
- 지정된 조건과 기간에 요구된 기능을 수행하는 능력이다.
- 다른 환경으로 옮겨 사용할 수 있는 정도와 관련된다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.3387 reliability
31. 알고리즘 설계 기법으로 거리가 먼 것은?
- Divide and Conquer
- Greedy
- Static Block
- Backtracking
정답과 해설 보기
정답: 3
정답은 ③이다. 분할 정복은 문제를 작은 하위 문제로 나누어 풀고 결과를 결합하는 전략이며, 탐욕법은 매 단계에서 현재 기준으로 가장 유리한 선택을 하는 전략이다. 백트래킹은 선택을 진행하다 조건을 만족할 수 없으면 이전 선택 지점으로 돌아가 다른 후보를 탐색한다. Static Block은 이들과 함께 분류하는 일반적인 알고리즘 설계 전략의 명칭이 아니다. 또한 탐욕적으로 고른 결과가 모든 문제에서 전역 최적해를 보장하는 것은 아니고, 백트래킹도 단순히 모든 계산을 처음부터 다시 시작하는 방법으로 한정되지 않는다.
선지별 해설
- 문제를 나누어 해결하고 결과를 결합하는 분할 정복 전략이다.
- 현재 단계의 기준에서 유리한 선택을 반복하는 탐욕 전략이다.
- 나머지 보기와 같은 일반적인 알고리즘 설계 전략의 명칭이 아니다.
- 실패한 선택에서 되돌아가 다른 후보를 시도하는 탐색 전략이다.
편집 해설 근거: NIST DADS, divide and conquer — Definition; NIST DADS, greedy algorithm — Definition; NIST DADS, backtracking — Definition; Note
32. 다음 중 소프트웨어 형상 관리의 직접적인 중심 역할과 가장 거리가 먼 것은?
[학습용 개정문항]
- 이전 리비전과 버전의 이력을 추적하여 배포본 구성을 관리한다.
- 정책에 따라 소스 변경 권한과 승인 절차를 적용한다.
- 프로젝트 전체 예산을 추정하고 부문별 개발비를 배분한다.
- 여러 개발자의 변경을 관리하고 통합하도록 지원한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 형상 관리는 소프트웨어와 관련 산출물을 식별하고 변경을 통제하며, 버전과 상태를 기록하고 배포 구성을 확인하는 활동이다. 이에 따라 이전 버전을 찾거나 변경 권한을 적용하고 여러 개발자의 작업을 통합하는 데 도움이 된다. 이런 활동이 재작업을 줄여 비용에 간접적인 영향을 줄 수는 있지만, 전체 프로젝트 예산을 추정·배분·통제하는 일 자체가 형상 관리의 직접적인 중심 책임은 아니다. 형상 관리와 프로젝트 비용 관리가 전혀 관계없다는 뜻으로 읽지 않도록 직접 역할과 간접 효과를 구별해야 한다.
선지별 해설
- 버전과 변경 이력을 추적하여 배포 구성을 확인하는 직접적인 활용이다.
- 변경 승인과 저장소 권한 정책으로 부적절한 변경을 제한할 수 있다.
- 프로젝트 전체 예산의 추정과 배분은 별도의 프로젝트 관리 책임에 가깝다.
- 작업 사본과 변경 통합을 이용하여 여러 개발자의 협업을 지원할 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Configuration Management §3 Software Configuration Change Control; §4 Software Configuration Status Accounting; §6 Software Release Management and Delivery; Software Engineering Management §2.3 Effort, Schedule, and Cost Estimation
33. 제품 소프트웨어 패키징 도구 활용 시 고려사항이 아닌 것은?
[학습용 개정문항]
- 보호가 필요한 콘텐츠에는 대상 환경에 적합한 암호화 등의 방식을 검토한다.
- 대상 환경과 이기종 시스템의 호환성을 검토한다.
- 사용자 편의성을 해치는 복잡성과 비효율을 검토한다.
- 내부 콘텐츠와 배포 산출물의 보안은 고려하지 않는다.
정답과 해설 보기
정답: 4
정답은 ④이다. 소프트웨어를 배포할 패키지로 만들 때에는 대상 환경에서 설치·실행할 수 있는지, 필요한 파일과 의존성이 포함되었는지, 사용자가 절차를 이해할 수 있는지 등을 확인한다. 보호가 필요한 콘텐츠나 배포 산출물에는 위협과 요구에 맞는 암호화·서명·무결성 검증 등을 검토해야 한다. 모든 파일을 반드시 암호화해야 한다는 뜻은 아니지만 보안을 아예 고려하지 않는다는 설명은 적절하지 않다. 보안 조치와 이기종 호환성, 설치 편의성은 서로 영향을 줄 수 있으므로 실제 배포 환경에서 함께 검증하는 것이 중요하다.
선지별 해설
- 기밀성 보호가 필요한 경우 데이터 형식과 실행 환경에 맞는 암호화 방식을 검토한다.
- 대상 운영체제·장치·의존 요소 사이의 호환성을 검토한다.
- 설치와 사용을 어렵게 하는 불필요한 복잡성이나 비효율을 검토한다.
- 위협과 요구사항에 따른 콘텐츠·배포 보안을 아예 제외하는 것은 부적절하다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Configuration Management §6.2 Software Release Management, printed pp. 8-13–8-14; Microsoft PlayReady, Content Packaging and Delivery — Packaging PlayReady content — Encrypting and inserting the DRM header
34. DRM의 직접적인 콘텐츠 이용 권한 관리 목적과 가장 거리가 먼 것은?
[학습용 개정문항]
- 콘텐츠 암호화 및 키 관리
- 콘텐츠와 관련 권리·키의 식별 정보 표현
- 전송 중 우연한 비트 오류의 감지와 복구 자체
- 라이선스 발급 및 이용 권한 관리
정답과 해설 보기
정답: 3
정답은 ③이다. DRM은 콘텐츠에 허용된 사용 권리와 제한을 연결하고 이를 집행하기 위한 체계이다. 콘텐츠를 암호화하고 키와 식별 정보를 관리하며, 어떤 사용자가 어느 조건으로 이용할 수 있는지 라이선스로 전달하는 기능이 핵심이다. 전송 중 우연한 비트 오류를 찾아 재전송하거나 복구하는 기능 자체는 일반적인 데이터 전달의 신뢰성 문제에 가깝다. DRM 구현도 무결성 검사나 오류 처리를 사용할 수 있으므로 그런 기능이 절대로 존재하지 않는다는 뜻은 아니다. 직접적인 이용 권한 관리와 통신 오류 복구라는 목적을 비교해야 한다.
선지별 해설
- 허가된 이용만 가능하도록 콘텐츠와 복호화 키를 보호하는 핵심 기능이다.
- 콘텐츠·키·권리 정보를 올바르게 연결하기 위한 식별 정보가 필요하다.
- 전송 중 우연한 비트 오류의 복구 자체는 이용 권한 관리의 직접 목적과 거리가 멀다.
- 허용된 사용과 제한 조건을 라이선스로 발급하고 관리하는 기능이다.
편집 해설 근거: Microsoft PlayReady, Simple End to End System — Overview of an End-to-End Video Service; Basic encryption and licensing process; Microsoft PlayReady, Content Packaging and Delivery — Packaging PlayReady content — Encrypting and inserting the DRM header
35. Oracle Database 19c의 파티셔닝 전략 설명에서 기본 또는 복합 분할 유형의 이름으로 나열되지 않는 것은?
[학습용 개정문항]
- 범위분할(Range Partitioning)
- 해시분할(Hash Partitioning)
- 조합분할(Composite Partitioning)
- 유닛분할(Unit Partitioning)
정답과 해설 보기
정답: 4
정답은 ④이다. Oracle의 파티셔닝 설명에서 범위 분할은 키 값의 구간으로, 해시 분할은 키에 해시 함수를 적용한 결과로 행을 나눈다. 복합 또는 조합 분할은 먼저 한 방식으로 파티션을 만든 다음 그 안을 다른 기준으로 하위 분할하는 방식이다. 예를 들어 날짜 구간으로 나눈 뒤 각 구간 안에서 해시 분할을 적용할 수 있다. Unit Partitioning은 문항에서 기준으로 삼은 문서의 이들 기본·복합 분할 전략 이름에 포함되지 않는다. 모든 DBMS가 동일한 분할 이름과 기능을 제공한다고 일반화하지 않는 것이 중요하다.
선지별 해설
- 분할 키의 값 범위에 따라 행을 배치하는 유형이다.
- 분할 키의 해시 결과를 이용하여 행을 배치하는 유형이다.
- 분할과 하위 분할에 방식을 조합하는 유형이다.
- 기준 문서의 기본 및 복합 파티셔닝 전략 이름에 포함되지 않는다.
편집 해설 근거: Oracle Database 19c VLDB and Partitioning Guide, Partitioning Concepts — §2.3.1.1 Range Partitioning; §2.3.1.2 Hash Partitioning; §2.3.2 Composite Partitioning
36. 이미지의 설명에 해당하는 통합 테스트 유형은?
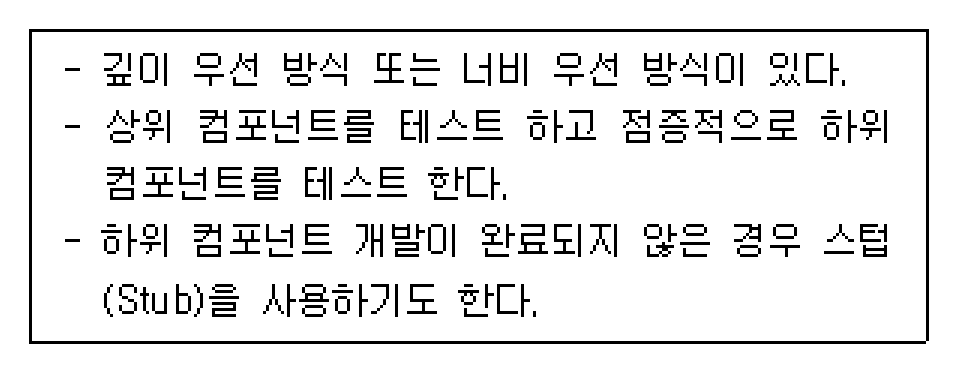
- 하향식 통합 테스트
- 상향식 통합 테스트
- 회귀 테스트
- 빅뱅 테스트
정답과 해설 보기
정답: 1
정답은 ①이다. 상위 구성 요소에서 시작하여 하위 구성 요소를 점진적으로 연결하는 흐름은 하향식 통합 시험이다. 호출할 하위 구성 요소가 아직 준비되지 않았다면 그 인터페이스에 필요한 동작을 대신 제공하는 스텁을 사용할 수 있다. 같은 하향식 전략 안에서도 한 갈래를 먼저 내려가는 깊이 우선이나 같은 수준을 먼저 연결하는 너비 우선 방식을 선택할 수 있다. 상향식은 낮은 수준에서 위로 통합하며 필요한 호출 역할을 드라이버로 대신할 수 있다. 회귀 시험은 변경의 부작용을 확인하는 목적이고 빅뱅은 여러 요소를 한꺼번에 통합하는 접근이다.
선지별 해설
- 상위에서 하위로 점진적으로 통합하며 미완성 하위 요소에 스텁을 사용할 수 있다.
- 낮은 수준에서 위로 통합하므로 이미지의 진행 방향과 반대이다.
- 변경 뒤 기존 동작에 부작용이 없는지 확인하는 시험 목적이다.
- 점진적인 방향별 연결보다 여러 요소를 한꺼번에 묶는 통합 방식이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Testing §2.1.2 Integration Testing; §8.2 Categories of Tools — Test harnesses; ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §2.2.1 Component Testing; §2.2.2 Integration Testing; §2.3.4 Change-related Testing
37. 이미지의 설명에 해당하는 인터페이스 구현 기술은?
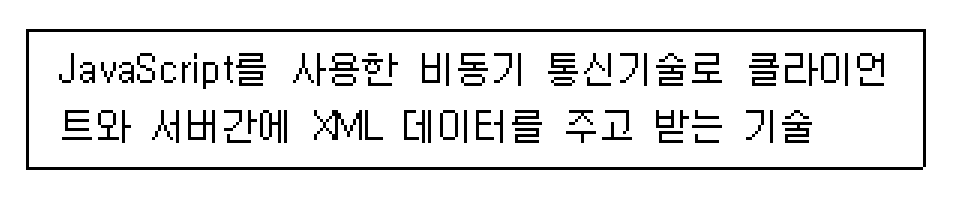
- Procedure
- Trigger
- Greedy
- AJAX
정답과 해설 보기
정답: 4
정답은 ④이다. AJAX는 JavaScript를 이용하여 비동기 HTTP 요청으로 서버의 자료를 받고 페이지의 필요한 부분을 갱신하는 웹 개발 기법이다. 이름에 XML이 들어 있고 그림도 XML 자료 교환을 예로 들지만, 실제로는 JSON이나 텍스트 등 다른 형식의 응답도 사용할 수 있다. 페이지 전체를 다시 불러오지 않고 필요한 내용을 갱신한다는 동작이 핵심이다. 저장 프로시저와 트리거는 데이터베이스 안의 처리와 관련되고, 탐욕법은 알고리즘 선택 전략이므로 그림의 브라우저와 서버 사이 비동기 통신 기법과는 다르다.
선지별 해설
- 일반적인 절차 또는 데이터베이스에 저장된 처리 단위를 가리킨다.
- 지정된 데이터베이스 사건에 반응하여 실행하는 처리와 관련된다.
- 매 단계에서 유리한 선택을 하는 알고리즘 전략이다.
- 비동기 요청을 이용해 서버 자료로 화면 일부를 갱신하는 웹 개발 기법이다.
편집 해설 근거: MDN Web Docs, Ajax glossary — Ajax definition; XMLHttpRequest and fetch implementations
38. 소프트웨어 재공학이 소프트웨어의 재개발에 비해 갖는 장점으로 거리가 먼 것은?
- 위험부담 감소
- 비용 절감
- 시스템 명세의 오류억제
- 개발시간의 증가
정답과 해설 보기
정답: 4
정답은 ④이다. 재공학은 기존 소프트웨어를 조사하고 변경하여 새로운 형태로 다시 구성하는 활동이다. 기존 기능과 운영 경험을 활용하면 모든 것을 처음부터 만드는 재개발보다 불확실성과 재작업을 줄일 수 있고, 기존 동작을 대조 자료로 삼아 빠뜨린 요구나 명세 문제를 찾는 데도 도움이 될 수 있다. 다만 이 효과는 기존 자산의 상태와 변경 범위에 달려 있어 비용·위험이 항상 감소한다고 보장할 수 없다. 개발 시간이 늘어난다는 사실 자체를 재공학의 장점으로 제시하는 것은 부적절하며, 선택 전에는 실제 비용과 효과를 비교해야 한다.
선지별 해설
- 기존 동작과 경험을 활용할 수 있는 경우 기대하는 이점이다.
- 기존 자산의 재사용이 가능한 경우 기대하는 이점이다.
- 기존 구현과 운영 결과를 대조하여 명세 문제를 찾을 수 있는 이점이다.
- 개발 시간의 증가 자체는 재공학을 선택하는 장점으로 보기 어렵다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Maintenance §4.1 Program Comprehension; §4.2 Software Reengineering; §4.3 Reverse Engineering
39. 알파, 베타 테스트와 가장 밀접한 연관이 있는 테스트 단계는?
- 단위 테스트
- 인수 테스트
- 통합 테스트
- 시스템 테스트
정답과 해설 보기
정답: 2
정답은 ②이다. 알파와 베타 시험은 실제 또는 잠재 사용자가 제품을 사용하며 요구와 기대에 맞는지 확인하는 인수 시험의 형태로 다룬다. 통상 알파 시험은 개발 조직의 환경에서, 베타 시험은 외부 사용자의 환경에서 수행하여 서로 다른 사용 경험과 피드백을 얻는다. 단위 시험은 개별 구성 요소, 통합 시험은 요소 사이의 상호작용, 시스템 시험은 완성된 시스템의 동작에 초점을 둔다. 실제 프로젝트에서는 활동이 겹칠 수 있지만 알파·베타라는 명칭의 주된 수용 판단 목적을 기준으로 답을 고른다.
선지별 해설
- 개별 구성 요소를 중심으로 시험하는 수준이다.
- 사용자 관점의 수용 여부를 확인하며 알파·베타 시험을 포함할 수 있다.
- 여러 구성 요소 사이의 인터페이스와 상호작용을 시험한다.
- 시스템 전체의 기능과 비기능 동작을 시험하는 수준이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §2.2.4 Acceptance Testing — alpha and beta testing
40. 이미지의 루트 트리에서 노드의 차수는 자식 수, 트리의 차수는 노드 차수의 최댓값으로 정의한다. 이 트리의 차수는?
[학습용 개정문항]
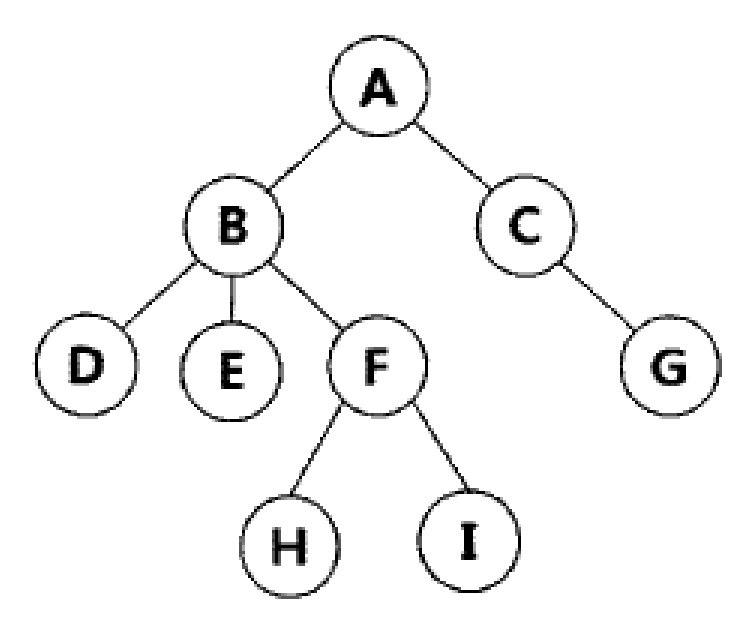
- 2
- 3
- 4
- 5
정답과 해설 보기
정답: 2
정답은 ②이다. 이 문항은 루트가 있는 트리에서 각 노드의 자식 수를 그 노드의 차수로 정의한다. A의 자식은 B와 C로 두 개이고, B의 자식은 D·E·F로 세 개이다. C의 자식은 G 하나이며 F의 자식은 H와 I로 두 개이다. 나머지 말단 노드는 자식이 없으므로 차수가 0이다. 따라서 최대 자식 수인 3이 트리의 차수이다. 무방향 그래프로 생각하여 B의 부모 A까지 연결된 간선을 모두 세면 4가 되지만, 이는 여기서 지정한 자식 수 기준과 다른 정의이다.
선지별 해설
- A나 F의 자식 수는 2지만 B에는 자식이 3개 있다.
- B의 자식 D·E·F가 세 개로 전체의 최댓값이다.
- 부모와 연결된 간선까지 포함한 B의 무방향 그래프 차수와 혼동한 값이다.
- 어느 노드도 자식을 다섯 개 갖고 있지 않다.
편집 해설 근거: NIST DADS, degree — Definition (3) — degree of a tree node
정보처리기사 필기 기출문제 · 데이터베이스 구축
41. 모든 비자명 함수 종속 X→Y에서 X가 슈퍼키여야 한다는 조건으로 정의되는 정규형은?
[학습용 개정문항]
- 제 1 정규형
- 제 2 정규형
- 보이스/코드 정규형
- 제 4 정규형
정답과 해설 보기
정답: 3
정답은 ③이다. BCNF는 릴레이션에서 성립하는 모든 비자명 함수 종속 X→Y에 대해 결정자 X가 슈퍼키여야 한다는 조건으로 정의한다. 슈퍼키는 전체 튜플을 식별할 수 있는 속성 집합이며 최소성을 만족하면 후보키가 된다. 따라서 모든 결정자를 반드시 최소인 후보키라고 표현하기보다 비자명 종속과 슈퍼키 조건을 명시하는 것이 정확하다. BCNF이면 하위 정규형도 만족하지만 질문은 이 정의에 직접 대응하는 이름을 묻는다. 제4정규형은 함수 종속만으로 다루지 못하는 다치 종속까지 고려하므로 같은 정의로 판단할 수 없다.
선지별 해설
- 속성의 원자적 도메인을 다루는 조건이며 제시 정의보다 약하다.
- 후보키 일부에 대한 비주요 속성의 부분 종속을 제거하는 단계이다.
- 모든 비자명 함수 종속의 결정자가 슈퍼키여야 한다는 정의에 해당한다.
- 비자명 다치 종속에 관한 추가 조건을 다루므로 제시 정의만으로 동일시할 수 없다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Chapter 19 저자 자료 — slides 9–11 — Normal Forms; Boyce-Codd Normal Form; Third Normal Form
42. 이미지의 관계형 데이터 모델에서 릴레이션·속성·튜플 수는?
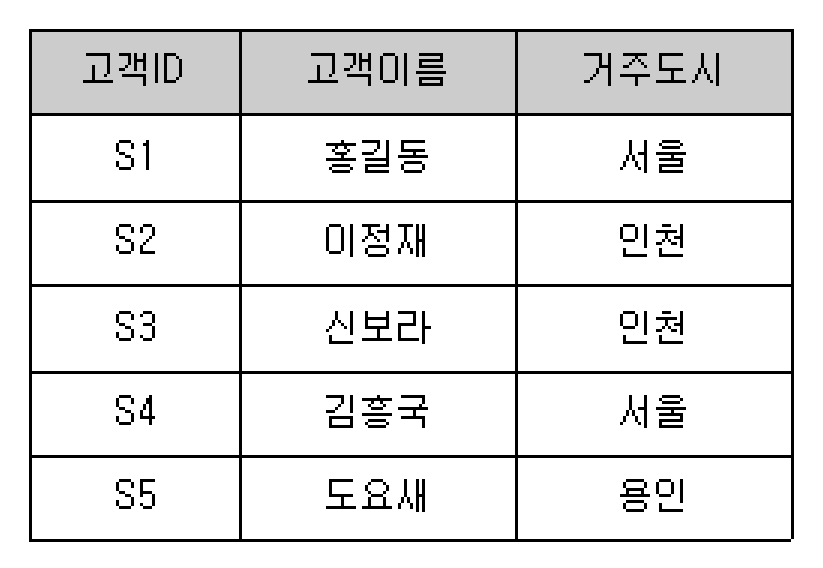
- relation 3개, attribute 3개, tuple 5개
- relation 3개, attribute 5개, tuple 3개
- relation 1개, attribute 5개, tuple 3개
- relation 1개, attribute 3개, tuple 5개
정답과 해설 보기
정답: 4
정답은 ④이다. 그림은 고객ID, 고객이름, 거주도시라는 세 속성으로 구성된 하나의 릴레이션 인스턴스이다. 열의 개수는 속성 수이므로 3이고, 제목 행 아래에 실제 고객 자료를 담은 행은 5개이므로 튜플 수는 5이다. 열 이름이 적힌 머리글은 스키마를 알려 주는 표시이며 자료 튜플로 세지 않는다. 릴레이션 수를 열 수와 혼동하거나 속성과 튜플을 바꾸어 세면 오답이 된다. 이 인스턴스에서 차수는 3, 카디널리티는 5라는 용어 대응도 함께 기억할 수 있다.
선지별 해설
- 하나의 표에 있는 세 열을 릴레이션 세 개로 잘못 센 것이다.
- 릴레이션 수를 잘못 세었고 열과 행의 개수도 뒤바뀌었다.
- 릴레이션은 한 개지만 속성 수와 튜플 수가 뒤바뀌었다.
- 하나의 릴레이션에 세 속성과 다섯 자료 튜플이 있다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — slides 3–4 — Relational Database: Definitions; Example Instance of Students Relation
43. 트랜잭션의 변경을 COMMIT으로 확정하거나 ROLLBACK으로 취소하여 전부 또는 전무의 반영을 구현하려는 성질은?
[학습용 개정문항]
- 병행성
- 보안성
- 원자성
- 로그
정답과 해설 보기
정답: 3
정답은 ③이다. 원자성은 하나의 트랜잭션에 속하는 작업들이 전부 반영되거나 전혀 반영되지 않은 것처럼 처리되는 성질이다. COMMIT은 성공한 트랜잭션의 변경을 확정하고 ROLLBACK은 아직 확정하지 않은 변경을 취소하는 제어 수단이다. 예를 들어 계좌 이체의 출금만 남고 입금은 빠지는 부분 반영을 막으려는 목적과 연결된다. 두 명령의 이름만 존재한다고 장애 상황까지 자동으로 보장되는 것은 아니며 DBMS의 기록과 복구 구현도 필요하다. 로그는 그 구현 수단 가운데 하나이고 병행성이나 보안성은 원자성의 명칭이 아니다.
선지별 해설
- 여러 작업이 겹쳐 실행되는 능력이나 제어와 관련된 개념이다.
- 접근 제어와 정보 보호 등에 관한 성질로 전부 또는 전무의 의미와 다르다.
- 트랜잭션 작업을 전부 반영하거나 전부 취소하는 성질이다.
- 작업과 변경을 기록하는 구현 수단으로 ACID 특성의 이름이 아니다.
편집 해설 근거: PostgreSQL 18, 3.4 Transactions — Transactions — all-or-nothing operation; BEGIN, COMMIT and ROLLBACK
44. R1의 다섯 행에서 학년 값이 1, 1, 2, 2, 3일 때 다음 SQL의 결과는? 행의 순서는 비교하지 않는다.
SELECT DISTINCT 학년 FROM R1;[학습용 개정문항]
- 학년 열에 1, 1, 2, 2, 3의 다섯 행
- 학년 열에 1, 2, 3이 각각 한 번씩 있는 세 행
- 이름과 학년 열에 원래 다섯 학생의 다섯 행
- 이름과 학년 열에 학년별 대표 학생 세 명의 세 행
정답과 해설 보기
정답: 2
정답은 ②이다. SELECT 목록에는 학년 하나만 있으므로 결과에도 학년 열만 포함된다. DISTINCT는 이 선택 결과에서 같은 학년 값이 여러 번 나타날 때 중복 행을 제거한다. 입력의 1, 1, 2, 2, 3을 서로 다른 값으로 정리하면 1, 2, 3의 세 행이 남는다. 학생 이름이 서로 다르더라도 이름을 조회하지 않았으므로 중복 제거 기준에 들어가지 않는다. 또한 ORDER BY가 없으므로 결과를 1부터 3까지 정렬해 반환한다고 보장하지 않으며, 여기서는 반환되는 값과 행 수만 비교한다.
선지별 해설
- DISTINCT로 제거해야 하는 학년의 중복을 그대로 남긴 결과이다.
- 학년만 조회하여 중복을 제거하면 값 1·2·3이 각각 한 번 남는다.
- SELECT 목록에 없는 이름 열을 추가했고 학년 중복도 남겼다.
- SELECT 목록에 없는 이름 열을 추가하고 학년별 대표 학생을 임의로 고른 결과이다.
편집 해설 근거: PostgreSQL 18 — SELECT — DISTINCT Clause; ORDER BY Clause
45. 다음 SQL 명령 중 트랜잭션의 확정·취소나 권한 부여가 아니라 데이터를 조회하는 명령은?
[학습용 개정문항]
- COMMIT
- ROLLBACK
- GRANT
- SELECT
정답과 해설 보기
정답: 4
정답은 ④이다. SELECT는 조회할 열과 조건 등을 지정하여 자료를 검색하는 명령이다. COMMIT은 현재 트랜잭션을 확정하고 ROLLBACK은 아직 확정하지 않은 변경을 취소하며, GRANT는 대상 객체 등에 대한 권한을 부여한다. 따라서 네 명령을 실제 기능으로 비교하면 자료 조회에 해당하는 SELECT를 구별할 수 있다. 교재에 따라 COMMIT과 ROLLBACK을 넓은 데이터 제어 범주에 넣기도 하지만 많은 분류에서는 트랜잭션 제어어인 TCL로 따로 다룬다. 분류 차이를 숨긴 채 셋을 모두 DCL이라고 단정하지 않는다.
선지별 해설
- 트랜잭션을 확정하는 명령이다.
- 확정 전 트랜잭션 변경을 취소하는 명령이다.
- 객체 등에 대한 권한을 부여하는 명령이다.
- 열과 조건을 지정하여 데이터를 조회하는 명령이다.
편집 해설 근거: PostgreSQL 18, 3.4 Transactions — Transactions — COMMIT and ROLLBACK; PostgreSQL 18, GRANT — Description; PostgreSQL 18 — SELECT — Description
46. 병행제어 기법 중 로킹에 대한 설명으로 옳지 않은 것은?
- 로킹의 대상이 되는 객체의 크기를 로킹 단위라고 한다.
- 데이터베이스, 파일, 레코드 등은 로킹 단위가 될 수 있다.
- 로킹의 단위가 작아지면 로킹 오버헤드가 증가한다.
- 로킹의 단위가 커지면 데이터베이스 공유도가 증가한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 로킹 단위는 하나의 잠금으로 보호하는 데이터 범위를 말하며 행·페이지·테이블처럼 여러 크기를 사용할 수 있다. 같은 작업 범위를 더 작은 단위로 잠그면 필요 없는 데이터까지 함께 막는 일이 줄어 다른 트랜잭션이 접근할 여지가 커진다. 대신 관리해야 할 잠금 수가 늘어 오버헤드가 커질 수 있다. 큰 단위로 잠그면 잠금 관리 수는 줄어들 수 있지만 충돌하는 접근을 더 넓게 제한하여 동시 접근 가능성을 낮출 수 있다. 실제 영향은 잠금 모드와 접근 패턴에도 달려 있으므로 단위 크기만으로 모든 성능을 단정하지 않는다.
선지별 해설
- 잠금이 보호하는 데이터 범위의 크기를 로킹 단위라고 한다.
- DBMS가 지원하는 모델에 따라 데이터베이스·파일·행 등 여러 수준을 사용할 수 있다.
- 같은 범위를 잘게 나누어 잠그면 관리할 잠금 수가 늘어날 수 있다.
- 큰 단위는 충돌하는 접근의 제한 범위를 넓혀 공유 가능성을 일반적으로 낮출 수 있다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Concurrency Control — slides 13–16 — Multiple-Granularity Locks; protocol and examples
47. 관계 데이터 모델에서 기본키를 구성하는 모든 속성에 NULL을 허용하지 않아 각 개체를 식별할 수 있게 하는 무결성 제약은?
[학습용 개정문항]
- 개체 무결성
- 참조 무결성
- 도메인 무결성
- 튜플의 유일성
정답과 해설 보기
정답: 1
정답은 ①이다. 개체 무결성은 각 튜플을 기본키로 분명하게 식별할 수 있어야 한다는 제약과 연결된다. 기본키를 구성하는 속성에는 NULL을 허용하지 않으며 기본키 값은 행을 유일하게 식별해야 한다. 복합 기본키에서도 각 구성 열에 NULL이 허용되는 것은 아니다. 참조 무결성은 외래키와 참조 대상의 관계, 도메인 무결성은 허용 값과 형식의 범위를 다룬다. 속성 값을 원자적으로 다룬다는 제1정규형의 조건은 기본키 NULL 금지와 별개의 개념이므로 한 문장으로 섞어서 정의하지 않는다.
선지별 해설
- 기본키를 통해 각 튜플을 식별하고 기본키 구성 속성의 NULL을 금지하는 제약이다.
- 외래키 값이 참조 대상과 일관되게 연결되도록 하는 제약이다.
- 속성 값이 허용된 자료형·범위·조건을 따르도록 하는 제약이다.
- 전체 튜플의 중복 여부에 관한 성질만으로 기본키의 NULL 금지를 설명하지 못한다.
편집 해설 근거: PostgreSQL 18 — Constraints — §5.5.4 Primary Keys; §5.5.5 Foreign Keys
48. PostgreSQL 18의 일반 뷰(CREATE VIEW)에 대한 설명으로 옳지 않은 것은? 물리화 뷰는 제외한다.
[학습용 개정문항]
- 뷰의 결과 데이터를 별도로 저장하고 그 데이터에 자체 인덱스를 만든다.
- 적절한 권한 설정과 함께 노출할 데이터를 제한하는 데 활용할 수 있다.
- 일정한 조회 인터페이스를 제공하여 기반 구조의 일부 변화를 감출 수 있다.
- 복잡한 조회 정의를 이름으로 재사용할 수 있다.
정답과 해설 보기
정답: 1
정답은 ①이다. PostgreSQL의 일반 뷰는 조회 정의를 보관하며 그 결과 행을 별도 물리 데이터로 저장하는 객체가 아니다. 따라서 일반 뷰 자체의 저장 데이터에 인덱스를 만든다는 설명은 맞지 않는다. 실제 조회에서는 기반 테이블의 인덱스를 이용할 수 있다. 뷰는 필요한 열과 행을 노출하고 복잡한 질의를 감추며 일정한 조회 인터페이스를 제공하는 데 활용할 수 있지만, 권한과 보안 조건을 제대로 설계해야 한다. 물리화 뷰나 일부 제품의 인덱스드 뷰는 별도의 기능이므로 일반 뷰의 설명과 구별한다.
선지별 해설
- 일반 뷰 자체에는 별도 결과 데이터와 그 데이터의 인덱스를 저장하지 않는다.
- 권한과 뷰 정의를 적절히 구성하면 노출할 자료를 제한할 수 있다.
- 기반 구조의 일부 변화를 감추고 일정한 조회 인터페이스를 제공하는 데 도움을 줄 수 있다.
- 복잡한 조회를 이름으로 재사용하여 사용자 관점의 접근을 단순화할 수 있다.
편집 해설 근거: PostgreSQL 18 — CREATE VIEW — Description; Notes — view definition and restricted access; PostgreSQL 18, CREATE INDEX — Description
49. Tanenbaum·van Steen의 분산 시스템 2판 저자 공개 해답(1장 4번)에 열거된 분산 투명성 유형의 명칭이 아닌 것은?
[학습용 개정문항]
- Location Transparency
- Replication Transparency
- Failure Transparency
- Media Access Transparency
정답과 해설 보기
정답: 4
정답은 ④이다. 분산 투명성은 자료나 기능이 여러 곳에 나뉘어 있다는 사실 가운데 일부를 사용자와 응용 프로그램이 직접 처리하지 않아도 되도록 감추는 성질이다. 위치 투명성은 어디에 있는지, 복제 투명성은 여러 복사본이 존재하는지에 대한 부담을 줄이며 장애 투명성은 일부 장애와 복구를 가능한 범위에서 감춘다. 기준 문서가 열거하는 접근 투명성과 Media Access Transparency라는 표현을 혼동하지 않아야 한다. 또한 모든 장애를 완전히 숨길 수 있다는 보장은 없고, 높은 투명성을 구현하는 데에는 응답 시간 등의 비용이 따를 수 있다.
선지별 해설
- 자료나 자원의 물리적 위치를 직접 의식하지 않게 하는 위치 투명성이다.
- 복사본의 존재와 관리를 사용자에게 감추려는 복제 투명성이다.
- 일부 장애와 복구를 감추려는 장애 투명성이다.
- 기준 목록의 접근 투명성과 다른 표현으로, 목록에 제시된 유형명이 아니다.
편집 해설 근거: Tanenbaum·van Steen, Distributed Systems 2판, 저자 공개 해답 Chapter 1 — Chapter 1, solutions 4–6 — distribution transparency, failure hiding and performance trade-off
50. 정규화의 목적으로 옳지 않은 것은?
[학습용 개정문항]
- 데이터 의미와 종속 관계에 맞추어 관계 구조를 정리한다.
- 불필요한 중복과 변경 시 여러 곳을 고쳐야 하는 부담을 줄인다.
- 삽입·삭제·갱신 이상이 더 많이 발생하도록 만든다.
- 분해할 때 원래 정보를 잃지 않는지 검토한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 정규화는 함수 종속 등 데이터의 의미와 제약을 분석하여 관계 구조를 적절히 분해함으로써 불필요한 중복과 변경 이상을 줄이려는 설계 과정이다. 예를 들어 같은 부서 정보를 여러 직원 행에 반복 저장하면 한 부서 정보를 바꿀 때 여러 행을 함께 고쳐야 하는 문제가 생길 수 있다. 분해할 때에는 원래 정보를 잃지 않고 다시 결합할 수 있는지 등을 검토해야 한다. 이상 현상을 더 많이 발생시키는 것이 목적은 아니며, 정규화만 수행하면 모든 조회가 빨라지거나 최적 검색 알고리즘이 자동 생성된다고 보장하지도 않는다.
선지별 해설
- 의미와 종속 관계에 맞추어 관계 구조를 정리하는 목적이다.
- 같은 사실을 여러 곳에서 따로 고쳐야 하는 부담을 줄이려는 목적이다.
- 삽입·삭제·갱신 이상을 늘리는 것은 정규화의 목적과 반대이다.
- 분해 후 원래 정보를 잃지 않도록 검토하는 것은 중요한 설계 조건이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Chapter 19 저자 자료 — slide 2 — The Evils of Redundancy; slide 9 — Normal Forms; Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — slides 7.8–7.10 — Lossless Decomposition; Normalization Theory
51. 이미지의 함수 종속에서 적용된 추론 규칙은?
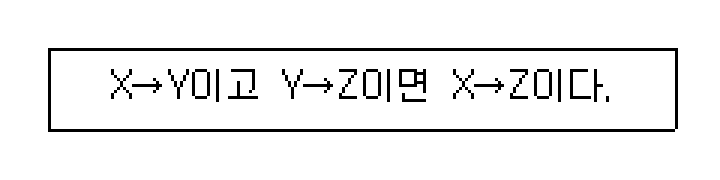
- 분해 규칙
- 이행 규칙
- 반사 규칙
- 결합 규칙
정답과 해설 보기
정답: 2
정답은 ②이다. 함수 종속 X→Y와 Y→Z가 성립하면 X가 같은 두 튜플은 먼저 Y가 같고, Y가 같으므로 다시 Z도 같게 된다. 따라서 X→Z를 추론할 수 있으며 이를 이행 규칙이라고 한다. X·Y·Z는 각각 하나의 속성뿐 아니라 속성 집합일 수도 있다. 분해는 X→YZ에서 X→Y 등을 얻는 규칙이고, 결합은 같은 결정자에 대한 종속들을 묶는 규칙이다. 반사는 Y가 X의 부분집합일 때 X→Y가 성립한다는 규칙이므로 중간 집합 Y를 거쳐 연결하는 이행과 구별한다.
선지별 해설
- 오른쪽의 속성 집합을 나누어 더 작은 종속을 얻는 규칙이다.
- X→Y와 Y→Z를 연결하여 X→Z를 얻는 이행 규칙이다.
- 결정자에 포함된 속성은 그 결정자로 정해진다는 부분집합 규칙이다.
- 같은 결정자의 여러 종속을 오른쪽 속성 집합의 합으로 묶는 규칙이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Chapter 19 저자 자료 — slides 6–7 — Reasoning About FDs; Armstrong’s Axioms; Union and Decomposition
52. 집합 의미의 릴레이션 R(D1,D2,D3)={(a,1,A),(b,1,A),(c,2,A),(d,2,B)}와 S(D2,D3)={(1,A)}가 있다. R÷S의 결과는?
[학습용 개정문항]
- D3 열에 A와 B
- D2 열에 2가 두 번 있는 결과
- D3 열에 A
- D1 열에 a와 b
정답과 해설 보기
정답: 4
정답은 ④이다. R÷S의 결과에는 R의 속성 가운데 S에 없는 D1만 남는다. 각 D1 값이 S의 모든 (D2,D3) 튜플과 결합한 행을 R에서 갖는지 확인한다. S에는 (1,A) 하나가 있으므로 (a,1,A)와 (b,1,A)를 가진 a와 b가 조건을 만족한다. c는 (2,A), d는 (2,B)만 있어서 필요한 (1,A) 조합이 없다. 따라서 결과는 D1 열의 a와 b이다. 나눗셈은 단순히 두 표의 같은 값을 제거하거나 공통 열만 출력하는 연산이 아니라 S의 모든 조건을 충족하는 나머지 속성 값을 찾는 연산이다.
선지별 해설
- 결과에 남는 속성은 D3가 아니라 S에 없는 D1이다.
- D2는 S에 포함된 속성이므로 결과 열이 아니며 값 2도 요구 조합을 만족하지 않는다.
- 공통 값 A를 뽑는 연산이 아니라 모든 S 조건을 만족하는 D1을 찾는다.
- a와 b는 모두 S의 (1,A)와 결합한 행을 R에 갖는다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — slides 13–15 — Division; Examples of Division; Expressing A/B Using Basic Operators
53. player 테이블에 player_name·team_id 문자 열과 height 숫자 열이 있다. 주석의 번호로 표시한 SQL에서 문법 오류가 있는 줄은?
/* (1) */ SELECT player_name, height
/* (2) */ FROM player
/* (3) */ WHERE team_id = 'Korea'
/* (4) */ AND height BETWEEN 170 OR 180;
[학습용 개정문항]
- (1)
- (2)
- (3)
- (4)
정답과 해설 보기
정답: 4
정답은 ④이다. BETWEEN으로 범위를 지정할 때에는 하한과 상한 사이에 AND를 써야 한다. 따라서 네 번째 줄의 170 OR 180을 170 AND 180으로 고쳐야 한다. 올바른 조건 height BETWEEN 170 AND 180은 height가 170 이상이면서 180 이하인 경우를 포함하며 두 경계값도 포함한다. SELECT의 열 목록, FROM의 테이블, WHERE의 문자값 비교는 질문에서 선언한 스키마를 전제로 맞는 형태이다. 네 번째 줄 맨 앞의 AND는 국가 조건과 키 조건을 결합하는 논리 연산자이고 BETWEEN 안의 AND는 범위 문법의 일부라는 점도 구별한다.
선지별 해설
- 쉼표로 조회할 두 열을 나열하는 구문은 유효하다.
- 선언된 player 테이블을 조회 대상으로 지정한 구문은 유효하다.
- 문자열을 작은따옴표로 감싸 team_id와 비교하는 조건은 유효하다.
- BETWEEN의 두 경계 사이에는 OR가 아니라 AND가 필요하다.
편집 해설 근거: PostgreSQL 18, Comparison Functions and Operators — Table 9.2 Comparison Predicates; BETWEEN equivalence
54. 데이터베이스 로그(log)를 필요로 하는 회복 기법은?
- 즉각 갱신 기법
- 대수적 코딩 방법
- 타임 스탬프 기법
- 폴딩 기법
정답과 해설 보기
정답: 1
정답은 ①이다. 로그를 이용하는 즉시 갱신 방식은 트랜잭션이 확정되기 전에도 데이터 변경을 버퍼나 저장소에 반영할 수 있다. 이후 취소나 장애가 발생하면 미확정 변경을 되돌릴 정보가 필요하고, 확정했지만 아직 저장소에 완전히 반영되지 않은 변경은 다시 적용할 수 있어야 한다. 전형적인 로그에는 변경 전후 값과 시작·확정 상태 등을 기록하며 데이터 변경에 앞서 필요한 로그를 안전하게 보관하는 규칙을 적용한다. 지연 갱신 방식도 로그를 사용할 수 있으므로 즉시 갱신만이 로그를 쓰는 유일한 방법이라고 외워서는 안 된다.
선지별 해설
- 확정 전 변경을 허용하므로 로그로 취소·재적용을 수행하는 대표적 회복 방식이다.
- 변경 이력과 트랜잭션 상태를 사용하는 즉시 갱신 회복의 명칭과 다르다.
- 주로 트랜잭션 순서를 이용하는 동시성 제어와 관련된 기법이다.
- 제시한 로그 기반 트랜잭션 회복 방식의 명칭이 아니다.
편집 해설 근거: Silberschatz, Korth, Sudarshan, Database System Concepts 7th ed., Chapter 19 Recovery System — slides 19.12–19.18 — Log-Based Recovery; Immediate Database Modification; Undo and Redo Operations
55. DML(Data Manipulation Language) 명령어가 아닌 것은?
- INSERT
- UPDATE
- ALTER
- DELETE
정답과 해설 보기
정답: 3
정답은 ③이다. INSERT는 행을 추가하고 UPDATE는 기존 행의 값을 바꾸며 DELETE는 조건에 맞는 행을 제거하는 데이터 조작 명령이다. ALTER는 일반적으로 ALTER TABLE처럼 사용하여 열이나 제약 등 객체의 정의를 변경하는 데이터 정의 명령이다. 예를 들어 고객 주소 값을 바꾸는 것은 UPDATE이고 주소 열의 자료형이나 제약을 바꾸는 것은 ALTER TABLE에 해당한다. 두 작업이 모두 일상어로는 변경이라고 불리더라도 저장된 행의 내용과 스키마 정의 중 무엇을 바꾸는지를 기준으로 구별해야 한다.
선지별 해설
- 테이블에 새 행을 추가하는 데이터 조작 명령이다.
- 기존 행의 열 값을 바꾸는 데이터 조작 명령이다.
- 객체의 구조나 정의를 변경하는 데이터 정의 명령 계열이다.
- 조건에 맞는 행을 제거하는 데이터 조작 명령이다.
편집 해설 근거: PostgreSQL 18 — Data Manipulation — Chapter 6 — Inserting Data; Updating Data; Deleting Data; PostgreSQL 18, ALTER TABLE — Description
56. 도시 열은 도시 하나를 원자적 값으로 다루기로 한다. 이미지처럼 여러 도시를 한 셀에 묶은 표를 도시별 한 행으로 바꾼 것은 어떤 정규형의 조건을 직접 맞추는 작업인가?
[학습용 개정문항]
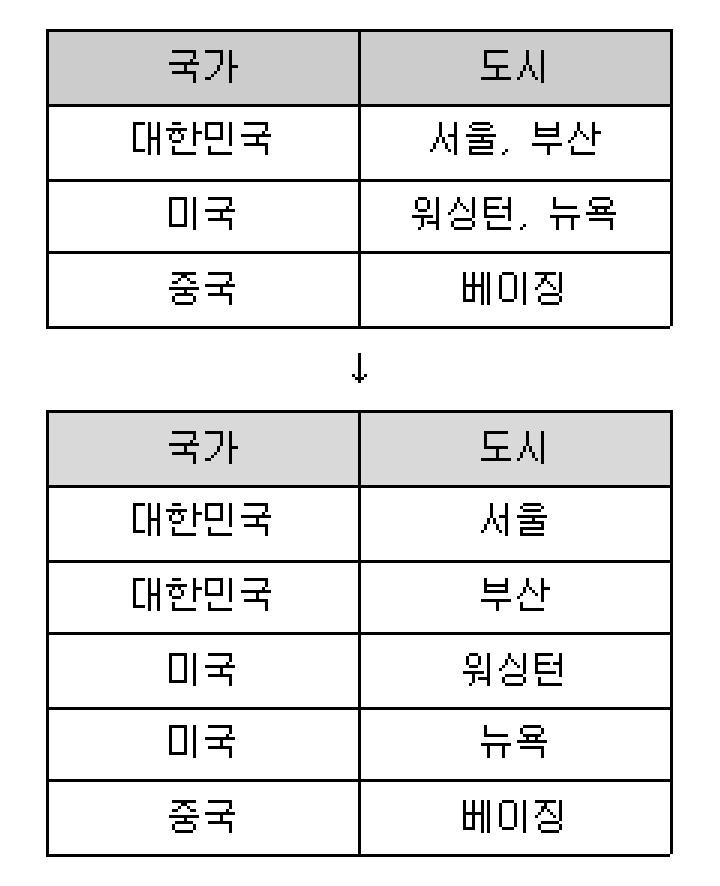
- 제1정규형
- 제2정규형
- 제3정규형
- 제4정규형
정답과 해설 보기
정답: 1
정답은 ①이다. 도시 열의 값은 하나의 도시로 다루기로 했는데 위 표는 대한민국의 서울·부산이나 미국의 워싱턴·뉴욕을 한 셀에 묶어 두었다. 아래 표는 각 나라와 도시의 조합을 한 행씩 나타내어 도시 도메인을 원자적인 값으로 다룬다. 이런 변화는 제1정규형의 원자적 도메인 조건과 직접 연결된다. 국가 이름이 여러 행에 반복된다는 사실만으로 정규화가 잘못되었다고 판단하지 않으며, 제2·제3·제4정규형 여부는 키와 함수·다치 종속 같은 추가 조건이 있어야 판단할 수 있다. 원자성은 현재 자료를 어떻게 사용할지 정한 도메인에 따른다.
선지별 해설
- 여러 도시를 묶은 값을 도시 하나씩으로 나누어 원자적 도메인 조건을 맞춘 변화이다.
- 부분 함수 종속을 제거했는지는 키와 종속 조건 없이 판단할 수 없다.
- 이행 함수 종속을 제거했다는 근거가 제시되지 않았다.
- 비자명 다치 종속을 별도 관계로 분해하는 조건이 제시되지 않았다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — slides 7.100–7.101 — First Normal Form; atomicity of domains
57. 관계대수에서 두 릴레이션의 각 튜플을 서로 가능한 모든 조합으로 결합하는 연산자는?
[학습용 개정문항]
- Select
- Cartesian Product
- Division
- Project
정답과 해설 보기
정답: 2
정답은 ②이다. 카티션 곱은 첫 릴레이션의 각 튜플을 두 번째 릴레이션의 모든 튜플과 결합한 결과이다. 두 관계에 각각 m개와 n개의 튜플이 있으면 모든 조합은 m×n개이다. 선택은 조건에 맞는 행을 남기고, 투영은 지정한 속성을 남기며, 나눗셈은 제수 관계의 모든 조건에 대응하는 나머지 속성 값을 찾는다. 이 연산들은 모두 관계대수에 포함되므로 카티션 곱이 관계대수가 아니라는 식으로 오해해서는 안 된다. 집합 연산 계열과 순수 관계 연산을 나누는 교재 분류보다 실제 연산 의미로 구별한다.
선지별 해설
- 조건을 만족하는 행을 선택하는 연산이다.
- 두 릴레이션의 모든 튜플 조합을 만드는 연산이다.
- 제수 관계의 모든 튜플과 대응하는 나머지 속성 값을 구하는 연산이다.
- 지정된 속성만 남기는 연산으로 모든 행 조합을 만들지 않는다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — slides 6–9 — Relational Algebra; Projection; Selection; Cross-Product
58. 다음 중 SQL의 집계 함수(aggregation function)가 아닌 것은?
- AVG
- COUNT
- SUM
- CREATE
정답과 해설 보기
정답: 4
정답은 ④이다. 집계 함수는 여러 입력 행의 값을 요약하여 평균·개수·합계 같은 결과를 계산한다. AVG는 평균, COUNT는 개수, SUM은 합계를 구하는 대표적인 집계 함수이다. CREATE는 CREATE TABLE이나 CREATE VIEW처럼 데이터베이스 객체를 정의하는 명령의 키워드이며 여러 행을 요약하는 함수가 아니다. 집계 대상의 자료형과 NULL 처리도 결과에 영향을 준다. 특히 COUNT(*)는 행 수를 세고 COUNT(열)은 해당 열이 NULL이 아닌 행을 세므로 둘을 무조건 같은 값이라고 생각하면 안 된다.
선지별 해설
- 입력값의 평균을 구하는 집계 함수이다.
- 행 수 또는 NULL이 아닌 입력값의 수를 세는 집계 함수이다.
- 입력값의 합계를 구하는 집계 함수이다.
- 데이터베이스 객체를 생성하는 명령의 키워드로 집계 함수가 아니다.
편집 해설 근거: PostgreSQL 18 — Aggregate Functions tutorial — §2.7 Aggregate Functions; PostgreSQL 18, Aggregate Functions — Table 9.62 General-Purpose Aggregate Functions — count, avg and sum
59. 릴레이션 조작 시 데이터들이 불필요하게 중복되어 예기치 않게 발생하는 곤란한 현상을 의미하는 것은?
- normalization
- rollback
- cardinality
- anomaly
정답과 해설 보기
정답: 4
정답은 ④이다. 변경 이상은 불필요한 중복이나 부적절한 관계 구조 때문에 삽입·삭제·갱신 과정에서 의도하지 않은 제약이나 정보 손실, 불일치가 생기는 현상이다. 예를 들어 부서 주소가 직원마다 반복되어 있을 때 한 행만 바꾸면 같은 부서의 주소가 서로 달라질 수 있다. 마지막 직원을 삭제하면서 부서 자체의 정보도 사라지는 경우는 삭제 이상으로 볼 수 있다. 정규화는 이런 문제를 줄이기 위한 설계 과정이고, 롤백은 트랜잭션을 취소하는 동작이며, 카디널리티는 릴레이션의 튜플 수를 가리키므로 현상의 이름과 다르다.
선지별 해설
- 이상 현상을 줄이도록 관계 구조를 정리하는 과정이다.
- 트랜잭션의 미확정 변경을 취소하는 동작이다.
- 릴레이션 인스턴스에 포함된 튜플 수이다.
- 삽입·삭제·갱신 과정에서 발생하는 변경 이상을 뜻한다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Chapter 19 저자 자료 — slide 2 — The Evils of Redundancy
60. 제1정규형을 전제로 하는 고전적인 관계 모델의 릴레이션 인스턴스에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 튜플들의 삽입, 삭제 등의 작업으로 인해 릴레이션은 시간에 따라 변한다.
- 한 릴레이션에 포함된 튜플들은 모두 상이하다.
- 애트리뷰트는 논리적으로 쪼갤 수 없는 원자값으로 저장한다.
- 한 릴레이션에 포함된 튜플 사이에는 순서가 있다.
정답과 해설 보기
정답: 4
정답은 ④이다. 고전적인 관계 모델의 릴레이션 인스턴스는 튜플의 집합이므로 튜플 사이에 본질적인 순서가 없고 같은 튜플을 중복 원소로 세지 않는다. 삽입이나 삭제가 일어나면 현재 인스턴스는 바뀔 수 있다. 제1정규형을 전제로 각 속성은 지정된 도메인에서 하나의 원자적인 값으로 다룬다. 실제 SQL의 테이블이나 SELECT 결과는 설정과 질의에 따라 중복을 허용할 수 있으며, 화면에 어떤 순서로 보였다는 이유만으로 그 순서가 보장되지는 않는다. 순서가 필요한 SQL 결과에는 ORDER BY를 명시해야 한다.
선지별 해설
- 삽입·삭제 등으로 현재의 튜플 집합이 바뀔 수 있다.
- 집합 의미의 릴레이션에는 같은 튜플이 중복 원소로 들어가지 않는다.
- 제1정규형에서는 각 속성 도메인을 원자적인 단위로 다룬다.
- 튜플 집합 자체에는 고유한 선후 순서가 없다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — slide 3 — Relational Database: Definitions; Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — slides 7.100–7.101 — First Normal Form; PostgreSQL 18 — SELECT — ORDER BY Clause; Description step 8
정보처리기사 필기 기출문제 · 프로그래밍 언어 활용
61. i와 j는 이미 초기화된 Java int 변수이며 같은 값일 수도 있다. 모든 i와 j에 대해 다음 if 문과 같은 k를 만드는 식은?
int k;
if (i > j) {
    k = i - j;
} else {
    k = i + j;
}
[학습용 개정문항]
k = (i > j) ? (i - j) : (i + j);k = (i < j) ? (i - j) : (i + j);k = (i > j) ? (i + j) : (i - j);k = (i < j) ? (i + j) : (i - j);
정답과 해설 보기
정답: 1
정답은 ①이다. 조건 연산자는 조건이 참이면 물음표 뒤의 첫 식을, 거짓이면 콜론 뒤의 식을 선택한다. 제시한 if 문은 i가 j보다 클 때 차를, 그렇지 않을 때 합을 k에 저장하므로 같은 조건과 두 식의 순서를 그대로 유지한 ①이 동등하다. ④는 서로 다른 두 값에 대해서는 같은 결과를 낼 수 있지만 i=j=5이면 원래 코드는 10, ④는 0을 만든다. 기존의 i=7, j=9만 고정하면 ①과 ④가 모두 16이 되어 답을 하나로 정할 수 없으므로, 개정 문항은 같은 값도 포함한 모든 int 입력에서의 동등성을 묻는다.
선지별 해설
- 조건과 참·거짓일 때의 계산이 원래 if 문과 각각 일치한다.
- i=7, j=9이면 차를 선택하여 -2가 되어 원래 결과 16과 다르다.
- i=7, j=9이면 거짓 분기에서 차를 선택하여 -2가 된다.
- i=j=5이면 차 0을 선택하지만 원래 if 문은 합 10을 선택한다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 15 Expressions — §15.25 Conditional Operator; §15.25.2 Numeric Conditional Expressions
62. 입력 길이가 대상 버퍼보다 큰지 검사하지 않고 데이터를 복사하여 버퍼 경계를 넘어 메모리를 덮어쓰는 취약점은?
[학습용 개정문항]
- FTP 바운스 공격
- SQL 삽입
- 버퍼 오버플로
- 디렉토리 접근 공격
정답과 해설 보기
정답: 3
정답은 ③이다. 입력의 크기를 확인하지 않고 고정 크기 버퍼에 복사하면 준비된 저장 공간의 경계를 넘어 다른 메모리를 덮어쓸 수 있다. 이는 전형적인 버퍼 오버플로 취약점이며 프로그램 중단이나 데이터 손상, 조건에 따라 제어 흐름 변조로 이어질 수 있다. 단순히 메모리 처리에 오류가 있다는 설명만으로는 해제 후 사용이나 잘못된 포인터 등 여러 문제를 구별할 수 없으므로 복사 길이와 버퍼 경계를 명시해야 한다. FTP 바운스, SQL 삽입, 경로 접근 문제는 각각 통신 기능·질의 구성·파일 접근 범위를 악용하는 다른 유형이다.
선지별 해설
- FTP 서버의 연결 기능을 악용하는 유형으로 버퍼 복사 경계 문제와 다르다.
- 입력이 SQL 구문으로 해석되도록 하는 질의 구성 취약점이다.
- 복사 대상 버퍼의 경계를 넘어 쓰는 전형적인 메모리 취약점이다.
- 허용되지 않은 경로에 접근하는 문제로 복사 길이 검사의 누락과 구별한다.
편집 해설 근거: MITRE CWE-120 — Buffer Copy without Checking Size of Input — Description; Demonstrative Examples 1–3
63. 다음 중 bash 쉘 스크립트에서 사용할 수 있는 제어문이 아닌 것은?
- if
- for
- repeat_do
- while
정답과 해설 보기
정답: 3
정답은 ③이다. Bash는 if로 조건에 따라 실행 경로를 선택하고 for·while·until 등으로 명령을 반복하는 문법을 제공한다. while은 조건 명령이 성공하는 동안 본문을 반복하며, 목록을 순회하는 for는 각 항목을 변수에 대입하여 본문을 실행한다. repeat_do는 Bash가 기본 제어문으로 정의한 예약어가 아니다. 사용자가 같은 이름의 함수나 외부 명령을 만들 수는 있지만 그것이 Bash 문법의 제어문이 되는 것은 아니다. 다른 셸이나 의사코드에서 본 반복 표현을 Bash의 내장 문법과 혼동하지 않도록 한다.
선지별 해설
- 조건 명령의 종료 상태에 따라 분기하는 Bash 문법이다.
- 목록 또는 산술 조건을 이용하는 Bash 반복 문법이다.
- Bash에 기본 제공되는 제어문 예약어가 아니다.
- 조건 명령이 성공하는 동안 실행하는 Bash 반복 문법이다.
편집 해설 근거: GNU Bash Reference Manual, Edition 5.3 (2025) — §3.2.1 Reserved Words; §3.2.5.1 Looping Constructs; §3.2.5.2 Conditional Constructs
64. IPv6에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 32비트의 주소 체계를 사용한다.
- 기본 헤더에 Traffic Class와 Flow Label 필드가 있다.
- 확장 헤더를 기본 헤더와 상위 프로토콜 사이에 둘 수 있다.
- 조건에 따라 SLAAC 방식으로 호스트 주소를 자동 구성할 수 있다.
정답과 해설 보기
정답: 1
정답은 ①이다. IPv6의 출발지와 목적지 주소는 각각 128비트이며 32비트는 IPv4 주소의 길이이다. IPv6 기본 헤더에는 Traffic Class와 Flow Label 등 흐름을 구별하는 필드가 있고 기본 헤더 뒤에 확장 헤더를 연결할 수 있다. 호스트는 조건에 따라 라우터의 광고 정보와 로컬 정보를 이용하는 SLAAC 등으로 주소를 자동 구성할 수 있다. 이런 기능이 존재한다고 모든 네트워크 설정이 저절로 끝나거나 실시간 전달과 보안이 자동 보장되는 것은 아니다. 보안 정책과 실제 네트워크 운용 조건은 별도로 설계해야 한다.
선지별 해설
- IPv6 주소는 32비트가 아니라 128비트이다.
- Traffic Class와 Flow Label은 IPv6 기본 헤더에 포함된다.
- Next Header 정보를 이용해 확장 헤더와 상위 프로토콜을 연결할 수 있다.
- 적절한 조건에서 SLAAC 등으로 호스트 주소를 자동 구성할 수 있다.
편집 해설 근거: IETF RFC 8200, Internet Protocol Version 6 Specification (2017) — §3 IPv6 Header Format; §4 IPv6 Extension Headers; IETF RFC 4862, IPv6 Stateless Address Autoconfiguration — §1 Introduction; §4 Protocol Overview
65. 효과적인 모듈 설계를 위한 유의사항으로 거리가 먼 것은?
[학습용 개정문항]
- 모듈 사이의 불필요한 결합을 줄인다.
- 불필요한 복잡성과 중복을 줄이고 일관성을 유지한다.
- 책임이 서로 달라도 모든 기능을 하나의 거대한 모듈로 묶어야 한다.
- 변경 영향을 파악하고 유지보수하기 쉬운 구조를 고려한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 모듈은 관련된 책임을 모아 이해하기 쉽게 만들고 외부와의 불필요한 의존을 줄이도록 설계하는 것이 일반적이다. 적절한 인터페이스와 일관된 규칙은 동작을 예측하고 변경 영향을 파악하는 데 도움이 된다. 서로 다른 모든 기능을 하나의 거대한 모듈로 묶으면 변경 이유와 의존 관계가 뒤섞여 이해·시험·수정이 어려워질 수 있다. 그렇다고 모듈을 무조건 잘게 나눌수록 좋다는 뜻은 아니며, 응집도와 결합도, 실행 비용, 실제 업무 경계를 함께 고려하여 적절한 책임 범위를 정해야 한다.
선지별 해설
- 불필요한 외부 의존을 줄이면 모듈을 독립적으로 이해하고 변경하기 쉬워진다.
- 불필요한 복잡성과 중복을 줄이고 일관된 규칙을 유지하는 방향이다.
- 무관한 책임까지 한 모듈로 집중시키면 이해와 변경이 어려워질 수 있다.
- 변경 요구에 대응하기 쉬운 구조를 고려하는 것은 적절하다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Modularity; Separation of concerns; Coupling and cohesion
66. 이미지의 현재 대기시간과 서비스시간을 고정하여 HRN 응답비 (대기시간+서비스시간)/서비스시간을 한 번 계산한다. 그 비율이 큰 순서로 나열한 것은? 실제 실행 중 대기시간 재계산은 하지 않는다.
[학습용 개정문항]
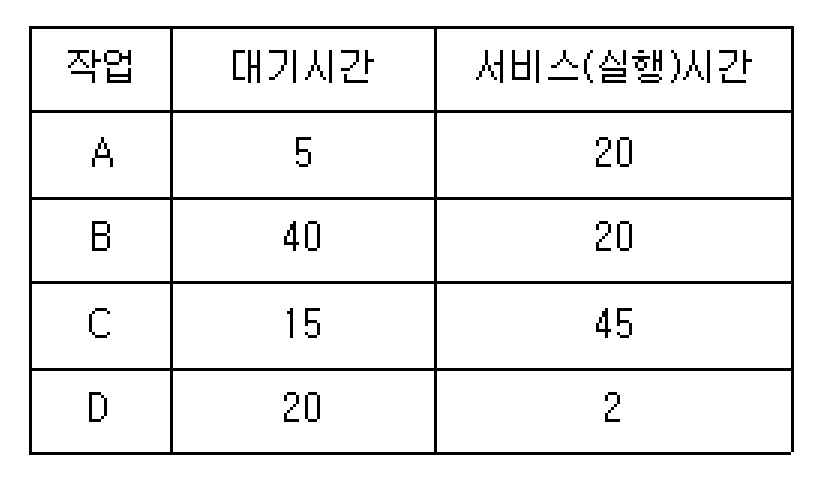
- A→B→C→D
- A→C→B→D
- D→B→C→A
- D→A→B→C
정답과 해설 보기
정답: 3
정답은 ③이다. HRN 또는 HRRN의 응답비는 (대기시간+서비스시간)/서비스시간이다. 표의 현재 값을 고정하여 계산하면 A는 25/20=1.25, B는 60/20=3, C는 60/45=4/3, D는 22/2=11이다. 따라서 지금의 응답비를 큰 순서로 정렬하면 D, B, C, A가 된다. 실제 비선점 HRRN에서는 한 작업을 끝낸 뒤 남은 작업의 대기시간을 늘려 다시 계산하므로 이 정렬을 전체 실행 순서라고 부르면 안 된다. 추가 도착이 없다면 이 표에서 동적으로 재계산한 실행 순서는 D, B, A, C가 되어 구별이 필요하다.
선지별 해설
- 가장 큰 응답비 11을 가진 D가 맨 뒤에 있어 현재 우선순위 순서가 아니다.
- D가 가장 크고 B는 C보다 크므로 두 비교 모두 맞지 않는다.
- 현재 응답비 11, 3, 4/3, 1.25의 내림차순이다.
- 현재 A의 응답비 1.25는 B와 C보다 작다.
편집 해설 근거: Virginia Tech CS3204, Scheduling Analysis (2005) — slide 13 — Highest Response Ratio Next (HRRN)
67. 운영체제에 대한 설명으로 거리가 먼 것은?
- 다중 사용자와 다중 응용프로그램 환경하에서 자원의 현재 상태를 파악하고 자원 분배를 위한 스케줄링을 담당한다.
- CPU, 메모리 공간, 기억 장치, 입출력 장치 등의 자원을 관리한다.
- 운영체제의 종류로는 매크로 프로세서, 어셈블러, 컴파일러 등이 있다.
- 입출력 장치와 사용자 프로그램을 제어한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 운영체제는 프로그램이 CPU와 메모리, 저장장치, 입출력 장치 같은 자원을 사용하도록 관리하고 필요한 추상화와 제어를 제공한다. 여러 작업이 실행되는 환경에서는 CPU 사용 기회를 나누고 보호와 입출력 등을 조정한다. 매크로 프로세서·어셈블러·컴파일러는 프로그램 표현을 확장하거나 다른 형식으로 번역하는 시스템 소프트웨어에 해당할 수 있지만 그 자체가 운영체제의 종류는 아니다. 운영체제와 함께 제공되거나 그 위에서 실행된다는 사실을 운영체제 자체라는 분류와 혼동하면 안 된다.
선지별 해설
- 지원되는 다중 작업 환경에서 자원 상태와 실행 순서를 관리하는 운영체제의 역할이다.
- CPU·메모리·저장장치·입출력 자원을 관리하는 역할이다.
- 프로그램 처리·번역 도구를 운영체제 종류로 잘못 분류했다.
- 장치와 응용 프로그램의 실행을 제어하는 역할과 관련된다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 2 Introduction to Operating Systems — Chapter 2 — Virtualizing the CPU; Virtualizing Memory; Concurrency; Persistence; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.681 compiler
68. 배치 작업의 품질 요구를 설명한 것으로 옳지 않은 것은?
[학습용 개정문항]
- 자동화: 정의된 정상 처리 절차를 반복적인 사용자 입력 없이 수행한다.
- 추적성: 오류 내용과 발생 시점 등 실행 기록을 확인할 수 있게 한다.
- 처리 능력: 예상한 규모의 데이터를 처리할 수 있어야 한다.
- 데이터 무결성: 주어진 시간 안에 끝나고 다른 프로그램을 방해하지 않는 것만을 뜻한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 배치 작업에서는 정해진 절차의 자동 실행, 오류와 실행 시점의 기록, 예상 데이터량을 감당할 처리 능력 등을 요구할 수 있다. 주어진 기한 안에 끝나는지는 성능과 시간 제약에 관한 문제이고, 다른 프로그램에 미치는 영향을 관리하는 것은 자원 사용과 공존성의 문제이다. 데이터 무결성은 정보가 부적절하게 변조되거나 훼손되지 않고 요구한 정확성과 제약을 유지하도록 하는 성질이므로 완료 시간만으로 정의할 수 없다. 빠르게 끝난 작업이라도 누락·중복·잘못된 수정이 있다면 결과의 무결성을 별도로 검증해야 한다.
선지별 해설
- 미리 정의된 정상 절차를 사용자의 반복 입력 없이 수행하도록 하는 요구이다.
- 실행과 오류 정보를 기록하여 문제 원인을 추적하도록 하는 요구이다.
- 예상한 데이터량을 처리할 수 있는 용량과 처리 능력에 관한 요구이다.
- 기한 내 종료와 자원 간섭만으로 데이터 무결성을 정의한 것은 잘못이다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.2035 integrity; PostgreSQL 18, 3.4 Transactions — Transactions — all-or-nothing operation
69. TCP 프로토콜에 대한 설명으로 거리가 먼 것은?
- 신뢰성이 있는 연결 지향형 전달 서비스이다.
- 기본 헤더 크기는 100byte이고 160byte까지 확장 가능하다.
- 스트림 전송 기능을 제공한다.
- 순서제어, 오류제어, 흐름제어 기능을 제공한다.
정답과 해설 보기
정답: 2
정답은 ②이다. TCP는 연결을 바탕으로 신뢰성 있는 바이트 스트림을 전달하는 전송 계층 프로토콜이다. 순서 번호와 확인 응답, 재전송, 수신 윈도우 등을 이용해 순서와 손실·흐름을 관리한다. 기본 헤더는 20바이트이고 옵션과 패딩을 포함한 일반 TCP 헤더의 최대 길이는 60바이트이다. 헤더의 Data Offset은 4비트이며 길이를 32비트 단위로 나타내므로 기본값 5는 20바이트, 최대값 15는 60바이트에 해당한다. 신뢰성이 있다는 것이 암호화나 모든 상황에서의 전달 성공까지 보장한다는 의미는 아니다.
선지별 해설
- 연결을 설정하여 신뢰성 있는 전송을 제공하는 성격이다.
- 100~160바이트가 아니라 기본 20바이트, 옵션 포함 일반 최대 60바이트이다.
- 응용 프로그램에 순서 있는 바이트 스트림을 제공한다.
- 순서 번호·확인 응답·재전송·윈도우 등을 이용하는 제어 기능을 제공한다.
편집 해설 근거: IETF RFC 9293, Transmission Control Protocol (2022) — §2.2 Key TCP Concepts; §3.1 Header Format — Data Offset and Options
70. 이미지의 설명에 해당하는 응집도는?
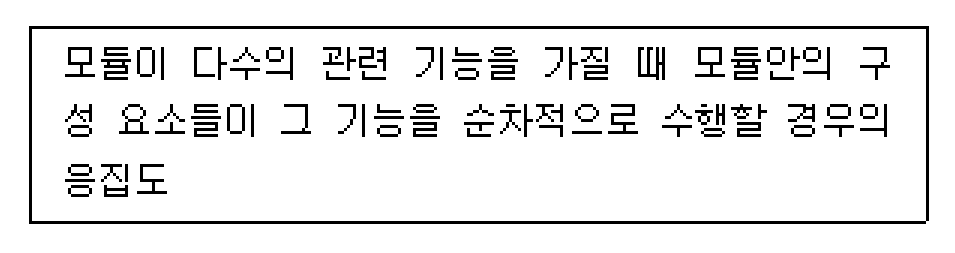
- 기능적 응집도
- 우연적 응집도
- 논리적 응집도
- 절차적 응집도
정답과 해설 보기
정답: 4
정답은 ④이다. 절차적 응집도는 여러 처리 요소가 정해진 실행 순서를 따른다는 이유로 한 모듈에 모여 있는 경우이다. 예를 들어 서로 다른 작업이라도 같은 절차에서 차례로 수행하도록 묶을 수 있다. 이때 앞 작업의 출력이 반드시 다음 작업의 입력이 될 필요는 없다. 그런 자료 전달 관계로 밀접하게 연결된다면 순차적 응집도와 구별해 검토해야 한다. 하나의 명확한 기능을 완성하는 기능적 응집도나 우연히 모아 둔 우연적 응집도와도 다르므로 그림의 순서라는 단서를 실행 절차의 관계로 읽는 것이 핵심이다.
선지별 해설
- 요소들이 하나의 명확한 기능을 함께 완성하는 관계이다.
- 의미 있는 관련성 없이 요소를 모아 둔 경우이다.
- 비슷한 종류의 기능을 묶는 관점으로 실행 순서의 관련성과 다르다.
- 정해진 실행 절차에 따라 차례로 수행되는 요소들을 묶은 경우이다.
편집 해설 근거: Lethbridge·Laganière, Object-Oriented Software Engineering, Chapter 9 (2001), 저자 강의 자료 — slide 22 — Procedural Cohesion; slides 17 and 21 — Functional and Sequential Cohesion
71. OSI-7Layer에서 링크의 설정과 유지 및 종료를 담당하며, 노드간의 오류제어와 흐름제어 기능을 수행하는 계층은?
- 데이터링크 계층
- 물리 계층
- 세션 계층
- 응용 계층
정답과 해설 보기
정답: 1
정답은 ①이다. OSI 참조 모델에서 데이터링크 계층은 물리 계층이 제공하는 전송을 이용하여 인접한 노드 사이의 데이터링크 연결과 프레임 전달을 다룬다. 연결의 설정·유지·해제와 오류 검출·복구, 흐름 제어 등의 기능이 이 계층의 설명에 포함된다. 물리 계층은 비트와 신호 전송을, 세션 계층은 상위 응용 사이의 대화와 동기화를 다루므로 링크의 직접적인 제어와 구별한다. 실제 모든 데이터링크 프로토콜이 같은 방식의 재전송이나 흐름 제어를 반드시 구현하는 것은 아니며, 문항은 참조 모델의 기능 분담을 묻는다.
선지별 해설
- 인접 노드 간 링크 연결과 프레임 전달을 제어하는 계층이다.
- 물리 매체를 통한 비트·신호 전송을 다루는 계층이다.
- 상위 응용 사이의 대화와 동기화 등을 다루는 계층이다.
- 응용 프로세스에 필요한 통신 기능을 제공하는 최상위 계층이다.
편집 해설 근거: ITU-T X.200 (07/1994), OSI Basic Reference Model — §7.6 Data Link Layer; §7.7 Physical Layer; §7.3 Session Layer
72. 다음 중 가장 결합도가 강한 것은?
- data coupling
- stamp coupling
- common coupling
- control coupling
정답과 해설 보기
정답: 3
정답은 ③이다. 전통적인 결합도 분류에서 제시한 네 종류를 낮은 쪽부터 비교하면 자료, 스탬프, 제어, 공통 결합 순으로 본다. 자료 결합은 필요한 값을 인자로 전달하고, 스탬프 결합은 공통 자료구조의 형태에 의존하며, 제어 결합은 다른 모듈의 행동을 지정하는 값에 의존한다. 공통 결합은 여러 모듈이 전역 자료를 공유하여 누가 값을 바꾸었는지와 어떤 영향이 퍼지는지를 함께 고려해야 하므로 보기 중 강한 결합으로 분류된다. 이 순서는 전통적인 구조 설계의 판단 기준이며 모든 프로그램의 성능이나 결함 수를 절대적으로 예측하는 척도는 아니다.
선지별 해설
- 필요한 자료 값을 인자로 주고받는 비교적 낮은 결합이다.
- 공유하는 자료구조의 구성에 의존하는 스탬프 결합이다.
- 전역 자료를 공유하여 여러 모듈의 상태가 연결되는 공통 결합이다.
- 다른 모듈의 동작을 선택하는 제어값을 전달하는 결합이다.
편집 해설 근거: University of Texas at El Paso, CS4311 Lecture 6 — Cohesion and Coupling — slide 23 — Type of Coupling; slides 24–32; Lethbridge·Laganière, Object-Oriented Software Engineering, Chapter 9 (2001), 저자 강의 자료 — slides 28–30 — Common Coupling; Control Coupling
73. 이미지의 메모리 표에 Worst Fit으로 10K를 할당할 위치는?
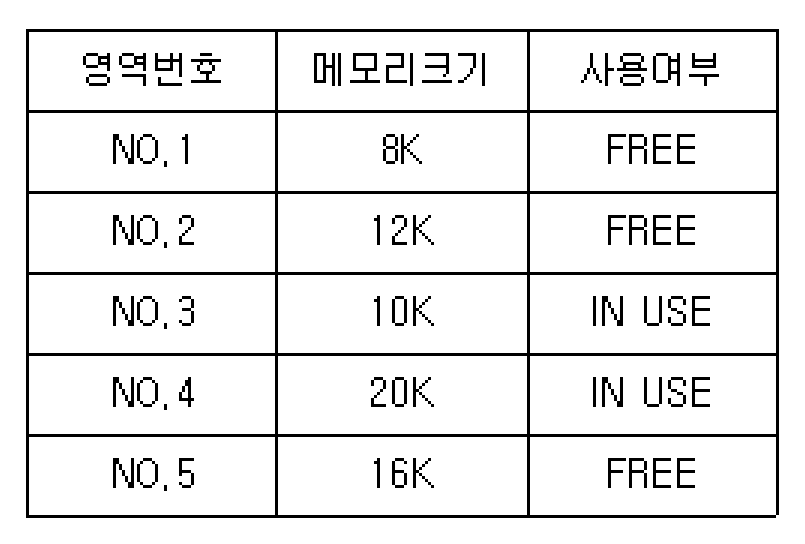
- NO.2
- NO.3
- NO.4
- NO.5
정답과 해설 보기
정답: 4
정답은 ④이다. Worst Fit은 요청을 수용할 수 있는 빈 영역 가운데 가장 큰 것을 선택한다. 표에서 비어 있는 영역은 NO.1의 8K, NO.2의 12K, NO.5의 16K이고, 10K 요청을 수용할 수 있는 후보는 12K와 16K이다. 그중 큰 16K의 NO.5를 선택하므로 분할 후 남는 공간은 6K이다. NO.4가 20K로 더 크더라도 이미 사용 중이므로 후보가 아니다. NO.2는 이 표에서 가장 작은 적합 빈 영역이므로 Best Fit의 결과와 Worst Fit을 혼동하지 않도록 한다.
선지별 해설
- 12K는 수용 가능하지만 16K보다 작아 Worst Fit이 선택하지 않는다.
- 크기는 맞아도 이미 사용 중인 영역이라 할당 후보가 아니다.
- 가장 큰 20K 영역이지만 이미 사용 중이다.
- 비어 있는 적합 영역 가운데 가장 큰 16K이므로 선택된다.
편집 해설 근거: Arpaci-Dusseau & Arpaci-Dusseau, OSTEP Chapter 17 Free-Space Management — §17.3 Basic Strategies — Best Fit and Worst Fit
74. 200.1.1.0/24에서 FLSM으로 최소 10개의 같은 크기 서브넷을 확보한다. 가능한 가장 짧은 새 프리픽스를 선택하고 0번 서브넷을 포함하여 주소가 작은 순서로 첫 번째부터 센다. 열 번째 서브넷의 브로드캐스트 주소는?
[학습용 개정문항]
- 200.1.1.159
- 201.1.5.175
- 202.1.11.254
- 203.1.255.245
정답과 해설 보기
정답: 1
정답은 ①이다. /24에서 같은 크기의 서브넷을 최소 10개 확보하려면 서브넷 비트를 4개 빌려야 한다. 3개를 빌리면 8개로 부족하고 4개면 16개의 /28 서브넷을 만들 수 있다. 각 블록의 주소 수는 16개이므로 0번 서브넷을 첫 번째로 세면 열 번째 블록의 시작은 (10−1)×16=144이다. 주소 범위는 200.1.1.144부터 200.1.1.159까지이고 마지막 주소가 브로드캐스트이다. 정확히 10개의 같은 크기 블록으로 /24 전체를 나눈다는 표현은 이진 프리픽스 분할과 맞지 않아 최소 10개 확보 조건으로 고쳤다.
선지별 해설
- 열 번째 /28 블록의 마지막 주소인 200.1.1.159이다.
- 첫 옥텟이 바뀌어 원래 200.1.1.0/24 범위 밖이다.
- 원래 /24 범위 밖이므로 해당 서브넷의 주소일 수 없다.
- 원래 /24 범위 밖이며 열 번째 /28 블록과도 무관하다.
편집 해설 근거: RFC 4632, Classless Inter-domain Routing (2006) — §3.1 Basic Description; IPv4 prefix length and address blocks
75. Python 3에서 다음 코드의 빈칸에 넣어 Helrld를 출력하게 하는 식은?
string = "Hello World"
m = ( _____ )
print(m)
[학습용 개정문항]
- string[1:3] + string[-3:]
- string[:3] + string[-3:-1]
- string[0:3] + string[-3:]
- string[0:] + string[:-1]
정답과 해설 보기
정답: 3
정답은 ③이다. Python 슬라이스는 시작 인덱스를 포함하고 끝 인덱스는 제외한다. string[0:3]은 인덱스 0·1·2의 문자 Hel을 얻고, string[-3:]은 끝에서 세 번째부터 마지막까지인 rld를 얻는다. 두 문자열을 더하면 Helrld가 된다. ①은 첫 글자 H를 빠뜨려 elrld, ②는 마지막 d를 빠뜨려 Helrl을 만든다. ④는 원문 전체와 마지막 문자만 제외한 원문을 이어 붙이므로 요구 결과보다 길어진다. 변수 이름의 대소문자는 구별되므로 원래 이미지의 String과 보기의 string이 달랐던 부분도 일치시켰다.
선지별 해설
- 인덱스 1에서 시작하여 H를 제외하므로 elrld가 된다.
- 뒤쪽 슬라이스가 인덱스 -1을 제외하여 Helrl이 된다.
- 앞의 Hel과 뒤의 rld를 연결해 Helrld를 만든다.
- 전체 문자열과 마지막 글자를 제외한 문자열을 연결하여 다른 결과가 된다.
편집 해설 근거: Python 3.14, Built-in Types — Common Sequence Operations — slice s[i:j], negative indices and concatenation
76. Python 3.14의 일반적인 변수 식별자 규칙에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 첫 자리에 숫자를 사용할 수 없다.
- 영문 대소문자와 밑줄을 사용할 수 있으며 첫 자리 뒤에는 숫자도 사용할 수 있다.
- 하나의 변수 이름 중간에 공백을 사용할 수 있다.
- if와 class 같은 키워드를 그대로 변수 이름으로 사용할 수 없다.
정답과 해설 보기
정답: 3
정답은 ③이다. Python의 식별자에는 영문자와 밑줄을 사용할 수 있고 숫자는 첫 글자를 제외한 위치에 사용할 수 있다. 따라서 count2는 가능하지만 2count는 일반적인 변수 이름으로 쓸 수 없다. 이름 중간의 공백은 토큰을 나누므로 하나의 식별자에 포함할 수 없다. if나 class 같은 키워드도 그대로 변수 이름으로 사용할 수 없다. 허용되는 비ASCII 유니코드 문자도 있으므로 변수 이름이 영문자만 가능하다고 단정하지 않으며, match 등 문맥에 따라 키워드가 되는 소프트 키워드와 항상 예약된 키워드도 구별한다.
선지별 해설
- 숫자는 이름의 첫 글자로 사용할 수 없다.
- 영문자·밑줄과 첫 글자 이후의 숫자는 사용할 수 있다.
- 공백이 들어가면 하나의 식별자가 아니므로 잘못된 설명이다.
- if와 class 같은 키워드는 그대로 변수 이름으로 사용할 수 없다.
편집 해설 근거: Python 3.14 Language Reference — Names and Keywords — §2.3 Names (identifiers and keywords); §2.3.1 Keywords; §2.3.2 Soft Keywords
77. 한 모듈이 다른 모듈을 호출할 때 플래그나 명령 값을 전달하여 피호출 모듈이 어떤 기능이나 분기를 수행할지 지정하는 결합도는?
[학습용 개정문항]
- data coupling
- stamp coupling
- control coupling
- common coupling
정답과 해설 보기
정답: 3
정답은 ③이다. 제어 결합은 한 모듈이 플래그나 명령 값을 전달하여 다른 모듈이 수행할 기능이나 내부 처리 경로를 지정하는 의존 관계이다. 예를 들어 같은 함수를 호출하면서 모드 값을 보내 특정 처리 분기를 선택하도록 한다면 호출자와 피호출자가 그 제어값의 의미를 함께 알아야 한다. 단순한 업무 데이터 전달과 달리 상대 모듈의 행동 선택에 직접 관여한다는 점이 핵심이다. 제어 신호가 반드시 하위에서 상위로 이동해야 하는 것은 아니며, 이른바 권리 전도 현상이 있어야만 제어 결합이 성립한다고 제한해서는 안 된다.
선지별 해설
- 처리할 자료 값을 주고받는 결합으로, 상대의 동작 모드를 지정하는 의미와 구별한다.
- 레코드나 객체 같은 자료구조의 형식에 의존하는 결합이다.
- 플래그나 명령 값으로 상대 모듈의 동작을 선택하게 하는 결합이다.
- 전역 자료를 여러 모듈이 공유하는 결합이다.
편집 해설 근거: Lethbridge·Laganière, Object-Oriented Software Engineering, Chapter 9 (2001), 저자 강의 자료 — slides 29–30 — Control Coupling and example
78. 다음 C11 프로그램의 표준 출력은?
#include <stdio.h>
int main(void) {
    int i;
    int sum = 0;
    for (i = 1; i <= 10; i = i + 2) {
        sum = sum + i;
    }
    printf("%d", sum);
    return 0;
}
[학습용 개정문항]
- 15
- 19
- 25
- 27
정답과 해설 보기
정답: 3
정답은 ③이다. for 문은 i를 1로 초기화한 뒤 i<=10인 동안 본문을 실행하고, 매번 본문 뒤에서 i에 2를 더한다. 따라서 sum에 더하는 값은 1, 3, 5, 7, 9이며 누적값은 차례로 1, 4, 9, 16, 25가 된다. 마지막 본문 뒤 i는 11이 되어 조건이 거짓이므로 10이나 11을 더하지 않는다. printf의 %d는 int 값인 sum을 십진수로 출력하므로 결과는 25이다. 표준 입출력 헤더와 int 반환형을 명시하여 오래된 이미지 코드의 생략 표현 때문에 별도의 컴파일 문제가 생기지 않게 했다.
선지별 해설
- 누적 대상인 1·3·5·7·9를 모두 합한 값과 다르다.
- 반복에서 실제 더하는 다섯 홀수의 합과 다르다.
- 1+3+5+7+9=25이며 마지막에 이 값이 출력된다.
- 조건 검사에서 제외되는 값을 더하는 등 반복 범위를 잘못 계산한 값이다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.8.5.3 The for statement; §7.21.6.1 The fprintf function; §7.21.6.3 The printf function
79. UNIX 계열에서 호출 프로세스를 바탕으로 새 자식 프로세스를 생성하는 POSIX 함수의 이름은?
[학습용 개정문항]
- ls
- cat
- fork
- chmod
정답과 해설 보기
정답: 3
정답은 ③이다. POSIX의 fork()는 호출한 프로세스를 바탕으로 새 자식 프로세스를 생성하는 함수이다. 성공하면 부모와 자식이 각각 반환을 받으며 부모에는 자식의 프로세스 ID, 자식에는 0이 반환되어 이후 처리 경로를 구별할 수 있다. 이는 셸에서 파일 목록을 보는 ls, 파일 내용을 이어 출력하는 cat, 파일 모드를 바꾸는 chmod와 역할이 다르다. fork는 일반적인 셸 유틸리티 명령의 이름이라기보다 프로그램이 호출하는 프로세스 생성 인터페이스이므로 문항에서도 함수라는 표현으로 명확히 구별한다.
선지별 해설
- 파일과 디렉터리 항목의 정보를 표시하는 유틸리티이다.
- 파일 내용을 이어 표준 출력으로 보내는 유틸리티이다.
- 호출 프로세스를 바탕으로 새 자식 프로세스를 생성하는 함수이다.
- 파일 접근 모드와 관련된 권한 비트를 변경하는 유틸리티이다.
편집 해설 근거: The Open Group, POSIX.1-2024 fork() — DESCRIPTION; RETURN VALUE
80. C11 표준의 자료형 분류에서 다음 중 정수형인 것은?
[학습용 개정문항]
- int
- float
- void
- double
정답과 해설 보기
정답: 1
정답은 ①이다. C11에서 int는 표준 부호 있는 정수형 가운데 하나이다. float와 double은 실수 부동소수점형이며 void는 값이 없음을 나타내는 형식으로 정수형이 아니다. 원래 보기에는 char가 있었지만 C 표준은 char도 정수형 범주에 포함하므로 int만 정답이라고 하면 복수 정답 문제가 생긴다. 문자를 저장할 때 자주 사용한다는 활용 목적과 표준의 형식 분류를 구별해야 한다. 개정 보기에서는 char를 void로 바꾸어 하나의 정답을 유지하며, int의 크기가 모든 구현에서 반드시 32비트라고 덧붙이지 않는다.
선지별 해설
- 표준 부호 있는 정수형이다.
- 실수 부동소수점형이다.
- 정수 값을 표현하는 형식이 아니라 값의 부재를 나타내는 형식이다.
- 실수 부동소수점형이다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.2.5 Types, paragraphs 4–6 and 10–19
정보처리기사 필기 기출문제 · 정보시스템 구축관리
81. 현실의 사물이나 프로세스를 디지털로 표현하고 정해진 주기와 정밀도로 현실 상태와 동기화하여 관찰·시뮬레이션·의사결정에 활용하는 모델은?
[학습용 개정문항]
- 최적화
- 실행 시간
- 디지털 트윈
- N-Screen
정답과 해설 보기
정답: 3
정답은 ③이다. 디지털 트윈은 현실의 대상이나 프로세스를 디지털로 표현하고 정해진 주기와 정밀도로 현실과 연결·동기화하는 모델이다. 센서 등에서 얻은 자료와 모델을 이용하여 현재 상태를 파악하고 조건이 바뀔 때의 결과를 시뮬레이션하는 데 활용할 수 있다. 단순히 외형이 같은 3차원 그림을 만드는 것만으로 설명을 끝내서는 안 된다. 또한 실제 대상과 모든 면에서 완전히 같거나 예측이 반드시 정확한 것은 아니며, 사용 목적에 필요한 충실도와 데이터 품질을 검증해야 한다. 최적화는 활용 목적 중 하나이고 실행 시간이나 N-Screen은 이 모델의 명칭이 아니다.
선지별 해설
- 자원 배치나 운용 조건을 개선하는 목적 또는 절차이며 해당 가상 모델의 명칭이 아니다.
- 프로그램이나 작업이 수행되는 데 걸리는 시간을 뜻한다.
- 현실 대상을 디지털로 표현하고 정해진 주기와 충실도로 동기화하는 모델이다.
- 여러 화면·기기에 걸쳐 콘텐츠를 이용하는 서비스 개념이다.
편집 해설 근거: Digital Twin Consortium, Digital Twin Consortium Defines Digital Twin (2020-12-03) — Digital Twin Consortium Definition; Virtual Representation; Synchronized
82. 정보보안의 3대 요소에 해당하지 않는 것은?
- 기밀성
- 휘발성
- 무결성
- 가용성
정답과 해설 보기
정답: 2
정답은 ②이다. 정보보안의 대표적인 세 가지 목표인 CIA는 기밀성, 무결성, 가용성을 뜻한다. 기밀성은 허가되지 않은 정보 공개를 막는 성질이고, 무결성은 부적절한 변경이나 파괴로부터 정보를 보호하는 성질이다. 가용성은 권한 있는 사용자가 필요할 때 정보와 시스템을 적시에 신뢰할 수 있게 이용하도록 하는 목표이다. 휘발성은 전원이 끊어질 때 저장 내용이 사라지는 메모리 등의 특성을 설명할 수 있지만 CIA의 한 요소는 아니다. 정보보안의 모든 요구가 세 단어에만 한정된다는 뜻이 아니라 이 문항이 대표적인 세 목표를 묻는 것이다.
선지별 해설
- 허가되지 않은 정보 공개를 방지하는 보안 목표이다.
- 저장 내용의 유지 특성과 관련된 용어로 CIA 세 요소에 포함되지 않는다.
- 부적절한 정보 변경이나 파괴로부터 보호하는 보안 목표이다.
- 필요한 때 정보와 시스템을 적시에 신뢰성 있게 이용하는 보안 목표이다.
편집 해설 근거: NIST FIPS 199 — §2 Security Objectives
83. 서로 다른 기존 웹 서비스의 API나 데이터를 둘 이상 결합하여 새로운 기능을 제공하는 응용 서비스를 만드는 방식은?
[학습용 개정문항]
- Quantum Key Distribution
- Digital Rights Management
- Grayware
- Mashup
정답과 해설 보기
정답: 4
정답은 ④이다. 매시업은 기존의 둘 이상 데이터나 서비스 기능을 결합하여 새로운 서비스나 응용을 구성하는 방식이다. 예를 들어 지도 서비스에 별도의 시설 위치 데이터를 연결하여 하나의 화면과 기능으로 제공하는 경우를 생각할 수 있다. API 호출 결과를 연결하거나 여러 서비스의 결과를 집계하는 구현이 가능하지만 단순히 웹에서 정보를 읽는 모든 행위를 매시업이라고 부르는 것은 아니다. 양자 키 분배는 키 공유, DRM은 디지털 콘텐츠 이용 권한 관리에 관련되며, 그레이웨어는 원치 않는 동작을 하는 소프트웨어를 가리키는 범주로 서비스 결합 방식과 다르다.
선지별 해설
- 양자적 특성을 이용한 키 분배 기술로 서비스 결합 방식이 아니다.
- 디지털 콘텐츠의 이용 권한과 접근을 관리하는 기술이다.
- 원치 않는 동작을 하는 소프트웨어와 관련된 범주이다.
- 기존 데이터와 서비스 기능을 결합하여 새 응용이나 서비스를 만드는 방식이다.
편집 해설 근거: IBM webMethods API Gateway — API Mashups — API Mashups — Overview; chaining and aggregation
84. 전통적인 IFPUG 기능점수의 다섯 기능 유형에 해당하지 않는 것은?
[학습용 개정문항]
- 클래스의 메서드·인터페이스 개수
- 외부 조회(EQ)
- 내부 논리 파일(ILF)
- 외부 출력(EO)
정답과 해설 보기
정답: 1
정답은 ①이다. 전통적인 IFPUG 기능점수는 사용자에게 제공되는 기능 규모를 외부 입력 EI, 외부 출력 EO, 외부 조회 EQ, 내부 논리 파일 ILF, 외부 인터페이스 파일 EIF의 다섯 유형으로 식별한다. 클래스의 메서드나 인터페이스 개수는 이 다섯 가지 기능 유형에 포함되지 않는다. 외부 인터페이스 파일의 인터페이스라는 단어를 객체지향 클래스의 인터페이스와 같은 의미로 읽어서는 안 된다. 기능점수는 기능 규모의 척도이므로 비용을 얻으려면 생산성이나 단가 등의 추가 조건이 필요하며, 개수만으로 모든 프로젝트의 비용이 자동 결정되는 것도 아니다.
선지별 해설
- 클래스 메서드나 인터페이스 개수는 전통적인 다섯 기능 유형이 아니다.
- 외부 조회 EQ는 트랜잭션 기능 유형 중 하나이다.
- 내부 논리 파일 ILF는 데이터 기능 유형 중 하나이다.
- 외부 출력 EO는 트랜잭션 기능 유형 중 하나이다.
편집 해설 근거: IFPUG — Simplifying Software Sizing with Simple Function Points, ISMA19 — Session Description — five traditional IFPUG function types
85. 블록 암호화 방식이 아닌 것은?
- DES
- RC4
- AES
- SEED
정답과 해설 보기
정답: 2
정답은 ②이다. RC4는 키로부터 생성한 키스트림을 평문과 결합하는 스트림 암호로 분류된다. DES는 64비트 블록, AES와 SEED는 128비트 블록을 처리하는 블록 암호이므로 제시한 보기에서 RC4만 분류가 다르다. 블록 크기와 키 길이는 별개의 개념이어서 AES의 키 길이가 128·192·256비트라는 사실을 블록 크기도 세 종류라는 뜻으로 이해하면 안 된다. 이 문항은 역사적인 알고리즘 분류를 묻는다. RC4는 TLS에서 사용이 금지되었고 DES 표준도 철회되었으므로 보기에 실렸다는 이유로 현재 안전한 선택이라고 판단해서는 안 된다.
선지별 해설
- 64비트 블록을 처리하는 역사적인 블록 암호이다.
- 블록 암호가 아니라 키스트림을 사용하는 스트림 암호이다.
- 128비트 블록을 처리하고 세 가지 키 길이를 지원하는 블록 암호이다.
- 128비트 블록과 128비트 키를 사용하는 블록 암호이다.
편집 해설 근거: IETF RFC 6229, Test Vectors for the Stream Cipher RC4 — Abstract; §1 Introduction; IETF RFC 7465, Prohibiting RC4 Cipher Suites — §2 Requirements; NIST FIPS 197-upd1 (2023), Advanced Encryption Standard — §1; §5 Algorithm Specifications; IETF RFC 4269, The SEED Encryption Algorithm (2005) — §2 The SEED Algorithm; NIST FIPS 46-3, Data Encryption Standard (1999), 2005년 철회된 역사 자료 — FIPS 46-3, Explanation; withdrawal notice
86. Putnam 모형을 기초로 해서 만든 자동화 추정 도구는?
- SQLR/30
- SLIM
- MESH
- NFV
정답과 해설 보기
정답: 2
정답은 ②이다. SLIM은 Putnam의 소프트웨어 생산 방정식에 기초하여 소프트웨어 규모, 투입 노력, 개발 기간, 생산성의 관계를 추정하는 도구 계열이다. 개발사 QSM의 설명은 Larry Putnam의 모델을 실제 추정 도구로 구현한 과정을 명시한다. 일정만 임의로 줄이면 동일한 결과를 얻는다고 보는 것이 아니라 다른 변수와의 관계를 함께 살피는 것이 핵심이다. 모델의 입력과 조직의 생산성 자료, 프로젝트 조건에 따라 결과가 달라지므로 추정값은 보장된 납기나 확정 비용이 아니다. 나머지 보기의 명칭을 SLIM의 별칭으로 이해하지 않는다.
선지별 해설
- Putnam 모델을 구현한 도구의 명칭인 SLIM과 다르다.
- Putnam의 소프트웨어 생산 모델을 바탕으로 한 추정 도구이다.
- 네트워크 등의 그물형 구조를 가리킬 때 쓰며 해당 추정 도구 이름이 아니다.
- 네트워크 기능 가상화의 약자로 해당 추정 도구가 아니다.
편집 해설 근거: QSM — Remembering Larry Putnam Sr. (2021) — Software Production Equation; development of SLIM with Ann Fitzsimmons
87. Rivest·Shamir·Adleman이 제시한 공개키 방식으로, 기본 구조에서 두 큰 소수의 곱을 공개 모듈러스로 사용하고 그 수의 소인수분해 어려움이 보안에 중요하게 관련되는 것은?
[학습용 개정문항]
- DES
- ARIA
- SEED
- RSA
정답과 해설 보기
정답: 4
정답은 ④이다. RSA라는 이름은 Rivest, Shamir, Adleman의 성에서 왔다. 기본 구조에서는 두 큰 소수의 곱을 공개 모듈러스로 사용하며 공개키와 개인키를 구별한다. 이 곱을 소인수분해할 수 있으면 개인키 계산에 필요한 정보를 얻을 수 있으므로 소인수분해의 어려움이 중요한 보안 기반이다. 다만 RSA를 깨는 모든 방법이 소인수분해와 수학적으로 동등하다고 증명되었다는 뜻은 아니다. DES·ARIA·SEED는 대칭키 블록 암호이다. 실제 RSA 암호화나 서명에는 적절한 인코딩·패딩 방식과 매개변수가 필요하며 교과서식 거듭제곱만 그대로 적용하지 않는다.
선지별 해설
- 대칭키 블록 암호이며 제시한 공개키 방식이 아니다.
- 대칭키 블록 암호로 RSA와 키 구조가 다르다.
- 대칭키 블록 암호이며 공개 모듈러스 기반 RSA와 다르다.
- Rivest·Shamir·Adleman의 공개키 방식이다.
편집 해설 근거: Rivest·Shamir·Adleman, A Method for Obtaining Digital Signatures and Public-Key Cryptosystems, 저자 공개본 — Abstract; encryption using n = pq; IETF RFC 8017, PKCS #1: RSA Cryptography Specifications Version 2.2 (2016) — §3 Key Types; §7 Encryption Schemes; §8 Signature Schemes; Menezes·van Oorschot·Vanstone, Handbook of Applied Cryptography, Chapter 8 저자 공개본 — §8.2 RSA public-key encryption; §8.2.2 Security of RSA
88. 초기 COCOMO(통상 COCOMO 81)의 프로젝트 개발 모드에 포함되지 않는 것은?
[학습용 개정문항]
- Organic
- Semi-detached
- Embedded
- Sequential
정답과 해설 보기
정답: 4
정답은 ④이다. 초기 COCOMO의 프로젝트 개발 모드는 Organic, Semidetached, Embedded의 세 가지이다. 익숙한 환경과 비교적 유연한 제약을 가진 유기형, 경험과 복잡성이 중간 정도인 중간형, 강한 하드웨어·소프트웨어·운영 제약을 받는 내장형을 구분하여 추정식의 계수 등을 달리 적용한다. Sequential은 순차적이라는 일반적인 말로 이 세 모드 중 하나가 아니다. 프로젝트 규모만으로 세 모드를 기계적으로 나누는 설명은 충분하지 않으며 경험과 환경·제약도 함께 고려한다. COCOMO II의 추정 단계나 하위 모델 명칭과도 구분해야 한다.
선지별 해설
- 초기 COCOMO의 유기형 개발 모드이다.
- 초기 COCOMO의 중간형 개발 모드이다.
- 초기 COCOMO의 강한 제약을 가진 내장형 개발 모드이다.
- 초기 COCOMO의 세 개발 모드에 포함되지 않는다.
편집 해설 근거: Barry W. Boehm, Software Engineering Economics (1984), 저자 논문 보존 사본 — Step 1 — Nominal Effort Estimation; Table IV COCOMO Software Development Modes
89. 데이터 속의 패턴과 변수 간 관계를 분석하여 분류·군집·연관 규칙 탐색이나 예측 등에 활용하는 기법은?
[학습용 개정문항]
- Data Mining
- Wm-Bus
- Digital Twin
- Zigbee
정답과 해설 보기
정답: 1
정답은 ①이다. 데이터 마이닝은 데이터에 들어 있는 패턴이나 관계를 분석하여 유용한 규칙과 예측에 활용하는 기법이다. 분류, 군집화, 연관 규칙 탐색 등 목적에 따라 여러 방법을 사용할 수 있다. 예를 들어 함께 구매되는 상품의 관계를 찾을 수 있지만 함께 나타난다는 사실만으로 한 상품이 다른 상품의 구매 원인이라고 확정할 수는 없다. 입력 자료의 품질과 문제 정의, 결과 검증도 필요하다. Wm-Bus와 Zigbee는 통신과 관련된 기술이고, 디지털 트윈은 현실 대상을 디지털로 표현·동기화하는 모델이므로 분석 기법의 이름과 구별한다.
선지별 해설
- 데이터에서 패턴과 관계를 발견하여 설명이나 예측에 활용하는 기법이다.
- 계량기 등의 통신에 관련된 무선 M-Bus 계열 기술이다.
- 현실 대상과 프로세스의 디지털 표현·동기화 모델이다.
- 저전력 기기 등의 통신에 활용되는 네트워크 기술이다.
편집 해설 근거: Oracle Database 12.1 Data Mining Concepts — What Is Data Mining? — What Is Data Mining?; What Can Data Mining Do and Not Do?
90. 여러 노드를 그물처럼 연결하고 중간 노드를 통한 다중 홉 전달과 대체 경로를 구성할 수 있으며, 완전 연결형과 부분 연결형을 구분하는 네트워크 구조는?
[학습용 개정문항]
- Software Defined Perimeter
- Virtual Private Network
- Local Area Network
- Mesh Network
정답과 해설 보기
정답: 4
정답은 ④이다. 메시 네트워크는 여러 노드가 서로 연결되어 필요하면 중간 노드를 거치는 경로로 데이터를 전달하는 그물형 구조이다. 여러 경로를 구성하면 특정 링크에 문제가 생겼을 때 다른 경로를 사용할 수 있지만 실제 우회 가능성은 연결 상태와 라우팅 방식에 달려 있다. 모든 노드 쌍이 직접 연결된 완전 메시와 일부 연결을 사용하는 부분 메시를 구분한다. 무선 네트워크에 활용할 수 있으나 메시라는 용어 자체가 무선에만 한정되는 것은 아니다. SDP는 접근 제어 구조, VPN은 가상 사설 연결, LAN은 근거리 네트워크라는 범위 개념이다.
선지별 해설
- 접근 권한에 따라 자원을 보호하는 소프트웨어 정의 경계 개념이다.
- 공용망 등에서 가상 사설 연결을 구성하는 기술이다.
- 근거리 네트워크의 범위를 뜻하며 특정 그물형 연결 방식만 의미하지 않는다.
- 여러 노드의 상호 연결과 중간 노드를 통한 경로를 이용하는 그물형 구조이다.
편집 해설 근거: IBM, What is network topology? — Mesh topology
91. 여러 호스트에서 대상에 트래픽을 보내는 분산 서비스 거부(DDoS) 공격 도구의 고유 이름으로 알려진 것은?
[학습용 개정문항]
- Secure shell
- Tribe Flood Network
- Nimda
- Deadlock
정답과 해설 보기
정답: 2
정답은 ②이다. Tribe Flood Network, 줄여서 TFN은 여러 호스트를 이용하여 분산 서비스 거부 공격을 수행하는 역사적인 도구이다. 다수의 공격 지점에서 대상에 트래픽을 보내 자원을 소모시키고 정상적인 이용을 방해한다는 점이 DDoS와 연결된다. Secure Shell은 원격 접속 등을 보호하는 통신 프로토콜이고, Nimda는 악성코드의 이름이며, 교착 상태는 작업들이 필요한 자원을 서로 기다려 진행하지 못하는 상태이다. 악성코드나 장애가 간접적으로 서비스 중단을 일으킬 수 있다는 넓은 설명과, 이 문항에서 묻는 분산 공격 도구의 고유 명칭을 구별한다.
선지별 해설
- 보호된 원격 접속 등에 사용하는 프로토콜이며 DDoS 도구 이름이 아니다.
- 여러 호스트를 이용한 분산 서비스 거부 공격 도구의 이름이다.
- 악성코드의 이름이며 문항이 특정하는 분산 공격 도구 명칭과 다르다.
- 작업들이 서로 자원을 기다리며 진행하지 못하는 상태이다.
편집 해설 근거: Dietrich·Long·Dittrich, Analyzing Distributed Denial Of Service Tools: The Shaft Case, USENIX LISA 2000 — Related work — TFN and variants
92. 이미지의 CPM 네트워크에서 화살표의 수치는 작업 소요일수이고 연결점 자체의 소요시간은 0이다. 모든 선행 작업이 끝나야 후속 작업이 시작되며 자원 제약이나 추가 지연은 없다. 시작부터 종료까지의 임계경로 소요기간은?
[학습용 개정문항]
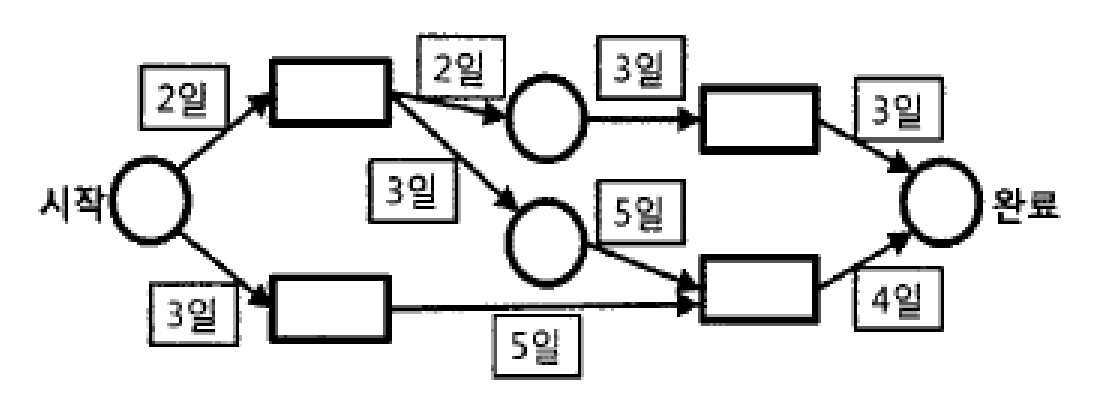
- 10일
- 12일
- 14일
- 16일
정답과 해설 보기
정답: 3
정답은 ③이다. 임계경로는 시작에서 종료까지 이어지는 경로 중 작업 소요시간의 합이 가장 큰 경로이다. 그림의 위쪽 경로는 2+2+3+3=10일, 대각선 연결을 거치는 경로는 2+3+5+4=14일, 아래쪽 경로는 3+5+4=12일이다. 세 경로 가운데 14일이 가장 길어 전체 완료 시점을 결정한다. 합류점에서는 먼저 끝난 한 경로만 보고 후속 작업을 시작하는 것이 아니라 모든 선행 작업이 끝나야 한다. 자원 제약이나 추가 지연이 없다는 문항의 조건에서 최소 완료기간을 구하는 것이며, 모든 화살표의 시간을 단순 합산하는 문제가 아니다.
선지별 해설
- 위쪽 경로의 합으로 다른 선행 경로의 지연을 반영하지 못한다.
- 아래쪽 경로의 합으로 14일인 경로보다 짧다.
- 대각선 연결을 거치는 가장 긴 경로의 합이다.
- 제시한 경로의 올바른 합에서 얻어지지 않는 값이다.
편집 해설 근거: U.S. GAO, Schedule Assessment Guide GAO-16-89G (2015) — Best Practice 6 — Confirming That the Critical Path Is Valid
93. RIP(Routing Information Protocol)에 대한 설명으로 틀린 것은?
- 거리 벡터 라우팅 프로토콜이라고도 한다.
- 소규모 네트워크 환경에 적합하다.
- 최대 홉 카운트를 115홉 이하로 한정하고 있다.
- 최단경로탐색에는 Bellman-Ford 알고리즘을 사용한다.
정답과 해설 보기
정답: 3
정답은 ③이다. RIP는 거리 벡터 방식의 라우팅 프로토콜로 Bellman–Ford 계열의 거리 갱신 원리를 사용한다. 일반적인 홉당 비용 1 설정에서는 도달 가능한 경로의 최대 홉 수가 15이고, 메트릭 16은 무한대, 즉 도달 불가능을 나타낸다. 따라서 115홉까지 허용한다는 보기는 잘못되었다. 이러한 메트릭 한계와 라우팅 정보 수렴 특성 때문에 큰 네트워크보다는 제한된 규모에 적합하다고 설명한다. 최단 경로라는 말은 정해진 메트릭의 합을 비교한다는 뜻이며 실제 지연시간이나 대역폭을 항상 최적으로 선택한다는 의미는 아니다.
선지별 해설
- 이웃과 목적지별 거리 정보를 교환하는 거리 벡터 방식이다.
- 메트릭과 수렴의 제약 때문에 비교적 작은 네트워크에 적합하다.
- 도달 가능 메트릭의 최대는 15이며 16은 도달 불가능이므로 115홉이라는 설명은 틀리다.
- 거리 벡터 갱신은 Bellman–Ford 계열의 원리에 기반한다.
편집 해설 근거: IETF RFC 2453, RIP Version 2 (1998) — §3.2 Limitations of the Protocol; §3.4 Distance Vector Algorithms; §3.6 Message Format
94. 요구사항 분석 → 설계 → 구현 → 시험 등 단계별 산출물을 다음 단계로 이어 가는 선형 순차적 생명주기 모형의 대표적인 이름은?
[학습용 개정문항]
- 폭포수 모형
- 애자일 모형
- 컴포넌트 기반 방법론
- 6GT 모형
정답과 해설 보기
정답: 1
정답은 ①이다. 폭포수 모형은 요구사항 분석, 설계, 구현, 시험 등의 활동을 구분하고 앞 단계의 결과를 다음 단계의 입력으로 이어 가는 순차적 생명주기 모형이다. 단계별 산출물과 검토 시점을 계획하기에 알맞지만 요구 변화나 늦게 발견한 문제 때문에 앞 단계로 돌아가면 수정 비용이 커질 수 있다. 순차적이라는 특징을 설명한다고 해서 실제 모든 프로젝트에서 되돌아가거나 변경하는 일이 절대 없다는 뜻은 아니다. 애자일 접근은 반복과 피드백을 강조하며 컴포넌트 기반 개발은 부품의 재사용·조립 관점이므로 이 문항이 지정한 순차적 흐름의 이름과 구별한다.
선지별 해설
- 단계별 산출물을 다음 단계에 넘기는 대표적인 순차적 생명주기 모형이다.
- 짧은 반복과 피드백·변화 대응을 강조하는 접근이다.
- 재사용 가능한 컴포넌트를 선택·조립하는 개발 관점이다.
- 제시한 순차적 생명주기 모형의 명칭이 아니다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §2.1.1 Software Development and Software Testing — Sequential Development Models
95. Boehm의 나선형 모형 한 반복을 다음과 같이 요약했다. A: 목표·대안·제약 확인, D: 대안의 위험 평가·해소, C: 다음 수준의 제품 개발·검증, B: 결과 검토와 다음 반복 계획. A에서 시작할 때 올바른 흐름은?
[학습용 개정문항]
- A → B → D → C 순으로 반복
- A → D → C → B 순으로 반복
- A → B → C → D 순으로 반복
- A → C → B → D 순으로 반복
정답과 해설 보기
정답: 2
정답은 ②이다. 나선형 모형은 각 반복에서 목표와 대안·제약을 확인하고, 대안을 평가하여 주요 위험을 파악·줄인 뒤 필요한 제품 수준을 개발하고 검증하는 위험 중심 접근이다. 그 결과를 관계자와 검토하고 다음 반복의 계획과 진행 여부를 정한다. 문항의 A는 해당 반복의 목표·대안·제약 확인, D는 위험 평가와 해소, C는 개발·검증, B는 결과 검토와 다음 반복 계획이므로 A→D→C→B 순서가 된다. 위험 분석을 개발이 끝난 뒤의 최종 검사로 미루는 것이 아니며, 모든 반복에서 똑같은 규모의 완제품을 만드는 것도 아니다.
선지별 해설
- 결과 검토와 다음 계획을 개발·위험 평가보다 앞에 놓아 지정한 단계 관계와 맞지 않는다.
- 목표 확인, 위험 평가·해소, 개발·검증, 검토·다음 계획 순서이다.
- 위험 평가를 개발·검토 뒤로 미루어 위험 중심 순서와 맞지 않는다.
- 위험 평가를 해당 반복의 개발과 결과 검토 뒤에 놓는다.
편집 해설 근거: Barry W. Boehm, A Spiral Model of Software Development and Enhancement (1988), 논문 보존 사본 — Figure 2; A typical cycle of the spiral, printed pp. 64–65
96. 전자 칩과 같은 소프트웨어 부품, 즉 블록(모듈)을 만들어서 끼워 맞추는 방법으로 소프트웨어를 완성시키는 재사용 방법은?
- 합성 중심
- 생성 중심
- 분리 중심
- 구조 중심
정답과 해설 보기
정답: 1
정답은 ①이다. 합성 중심 재사용은 이미 준비한 컴포넌트나 모듈을 선택하고 서로 연결하여 필요한 소프트웨어를 구성하는 방식이다. 전자 부품을 조립하는 비유는 이 구성을 설명하지만 소프트웨어 부품이 아무 조건 없이 바로 결합된다는 뜻은 아니다. 제공·요구 인터페이스, 의존성, 데이터 형식, 실행 환경이 맞는지 확인하고 통합 시험도 수행해야 한다. 생성 중심 방식은 명세나 모델 등의 입력에서 생성 도구로 코드를 만들어 내는 관점을 강조한다. 재사용할 부품을 결합하는 문항의 설명은 합성 중심에 해당한다.
선지별 해설
- 기존 컴포넌트나 모듈을 조합하여 새 시스템을 구성하는 방식이다.
- 명세나 모델을 바탕으로 도구가 코드를 생성하는 관점을 강조한다.
- 제시한 부품 조합 재사용 방식의 명칭이 아니다.
- 제시한 합성 대 생성 구분에서 부품 조합의 명칭이 아니다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §5.6 Component-Based Design; Software Construction §1.4 Reusing Assets
97. 필요한 import가 준비된 Java 메서드 안에서 다음 고정값을 실제 운영 데이터 암호화의 비밀키로 사용하려 한다. 코드에 직접 드러난 보안 약점은?
SecretKey key = new SecretKeySpec(
    "0123456789abcdef".getBytes(StandardCharsets.US_ASCII),
    "AES"
);
[학습용 개정문항]
- 무결성 검사 없는 코드 다운로드
- 중요 자원에 대한 잘못된 권한 설정
- 하드코드된 암호화 키 사용
- 적절한 인증없는 중요 기능 허용
정답과 해설 보기
정답: 3
정답은 ③이다. 제시한 코드는 AES 비밀키의 바이트를 소스 코드에 고정된 문자열로 넣고 있으므로 하드코드된 암호화 키 사용에 해당한다. 소스나 배포 파일에서 값을 추출한 사람이 같은 키를 알 수 있고, 키를 바꾸려면 코드·배포 과정까지 변경해야 하는 문제가 생긴다. 16바이트라는 길이가 AES 키 길이에 맞는다는 사실은 키의 비밀성과 안전한 관리를 보장하지 않는다. 이 짧은 코드만으로 다운로드 무결성 검사, 파일 권한, 사용자 인증의 구현 여부를 판단할 수 없으므로 명시적으로 드러난 약점을 선택한다. 예시 문자열은 학습을 위한 고정값이며 운영 키로 사용하면 안 된다.
선지별 해설
- 다운로드 동작이나 무결성 검증이 이 코드에 제시되지 않았다.
- 자원 권한을 설정하는 코드가 제시되지 않아 이 약점으로 특정할 수 없다.
- 실제 사용할 비밀키 값을 소스 코드에 상수로 고정하였다.
- 인증 절차와 보호 기능의 연결이 제시되지 않아 이 약점으로 특정할 수 없다.
편집 해설 근거: MITRE CWE-321 — Use of Hard-coded Cryptographic Key — Description; Common Consequences; Potential Mitigations
98. 소프트웨어 프로세스의 개선과 역량 판단을 뜻하며, 역사적으로 ISO/IEC 15504 계열의 프로세스 평가와 연결되어 사용된 명칭은?
[학습용 개정문항]
- SCRUM
- ISO/IEC 12509
- SPICE
- CASE
정답과 해설 보기
정답: 3
정답은 ③이다. SPICE는 Software Process Improvement and Capability Determination을 뜻하며 소프트웨어 프로세스의 평가, 역량 판단, 개선과 관련된 접근이다. 역사적으로 ISO/IEC 15504 계열과 연결되어 사용되었다. 제품의 오류 개수만 검사하는 것보다 조직이 수행하는 프로세스의 강점과 약점, 개선 가능성을 평가하는 관점이 핵심이다. 다만 15504 계열의 과거 표준을 모두 현재 유효한 표준으로 부르면 안 된다. 예를 들어 ISO/IEC 15504-4:2004는 철회되고 ISO/IEC TR 33015:2019로 대체되었다. Scrum은 개발 프레임워크이며 CASE는 개발 지원 도구·환경에 관한 용어이다.
선지별 해설
- 반복적 제품 개발과 팀의 작업 운영에 쓰는 프레임워크이다.
- 문항이 묻는 ISO/IEC 15504 관련 접근의 명칭이 아니다.
- 프로세스 개선과 역량 판단을 뜻하며 ISO/IEC 15504 계열과 역사적으로 연결된다.
- 컴퓨터를 이용해 소프트웨어 공학 활동을 지원하는 도구·환경과 관련된다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Testing — Acronyms; test process improvement models; ISO/IEC 15504-4:2004, Process assessment, 공식 개요 및 대체 표준 표시 — Abstract; Life cycle — withdrawal and ISO/IEC TR 33015:2019 replacement
99. Gary McGraw가 제시한 접근으로, 코드 검토·아키텍처 위험 분석·침투 시험 등을 포함한 일곱 가지 보안 실천 활동을 소프트웨어 생명주기의 산출물에 연결하는 것은?
[학습용 개정문항]
- CLASP
- CWE
- PIMS
- Seven Touchpoints
정답과 해설 보기
정답: 4
정답은 ④이다. Gary McGraw의 Seven Touchpoints는 코드 검토, 아키텍처 위험 분석, 침투 시험 등의 보안 활동을 소프트웨어 생명주기의 산출물과 연결하여 적용하는 접근이다. 보안을 배포 직전 한 번의 점검으로 끝내기보다 요구·설계·구현·시험·운영의 관련 지점에서 다루는 것이 핵심이다. CLASP도 개발 과정에 보안을 통합하는 접근이므로 단순히 SDLC에 보안을 넣는다는 설명만으로 두 방법을 구별하기 어렵다. 개정 문항은 저자와 일곱 가지 실천 활동이라는 조건을 주어 정답을 특정했다. CWE는 약점 분류 체계이며 PIMS는 개인정보 보호 관리체계에 관련된다.
선지별 해설
- 보안 개발 접근이지만 Gary McGraw의 일곱 가지 touchpoint 명칭과 다르다.
- 소프트웨어·하드웨어 약점을 정리하는 분류 체계이다.
- 개인정보 보호 관리체계와 관련된 명칭이다.
- Gary McGraw가 제시한 일곱 보안 실천 활동의 접근이다.
편집 해설 근거: Gary McGraw, Software Security: Building Security In — Preface — What This Book Is About — Part II; chapters 3–9; Icons
100. 이미지의 LAN 네트워크 토폴로지는?
- 버스형
- 성형
- 링형
- 그물형
정답과 해설 보기
정답: 1
정답은 ①이다. 그림에서는 여러 단말이 하나의 공통 선로에 짧은 연결선으로 붙어 있으므로 버스형 토폴로지이다. 성형처럼 중앙 허브나 스위치에 각각 독립적인 선이 모이지 않고, 링형처럼 연결이 닫힌 고리를 이루지도 않는다. 또한 여러 노드 사이에 다수의 개별 연결이 있는 그물형과도 다르다. 토폴로지는 연결 구조를 나타내므로 그림의 단말 배치 방향이나 개수 자체보다 공통 선로를 공유하는 관계를 본다. 이 단순한 도식을 근거로 모든 현대 LAN이나 이더넷이 물리적 버스 구조라고 일반화해서는 안 된다.
선지별 해설
- 여러 단말이 하나의 공통 백본 선로에 연결된 구조이다.
- 각 단말의 연결이 중앙 장치에 모이는 구조이다.
- 노드의 연결이 닫힌 고리를 만드는 구조이다.
- 여러 노드가 다수의 개별 연결로 이어지는 구조이다.
편집 해설 근거: IBM, What is network topology? — Bus topology; Ring topology; Star topology; Mesh topology
정보처리기사 필기 기출문제 학습 방법
먼저 PDF 문제지를 시간에 맞춰 푼 뒤, 이 글에서 오답의 정답·해설·근거를 확인하세요. 법규 문항은 근거 기준일 이후 개정 여부도 함께 확인하는 것이 안전합니다.