
문제지 PDF · 웹 정답 해설
정보처리기사 필기 2022년 1회 공개기출 100문항
정보처리기사 필기 2022년 1회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.

© 자격증3001. 이 정보처리기사 필기 기출문제 게시물의 문제 재구성 문장, 해설, 재작성 도식, 편집 및 PDF 디자인은 자격증3001의 저작권 보호를 받습니다. 국가기술자격 시험 및 관련 명칭의 권리는 해당 기관에 있으며, 본 자료는 Q-Net 공식 문제지 또는 공식 해설이 아닙니다. 무단 복제·재배포를 금합니다.
정보처리기사 필기 2022년 1회 공개기출 100문항 안내
정보처리기사 필기 2022년 1회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.
이 회차의 100문항 해설을 문항별 기술 원문과 필요한 독립 계산으로 편집 검토했습니다. 질문·조건·보기를 고친 문항은 학습용 개정문항으로 표시합니다. 원 시험의 공식 원문이나 공식 정답표를 새로 확인한 자료는 아닙니다.
정보처리기사 필기 기출문제 · 소프트웨어 설계
1. User Interface 설계 시 오류 메시지나 경고에 관한 지침으로 가장 거리가 먼 것은?
[학습용 개정문항]
- 메시지는 이해하기 쉬워야 한다.
- 오류에서 회복하기 위한 구체적인 설명을 제공한다.
- 오류로 발생할 수 있는 데이터 손실 등의 결과를 명확히 알린다.
- 텍스트 설명 없이 색이나 소리만으로 오류를 알린다.
정답과 해설 보기
정답: 4
정답은 ④이다. 오류 메시지는 문제가 있는 항목과 수정 방법을 사용자가 이해할 수 있는 말로 알려야 한다. 색이나 소리는 주의를 끄는 보조 수단으로 쓸 수 있지만 그것만으로 의미를 전달하면 색을 구별하지 못하거나 소리를 듣지 못하는 사용자는 오류를 파악하기 어렵다. 따라서 텍스트 설명을 제공하고 필요한 시각·청각 단서를 함께 사용한다. WCAG의 오류 식별 기준도 자동으로 감지한 입력 오류를 텍스트로 설명하도록 요구한다.
선지별 해설
- 전문 오류 코드만 나열하기보다 사용자가 이해하는 말로 문제를 알려야 한다.
- 가능한 수정 방법을 제시하면 같은 오류를 반복하지 않고 회복할 수 있다.
- 데이터 손실 등 실제로 예상되는 결과를 명확하게 알려야 한다.
- 텍스트 설명을 생략하고 감각적 단서에만 의존하면 오류를 이해할 수 없는 사용자가 생긴다.
편집 해설 근거: W3C WCAG 2.2, Understanding SC 3.3.1 Error Identification — SC 3.3.1 — Intent; W3C WCAG 2.2, Understanding 1.4.1 Use of Color — SC 1.4.1 — Intent; W3C WCAG 2.2, Understanding SC 3.3.3 Error Suggestion — SC 3.3.3 — Intent
2. 다음 중 애자일(Agile) 소프트웨어 개발에 대한 설명으로 틀린 것은?
- 공정과 도구보다 개인과의 상호작용을 더 가치 있게 여긴다.
- 동작하는 소프트웨어보다는 포괄적인 문서를 가치 있게 여긴다.
- 계약 협상보다는 고객과의 협력을 가치 있게 여긴다.
- 계획을 따르기보다 변화에 대응하기를 가치 있게 여긴다.
정답과 해설 보기
정답: 2
정답은 ②이다. 애자일 선언은 포괄적인 문서보다 작동하는 소프트웨어에 더 큰 가치를 둔다. 실제로 실행되는 결과를 통해 요구사항을 확인하고 짧은 피드백 주기로 개선하는 데 무게를 두기 때문이다. 나머지 세 항목은 개인과 상호작용, 고객과 협력, 변화에 대응한다는 선언의 가치와 일치한다. 오른쪽 항목에도 가치가 있다는 전제가 있으므로 애자일을 문서·도구·계약·계획을 전혀 사용하지 않는 방식으로 해석하면 안 된다.
선지별 해설
- 개인과 상호작용을 공정과 도구보다 중시한다는 선언의 가치다.
- 선언의 우선순위를 뒤집었다. 작동하는 소프트웨어 쪽에 더 큰 가치를 둔다.
- 고객과 협력하여 실제 요구를 지속해서 확인한다는 가치다.
- 계획을 고수하는 것보다 상황 변화에 대응하는 능력을 중시한다.
편집 해설 근거: Manifesto for Agile Software Development (2001) — 네 가지 가치와 마지막 문장
3. 소프트웨어 설계에서 요구사항 분석에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 필요한 기능과 제약을 분석하여 요구사항 명세를 작성한다.
- 사용자 요구의 범위·우선순위를 정하고 충돌과 모호함을 조정한다.
- 운영 중에 발견되는 오류를 정리하고 수정하는 활동 자체를 뜻한다.
- 개발 초기에 수행하며 요구 변경이나 반복 개발 때 다시 수행할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 요구사항 분석은 이해관계자가 원하는 기능과 제약을 정리하고, 충돌·누락·모호함을 해결하여 개발할 대상의 요구사항을 구체화하는 활동이다. 상세 알고리즘이나 클래스 구조를 확정하는 설계와도 구별한다. 운영 중 발견한 오류를 정리하고 고치는 활동은 유지보수의 일부이므로 요구사항 분석의 정의가 아니다. 다만 분석은 초기 단계에만 한 번 수행하는 것이 아니라 요구 변경이나 반복 개발 과정에서도 다시 수행될 수 있다.
선지별 해설
- 소프트웨어가 제공할 기능과 제약을 명세화하는 활동에 해당한다.
- 사용자 요구의 범위와 우선순위를 정하고 충돌을 조정하는 것은 분석 활동이다.
- 운영 중 오류의 조사와 수정은 유지보수 활동에 해당한다.
- 개발 초기에 시작하되 변경과 반복에 따라 재수행할 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §3 Requirements Analysis; Software Maintenance §1.6 Categories
4. 객체지향 기법에서 상위 클래스의 메소드와 속성을 하위 클래스가 물려받는 것을 의미하는 것은?
- Abstraction
- Polymorphism
- Encapsulation
- Inheritance
정답과 해설 보기
정답: 4
정답은 ④이다. 상속은 기존 클래스와 새 클래스 사이에 상위·하위 관계를 만들고, 언어가 허용하는 속성과 연산을 하위 클래스에서 이어받도록 하는 기법이다. 이를 통해 공통 동작을 재사용하고 필요한 동작을 추가하거나 재정의할 수 있다. 추상화는 핵심 특성의 표현, 캡슐화는 내부 표현과 외부 접근의 경계, 다형성은 같은 인터페이스를 통한 서로 다른 동작에 초점을 둔다. 비공개 멤버에 대한 직접 접근 등 세부 규칙은 언어마다 확인해야 한다.
선지별 해설
- 추상화는 관련 있는 핵심 특성을 뽑아 모델로 표현하는 것이다.
- 다형성은 동일한 연산이나 인터페이스가 대상에 따라 다른 동작을 하는 특성이다.
- 캡슐화는 상태와 동작을 묶고 내부 구현에 대한 접근을 통제하는 것이다.
- 상위 클래스의 구조와 동작을 하위 클래스가 이어받는 관계를 뜻한다.
편집 해설 근거: Python 3 공식 자습서, 9 Classes — §9.5 Inheritance; §9.6 Private Variables
5. 설계 기법 중 하향식 설계 방법과 상향식 설계 방법에 대한 비교 설명으로 가장 옳지 않은 것은?
[학습용 개정문항]
- 하향식에서는 상위 구조와 인터페이스를 먼저 정해 후속 통합의 기준을 마련할 수 있다.
- 하향식에서는 낮은 수준의 자료구조 세부 사항을 후속 단계에서 구체화할 수 있다.
- 상향식에서는 하위 구성 요소를 먼저 설계하고 조합해 상위 기능을 구성한다.
- 상향식에서는 인터페이스를 정하지 않아도 모듈 간 기능 추가가 쉽다.
정답과 해설 보기
정답: 4
정답은 ④이다. 하향식 설계는 시스템의 큰 기능을 정한 뒤 세부 모듈로 분해하고, 상향식 설계는 낮은 수준의 구성 요소를 조합하여 더 큰 기능을 만든다. 어느 쪽이든 구성 요소를 연결하려면 제공 기능, 입력·출력, 호출 규약 등 인터페이스가 필요하다. 따라서 상향식이라는 이유로 인터페이스를 정하지 않아도 기능 추가가 쉬워지는 것은 아니다. 하향식에서 인터페이스를 일찍 정하면 통합에 도움이 되지만 통합이 자동으로 간단해지거나 오류가 사라지는 것은 아니다.
선지별 해설
- 상위 구조와 인터페이스를 먼저 정하면 후속 통합의 기준을 마련할 수 있다.
- 전체 기능에서 세부 사항으로 내려가므로 낮은 수준의 표현을 나중에 구체화할 수 있다.
- 기존 또는 하위 구성 요소를 조합해 상위 기능을 구성하는 방향이다.
- 상향식에서도 모듈을 조합하려면 인터페이스를 정의하고 호환성을 확인해야 한다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §5.1 General Strategies; §5.2 Function-Oriented Design
6. 처리를 원, 자료 저장소를 평행한 두 선으로 표시하는 DFD 표기법에서 요소와 기호의 연결이 옳지 않은 것은?
[학습용 개정문항]
- Process : 원
- Data Flow : 화살표
- Data Store : 삼각형
- Terminator : 사각형
정답과 해설 보기
정답: 3
정답은 ③이다. 이 문항에서 사용하는 자료 흐름도 표기에서는 처리를 원, 자료의 이동을 화살표, 외부 실체를 사각형으로 표현한다. 자료 저장소는 평행한 두 선으로 표시하며 삼각형은 해당 저장소 기호가 아니다. 프로세스는 들어온 자료를 변환하고, 저장소는 자료를 보관하며, 외부 실체는 시스템 경계 밖의 자료 제공자나 수신자를 뜻한다. DFD에는 여러 표기 변형이 있으므로 도형 이름을 판단할 때는 적용하는 표기 체계를 먼저 정해야 한다.
선지별 해설
- 이 문항에 지정한 표기에서 원은 자료 변환을 수행하는 처리다.
- 화살표는 자료가 이동하는 방향을 나타낸다.
- 자료 저장소는 평행한 두 선으로 표시하므로 삼각형이라는 연결은 틀렸다.
- 사각형은 시스템 외부의 자료 제공자 또는 수신자를 뜻한다.
편집 해설 근거: Excel Software, Process Model — Data Flow Diagrams — Data Flow Diagrams; Yourdon/DeMarco DFD
7. 소프트웨어 개발에 이용되는 모델(Model)에 대한 설명 중 거리가 먼 것은?
- 모델은 개발 대상을 추상화하고 기호나 그림 등으로 시각적으로 표현한다.
- 모델을 통해 소프트웨어에 대한 이해도를 향상시킬 수 있다.
- 모델을 통해 이해 당사자 간의 의사소통이 향상된다.
- 모델을 통해 향후 개발될 시스템의 유추는 불가능하다.
정답과 해설 보기
정답: 4
정답은 ④이다. 모델은 복잡한 시스템에서 관심 있는 구조나 동작을 골라 추상화한 표현이다. 아직 구현하지 않은 시스템도 요구사항·설계 모델로 표현하여 구성 요소의 관계나 실행 시나리오를 검토하고, 이해관계자 사이의 해석 차이를 줄일 수 있다. 따라서 향후 시스템의 모습을 유추하는 것이 불가능하다는 설명은 모델링의 목적과 반대다. 다만 모델은 선택한 관점과 가정만 담으므로 실제 시스템의 모든 성질을 완벽하게 예측한다고 보아서는 안 된다.
선지별 해설
- 관심 대상의 핵심 구조나 동작을 추상화하는 것은 모델의 역할이다.
- 불필요한 세부 사항을 덜어내면 구조와 동작을 이해하기 쉽다.
- 공통 표현을 사용하면 개발자와 사용자 사이의 의사소통에 도움이 된다.
- 개발할 시스템을 미리 표현하고 검토하는 데 사용할 수 있으므로 틀린 설명이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Models and Methods §1 Modeling
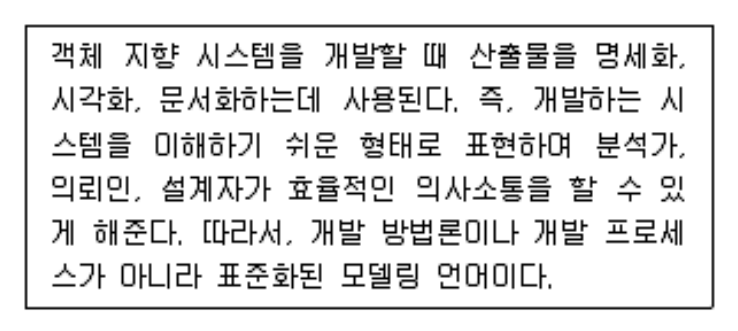
8. 다음의 설명에 해당하는 언어는?
- JAVA
- C
- UML
- Python
정답과 해설 보기
정답: 3
정답은 ③이다. 그림은 개발 산출물을 명세하고 시각화하며 문서화하기 위한 표준 모델링 언어를 설명한다. UML은 클래스와 객체의 관계, 상호작용, 상태 변화 등 여러 관점을 표현하는 공통 표기와 의미를 제공한다. 따라서 특정 실행 프로그램을 작성하는 Java·C·Python보다 지문의 목적에 직접 맞는다. UML은 표현 언어이므로 프로젝트의 단계나 일정을 정하는 개발 방법론 자체는 아니며, 특정 개발 절차에 맞추어 필요한 다이어그램을 사용할 수 있다.
선지별 해설
- Java는 프로그램 구현을 위한 범용 언어로, 그림이 정의한 표준 모델링 언어는 아니다.
- C는 절차와 자료 처리를 구현하는 프로그래밍 언어다.
- UML은 시스템의 구조·동작을 명세하고 시각화하는 표준 모델링 언어다.
- Python은 실행 가능한 프로그램을 만드는 범용 언어다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §1 Scope; Annex A Diagrams
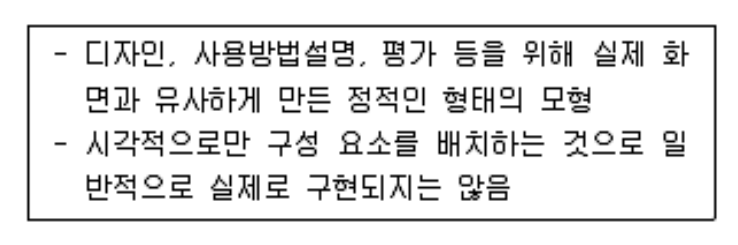
9. 다음 내용이 설명하는 UI설계 도구는?
- 스토리보드(Storyboard)
- 목업(Mockup)
- 프로토타입(Prototype)
- 유스케이스(Usecase)
정답과 해설 보기
정답: 2
정답은 ②이다. 그림의 핵심 조건은 실제 화면과 유사한 외관을 갖추되 화면 구성 요소를 정적으로 배치한다는 점이다. 목업은 색상·글꼴·이미지·배치 등의 시각 설계를 검토하기 위한 모형으로, 버튼 클릭에 따른 실제 처리까지 구현할 필요는 없다. 스토리보드는 장면이나 화면의 흐름을 설명하고, 유스케이스는 사용자 목표와 시스템 상호작용을 기술한다. 프로토타입은 아이디어나 동작을 시험하는 넓은 개념이지만 이 문항은 정적인 시각 모형의 명칭을 묻는다.
선지별 해설
- 스토리보드는 사용 상황과 화면·장면의 진행을 설명하는 데 초점을 둔다.
- 실제 화면과 비슷한 시각 요소를 갖춘 정적인 UI 모형에 해당한다.
- 프로토타입은 아이디어·상호작용·기능 검증을 위한 시제품의 넓은 개념이다.
- 유스케이스는 행위자와 시스템이 목표를 달성하는 상호작용을 기술한다.
편집 해설 근거: Nielsen Norman Group, UX Deliverables: Glossary — Mockup; Prototype; Storyboard 항목
10. 애자일(Agile) 기법 중 스크럼(Scrum)과 관련된 용어에 대한 설명이 틀린 것은?
- 스크럼 마스터(Scrum Master)는 스크럼 프로세스를 따르고, 팀이 스크럼을 효과적으로 활용할 수 있도록 보장하는 역할 등을 맡는다.
- 제품 백로그(Product Backlog)는 스크럼 팀이해결해야 하는 목록으로 소프트웨어 요구사항, 아키텍처 정의 등이 포함될 수 있다.
- 스프린트(Sprint)는 하나의 완성된 최종 결과물을 만들기 위한 주기로 3달 이상의 장기간으로 결정된다.
- 속도(Velocity)는 한 번의 스프린트에서 한 팀이 어느 정도의 제품 백로그를 감당할 수 있는지에 대한 추정치로 볼 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 2020 스크럼 가이드에서 스프린트는 한 달 이하로 정한 고정 길이의 이벤트이며, 끝나면 다음 스프린트가 곧바로 시작된다. 따라서 3개월 이상의 장기간으로 결정한다는 설명은 틀렸다. 스프린트마다 제품 가치를 점검하고 적응할 기회를 확보하는 것이 목적이지 전체 프로젝트를 한 번에 끝내는 기간을 뜻하지 않는다. 스크럼 마스터는 스크럼의 이해와 효과적인 적용을 돕고 제품 백로그는 제품 개선에 필요한 작업 목록이다. Velocity는 실무 추정 지표로 쓰일 수 있지만 가이드가 필수 요소로 규정한 지표는 아니다.
선지별 해설
- 스크럼 마스터는 팀과 조직이 스크럼을 이해하고 효과적으로 활용하도록 돕는다.
- 제품 백로그에는 제품을 개선하기 위해 필요한 다양한 작업이 포함될 수 있다.
- 스프린트의 고정 길이는 한 달 이하이며 3개월 이상이라는 설명이 틀렸다.
- 팀의 작업량 예측에 쓰는 실무 지표지만 스크럼 가이드의 필수 산출물은 아니다.
편집 해설 근거: Schwaber·Sutherland, The Scrum Guide (2020) — Scrum Master; The Sprint; Product Backlog
11. UML 다이어그램 중 정적 다이어그램이 아닌 것은?
- 컴포넌트 다이어그램
- 배치 다이어그램
- 순차 다이어그램
- 패키지 다이어그램
정답과 해설 보기
정답: 3
정답은 ③이다. 순차 다이어그램은 참여 객체의 생명선과 주고받는 메시지를 시간 흐름에 따라 나타내므로 상호작용을 표현하는 동적 다이어그램이다. 반면 컴포넌트 다이어그램은 소프트웨어 구성 요소와 의존 관계를, 배치 다이어그램은 실행 환경과 산출물의 배치를, 패키지 다이어그램은 모델 요소의 묶음과 관계를 나타낸다. 이 세 가지는 구조 다이어그램으로 분류된다. 실행 시점의 장치가 등장하는 배치 다이어그램도 메시지 순서를 기술하는 다이어그램과는 다르다.
선지별 해설
- 컴포넌트의 구성과 의존 관계를 나타내는 구조 다이어그램이다.
- 노드와 산출물의 배치를 나타내는 구조 다이어그램이다.
- 시간에 따른 메시지 교환을 표현하는 상호작용 다이어그램이다.
- 패키지의 구성과 의존 관계를 나타내는 구조 다이어그램이다.
편집 해설 근거: OMG UML 2.5.1 (2017) — Annex A, Figure A.5 Taxonomy of Structure and Behavior Diagrams; §17 Interactions
12. 총 36,000라인의 코드를 6명이 개발한다. 각 프로그래머의 생산성이 월 300라인으로 일정하고 기타 지연이 없다고 가정할 때, LOC 기반 단순 계산으로 구한 개발 기간은?
[학습용 개정문항]
- 5개월
- 10개월
- 15개월
- 20개월
정답과 해설 보기
정답: 4
정답은 ④이다. 한 사람의 월 생산성이 300라인이고 6명이 같은 생산성으로 참여한다면 팀의 월 생산량은 6×300=1,800라인이다. 총 36,000라인을 이 값으로 나누면 36,000÷1,800=20개월이 된다. 먼저 전체 공수를 36,000÷300=120인월로 구하고 이를 6명으로 나누어도 같다. 이는 의사소통 비용이나 대기 시간 없이 생산성이 일정하다고 가정한 단순 산정이며, 실제 프로젝트에서 인원 증가에 따라 기간이 항상 반비례한다는 뜻은 아니다.
선지별 해설
- 5개월이면 9,000라인이므로 제시된 전체 규모에 미달한다.
- 10개월이면 18,000라인이므로 필요한 규모의 절반이다.
- 15개월이면 27,000라인으로 9,000라인이 부족하다.
- 6명×300라인/인월×20개월=36,000라인이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Management §2.3 Effort, Schedule, and Cost Estimation
13. 클래스 설계 원칙에 대한 바른 설명은?
- 단일 책임 원칙 : 하나의 클래스만 변경 가능해야 한다.
- 개방-폐쇄의 원칙 : 클래스는 확장에 대해 열려 있어야 하며 변경에 대해 닫혀 있어야 한다.
- 리스코프 교체의 원칙 : 여러 개의 책임을 가진 클래스는 하나의 책임을 가진 클래스로 대체되어야 한다.
- 의존관계 역전의 원칙 : 클라이언트는 자신이 사용하는 메소드와 의존관계를 갖지 않도록 해야 한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 개방·폐쇄 원칙은 기존 모듈의 안정된 코드를 계속 고치는 대신 새로운 동작을 확장할 수 있게 설계하자는 원칙이다. 단일 책임 원칙은 변경 이유가 다른 책임을 분리하는 것이며 한 클래스만 수정 가능하다는 뜻이 아니다. 리스코프 치환 원칙은 하위 타입이 상위 타입을 기대하는 곳에서 그 계약을 지키며 대체될 수 있어야 한다는 뜻이다. 의존관계 역전은 상위 정책과 하위 구현이 추상화에 의존하도록 하는 원칙으로, 클라이언트가 사용하는 메소드와도 아무 의존을 갖지 말라는 의미가 아니다.
선지별 해설
- 단일 책임은 클래스의 변경 이유를 응집시키는 원칙으로 수정 가능한 클래스 수를 뜻하지 않는다.
- 기능 확장에 열려 있고 기존 코드 수정에는 닫혀 있어야 한다는 OCP의 설명이다.
- 리스코프 치환은 하위 타입의 대체 가능성과 계약 준수에 관한 원칙이다.
- 의존관계 역전은 추상화에 대한 의존을 뜻한다. 사용하지 않는 인터페이스에 의존하지 않게 하는 것은 ISP다.
편집 해설 근거: Robert C. Martin, Solid Relevance (2020-10-18) — SRP; OCP; LSP; ISP; DIP 항목
14. GoF(Gang of Four) 디자인 패턴에서 생성(Creational) 패턴에 해당하는 것은?
- 컴포지트(Composite)
- 어댑터(Adapter)
- 추상 팩토리(Abstract Factory)
- 옵서버(Observer)
정답과 해설 보기
정답: 3
정답은 ③이다. 추상 팩토리는 서로 관련된 객체들을 구체 클래스에 직접 의존하지 않고 한 계열로 생성하도록 하는 생성 패턴이다. 예를 들어 같은 테마의 버튼과 메뉴를 만드는 팩토리를 바꾸면 사용하는 쪽은 추상 인터페이스를 유지할 수 있다. 컴포지트와 어댑터는 객체나 인터페이스의 구조를 구성하는 구조 패턴이고, 옵서버는 대상의 변화에 따른 통지와 협력을 다루는 행위 패턴이다. 분류 기준은 이름이 아니라 패턴이 해결하는 설계 문제다.
선지별 해설
- 컴포지트는 부분과 전체를 트리 구조로 구성하는 구조 패턴이다.
- 어댑터는 호환되지 않는 인터페이스를 연결하는 구조 패턴이다.
- 관련 객체 계열의 생성 방법을 추상화하므로 생성 패턴이다.
- 옵서버는 상태 변화 통지와 의존 객체의 협력을 다루는 행위 패턴이다.
편집 해설 근거: Microsoft MSDN Magazine, Hidden Disposables (2016-11), Abstract Factory — The Abstract Factory Design Pattern; IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §4.4 Design Patterns and Styles
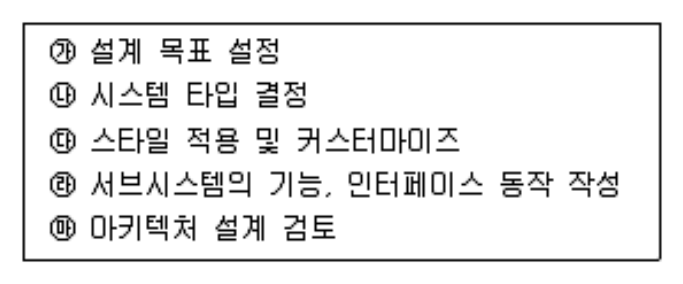
15. 설계 목표와 시스템 유형을 먼저 정하고, 스타일 적용 후 서브시스템을 상세화한 뒤 최종 검토하는 순차 절차를 가정한다. 그림의 활동을 이 절차에 맞게 나열한 것은?
[학습용 개정문항]
- ㉮ → ㉯ → ㉰ → ㉱ → ㉲
- ㉲ → ㉮ → ㉯ → ㉱ → ㉰
- ㉮ → ㉲ → ㉯ → ㉱ → ㉰
- ㉮ → ㉯ → ㉰ → ㉲ → ㉱
정답과 해설 보기
정답: 1
정답은 ①이다. 이 문항이 정한 순차 절차에서는 먼저 설계 목표를 설정하고 그 목표에 맞는 시스템 유형을 결정한다. 다음으로 적절한 아키텍처 스타일을 선택·조정한 뒤 서브시스템의 기능, 인터페이스와 동작을 구체화하고 마지막에 설계 전체를 검토한다. 따라서 그림의 순서는 ㉮→㉯→㉰→㉱→㉲이다. 실제 아키텍처 설계는 검토 결과에 따라 앞 단계로 돌아갈 수 있으므로 이 배열을 모든 프로젝트에 강제되는 일방향 표준 절차라고 외우지 않아야 한다.
선지별 해설
- 목표 설정부터 유형 결정·스타일 적용·상세화·검토까지 주어진 절차와 일치한다.
- 설계 목표와 산출물을 만들기 전에 최종 검토를 배치했다.
- 시스템 유형과 스타일을 정하기 전에 최종 검토를 배치했다.
- 서브시스템의 기능과 인터페이스를 상세화하기 전에 최종 검토를 끝낸다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Architecture §3.2.1 Architecture Analysis; §3.2.2 Architecture Synthesis; §3.2.3 Architecture Evaluation
16. 사용자 인터페이스를 설계할 경우 고려해야 할 가이드라인과 가장 거리가 먼 것은?
- 심미성을 사용성보다 우선하여 설계해야 한다.
- 효율성을 높이게 설계해야 한다.
- 발생하는 오류를 쉽게 수정할 수 있어야 한다.
- 사용자에게 피드백을 제공해야 한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 사용자 인터페이스는 사용자가 목표를 정확하고 효율적으로 달성하도록 돕는 것이 기본 목적이다. 심미성도 사용 경험에 영향을 주지만 그 이유로 글자를 읽기 어렵게 하거나 오류 회복과 피드백을 희생하는 것은 바람직하지 않다. 효율적인 조작, 오류의 이해와 수정, 현재 상태에 대한 피드백은 사용성을 높이는 주요 원칙이다. 보기 ①처럼 심미성을 언제나 사용성보다 우선한다는 일률적 기준은 사용자와 과업의 맥락을 무시하므로 적절하지 않다.
선지별 해설
- 보기 좋다는 이유로 읽기·조작·오류 회복의 용이성을 항상 뒤로 미뤄서는 안 된다.
- 빈번한 작업의 단계와 노력을 줄이면 효율성을 높일 수 있다.
- 오류 원인과 회복 방법을 이해하기 쉽게 제공해야 한다.
- 처리 중인지 완료됐는지 등의 상태를 적절하게 알려야 한다.
편집 해설 근거: Jakob Nielsen, 10 Usability Heuristics for User Interface Design — 1 Visibility of System Status; 7 Flexibility and Efficiency; 8 Aesthetic and Minimalist Design; 9 Error Recovery
17. 소프트웨어 설계에서 자주 발생하는 문제에 대한 일반적이고 반복적 인 해결 방법을 무엇이라고 하는가?
- 모듈 분해
- 디자인 패턴
- 연관 관계
- 클래스 도출
정답과 해설 보기
정답: 2
정답은 ②이다. 디자인 패턴은 반복해서 나타나는 설계 문제와 그 맥락에 적용할 수 있는 해결 구조를 정리한 것이다. 특정 코드 조각을 그대로 복사하는 규칙이 아니라 참여 객체의 역할과 협력, 적용 조건과 결과를 설명하므로 다른 시스템에서도 응용할 수 있다. 모듈 분해와 클래스 도출은 설계 활동이며 연관 관계는 모델 요소 사이의 연결이다. 이들을 포괄하는 모든 설계 작업을 패턴이라고 부르는 것이 아니라 재사용 가능한 문제 해결 지식이라는 점이 핵심이다.
선지별 해설
- 모듈 분해는 시스템을 더 작은 구성 요소로 나누는 활동이다.
- 반복되는 설계 문제에 적용할 수 있는 해결 구조와 경험을 정리한 것이다.
- 연관 관계는 객체나 클래스 사이의 구조적 연결을 표현하는 개념이다.
- 클래스 도출은 모델에서 필요한 클래스와 책임을 찾아내는 활동이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §4.4 Design Patterns and Styles
18. 객체지향 분석 기법의 하나로 객체 모형, 동적 모형, 기능 모형의 3개 모형을 생성하는 방법은?
- Wirfs-Block Method
- Rumbaugh Method
- Booch Method
- Jacobson Method
정답과 해설 보기
정답: 2
정답은 ②이다. 럼바우의 OMT(Object Modeling Technique)는 객체·동적·기능 모형을 함께 사용하여 시스템을 분석한다. 객체 모형은 객체와 관계 등 정적 구조를, 동적 모형은 사건에 따른 상태와 제어 변화를, 기능 모형은 자료 변환과 계산을 표현한다. 서로 다른 관점을 함께 검토해야 구조만으로 놓치기 쉬운 동작을 설명할 수 있다. Wirfs-Brock의 책임 중심 접근, Booch의 객체지향 설계, Jacobson의 유스케이스 중심 접근과 세 모형의 조합을 구별한다.
선지별 해설
- Wirfs-Brock은 객체의 책임과 협력에 초점을 두는 접근으로 알려져 있다.
- OMT의 객체·동적·기능 모형 세 가지와 일치한다.
- Booch의 객체지향 설계 방법을 가리키며 문항의 OMT 세 모형 조합과 다르다.
- Jacobson의 OOSE는 유스케이스 중심 접근이다.
편집 해설 근거: Dov Dori, On Bridging the Analysis–Design and Structure–Behavior Grand Canyons with Object Paradigms (1996), 저자 제공 원문 — 인쇄 p.26, Object Modeling Technique; Object-Oriented Software Engineering; Wirfs-Brock·Wilkerson, Object-Oriented Design: A Responsibility-Driven Approach (1989) — Responsibility-Driven Design
19. 입력 데이터를 컴퓨터의 프로세서가 처리하기 전에 미리 처리하여 프로세서의 처리 시간을 줄이는 프로그램이나 하드웨어는?
- EAI
- FEP
- GPL
- Duplexing
정답과 해설 보기
정답: 2
정답은 ②이다. FEP(Front-End Processor)는 호스트 앞단에서 통신 제어 등 전처리 작업을 맡아 주 처리기의 부담을 줄이는 장치 또는 처리 구성을 뜻한다. 예를 들어 입력 메시지의 전달과 통신 프로토콜 처리를 앞단에서 수행하면 호스트는 주된 업무 처리에 집중할 수 있다. EAI는 여러 업무 애플리케이션의 통합, GPL은 소프트웨어 이용·배포 조건을 정하는 라이선스, 이중화는 장애 대비를 위한 구성이다. 무엇을 앞단에서 처리하는지는 시스템 설계에 따라 달라진다.
선지별 해설
- EAI는 기업 내 여러 애플리케이션을 연결하고 통합하는 접근이다.
- 호스트의 통신·입력 전처리 부담을 앞단에서 맡는 구성에 해당한다.
- GPL은 프로그램 처리 장치가 아니라 자유 소프트웨어 라이선스다.
- Duplexing은 장애 등에 대비해 자원을 중복 구성하는 방식이다.
편집 해설 근거: RFC 1008, Implementation Guide for the ISO Transport Protocol (1987) — §2.4 Front end processor
20. 객체 지향 개념 중 하나 이상의 유사한 객체들을 묶어 공통된 특성을 표현한 데이터 추상화를 의미하는 것은?
- Method
- Class
- Field
- Message
정답과 해설 보기
정답: 2
정답은 ②이다. 클래스는 공통된 구조와 동작을 갖는 객체들을 정의하는 추상적인 틀이다. 같은 클래스의 인스턴스는 정해진 속성과 연산을 공유하지만 각자의 상태 값을 가질 수 있다. 예를 들어 학생 클래스는 이름과 학번 같은 속성 및 수강 신청 같은 동작을 정의하고 실제 학생 객체는 그 틀의 개별 인스턴스가 된다. 메소드는 동작을 구현하는 연산, 필드는 상태를 저장하는 항목, 메시지는 객체 간의 요청이나 상호작용을 뜻하므로 클래스 전체와 구별해야 한다.
선지별 해설
- 메소드는 객체가 제공하는 동작이나 연산을 구현한다.
- 공통된 속성과 동작을 갖는 객체의 형식을 정의하는 추상화다.
- 필드는 객체나 클래스의 상태 값을 저장하는 구성 요소다.
- 메시지는 객체 사이의 호출이나 신호와 같은 상호작용을 나타낸다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §11.4 Classes; §9.5 Properties; §9.6 Operations
정보처리기사 필기 기출문제 · 소프트웨어 개발
21. 클린 코드(Clean Code)를 작성하기 위한 원칙으로 틀린 것은?
[학습용 개정문항]
- 추상화: 사용하는 쪽이 구현 세부를 모두 알아야 하므로 세부 구현을 외부에 전부 공개한다.
- 의존성: 다른 모듈에 미치는 불필요한 영향을 줄인다.
- 가독성: 의도와 흐름을 읽기 쉽게 작성한다.
- 중복성: 같은 규칙의 불필요한 중복을 줄인다.
정답과 해설 보기
정답: 1
정답은 ①이다. 추상화는 사용자가 알아야 할 핵심 개념과 동작을 드러내고 불필요한 구현 세부를 감추어 복잡성을 다루는 방법이다. 따라서 세부 구현을 모두 외부에 공개해야 한다는 설명은 반대다. 읽기 쉬운 이름과 단순한 흐름, 불필요한 의존과 중복의 감소는 변경을 이해하고 검토하기 쉽게 만든다. 다만 중복 제거를 위해 오히려 복잡한 범용 계층을 만들 수 있으므로 줄 수가 적다는 이유만으로 좋은 코드라고 판단하지 않고 이해 가능성과 변경 영향을 함께 살핀다.
선지별 해설
- 추상화는 필요한 동작을 드러내되 불필요한 세부를 숨기는 것이므로 틀렸다.
- 불필요한 모듈 의존을 줄이면 변경의 파급을 제한할 수 있다.
- 명확한 이름과 흐름은 코드를 읽고 검토하기 쉽게 만든다.
- 같은 규칙을 여러 곳에 중복하면 수정 누락이 생기므로 적절히 묶는 것이 좋다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Abstraction; Encapsulation; Google Engineering Practices, What to look for in a code review — Complexity; Naming; Style
22. 단위 테스트에서 테스트의 대상이 되는 하위 모듈을 호출하고, 파라미터를 전달하는 가상의 모듈로 상향식 테스트에 필요한 것은?
- 테스트 스텁(Test Stub)
- 테스트 드라이버(Test Driver)
- 테스트 슈트(Test Suites)
- 테스트 케이스(Test Case)
정답과 해설 보기
정답: 2
정답은 ②이다. 테스트 드라이버는 검사 대상 모듈을 호출하고 필요한 입력을 전달하며 결과를 관찰하는 시험용 호출자다. 상향식 통합에서는 하위 모듈부터 시험하므로 아직 결합하지 않은 상위 호출 부분을 드라이버로 대신할 수 있다. 반대로 스텁은 검사 대상이 호출하는 하위 기능을 대신하여 정해진 응답을 돌려준다. 테스트 슈트는 여러 테스트의 모음이고 테스트 케이스는 입력·실행 조건·예상 결과 등을 정한 개별 시험 단위다. 호출 방향을 보면 드라이버와 스텁을 구별할 수 있다.
선지별 해설
- 스텁은 시험 대상에 의해 호출되는 하위 기능을 대신한다.
- 시험 대상을 호출하고 입력을 주는 상위 역할의 시험용 모듈이다.
- 여러 테스트 케이스나 테스트를 묶은 집합이다.
- 입력 조건과 기대 결과 등을 정의한 개별 시험이다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.4227 test driver; §3.4018 stub
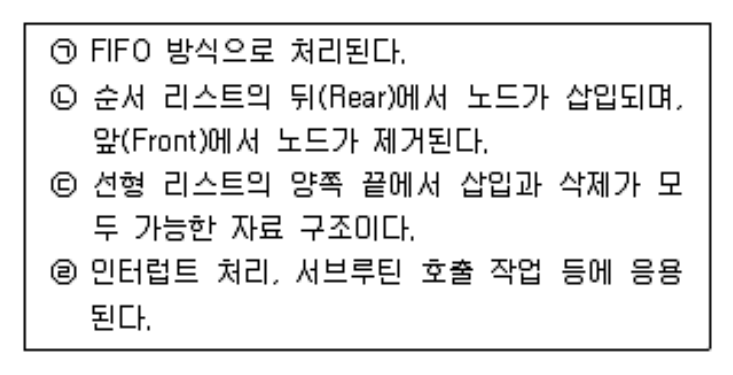
23. 스택(Stack)에 대한 옳은 내용으로만 나열된 것은?
- ㉠, ㉡
- ㉡, ㉢
- ㉣
- ㉠, ㉡, ㉢, ㉣
정답과 해설 보기
정답: 3
정답은 ③이다. 스택은 한쪽 끝인 top에서 삽입과 삭제를 수행하는 후입선출 자료구조다. 따라서 먼저 들어온 것을 먼저 꺼낸다는 ㉠과 뒤에서 넣고 앞에서 뺀다는 ㉡은 큐의 설명이다. 양쪽 끝에서 삽입과 삭제를 모두 허용하는 ㉢은 덱의 설명이다. 함수 호출에서 나중에 호출한 함수가 먼저 복귀하도록 반환 정보를 보관하는 데 스택을 사용할 수 있으므로 ㉣만 옳다. 인터럽트 처리에서도 구현에 따라 복귀 상태의 저장에 스택을 활용한다.
선지별 해설
- ㉠과 ㉡은 FIFO 큐의 특성이므로 스택의 설명이 아니다.
- ㉡은 큐, ㉢은 덱의 설명이다.
- ㉣의 함수 호출·복귀 및 상태 보존 용도는 스택의 LIFO 특성과 맞는다.
- 큐와 덱의 설명까지 포함하므로 옳지 않다.
편집 해설 근거: NIST DADS, stack — stack 정의 — last-in, first-out
24. 소프트웨어 모듈화의 장점이 아닌 것은?
- 오류의 파급 효과를 최소화한다.
- 기능의 분리가 가능하여 인터페이스가 복잡하다.
- 모듈의 재사용 가능으로 개발과 유지 보수가 용이하다.
- 프로그램의 효율적인 관리가 가능하다.
정답과 해설 보기
정답: 2
정답은 ②이다. 모듈화는 시스템을 책임이 구분된 구성 요소로 나누고 서로 정한 인터페이스를 통해 협력하게 하는 설계 방식이다. 경계를 잘 정하면 변경이나 오류의 영향 범위를 줄이고 일부 기능을 재사용하거나 독립적으로 이해하기 쉬워진다. 기능을 분리한 결과 인터페이스가 복잡해졌다면 관리해야 할 비용이지 장점은 아니다. 모듈 수를 늘리는 것만으로 효과가 생기는 것도 아니므로 기능의 응집도와 모듈 사이의 결합도를 함께 고려해야 한다.
선지별 해설
- 잘 정한 모듈 경계는 결함과 수정의 파급 범위를 줄일 수 있다.
- 인터페이스의 복잡성 증가는 모듈화의 장점이 아니라 부담이다.
- 적절한 책임과 인터페이스를 갖춘 모듈은 재사용과 유지보수에 도움이 된다.
- 큰 프로그램을 책임별 단위로 나누면 이해와 관리가 쉬워질 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 — Modularization; Coupling and Cohesion
25. 소프트웨어 프로젝트 관리에 대한 설명으로 가장 옳은 것은?
- 개발에 따른 산출물 관리
- 소요인력은 최대화하되 정책 결정은 신속하게 처리
- 주어진 기간은 연장하되 최소의 비용으로 시스템을 개발
- 주어진 기간 내에 최소의 비용으로 사용자를 만족시키는 시스템을 개발
정답과 해설 보기
정답: 4
정답은 ④이다. 프로젝트 관리는 요구되는 범위와 품질을 충족하는 결과를 일정·비용·자원 등의 제약 안에서 제공하도록 계획하고 조정하는 활동이다. 보기 중 사용자의 필요, 기간과 비용을 함께 고려하는 ④가 가장 포괄적이다. 산출물 관리는 그 일부이지만 프로젝트 관리 전체를 설명하지는 못한다. 인력을 무조건 최대화하거나 기간을 일방적으로 늘리는 것도 목표가 아니다. 여기서 최소 비용은 요구 품질과 계약 조건을 무시한 절감이 아니라 목표를 충족하는 범위에서의 효율적인 자원 사용으로 이해해야 한다.
선지별 해설
- 산출물 관리는 중요한 세부 활동이지만 일정·비용·품질 등의 전체 관리를 포괄하지 못한다.
- 인력은 필요와 제약에 맞게 배치하며 무조건 최대화하지 않는다.
- 일정 연장을 기본 목표로 삼는 것은 프로젝트의 기간 제약과 맞지 않는다.
- 주어진 제약 속에서 사용자의 요구를 충족하는 결과를 제공한다는 목표에 가장 가깝다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Management §2 Software Project Planning; §3 Software Project Enactment
26. 정형 기술 검토(FTR)의 지침으로 틀린 것은?
- 의제를 제한한다.
- 논쟁과 반박을 제한한다.
- 문제 영역을 명확히 표현한다.
- 참가자의 수를 제한하지 않는다.
정답과 해설 보기
정답: 4
정답은 ④이다. 정형 기술 검토는 정해진 산출물에서 결함을 찾아 기록하는 데 집중해야 한다. 이를 위해 검토 범위와 시간을 정하고 적절한 전문성을 가진 참여자를 선정하며 사회자·기록자 등의 역할을 배정한다. 인원을 제한 없이 늘리면 준비 수준을 맞추고 논점을 유지하기 어려우므로 효과적인 검토 운영과 거리가 멀다. 논쟁을 제한한다는 말은 기술적 이견을 금지한다는 뜻이 아니라 인신공격이나 해결책의 장시간 논쟁을 줄이고 결함 식별과 후속 조치를 분리한다는 의미다.
선지별 해설
- 한정된 시간 안에 검토할 의제와 산출물 범위를 정하는 것이 필요하다.
- 결함 식별의 목적을 벗어난 장시간 논쟁이나 인신공격을 제한해야 한다.
- 발견한 문제의 위치와 내용을 구체적으로 기록해야 후속 수정이 가능하다.
- 필요한 역할과 전문성을 고려해 참여 규모를 정해야 하므로 무제한 참여는 적절하지 않다.
편집 해설 근거: NASA Software Engineering Handbook, 7.10 Peer Review and Inspections — §2.1 Planning; §2.4 Inspection Meeting; §2.5 Third Hour
27. 소프트웨어 재공학의 주요 활동 중 기존 소프트웨어 시스템을 새로운 기술 또는 하드웨어 환경에서 사용할 수 있도록 변환하는 작업을 의미하는 것은?
- Analysis
- Migration
- Restructuring
- Reverse Engineering
정답과 해설 보기
정답: 2
정답은 ②이다. 마이그레이션은 기존 애플리케이션이나 데이터를 새로운 운영 환경으로 옮겨 계속 사용할 수 있게 하는 작업이다. 서버·플랫폼·데이터베이스 등이 바뀌면 코드, 구성, 의존성이나 데이터 형식을 조정하고 전환 결과를 검증할 수 있다. 분석은 현재 시스템의 상태와 요구를 이해하는 활동이고, 재구조화는 내부 구조를 정돈하는 활동이며, 역공학은 구현에서 설계·명세 등 더 높은 추상 수준의 정보를 추출한다. 이들 활동이 함께 수행될 수 있어도 환경 전환이라는 문항의 중심 목적은 마이그레이션이다.
선지별 해설
- 분석은 기존 시스템을 이해하고 평가하는 활동이다.
- 기존 소프트웨어를 새로운 플랫폼이나 운영 환경으로 이전하는 활동이다.
- 재구조화는 기능을 유지하면서 내부 표현이나 구조를 개선하는 데 초점을 둔다.
- 역공학은 구현물을 분석해 설계나 명세 등 상위 수준의 정보를 복원하는 활동이다.
편집 해설 근거: AWS, What is Application Migration? (2026-10-05 확인) — What is application migration?; IEEE Computer Society, SWEBOK Guide V4.0a — Software Maintenance §4.2 Reengineering; §4.3 Reverse Engineering
28. 정보 시스템 개발 단계에서 프로그래밍 언어 선택 시 고려할 사항으로 가장 거리가 먼 것은?
- 개발 정보 시스템의 특성
- 사용자의 요구사항
- 컴파일러의 가용성
- 컴파일러의 독창성
정답과 해설 보기
정답: 4
정답은 ④이다. 구현 언어는 시스템의 기능·성능·운영 환경, 개발자의 숙련도, 사용할 라이브러리와 도구의 지원 등을 고려해 선택한다. 컴파일 방식의 언어를 쓴다면 대상 플랫폼에서 신뢰할 수 있는 컴파일러를 사용할 수 있는지도 실질적인 제약이다. 반면 컴파일러가 얼마나 독창적인지는 요구사항의 충족 여부나 운영 적합성을 판단하는 일반적인 선택 기준이 아니다. 새롭거나 특이한 도구라는 이유만으로 유지보수성·표준 준수·지원 가능성이 보장되지는 않는다.
선지별 해설
- 실시간성·처리량·운영 플랫폼 같은 시스템 특성은 언어 선택에 영향을 준다.
- 구현해야 하는 기능과 품질 요구를 충족할 수 있어야 한다.
- 컴파일러와 도구의 지원 여부는 실제 개발·배포 가능성과 연결된다.
- 독창성 자체는 요구를 충족하는 구현 도구인지 판단하는 일반적인 기준이 아니다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Construction §3.2 Construction Languages; §5 Software Construction Tools
29. 소프트웨어 패키징에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 사용자의 설치 환경보다 개발자 개인 환경만 고려하여 진행한다.
- 배포할 코드·자원·의존성을 식별하고 배포 단위로 구성한다.
- 설치 문서와 버전 정보를 관리하여 사용자의 편의를 돕는다.
- 명시한 지원 환경과 설치 방식에 맞는 배포 형식을 선택한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 소프트웨어 패키징은 사용자가 지원 환경에서 프로그램을 설치하고 실행할 수 있도록 코드와 필요한 자원, 의존성 및 배포 정보를 묶는 과정이다. 개발자 개인의 환경에서만 실행되면 충분하다는 관점은 설치 대상과 사용자의 요구를 놓친다. 버전·지원 플랫폼·설치 방법을 명확히 하고 변경 이력과 필요한 문서를 제공해야 배포물을 구별하고 유지보수할 수 있다. 모든 패키지가 상용 제품이거나 모든 운영체제에서 실행되는 것은 아니므로 지원 범위에 맞는 배포 형식을 선택한다.
선지별 해설
- 실제 사용자의 설치·운영 환경을 고려하지 않는다는 점에서 잘못된 설명이다.
- 배포 대상 코드와 자원·의존성을 식별하여 구성하는 활동이다.
- 문서와 버전 정보는 배포물의 식별·설치·유지보수를 돕는다.
- 지원 플랫폼과 설치 방식에 맞는 형식을 선택해야 한다.
편집 해설 근거: Python Packaging User Guide, Packaging Python Projects — Creating the package files; Generating distribution archives; Python Packaging User Guide — Platform compatibility tags — Overview — Python, ABI and platform tags
30. 자료 구조의 분류 중 선형 구조가 아닌 것은?
- 트리
- 리스트
- 스택
- 데크
정답과 해설 보기
정답: 1
정답은 ①이다. 선형 구조는 원소들이 하나의 순서로 이어지는 구조다. 리스트는 원소의 순서를 유지하며 스택은 한쪽 끝에서, 덱은 양쪽 끝에서 삽입과 삭제를 수행하지만 모두 원소가 선형으로 나열된다. 트리는 부모와 자식의 관계로 분기하는 계층 구조여서 하나의 단순한 앞뒤 순서로만 표현되지 않는다. 트리를 배열에 저장하거나 순회 결과를 리스트로 만들 수 있다는 사실과 자료구조 자체의 논리적 분류는 별개다.
선지별 해설
- 부모·자식 관계로 분기하는 계층적 비선형 구조다.
- 원소가 순서를 이루는 대표적인 선형 구조다.
- 삽입·삭제 위치가 top으로 제한된 선형 구조다.
- 양쪽 끝에서 삽입·삭제가 가능한 선형 구조다.
편집 해설 근거: NIST DADS, tree — tree 정의; NIST DADS, stack — stack 정의
31. 과거에 개발되어 현재도 업무 시스템이 의존하지만, 오래된 기술·의존성이나 문서 부족 등으로 변경과 유지보수가 어려울 수 있는 기존 코드를 일반적으로 무엇이라 하는가?
[학습용 개정문항]
- Title Code
- Source Code
- Object Code
- Legacy Code
정답과 해설 보기
정답: 4
정답은 ④이다. 레거시 코드는 과거에 개발되어 현재도 업무나 시스템이 의존하고 있는 기존 코드를 말한다. 오래된 기술과 의존성, 부족한 문서나 담당자의 부재 때문에 이해와 변경이 어려울 수 있지만 오래됐다는 이유만으로 가치가 없거나 반드시 교체해야 하는 것은 아니다. 소스 코드는 사람이 작성한 표현, 목적 코드는 컴파일 결과라는 형식 분류이므로 개발 시기나 유지보수 상황을 직접 뜻하지 않는다. 기존의 모호한 별칭 대신 검증 가능한 레거시 코드의 개념을 묻도록 정리한 문항이다.
선지별 해설
- Title Code는 여기서 설명한 기존 시스템 코드의 일반적인 기술 명칭이 아니다.
- Source Code는 프로그램의 원천 표현을 뜻하며 오래된 코드에 한정되지 않는다.
- Object Code는 번역·컴파일된 결과를 뜻한다.
- 과거에 개발되어 현재 시스템이 계속 의존하는 기존 코드를 뜻한다.
편집 해설 근거: IBM, What is legacy code? (2026-04-06 갱신) — What is legacy code?; Challenges of legacy code
32. 적합성을 검토한 기존 소프트웨어와 관련 문서를 재사용할 때 기대하는 직접적인 효과와 가장 거리가 먼 것은?
[학습용 개정문항]
- 반복 구현을 줄여 생산성을 높일 수 있다.
- 기존 설계·사용 문서를 함께 활용할 수 있다.
- 검증된 구성 요소를 활용해 품질을 높일 수 있다.
- 새로운 개발 방법론의 성공적인 도입이 자동으로 보장된다.
정답과 해설 보기
정답: 4
정답은 ④이다. 검증된 소프트웨어 자산을 재사용하면 같은 기능을 다시 구현하는 노력을 줄이고 기존 시험·설계 경험을 활용할 수 있다. 함께 관리된 문서도 재사용 대상을 이해하는 데 도움이 된다. 그러나 재사용이 새로운 개발 방법론의 도입을 저절로 보장하지는 않는다. 재사용하려는 자산의 인터페이스, 품질, 라이선스, 적용 환경을 검토하고 필요한 적응 작업을 해야 하며 이 비용이 이익보다 클 수도 있다. 생산성과 품질 개선 역시 적절한 대상을 선택했을 때 기대하는 효과다.
선지별 해설
- 반복 구현을 줄일 수 있어 생산성 향상을 기대할 수 있다.
- 관리된 설계·사용 문서를 함께 활용하면 이해와 적용에 도움이 된다.
- 이미 검증된 기능을 적절히 활용하면 품질 향상을 기대할 수 있다.
- 자산 재사용만으로 개발 방법론 전환의 성공이 보장되는 것은 아니다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Construction §1.4 Reusing Assets; §3.5 Reuse in Construction
33. 인터페이스 간의 통신을 위해 이용되는 데이터 포맷이 아닌 것은?
- AJTML
- JSON
- XML
- YAML
정답과 해설 보기
정답: 1
정답은 ①이다. JSON은 객체·배열·문자열·숫자 등의 구조를 표현하는 텍스트 교환 형식이며, XML은 요소와 속성으로 구조화된 문서를 표현한다. YAML도 사람이 읽기 쉬운 데이터 직렬화 언어로 설정과 자료 교환에 쓰인다. AJTML은 나머지 세 형식처럼 이 문항에서 식별할 수 있는 표준 데이터 형식의 이름이 아니다. 통신에서는 HTTP 같은 전달 프로토콜과 JSON·XML 같은 내용의 표현 형식을 구별해야 하며, 실제 교환 시에는 양쪽이 같은 스키마와 인코딩을 이해해야 한다.
선지별 해설
- 문항에서 표준 자료 형식으로 제시된 JSON·XML·YAML과 달리 해당 명칭의 형식 정의가 없다.
- RFC 8259에서 정의한 텍스트 기반 데이터 교환 형식이다.
- W3C가 정의한 구조화 문서 표현 언어다.
- 매핑·시퀀스·스칼라 등의 구조를 표현하는 데이터 직렬화 언어다.
편집 해설 근거: IETF RFC 8259 — JSON — §1 Introduction; §2 JSON Grammar; W3C Recommendation — XML 1.0 — §1 Introduction; YAML 1.2.2 specification — §1.1 Goals; §2.1 Collections
34. 프로그램 설계도의 하나인 NS Chart에 대한 설명으로 가장 거리가 먼 것은?
- 논리의 기술에 중점을 두고 도형을 이용한 표현 방법이다.
- 이해하기 쉽고 코드 변환이용이하다.
- 화살표나 GOTO를 사용하여 이해하기 쉽다.
- 연속, 선택, 반복 등의 제어 논리 구조를 표현한다.
정답과 해설 보기
정답: 3
정답은 ③이다. Nassi–Shneiderman 차트는 순차 실행, 선택, 반복을 중첩된 블록으로 표현하여 프로그램의 제어 구조가 도형의 포함 관계에 드러나게 한다. 임의의 위치로 이동하는 GOTO나 복잡한 화살표 연결에 의존하는 흐름도와 달리 구조화된 제어 흐름을 표현하려는 기법이다. 따라서 화살표와 GOTO를 사용한다는 설명은 핵심 취지와 맞지 않는다. 블록의 경계를 프로그램의 if·반복문 등에 대응시킬 수 있지만 차트를 그렸다는 사실만으로 알고리즘의 정확성이 보장되지는 않는다.
선지별 해설
- 도형 안에 논리를 구조적으로 배치하는 표현 기법이다.
- 중첩 블록을 구조화된 제어문에 대응시키기 쉽다.
- 임의 이동을 나타내는 GOTO·화살표에 의존한다는 설명은 NS 차트의 취지와 반대다.
- 순차·선택·반복 제어 구조를 블록으로 표현한다.
편집 해설 근거: Nassi·Shneiderman, Flowchart techniques for structured programming (1973), 저자 제공 원문 — Flowchart Techniques for Structured Programming, 본문 및 제어구조 도식
35. 입력 자료 A, B, C, D에 다음 스택 연산을 순서대로 수행할 때 pop되는 자료의 순서는?
push → push → pop → push → push → pop → pop → pop
- BDCA
- ABCD
- BACD
- ABDC
정답과 해설 보기
정답: 1
정답은 ①이다. 빈 스택에 입력을 A부터 순서대로 넣으면 처음 두 push 뒤에는 A, B가 있고 첫 pop은 top의 B를 꺼낸다. 다음으로 C와 D를 넣으면 스택은 아래부터 A, C, D가 된다. 이어지는 세 pop은 D, C, A를 차례로 꺼내므로 전체 출력 순서는 B-D-C-A다. push는 다음 입력 하나를 맨 위에 추가하고 pop은 현재 맨 위 하나를 제거한다는 규칙을 각 연산마다 적용해야 하며, 처음 입력한 순서 그대로 꺼내는 큐와 혼동하면 안 된다.
선지별 해설
- 각 pop의 결과가 B, D, C, A이므로 맞다.
- 입력 순서대로 꺼내는 FIFO 방식으로 잘못 판단했다.
- 두 번째 pop 시점에는 C보다 나중에 넣은 D가 위에 있다.
- 첫 번째 pop부터 B를 꺼내므로 A로 시작하는 배열은 틀렸다.
편집 해설 근거: NIST DADS, stack — stack — push, pop, last-in first-out
36. 피벗을 정하고 나머지 각 원소를 피벗과 한 번씩 비교하여 분할한 뒤 재귀적으로 정렬한다. 서로 다른 n개 원소에서 매번 한쪽 부분이 비게 되면 총 n(n−1)/2번 비교하는 이 정렬 알고리즘은?
[학습용 개정문항]
- Selection Sort
- Bubble Sort
- Insert Sort
- Quick Sort
정답과 해설 보기
정답: 4
정답은 ④이다. 퀵 정렬은 피벗을 기준으로 자료를 분할한 뒤 각 부분을 재귀적으로 정렬하는 분할 정복 알고리즘이다. 매 단계에서 피벗이 최솟값이나 최댓값으로 정해져 나머지 n−1개가 한쪽에 남으면 분할이 극단적으로 불균형해진다. 문항의 비교 모형에서 총 비교 횟수는 (n−1)+(n−2)+…+1=n(n−1)/2로 이차적으로 증가한다. 선택 정렬도 이와 같은 비교 횟수가 나올 수 있지만 피벗을 사용해 재귀적으로 분할한다는 조건이 퀵 정렬을 구별한다.
선지별 해설
- 선택 정렬은 남은 구간의 최소 원소를 찾아 위치를 정하며 피벗 분할을 하지 않는다.
- 버블 정렬은 인접 원소를 비교·교환한다.
- 삽입 정렬은 이미 정렬된 부분에 다음 원소를 삽입한다.
- 피벗으로 분할하며 극단적인 불균형 분할에서 이차 비교 비용이 발생한다.
편집 해설 근거: NIST DADS, quicksort — quicksort — definition and performance
37. 화이트 박스 검사 기법에 해당하는 것으로만 짝지어진 것 은?
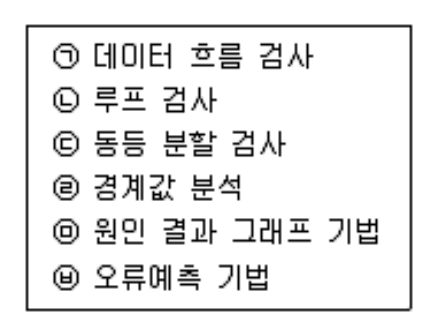
- ㉠, ㉡
- ㉠, ㉣
- ㉡, ㉤
- ㉢, ㉥
정답과 해설 보기
정답: 1
정답은 ①이다. 화이트박스 시험은 코드의 내부 구조를 기준으로 시험 조건을 정한다. 자료 흐름 검사는 변수의 정의와 사용 관계를, 루프 검사는 반복문의 실행 횟수와 경로를 살피므로 ㉠과 ㉡이 해당한다. 동등 분할·경계값 분석·원인 결과 그래프는 명세와 입출력 관계를 이용하는 기법으로 구별한다. 오류 예측은 경험한 결함 유형과 직관을 활용하는 경험 기반 기법이며, 이름에 오류가 들어간다고 화이트박스가 되는 것은 아니다.
선지별 해설
- 변수의 정의·사용과 반복문의 내부 구조를 검사하므로 둘 다 화이트박스 기법이다.
- ㉠은 화이트박스지만 ㉣ 경계값 분석은 입력 영역의 경계를 이용한다.
- ㉡은 화이트박스지만 ㉤ 원인 결과 그래프는 입출력 논리 관계를 이용한다.
- ㉢은 명세 기반, ㉥은 경험 기반 기법으로 내부 구조 검사만의 조합이 아니다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §4.1 Categories of Test Techniques; §4.2 Black-box Techniques; §4.3 White-box Techniques; §4.4.1 Error Guessing; IEEE Computer Society, SWEBOK Guide V4.0a — Software Testing §3.2 Structure-Based Test Techniques; §3.2.1 Control Flow Testing; §3.2.2 Data Flow Testing
38. 2022년 시험 당시의 SQuaRE 체계와 ISO/IEC 25010:2011을 기준으로 옳지 않은 설명은?
[학습용 개정문항]
- SQuaRE는 시스템·소프트웨어 품질 요구사항과 평가를 다루는 표준 체계다.
- SQuaRE는 Systems and software Quality Requirements and Evaluation의 약칭이다.
- ISO/IEC 25010:2011은 품질 모델 대신 내부·외부·사용 품질 측정과 측정 요소를 주된 내용으로 규정한다.
- ISO/IEC 25000은 기존 ISO/IEC 9126 및 14598 계열에서 SQuaRE로 전환하는 관계를 안내한다.
정답과 해설 보기
정답: 3
정답은 ③이다. SQuaRE는 시스템·소프트웨어의 품질 요구사항과 평가를 다루는 표준 체계이며, 품질 모델과 측정 체계의 역할을 구별해야 한다. 2022년 당시의 ISO/IEC 25010:2011은 제품 품질 모델과 사용 품질 모델을 정의한다. 품질 측정의 참조 모형·측정 선택 및 적용은 ISO/IEC 25020 등 2502n 계열의 영역이므로 이를 25010의 주된 내용이라고 설명한 ③이 틀렸다. 현행판과 구판의 품질 특성 구성이 달라질 수 있어 이 문항은 판 번호를 고정해 판단한다.
선지별 해설
- SQuaRE는 품질 요구사항과 평가를 위한 여러 표준으로 구성된다.
- Systems and software Quality Requirements and Evaluation의 약칭이다.
- 25010:2011의 중심은 품질 모델이며 측정 체계는 25020 등에서 다룬다.
- 기존 9126 및 14598 계열에서 SQuaRE 체계로 전환된 관계를 설명한다.
편집 해설 근거: ISO/IEC 25000:2014, Guide to SQuaRE, ISO 공식 개요 — Abstract — SQuaRE series and transition from ISO/IEC 9126 and 14598; ISO/IEC 25010:2011, Software quality model (문항에 명시한 구판) — §1 Scope; ISO/IEC 25020:2019, Quality measurement framework, ISO 공식 개요 — Abstract — quality measurement framework
39. 코드 인스펙션(Code Inspection)과 관련한 설명으로 틀린 것은?
- 프로그램을 수행시켜보는 것 대신에 읽어보고 눈으로 확인하는 방법으로 볼 수 있다.
- 코드 품질 향상 기법 중 하나이다.
- 동적 테스트 시에만 활용하는 기법이다.
- 결함과 함께 코딩 표준 준수 여부, 효율성 등의 다른 품질 이슈를 검사하기도 한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 코드 인스펙션은 프로그램을 실행하여 결과를 관찰하는 동적 시험과 달리, 소스 코드를 검토하여 결함과 품질 문제를 찾는 정적 검토 기법이다. 요구와의 불일치, 잘못된 조건, 코딩 규약 위반, 이해하기 어려운 구조 등을 실행 전에 발견하는 데 도움이 된다. 따라서 동적 테스트 때에만 활용한다는 제한은 틀렸다. 인스펙션과 동적 시험은 서로 다른 종류의 결함을 찾을 수 있으므로 한쪽이 다른 쪽을 완전히 대신하는 것이 아니라 함께 활용한다.
선지별 해설
- 코드를 실행하지 않고 읽고 분석하는 정적 검토라는 설명이다.
- 결함을 조기에 발견하고 유지보수성을 검토하는 품질 활동이다.
- 인스펙션은 정적 검토이며 동적 실행 시험에만 한정되지 않는다.
- 기능 오류 외에도 코딩 표준과 복잡성 등 품질 문제를 검토할 수 있다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §3.1 Static Testing Basics; §3.2 Review Process; Google Engineering Practices, What to look for in a code review — Design; Functionality; Complexity; Style
40. 프로젝트에 내재된 위험 요소를 식별하고 영향을 분석하여 사전에 예측·대비하는 관리 활동은?
- Critical Path Method
- Risk Analysis
- Work Breakdown Structure
- Waterfall Model
정답과 해설 보기
정답: 2
정답은 ②이다. 위험 분석은 발생할 수 있는 부정적 사건과 그 원인, 발생 가능성 및 영향을 검토해 대응 우선순위를 정하는 활동이다. 프로젝트에서는 기술적 불확실성, 인력·일정·비용 문제 등을 미리 식별하고 회피·완화·수용 등의 대응을 준비하는 데 활용한다. CPM은 일정 네트워크의 임계 경로 분석, WBS는 작업의 계층적 분해, 폭포수 모형은 개발 활동을 단계로 구성하는 생명주기 모형이다. 이 도구들이 위험 관리에 도움을 줄 수 있어도 문항이 직접 설명한 활동명은 위험 분석이다.
선지별 해설
- CPM은 작업 의존 관계와 기간으로 전체 일정을 좌우하는 경로를 찾는다.
- 위험 요소를 식별하고 가능성과 영향을 분석하여 대비하는 활동에 해당한다.
- WBS는 프로젝트 범위를 수행 가능한 작업 단위로 나누는 구조다.
- 폭포수 모형은 요구·설계·구현·시험 등의 개발 단계를 구성하는 모형이다.
편집 해설 근거: NIST SP 800-30 Rev.1 (2012) — §3.2 Conduct the Assessment — threats, vulnerabilities, likelihood and impact; CMU Software Engineering Institute, Continuous Risk Management Guidebook (1996) — Identify; Analyze; Plan; Track; Control
정보처리기사 필기 기출문제 · 데이터베이스 구축
41. 물리적 저장 구조와 접근 경로를 정하는 데이터베이스 설계에서 직접적인 물리 설계 지표·활동에 해당하지 않는 것은?
[학습용 개정문항]
- 함수 종속성에 따라 릴레이션을 정규화하는 논리적 설계
- 질의 응답 시간 검토
- 저장 공간 사용량의 효율화
- 트랜잭션 처리량 검토
정답과 해설 보기
정답: 1
정답은 ①이다. 물리적 설계에서는 예상되는 질의와 갱신 작업을 고려하여 파일 구성, 인덱스, 접근 경로, 저장 배치 등을 선택한다. 이 선택은 질의 응답 시간, 단위 시간당 처리량과 필요한 저장 공간에 영향을 준다. 반면 함수 종속성을 이용해 릴레이션을 정규화하는 활동 자체는 논리적 스키마 설계에 해당한다. 성능 검토 결과 논리 스키마를 다시 조정할 수는 있지만 그러한 반복 가능성과 물리적 저장 구조를 직접 결정하는 활동의 구분은 별개다.
선지별 해설
- 릴레이션 정규화는 논리적 구조와 종속성의 설계 활동이다.
- 사용자의 요청이 얼마나 빨리 완료되는지는 물리 설계의 주요 성능 지표다.
- 인덱스와 파일 배치는 저장 공간의 사용량에 영향을 준다.
- 인덱스와 접근 경로는 단위 시간당 트랜잭션 처리 성능에 영향을 준다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Physical Database Design — Overview; Understanding the Workload; Decisions to Make; Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — Functional Dependencies; Decomposition
42. DELETE 명령에 대한 설명으로 틀린 것은?
- 테이블의 행을 삭제할 때 사용한다.
- WHERE 조건절이 없는 DELETE 명령을 수행하면 DROP TABLE 명령을 수행했을 때와 동일한 효과를 얻을 수 있다.
- SQL을 사용 용도에 따라 분류할 경우 DML에 해당한다.
- 기본 사용 형식은 DELETE FROM 테이블 [WHERE 조건];이다.
정답과 해설 보기
정답: 2
정답은 ②이다. DELETE는 지정한 테이블에서 조건에 맞는 행을 삭제하는 데이터 조작 명령이다. WHERE가 없으면 삭제 대상은 전체 행이지만 테이블의 이름·열·제약 등 정의는 남아 있어 이후 다시 행을 넣을 수 있다. DROP TABLE은 테이블 객체 자체를 제거하므로 같은 효과가 아니다. 또한 DELETE의 실제 결과는 권한·참조 무결성·트리거 같은 조건의 영향을 받을 수 있다. 여기서는 정상적으로 명령이 수행되는 경우에도 테이블 정의가 남는지 사라지는지가 핵심 차이다.
선지별 해설
- DELETE는 테이블에서 행을 제거하는 명령이다.
- 전체 행 삭제와 테이블 객체 삭제는 정의의 보존 여부가 다르다.
- 행을 삽입·수정·삭제하는 DML 명령에 해당한다.
- 대상 테이블 뒤에 필요하면 WHERE 조건을 붙이는 기본 형식이다.
편집 해설 근거: PostgreSQL 18: DELETE — Description; Synopsis; PostgreSQL 18: DROP TABLE — Description
43. 릴레이션에 성립하는 모든 비자명한 조인 종속성이 후보키 제약에서 유도되어야 한다고 정의하는 정규형은?
[학습용 개정문항]
- 제5정규형
- 제4정규형
- 제3정규형
- 제1정규형
정답과 해설 보기
정답: 1
정답은 ①이다. 제5정규형은 조인 종속성을 다루는 정규형으로 투영·조인 정규형(PJNF)이라고도 한다. 릴레이션을 여러 투영으로 분해했다가 조인하여 정확히 원래 관계를 복원할 수 있는 제약이 조인 종속성이며, 5NF에서는 성립하는 비자명한 조인 종속성이 후보키 제약에서 유도되어야 한다. 제4정규형은 비자명한 다치 종속성을 중심으로 다루고 제3정규형은 함수 종속성의 제한을 다룬다. 단순히 여러 테이블을 조인할 수 있다는 사실만으로 5NF라고 판단하지는 않는다.
선지별 해설
- 후보키 제약으로 설명되는 비자명한 조인 종속성이라는 조건은 5NF에 해당한다.
- 4NF는 비자명한 다치 종속성의 결정자가 슈퍼키인지 다룬다.
- 3NF는 함수 종속성과 결정자·주요 속성 조건으로 정의한다.
- 1NF는 관계 모형의 속성 값에 대한 기본 구조 조건이며 조인 종속성의 기준이 아니다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts, 온라인 Chapter 28 — §28.2.2 Project-Join Normal Form
44. E-R 모델에서 다중값 속성의 표기법은?
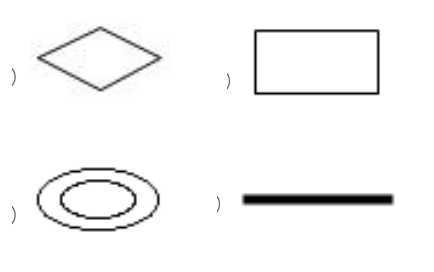
- 마름모(관계)
- 사각형(개체)
- 이중 타원(다중값 속성)
- 선(연결)
정답과 해설 보기
정답: 3
정답은 ③이다. 개체를 사각형, 관계를 마름모, 속성을 타원으로 표현하는 E-R 표기에서 다중값 속성은 이중 타원으로 구별한다. 예를 들어 한 사람에게 여러 전화번호를 기록할 수 있다면 전화번호는 다중값 속성으로 모델링할 수 있다. 이중 타원은 값이 여러 개일 수 있음을 뜻하며 그 자체가 기본키나 개체 간 관계를 뜻하지 않는다. ER 표기법에는 여러 변형이 있으므로 이 문항에서는 그림에 제시한 도형 체계를 기준으로 읽는다.
선지별 해설
- 마름모는 개체 사이의 관계를 나타낸다.
- 사각형은 개체 유형을 나타낸다.
- 이중 타원은 한 개체가 여러 값을 가질 수 있는 속성의 표시다.
- 연결선은 개체·관계·속성의 연결을 나타내며 다중값 속성 자체의 기호가 아니다.
편집 해설 근거: University of Kentucky, Conceptual Design/Data Modeling 강의 자료 — Basic E-R notation (Fig. 3-2) — Multi-valued attribute
45. 다른 릴레이션의 기본키 또는 후보키를 참조하여 릴레이션 사이의 참조 무결성을 설정하는 키는?
- 기본키
- 슈퍼키
- 외래키
- 후보키
정답과 해설 보기
정답: 3
정답은 ③이다. 외래키는 한 테이블의 열 또는 열 묶음이 참조 대상 테이블의 키 값과 대응하도록 하는 제약이다. 이를 통해 존재하지 않는 대상을 참조하는 행을 제한하여 참조 무결성을 유지한다. 기본키는 후보키 중 대표 식별자로 선택한 키이고, 후보키는 최소성을 가진 유일한 식별자이며, 슈퍼키는 최소성을 요구하지 않는 유일한 식별자다. 외래키 값의 중복은 허용될 수 있고 NULL 허용 여부나 삭제·갱신 때의 처리는 정의된 제약에 따라 달라진다.
선지별 해설
- 기본키는 해당 릴레이션의 대표 행 식별자다.
- 슈퍼키는 행을 유일하게 구별할 수 있는 속성 집합이다.
- 참조 대상의 키와 대응 관계를 유지하는 제약이다.
- 후보키는 유일성과 최소성을 만족하는 식별자다.
편집 해설 근거: PostgreSQL 18 — Constraints — §5.5.4 Primary Keys; §5.5.5 Foreign Keys
46. 관계해석에서 '모든 것에 대하여'의 의미를 나타내는 논리 기호는?
- ∃
- ∈
- ∀
- ⊂
정답과 해설 보기
정답: 3
정답은 ③이다. 보편 양화사 ∀는 변수의 가능한 모든 값에 대하여 뒤의 조건이 성립한다는 뜻이다. 반대로 존재 양화사 ∃는 조건을 만족하는 값이 하나 이상 존재한다는 뜻이다. 예를 들어 모든 학생이 어떤 조건을 만족해야 한다는 서술에는 ∀를 사용하고, 조건을 만족하는 학생이 적어도 한 명 있다는 서술에는 ∃를 사용한다. ∈는 집합의 원소 관계, ⊂는 부분집합 관계를 나타내므로 양화사와 역할이 다르다. 기호의 모양보다 대상의 범위를 구별해야 한다.
선지별 해설
- ∃는 조건을 만족하는 대상이 존재함을 나타내는 존재 양화사다.
- ∈는 어떤 값이 집합의 원소임을 나타낸다.
- ∀는 모든 대상에 대해 조건이 성립함을 나타내는 보편 양화사다.
- ⊂는 집합 사이의 포함 관계를 나타낸다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Calculus — Domain Relational Calculus — formulas and quantifiers
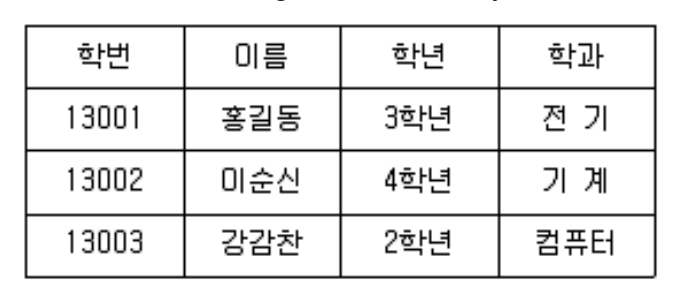
47. 다음 릴레이션의 Degree와 Cardinality는?
- Degree : 4, Cardinality : 3
- Degree : 3, Cardinality : 4
- Degree : 3, Cardinality : 12
- Degree : 12, Cardinality : 3
정답과 해설 보기
정답: 1
정답은 ①이다. 릴레이션의 차수(Degree)는 속성의 수이고 카디널리티(Cardinality)는 튜플의 수다. 그림의 열은 학번·이름·학년·학과의 네 개이므로 차수는 4다. 실제 학생 자료는 학번 13001·13002·13003의 세 행이므로 카디널리티는 3이다. 맨 위의 열 이름 행은 스키마를 설명하는 머리글이므로 튜플 수에 포함하지 않는다. 4×3=12는 표의 자료 칸 수이며 차수나 카디널리티 어느 쪽도 아니다.
선지별 해설
- 속성 네 개, 자료 행 세 개이므로 차수 4와 카디널리티 3이다.
- 열 수와 행 수를 서로 바꾸어 적었다.
- 행 수와 전체 자료 칸 수를 차수·카디널리티로 혼동했다.
- 전체 자료 칸 12개는 속성의 개수가 아니다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relational Database: Definitions; Example Instance of Students Relation
48. 뷰(View)에 대한 설명으로 틀린 것은?
- 뷰 위에 또 다른 뷰를 정의할 수 있다.
- DBA는 보안성 측면에서 뷰를 활용할 수 있다.
- 사용자가 필요한 정보를 요구에 맞게 가공하여 뷰로 만들 수 있다.
- SQL을 사용하면 뷰에 대한 삽입, 갱신, 삭제 연산 시 제약 사항이 없다.
정답과 해설 보기
정답: 4
정답은 ④이다. 뷰는 질의 결과를 테이블처럼 사용할 수 있게 정의한 것으로, 다른 뷰를 참조하거나 사용자에게 필요한 열과 행을 제한해 보여줄 수 있다. 그러나 모든 뷰가 자유롭게 갱신 가능한 것은 아니다. 집계·그룹화·집합 연산 등을 포함한 뷰는 한 결과 행을 원본의 어떤 행으로 되돌려 반영할지 정하기 어려워 자동 갱신에 제약이 있다. 단순 뷰도 기본 테이블의 제약과 권한 등을 따라야 한다. 뷰를 통한 보안은 적절한 권한 설정과 함께 설계해야 한다.
선지별 해설
- 기존 뷰를 참조하여 새 뷰를 정의할 수 있다.
- 행·열의 노출과 권한을 설계해 접근 범위를 제한하는 데 활용할 수 있다.
- 필요한 질의 결과를 이름 있는 뷰로 제공할 수 있다.
- 뷰의 정의와 원본 제약에 따라 삽입·갱신·삭제가 제한될 수 있다.
편집 해설 근거: PostgreSQL 18 — CREATE VIEW — Description; Updatable Views; Notes
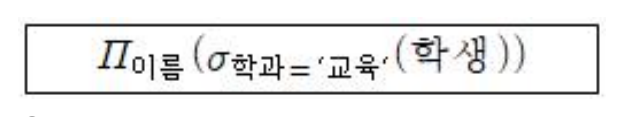
49. 관계 대수식을 SQL 질의로 옳게 표현한 것은?
[학습용 개정문항]
- SELECT 학생 FROM 이름 WHERE 학과='교육';
- SELECT DISTINCT 이름 FROM 학생 WHERE 학과='교육';
- SELECT 교육 FROM 학과 WHERE 이름='학생';
- SELECT 학과 FROM 학생 WHERE 이름='교육';
정답과 해설 보기
정답: 2
정답은 ②이다. 그림의 안쪽 선택 연산 σ는 학생 릴레이션에서 학과가 교육인 행을 고르고, 바깥쪽 투영 연산 π는 그 결과에서 이름 속성만 남긴다. SQL로는 학생을 FROM에, 행의 조건을 WHERE에, 출력할 이름을 SELECT에 둔다. 관계 대수의 투영은 집합 의미로 중복을 제거하므로 같은 이름을 가진 학생이 여러 명 있을 가능성까지 맞추려면 SELECT DISTINCT가 필요하다. 일반 SELECT는 중복 행을 남길 수 있어 완전히 같은 의미라고 단정하지 않아야 한다.
선지별 해설
- SELECT에는 열, FROM에는 테이블이 와야 하는데 두 역할을 뒤바꾸었다.
- 학생 중 학과가 교육인 행을 고르고 이름의 중복을 제거한다.
- 테이블·열·조건의 역할이 주어진 관계 대수식과 맞지 않는다.
- 이름이 교육인 행의 학과를 출력하므로 조건과 결과 열이 바뀌었다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — Selection; Projection; PostgreSQL 18 — SELECT — SELECT List; DISTINCT Clause
50. 2NF인 릴레이션에서 A는 후보키, B와 C는 서로 다른 비주요 속성이고 B는 슈퍼키가 아니다. A→B, B→C에 따른 비주요 속성의 이행 종속을 제거해 다음 정규형을 만족시키는 단계는?
[학습용 개정문항]
- 1NF → 2NF
- 2NF → 3NF
- 3NF → BCNF
- BCNF → 4NF
정답과 해설 보기
정답: 2
정답은 ②이다. 2NF인 릴레이션에서 후보키 A가 비주요 속성 B를 결정하고, 슈퍼키가 아닌 B가 다른 비주요 속성 C를 결정한다면 C가 키 A에 이행적으로 종속된다. 이 구조는 B와 C의 대응 사실이 여러 행에 반복되어 수정 이상을 일으킬 수 있다. 이를 분리하여 3NF 조건을 만족시키는 과정이 2NF에서 3NF로의 정규화다. 다만 A→B와 B→C가 있다는 사실만으로 언제나 3NF 위반이라고 할 수는 없어, 결정자의 슈퍼키 여부와 종속 속성의 주요 속성 여부를 함께 확인해야 한다.
선지별 해설
- 1NF에서 2NF로 갈 때는 후보키의 일부에 대한 비주요 속성의 부분 종속을 다룬다.
- 제시한 비키 속성을 거치는 이행 종속을 제거해 3NF 조건을 만족시키는 단계다.
- BCNF는 모든 비자명한 함수 종속의 결정자가 슈퍼키인지 더 엄격하게 요구한다.
- 4NF는 비자명한 다치 종속성을 다루는 단계다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — Third Normal Form; 3NF Example; Decomposition
51. CREATE TABLE문에 포함되지 않는 기능은?
- 속성 타입 변경
- 속성의 NOT NULL 여부 지정
- 기본키를 구성하는 속성 지정
- CHECK 제약조건의 정의
정답과 해설 보기
정답: 1
정답은 ①이다. CREATE TABLE은 새 테이블을 만들면서 각 열의 자료형과 NULL 허용 여부, 기본키와 CHECK 같은 제약을 정의하는 명령이다. 새 열의 자료형을 지정하는 것과 이미 존재하는 테이블의 열 자료형을 변경하는 것은 다르다. 기존 열의 형식을 바꾸는 작업은 ALTER TABLE의 자료형 변경 기능을 사용한다. 변경 과정에서는 기존 값의 변환 가능성과 인덱스·제약 등 관련 객체의 영향을 확인해야 한다. 따라서 CREATE TABLE의 기능이 아닌 것은 기존 속성 타입의 변경이다.
선지별 해설
- 기존 열의 자료형 변경은 ALTER TABLE의 역할이다.
- 새 테이블의 열에 NOT NULL 제약을 지정할 수 있다.
- 하나 또는 여러 열을 기본키로 지정할 수 있다.
- 허용 값에 대한 CHECK 조건을 정의할 수 있다.
편집 해설 근거: PostgreSQL 18: Data Definition — §5.1 Table Basics; §5.5 Constraints; PostgreSQL 18, ALTER TABLE — SET DATA TYPE
52. SQL과 관련한 설명으로 틀린 것은?
- REVOKE 키워드를 사용하여 열 이름을 다시 부여할 수 있다.
- 데이터 정의어는 기본 테이블, 뷰 테이블, 또는 인덱스 등을 생성, 변경, 제거하는데 사용되는 명령어이다.
- DISTINCT를 활용하여 중복 값을 제거할 수 있다.
- JOIN을 통해 여러 테이블의 레코드를 조합하여 표현할 수 있다.
정답과 해설 보기
정답: 1
정답은 ①이다. REVOKE는 사용자나 역할에 부여했던 권한 등을 회수하는 명령이며 열의 이름을 바꾸는 명령이 아니다. 기존 열 자체의 이름을 변경하려면 ALTER TABLE의 RENAME COLUMN을 사용하고, 한 질의의 출력 이름만 바꾸려면 AS 별칭을 사용할 수 있다. DISTINCT는 SELECT 결과의 중복 행을 제거하고 JOIN은 조건에 따라 여러 테이블의 행을 결합한다. 데이터 정의어의 CREATE·ALTER·DROP은 데이터베이스 객체의 정의를 생성·변경·제거한다는 점에서 권한 관리와 구별된다.
선지별 해설
- REVOKE는 권한 회수다. 실제 열 이름 변경이나 출력 별칭 부여와는 다르다.
- CREATE·ALTER·DROP은 테이블·뷰 등 객체의 정의를 다루는 명령이다.
- SELECT DISTINCT는 지정한 출력 열들의 조합이 같은 중복 행을 제거한다.
- JOIN은 여러 테이블의 행을 결합해 필요한 결과를 만드는 연산이다.
편집 해설 근거: PostgreSQL 18, REVOKE — Description; PostgreSQL 18, ALTER TABLE — RENAME COLUMN; PostgreSQL 18 — SELECT — SELECT List; DISTINCT Clause; FROM Clause
53. 다음 SQL문의 실행결과로 생성되는 튜플 수는?
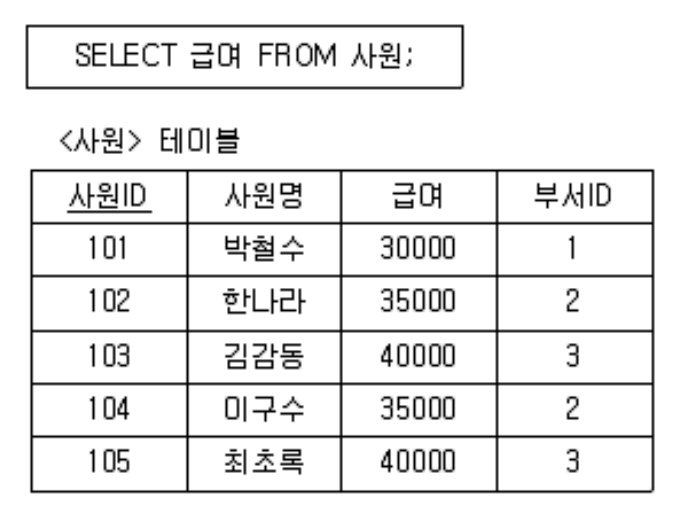
- 1
- 3
- 4
- 5
정답과 해설 보기
정답: 4
정답은 ④이다. 그림의 사원 테이블에는 자료 행이 다섯 개 있고, 질의는 WHERE나 DISTINCT 없이 급여 열만 선택한다. 일반 SELECT는 같은 급여가 여러 번 나타나더라도 각 입력 행에 대응하는 결과 행을 남기므로 출력 튜플은 다섯 개다. 급여 값은 30,000·35,000·40,000·35,000·40,000이며 서로 다른 값은 세 개지만 결과 행 수와는 다르다. SELECT DISTINCT 급여라면 중복이 제거되어 세 행이 되므로 DISTINCT 유무를 먼저 확인해야 한다.
선지별 해설
- 집계로 한 행을 만드는 질의가 아니며 다섯 입력 행이 결과에 남는다.
- 3은 DISTINCT를 적용했을 때 서로 다른 급여 값의 수다.
- 입력 테이블의 열 수나 중복 값 일부를 잘못 센 결과다.
- DISTINCT와 WHERE가 없으므로 다섯 자료 행에 대응하는 결과가 나온다.
편집 해설 근거: PostgreSQL 18 — SELECT — Description — SELECT ALL default; DISTINCT Clause
54. 다음 SQL문에서 사용된 BETWEEN 연산의 의미와 동일한 것은?
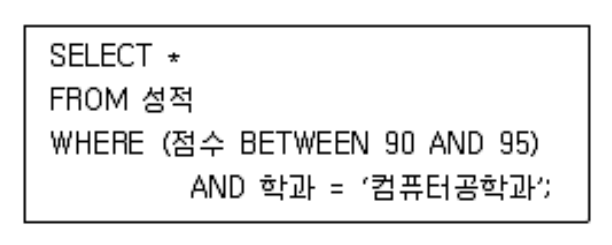
- 점수 >= 90 AND 점수 <= 95
- 점수 > 90 AND 점수 < 95
- 점수 > 90 AND 점수 <= 95
- 점수 >= 90 AND 점수 < 95
정답과 해설 보기
정답: 1
정답은 ①이다. BETWEEN 90 AND 95는 양쪽 경계를 모두 포함하므로 점수가 90 이상이면서 95 이하라는 뜻이다. 따라서 점수 >= 90 AND 점수 <= 95와 같은 범위를 고른다. 그림의 전체 질의는 여기에 학과가 컴퓨터공학과라는 조건도 AND로 결합하므로 범위 안의 점수만으로 모든 행이 선택되는 것은 아니다. NULL 점수는 비교 결과가 참이 되지 않아 WHERE를 통과하지 않는다. 두 경계 중 하나라도 엄격한 부등호로 바꾸면 90 또는 95가 제외되어 원래 조건과 달라진다.
선지별 해설
- 90과 95를 모두 포함하여 BETWEEN의 범위와 일치한다.
- 두 경계를 모두 제외하므로 90과 95가 빠진다.
- 하한 90을 제외하므로 원래 조건과 다르다.
- 상한 95를 제외하므로 원래 조건과 다르다.
편집 해설 근거: PostgreSQL 18, Comparison Functions and Operators — Comparison Predicates — BETWEEN
55. 트랜잭션의 상태 중 트랜잭션의 수행이 실패하여 Rollback 연산을 실행한 상태는?
- 철회(Aborted)
- 부분 완료(partially Committed)
- 완료(Commit)
- 실패(Fail)
정답과 해설 보기
정답: 1
정답은 ①이다. 트랜잭션이 더는 정상적으로 수행될 수 없다고 판단되면 실패 상태가 된다. 이후 이미 수행한 변경을 되돌리는 롤백을 마쳐 실행 전 상태로 복구된 상태가 철회(Aborted)다. 부분 완료는 마지막 명령을 실행했지만 결과의 영속성을 아직 확정하지 않은 단계이고, 완료는 성공적으로 커밋한 상태다. 따라서 실패를 감지한 시점과 그 실패의 영향을 제거한 시점을 구별해야 한다. 철회 후에는 정책과 원인에 따라 재시작하거나 트랜잭션을 종료할 수 있다.
선지별 해설
- 롤백을 완료해 이전 상태로 복구된 철회 상태다.
- 마지막 명령 실행을 마쳤지만 커밋 확정 전인 단계다.
- 변경 결과를 성공적으로 확정한 상태다.
- 정상 진행이 불가능하다고 판단된 단계로 롤백 완료와 구별한다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 17 저자 자료 — Transaction State — Active, Partially committed, Failed, Aborted, Committed
56. 데이터 제어어(DCL)에 대한 설명으로 옳은 것은?
- ROLLBACK : 데이터의 보안과 무결성을 정의한다.
- COMMIT : 데이터베이스 사용자의 사용 권한을 취소한다.
- GRANT : 데이터베이스 사용자의 사용 권한을 부여한다.
- REVOKE: 데이터베이스 조작 작업이 비정상적으로 종료되었을 때 원래 상태로 복구한다.
정답과 해설 보기
정답: 3
정답은 ③이다. GRANT는 사용자나 역할에 데이터베이스 객체를 조회·변경하는 등의 권한을 부여하는 명령이고 REVOKE는 부여한 권한을 회수한다. COMMIT은 트랜잭션의 변경을 확정하며 ROLLBACK은 아직 확정하지 않은 변경을 되돌린다. 따라서 ①·②·④는 각 명령의 기능을 서로 바꿔 설명했다. SQL 분류 체계에 따라 COMMIT과 ROLLBACK을 트랜잭션 제어어(TCL)로 따로 구분하기도 하지만, 명칭 분류와 관계없이 네 명령의 실제 동작은 구별해야 한다.
선지별 해설
- ROLLBACK은 미확정 트랜잭션을 되돌리는 명령이지 보안·무결성 정의 자체가 아니다.
- COMMIT은 변경의 확정이며 권한 회수 명령이 아니다.
- GRANT는 권한을 부여한다.
- REVOKE는 권한 회수이며 비정상 종료된 조작을 되돌리는 명령이 아니다.
편집 해설 근거: PostgreSQL 18, GRANT — Description; PostgreSQL 18, REVOKE — Description; PostgreSQL 18, 3.4 Transactions — §3.4 Transactions — COMMIT and ROLLBACK
57. 그림의 R과 S에 제시된 UNION ALL 질의를 수행한다. 출력 순서는 무시하고 중복을 포함한 A 열의 값 구성이 맞는 것은?
[학습용 개정문항]
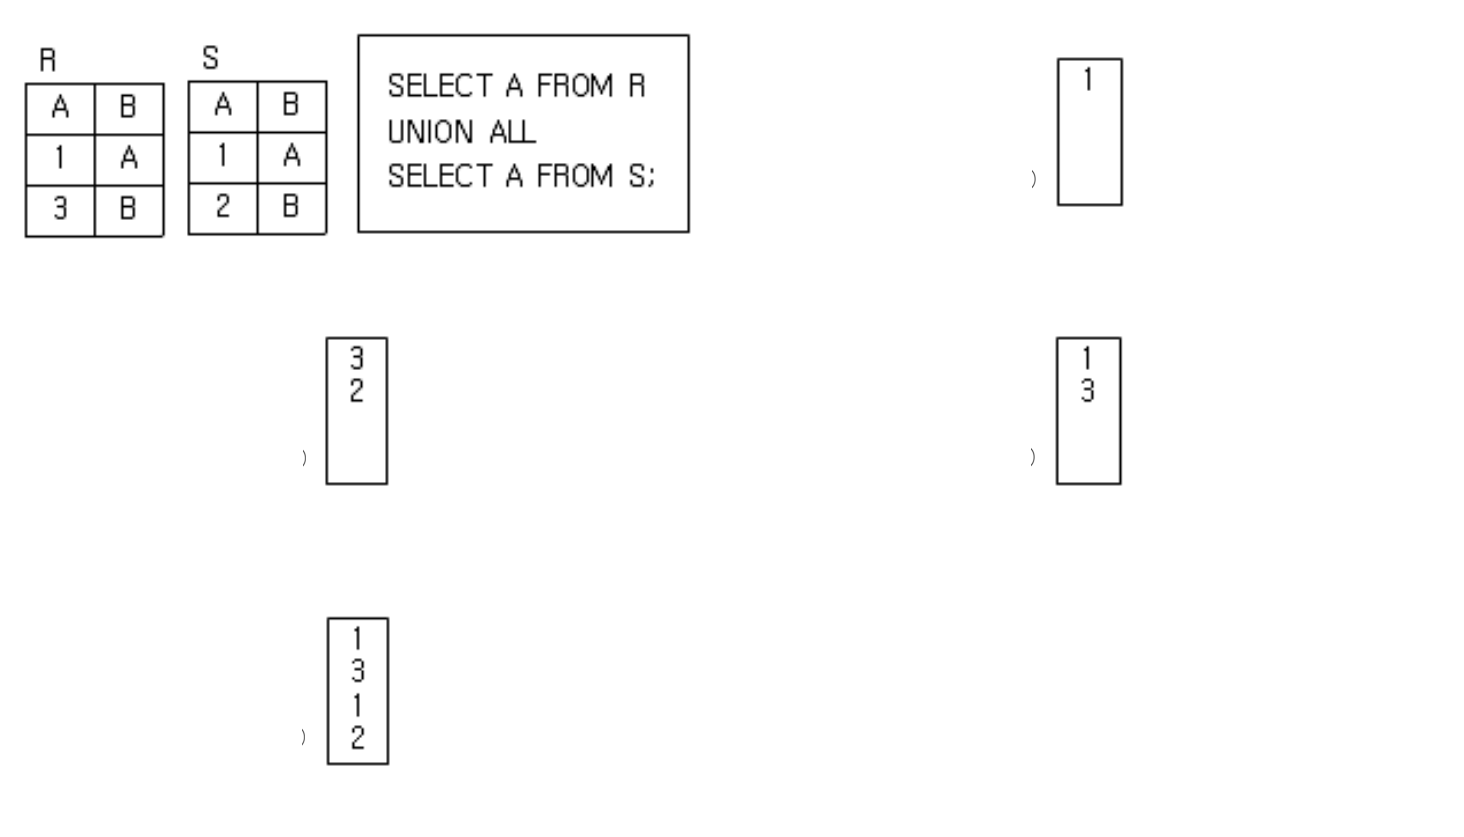
- 1
- 3 2
- 1 3
- 1 3 1 2
정답과 해설 보기
정답: 4
정답은 ④이다. R에서 A 열을 읽으면 1과 3이 나오고 S에서 읽으면 1과 2가 나온다. UNION ALL은 두 결과를 합치면서 중복을 제거하지 않으므로 1이 두 번, 2와 3이 각각 한 번 포함된 총 네 행이 된다. UNION만 사용하면 중복 1이 하나로 줄지만 ALL이 있으므로 그대로 남는다. 또한 ORDER BY가 없으므로 1·3·1·2라는 특정 나열 순서까지 SQL이 보장하는 것은 아니다. 이 문항은 순서를 무시한 값과 출현 횟수를 비교한다.
선지별 해설
- 공통 값만 남기는 연산이 아니므로 1만 나오는 결과는 틀렸다.
- 두 결과의 중복을 유지하는 합집합이므로 1 두 개가 누락되면 안 된다.
- 이 결과는 R 쪽 값만 포함하고 S 쪽의 추가 행을 빠뜨렸다.
- 1이 두 번, 3과 2가 한 번씩 나와 총 네 행이라는 구성이 맞다.
편집 해설 근거: PostgreSQL 18 — SELECT — UNION Clause; ORDER BY Clause
58. 분산 데이터베이스 시스템(Distributed Database System)에 대한 설명으로 틀린 것은?
- 분산 데이터베이스는 논리적으로는 하나의 시스템에 속하지만 물리적으로는 여러 개의 컴퓨터 사이트에 분산되어 있다.
- 위치 투명성, 중복 투명성, 병행 투명성, 장애 투명성을 목표로 한다.
- 데이터베이스의 설계가 비교적 어렵고, 개발 비용과 처리 비용이 증가한다는 단점이 있다.
- 분산 데이터베이스 시스템의 주요 구성 요소는 분산 처리기, P2P 시스템, 단일 데이터베이스 등이 있다.
정답과 해설 보기
정답: 4
정답은 ④이다. 분산 데이터베이스는 데이터가 여러 사이트에 나뉘어 있으면서 사용자에게는 하나의 논리적인 데이터베이스처럼 이용되도록 구성한 시스템이다. 각 사이트의 데이터베이스와 처리 기능을 통신망 및 분산 관리 기능으로 연결한다. 모든 분산 데이터베이스가 P2P 방식과 단일 물리 데이터베이스로 구성되어야 하는 것은 아니다. 위치·복제·동시 실행·장애를 사용자에게 가능한 한 감추는 투명성을 목표로 하지만 네트워크와 분산 트랜잭션 등을 관리하는 설계·운영 복잡성이 추가될 수 있다.
선지별 해설
- 논리적으로 통합된 데이터가 물리적으로 여러 사이트에 존재할 수 있다.
- 데이터의 위치·복제 및 동시 실행·장애의 영향을 감추는 투명성을 추구한다.
- 통신과 데이터 일관성을 관리하는 추가 복잡성과 비용이 생길 수 있다.
- P2P 방식과 단일 물리 데이터베이스가 필수 구성이라고 할 수 없다.
편집 해설 근거: Oracle Database — Distributed Database Concepts — Distributed Database Architecture; Distributed Database Transparency
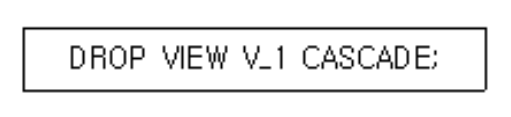
59. PostgreSQL 18에서 두 테이블을 조인한 뷰 V_1과 이를 참조하는 뷰 V_2가 있다. 필요한 권한이 있고 그림의 명령이 정상 실행될 때 제거되는 뷰는?
[학습용 개정문항]
- V_1만 삭제된다.
- V_2만 삭제된다.
- V_1과 V_2 모두 삭제된다.
- V_1과 V_2 모두 삭제되지 않는다.
정답과 해설 보기
정답: 3
정답은 ③이다. PostgreSQL에서 DROP VIEW V_1 CASCADE는 V_1을 제거하면서 그것에 의존하는 객체도 함께 제거한다. V_2가 V_1을 참조해 정의되어 있으므로 V_2도 삭제 대상에 들어간다. 반대로 CASCADE 없이 기본 RESTRICT 동작을 사용하면 의존 객체가 존재할 때 명령이 거절될 수 있다. V_1을 정의할 때 사용한 원본 테이블은 V_1에 의존하는 객체가 아니라 V_1이 의존하는 대상이므로 이 명령만으로 함께 삭제되는 것은 아니다.
선지별 해설
- CASCADE가 있으므로 V_1에 의존하는 V_2도 삭제된다.
- 명령의 직접 대상인 V_1이 남는다는 설명은 틀렸다.
- V_1과 그것에 의존하는 V_2가 함께 제거된다.
- CASCADE로 의존 객체까지 제거하도록 했으므로 둘 다 남지는 않는다.
편집 해설 근거: PostgreSQL 18, DROP VIEW — Parameters — CASCADE and RESTRICT
60. 데이터베이스에서 병행제어의 목적으로 틀린 것은?
- 시스템 활용도 최대화
- 사용자에 대한 응답시간 최소화
- 데이터베이스 공유 최소화
- 데이터베이스 일관성 유지
정답과 해설 보기
정답: 3
정답은 ③이다. 병행제어는 여러 트랜잭션이 동시에 데이터에 접근하면서도 서로의 작업을 잘못 덮어쓰거나 일관성을 깨뜨리지 않게 조정하는 기능이다. 안전한 공유를 통해 시스템 자원을 효율적으로 사용하고 처리량과 응답성을 높이는 것이 목표이므로 데이터베이스 공유 자체를 최소화하려는 것은 아니다. 잠금 등으로 일부 접근을 대기시킬 수 있지만 이는 일관성을 위한 수단이다. 동시 실행이 언제나 빠른 것은 아니어서 충돌·대기 비용과 격리 수준 사이의 균형도 고려한다.
선지별 해설
- 안전한 동시 실행으로 자원 활용도를 높이는 것은 추구하는 목표다.
- 사용자 응답성을 높이려 하지만 잠금 경쟁 등에 따른 대기는 생길 수 있다.
- 공유를 없애는 것이 아니라 공유하면서도 일관성을 유지하는 것이 목적이다.
- 동시에 수행되는 트랜잭션 사이에서 데이터의 일관성을 지켜야 한다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Concurrency Control — Concurrency Control; Serializability; Lock-Based Concurrency Control
정보처리기사 필기 기출문제 · 프로그래밍 언어 활용
61. IP 주소체계와 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- IPv6 기본 헤더는 32옥텟의 고정 길이를 가진다.
- IPv6는 자동 주소 설정 기능을 지원한다.
- IPv4는 DHCP를 이용해 호스트 주소를 할당할 수 있으며 유니캐스트를 지원한다.
- 과거 클래스 기반 IPv4 방식에서 A·B·C 클래스는 네트워크 부분의 길이가 다르다.
정답과 해설 보기
정답: 1
정답은 ①이다. IPv6 기본 헤더는 40옥텟으로 고정되며, 선택적인 확장 헤더는 그 뒤에 이어진다. 주소 자체의 길이인 128비트와 기본 헤더 전체 길이를 혼동하면 안 된다. IPv6는 자동 주소 설정을 지원하고 IPv4에서는 DHCP 같은 별도 프로토콜을 이용해 주소를 할당할 수 있다. IPv4의 A·B·C 클래스별 네트워크 길이는 과거 클래스 기반 주소 방식의 설명이며, 오늘날 CIDR에서는 접두사 길이로 네트워크 부분을 정한다.
선지별 해설
- IPv6 기본 헤더는 32옥텟이 아니라 40옥텟이다.
- IPv6는 자동 주소 설정 기능을 지원한다.
- IPv4 주소를 DHCP로 할당할 수 있고 유니캐스트 통신도 가능하다.
- 과거 클래스 기반 IPv4에서는 A·B·C 클래스의 네트워크 부분 길이가 달랐다.
편집 해설 근거: IETF RFC 8200, Internet Protocol Version 6 Specification (2017) — §3 IPv6 Header Format; IETF RFC 2131, Dynamic Host Configuration Protocol (1997) — §1 Introduction; IETF RFC 791, Internet Protocol (1981) — §3.2 Discussion — Addressing
62. 다음 C 프로그램의 출력은?
#include <stdio.h>
int main(void) {
    int arr[2][3] = {1,2,3,4,5,6};
    int (*p)[3] = NULL;
    p = arr;
    printf("%d, ", *(p[0]+1) + *(p[1]+2));
    printf("%d", *(*(p+1)+0) + *(*(p+1)+1));
    return 0;
}
[학습용 개정문항]
- 7, 5
- 8, 5
- 8, 9
- 7, 9
정답과 해설 보기
정답: 3
정답은 ③이다. arr의 첫 행은 [1,2,3], 둘째 행은 [4,5,6]이다. p는 정수 세 개로 이루어진 행을 가리키는 포인터이므로 p[0]은 첫 행, p[1]은 둘째 행을 뜻한다. 첫 printf의 두 항은 arr[0][1]=2와 arr[1][2]=6이어서 합이 8이다. 다음 식에서 p+1은 둘째 행을 가리키며 *(*(p+1)+0)=4, *(*(p+1)+1)=5이므로 합은 9다. 포인터를 한 칸 이동할 때 단일 int가 아니라 행 전체 크기만큼 이동한다는 점을 구별해야 한다.
선지별 해설
- 첫 출력은 2+6=8이므로 7이 아니며 둘째도 4+5=9다.
- 첫 합은 맞지만 둘째 합은 4+5=9다.
- 두 출력은 각각 2+6=8과 4+5=9다.
- 둘째 합은 맞지만 첫 합을 7로 잘못 계산했다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.2.1 Array subscripting; §6.5.6 Additive operators
63. OSI 7계층 중 데이터링크 계층에 해당되는 프로토콜이 아닌 것은?
- HTTP
- HDLC
- PPP
- LLC
정답과 해설 보기
정답: 1
정답은 ①이다. HTTP는 웹 요청과 응답 등의 의미를 정의하는 응용 계층 프로토콜이다. HDLC와 PPP는 링크를 통한 프레임 전달과 연결 제어를 다루고, LLC는 IEEE 802 계열 데이터링크 계층의 논리 링크 제어 하위 계층이다. 따라서 네 항목 중 데이터링크 계층으로 분류하지 않는 것은 HTTP다. HTTP가 실제 전송에서 TCP나 QUIC 같은 하위 프로토콜을 사용한다는 사실은 HTTP 자체의 응용 계층 역할을 바꾸지 않는다.
선지별 해설
- HTTP는 응용 계층의 요청·응답 의미를 다룬다.
- HDLC는 데이터링크 계층의 프레임 및 링크 제어 프로토콜이다.
- PPP는 점대점 링크를 통한 다중 프로토콜 캡슐화와 링크 제어를 제공한다.
- LLC는 IEEE 802 데이터링크 계층의 논리 링크 제어 부분이다.
편집 해설 근거: ITU-T X.200 (07/1994), OSI Basic Reference Model — §7.6 Data Link Layer; §7.1 Application Layer; IETF RFC 1122 (1989), Requirements for Internet Hosts — §1.1.3 Internet Protocol Suite
64. C언어에서 두 개의 논리 값 중 하나라도 참이면 1을, 모두 거짓이면 0을 반환하는 연산자는?
[학습용 개정문항]
- ||
- &&
- **
- !=
정답과 해설 보기
정답: 1
정답은 ①이다. C의 논리 OR 연산자 ||는 왼쪽 또는 오른쪽 피연산자가 0이 아니면 정수 1을, 둘 다 0이면 0을 반환한다. 왼쪽만으로 결과가 참임이 정해지면 오른쪽은 평가하지 않는 단락 평가도 수행한다. &&는 두 피연산자가 모두 참일 때 1을 반환하는 논리 AND이고, !=는 두 값이 서로 다른지를 비교한다. **는 C의 거듭제곱 연산자가 아니다. 두 값의 비트를 각각 OR하는 |와 논리값 하나를 만드는 ||도 구별해야 한다.
선지별 해설
- ||는 하나 이상 참일 때 1을 반환하는 논리 OR다.
- &&는 두 피연산자가 모두 참이어야 1이다.
- C에는 **라는 거듭제곱 연산자가 없다.
- !=는 두 값의 비동등 비교로 논리 OR와 다르다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.13 Logical AND; §6.5.14 Logical OR; §6.5.9 Equality operators
65. IPv6에 대한 특성으로 틀린 것은?
[학습용 개정문항]
- 주소를 8비트씩 네 부분의 점 구분 10진수로 표시한다.
- 128비트로 2¹²⁸개의 주소 비트 조합을 표현할 수 있다.
- Traffic Class와 Flow Label을 트래픽 분류와 흐름 처리에 활용할 수 있다.
- 적절히 구성한 IPsec을 통해 인증·기밀성 같은 보안 서비스를 적용할 수 있다.
정답과 해설 보기
정답: 1
정답은 ①이다. IPv6 주소는 128비트이며 일반적인 텍스트 표기는 16비트 묶음 여덟 개를 16진수와 콜론으로 표현한다. 8비트씩 네 부분을 점으로 구분한 10진수 표기는 IPv4에 해당한다. IPv6 기본 헤더의 Traffic Class와 Flow Label은 트래픽 처리와 흐름 식별에 활용되지만 그 자체가 대역폭이나 지연을 보장하지는 않는다. IPsec 보안 프로토콜을 사용할 수도 있으나 적절한 정책·키·설정이 있어야 하며 모든 IPv6 통신이 자동 암호화되는 것은 아니다.
선지별 해설
- IPv4의 일반적인 점 구분 10진수 표기를 IPv6에 적용한 설명이다.
- 128비트 주소 공간이므로 이론적인 비트 조합은 2의 128제곱 개다.
- Traffic Class와 Flow Label은 트래픽 분류와 흐름 처리에 활용할 수 있다.
- 설정된 IPsec 정책과 키를 통해 인증·기밀성 등의 서비스를 적용할 수 있다.
편집 해설 근거: IETF RFC 4291, IP Version 6 Addressing Architecture (2006) — §2.2 Text Representation of Addresses; IETF RFC 8200, Internet Protocol Version 6 Specification (2017) — §3 IPv6 Header Format; IETF RFC 4301 — IPsec architecture — §3 System Overview; §4.1 Security Associations
66. JAVA의 예외(exception)와 관련한 설명으로 틀린 것은?
- 문법 오류로 인해 발생한 것
- 오동작이나 결과에 악영향을 미칠 수 있는 실행 시간 동안에 발생한 오류
- 배열의 인덱스가 그 범위를 넘어서는 경우 발생하는 오류
- 존재하지 않는 파일을 읽으려고 하는 경우에 발생하는 오류
정답과 해설 보기
정답: 1
정답은 ①이다. Java 예외는 프로그램 실행 중 발생한 비정상 상황을 객체와 throw·catch 등의 기제로 전달하는 방식이다. 소스 코드의 문법 오류는 보통 컴파일 과정에서 진단되므로 실행 중 예외와 구별한다. 배열 범위를 벗어난 접근은 ArrayIndexOutOfBoundsException을 일으키고, 존재하지 않는 파일을 여는 연산은 사용한 API에 따라 FileNotFoundException 같은 예외를 일으킬 수 있다. 검사 예외에 대해 컴파일러가 처리 여부를 확인한다는 사실과 문법 오류 자체가 실행 예외라는 주장은 다르다.
선지별 해설
- 문법 오류는 컴파일 진단 대상이며 Java 실행 중 예외의 정의가 아니다.
- 실행 중 발생한 비정상 상황을 예외로 전달할 수 있다.
- 배열의 허용 인덱스 범위를 벗어난 접근은 실행 중 예외를 일으킨다.
- 파일 열기 API는 대상 파일이 없을 때 관련 예외를 발생시킬 수 있다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 11 Exceptions — §11.1.1 The Kinds of Exceptions; §11.2 Compile-Time Checking of Exceptions
67. TCP/IP 계층 구조에서 IP 패킷 전달 중 발생한 오류 정보를 전송하는 프로토콜은?
- ECP(Error Checking Protocol)
- ARP(Address Resolution Protocol)
- ICMP(Internet Control Message Protocol)
- PPP(Point-to-Point Protocol)
정답과 해설 보기
정답: 3
정답은 ③이다. ICMP는 IP 통신 중 발생한 전달 문제와 제어 정보를 보고하는 프로토콜이다. 목적지 도달 불가나 전송 시간 초과 같은 메시지로 송신 측에 상태를 알릴 수 있다. ARP는 IPv4 주소에 대응하는 링크 계층 주소를 알아내고, PPP는 점대점 링크의 통신을 다루므로 역할이 다르다. ICMP가 오류를 보고한다고 해서 IP 패킷의 재전송이나 전달 성공을 보장하는 것은 아니다. 보고 메시지 자체도 유실될 수 있으며 모든 상황에서 오류 메시지를 생성하는 것도 아니다.
선지별 해설
- ECP는 이 문항의 IP 오류 보고 역할을 정의한 프로토콜 명칭이 아니다.
- ARP는 IPv4 주소와 링크 계층 주소의 대응을 알아내는 프로토콜이다.
- IP 전달 오류와 제어 정보를 보고하는 ICMP가 해당한다.
- PPP는 점대점 링크를 구성하고 패킷을 전달하기 위한 프로토콜이다.
편집 해설 근거: IETF RFC 792 — Internet Control Message Protocol — Introduction; Destination Unreachable; Time Exceeded
68. 좋은 소프트웨어 설계를 위한 모듈 간 결합도(Coupling)와 모듈 내 요소 간 응집도(Cohesion)의 관계로 옳은 것은?
- 응집도는 낮게 결합도는 높게 설계한다.
- 응집도는 높게 결합도는 낮게 설계한다.
- 양쪽 모두 낮게 설계한다.
- 양쪽 모두 높게 설계한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 응집도는 한 모듈 안의 요소들이 하나의 책임이나 목적에 얼마나 긴밀하게 관련되는지 나타내고, 결합도는 서로 다른 모듈들이 얼마나 의존하는지를 나타낸다. 높은 응집도와 낮은 불필요한 결합도를 목표로 하면 한 기능을 이해하고 수정하기 쉬우며 변경의 파급을 줄일 수 있다. 다만 모듈 간 협력을 모두 없애라는 뜻은 아니다. 필요한 기능은 명확한 인터페이스로 연결하고 다른 모듈의 내부 상태나 구현 세부에 대한 의존을 줄이는 것이 핵심이다.
선지별 해설
- 서로 무관한 책임을 묶고 외부 의존을 늘리는 방향이라 바람직하지 않다.
- 모듈 내부의 관련성은 높이고 외부의 불필요한 의존은 낮추는 방향이다.
- 결합도를 낮추더라도 모듈 내부 책임이 흩어져 있으면 이해와 관리가 어렵다.
- 응집도가 높아도 다른 모듈과 강하게 얽히면 변경 영향이 커진다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 — Coupling and Cohesion
69. 그림의 P와 V는 원자적인 추상 연산이고 S의 초기값은 1이다. 임계구역 진입 전에 P, 종료 후 V를 호출해 상호배제를 구현하는 기법은?
[학습용 개정문항]
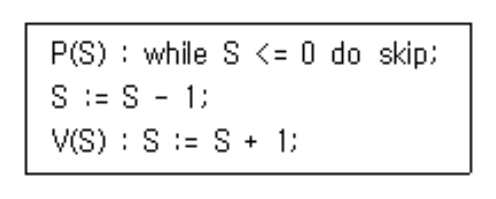
- Dekker Algorithm
- Lamport Algorithm
- Peterson Algorithm
- Semaphore
정답과 해설 보기
정답: 4
정답은 ④이다. 세마포어는 공유 자원의 사용 가능 수 등을 나타내는 값과 이를 조정하는 원자적 연산으로 동기화를 제공한다. 그림의 P는 사용 가능해질 때까지 기다렸다가 값을 줄여 자원을 획득하고 V는 값을 늘려 반환한다. 초기값을 1로 두고 임계구역 앞뒤에서 올바르게 P와 V를 호출하면 한 번에 하나만 진입하도록 할 수 있다. 단순한 일반 변수의 while 검사와 감소를 여러 스레드가 따로 실행하면 경쟁이 생기므로 검사·갱신의 원자성이라는 전제가 필요하다.
선지별 해설
- Dekker 알고리즘은 두 프로세스의 진입 의사와 차례를 이용한다.
- Lamport의 대표적인 상호배제 알고리즘은 번호표 등의 순서를 이용한다.
- Peterson 알고리즘은 두 프로세스의 flag와 turn을 이용한다.
- 원자적인 P·V 연산과 계수 값을 사용하는 세마포어다.
편집 해설 근거: Arpaci-Dusseau & Arpaci-Dusseau, OSTEP Chapter 31 Semaphores — §31.1 Semaphores: A Definition; §31.2 Binary Semaphores (Locks)
70. 소프트웨어 개발에서 모듈(Module)이 되기 위한 주요 특징에 해당하지 않는 것은?
[학습용 개정문항]
- 다른 구성 요소와 구별할 수 있는 역할과 책임을 가진다.
- 언어·빌드 환경이 지원하면 분리 컴파일할 수 있다.
- 자신이 사용되는 이름 범위 안에서 식별 가능해야 한다.
- 다른 모듈이 공개 인터페이스를 통해서도 전혀 접근할 수 없어야 한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 모듈은 관련된 책임을 묶어 다른 부분과 구별할 수 있는 프로그램 구성 단위다. 다른 모듈과 협력할 수 있도록 공개 인터페이스를 제공하면서 내부 구현에 대한 불필요한 직접 접근을 제한하는 것이 바람직하다. 따라서 다른 모듈에서 어떤 형태의 접근도 불가능해야 한다는 설명은 잘못됐다. 분리 컴파일 가능 여부와 이름의 유효 범위는 언어·빌드 체계에 따라 달라지므로 모든 모듈이 전역적으로 유일한 이름이나 독립 실행 가능성을 갖춰야 한다고 일반화하지 않는다.
선지별 해설
- 역할과 책임을 구분할 수 있는 구성 단위여야 한다.
- 언어와 빌드 환경이 지원하면 모듈을 분리해서 컴파일할 수 있다.
- 이름을 사용하는 범위 안에서 식별 가능해야 한다.
- 공개 인터페이스를 통한 필요한 접근과 협력까지 막을 필요는 없다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 — Modularization; Encapsulation; Separation of Interface and Implementation; ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §5.1.1.1 Program structure
71. 빈 고정 파티션의 크기가 20KB, 16KB, 8KB, 40KB이다. 최적 적합(Best Fit)으로 17KB 프로그램에 파티션 하나 전체를 할당하고 남는 공간은 따로 재사용하지 않는다. 이 할당의 내부 단편화 크기는?
[학습용 개정문항]
- 3KB
- 23KB
- 64KB
- 67KB
정답과 해설 보기
정답: 1
정답은 ①이다. 최적 적합은 요청을 수용할 수 있는 빈 영역 중 가장 작은 것을 선택한다. 17KB를 넣을 수 있는 후보는 20KB와 40KB이며, 이 중 작은 20KB 파티션을 선택한다. 문항에서는 선택한 고정 파티션 전체를 한 프로그램에 할당하고 남는 부분을 따로 쓰지 못하므로 내부의 미사용 공간은 20−17=3KB다. 가변 분할에서 남는 3KB를 별도 빈 공간으로 되돌리는 상황이라면 이를 같은 의미의 내부 단편화로 단정할 수 없어 고정 파티션 조건이 중요하다.
선지별 해설
- 선택한 20KB 파티션에서 17KB를 뺀 내부 미사용 공간이다.
- 40KB를 선택했을 때의 차이로 최적 적합의 선택이 아니다.
- 다른 빈 영역의 합계 등을 내부 단편화로 잘못 센 값이다.
- 사용 가능한 전체 공간이나 남은 공간의 합계와 개별 할당의 내부 단편화를 혼동했다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 17 Free-Space Management — §17.1 Assumptions; §17.3 Basic Strategies — Best Fit
72. 다음 C 프로그램의 출력은?
#include <stdio.h>
int main(void) {
    int i = 0;
    while (1) {
        if (i == 4) {
            break;
        }
        ++i;
    }
    printf("i = %d", i);
    return 0;
}
[학습용 개정문항]
- i = 0
- i = 1
- i = 3
- i = 4
정답과 해설 보기
정답: 4
정답은 ④이다. i는 0에서 시작하고 while(1)은 조건이 항상 참이다. 각 반복의 앞에서 i가 4인지 확인하여 같으면 break로 반복문을 빠져나가고, 그렇지 않으면 ++i로 1을 더한다. 따라서 i는 0→1→2→3→4로 변한 뒤 다음 조건 검사에서 반복을 끝낸다. i가 4일 때는 증가문에 도달하지 않으므로 5가 되지 않는다. 반복문 다음의 printf는 남아 있는 i 값 4를 사용하여 i = 4를 출력한다.
선지별 해설
- 반복이 실행되면서 증가하므로 초기값 0에 머무르지 않는다.
- 한 번 증가한 뒤 종료하는 조건이 아니다.
- 3일 때 조건이 거짓이어서 한 번 더 증가한다.
- 4에서 break가 실행되어 i = 4를 출력한다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.8.5.1 The while statement; §6.8.6.3 The break statement; §6.5.3.1 Prefix increment
73. 다음 Java 프로그램의 출력은?
public class Ape {
    static void rs(char a[]) {
        for (int i = 0; i < a.length; i++) {
            if (a[i] == 'B')
                a[i] = 'C';
            else if (i == a.length - 1)
                a[i] = a[i-1];
            else
                a[i] = a[i+1];
        }
    }
    static void pca(char a[]) {
        for (int i = 0; i < a.length; i++)
            System.out.print(a[i]);
        System.out.println();
    }
    public static void main(String[] args) {
        char c[] = {'A','B','D','D','A','B','C'};
        rs(c);
        pca(c);
    }
}
[학습용 개정문항]
- BCDABCA
- BCDABCC
- CDDACCC
- CDDACCA
정답과 해설 보기
정답: 2
정답은 ②이다. rs는 배열을 왼쪽에서 오른쪽으로 직접 변경한다. 초기 ABDDABC에서 i=0은 다음 값 B를 복사하고, i=1은 B이므로 C로 바꾼다. i=2·3·4는 각각 다음 원소 D·A·B를 복사하고, i=5는 B를 C로 바꾼다. 마지막 i=6은 B가 아니므로 이미 변경된 앞 원소인 C를 복사한다. 그 결과 배열은 BCDABCC가 된다. 별도의 결과 배열을 만드는 연산이 아니므로 앞 원소를 읽을 때에는 원래 값과 현재 값을 구별해야 한다.
선지별 해설
- 마지막 원소는 이미 C가 된 바로 앞 원소를 복사하므로 A가 아니다.
- 왼쪽부터 제자리 변경한 결과는 B-C-D-A-B-C-C다.
- 각 분기 조건과 다음 원소를 읽는 위치가 실제 반복 순서와 다르다.
- 첫 원소와 마지막 원소의 변경 규칙을 모두 잘못 반영했다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 15 Expressions — §15.10 Array Access; §15.26 Assignment Operators; Oracle Java SE 17 Language Specification, Chapter 14 Blocks and Statements — §14.9 The if Statement; §14.14 The for Statement
74. 개발 환경 구성을 위한 빌드(Build) 도구에 해당하지 않는 것은?
- Ant
- Kerberos
- Maven
- Gradle
정답과 해설 보기
정답: 2
정답은 ②이다. Ant·Maven·Gradle은 소스의 컴파일, 시험, 패키징 등 빌드 작업을 정의하고 실행하는 도구다. Kerberos는 신뢰하는 인증 서버가 발급하는 티켓 등을 이용하여 네트워크 서비스의 인증을 지원하는 프로토콜이므로 빌드 도구로 분류하지 않는다. 빌드 과정에서 인증이 필요한 저장소나 서비스를 이용할 수는 있지만, 그 인증 수단과 빌드 작업을 조정하는 도구의 역할은 다르다. 도구 이름이 개발 환경에 등장한다는 사실보다 어떤 기능을 수행하는지가 기준이다.
선지별 해설
- Ant는 타깃과 태스크를 정의해 빌드 작업을 실행한다.
- Kerberos는 티켓 기반 네트워크 인증 프로토콜이다.
- Maven은 프로젝트 모델과 생명주기를 바탕으로 빌드·의존성을 관리한다.
- Gradle은 태스크와 의존 관계를 바탕으로 빌드를 자동화한다.
편집 해설 근거: Apache Ant User Manual, Introduction — Apache Ant — Introduction; Apache Maven, What is Maven? — What is Maven?; Gradle Build Tool, project introduction (2026-10-05 확인) — User Manual — Build Tool; IETF RFC 4120, The Kerberos Network Authentication Service V5 (2005) — §1 Introduction
75. 초기에 모두 빈 3개 페이지 프레임을 1번부터 순서대로 채운다. 페이지 참조 순서가 1, 2, 1, 0, 4, 1, 3일 때 FIFO 교체 후 프레임 1·2·3의 최종 내용은?
[학습용 개정문항]
- 1, 2, 0
- 2, 4, 3
- 1, 4, 2
- 4, 1, 3
정답과 해설 보기
정답: 4
정답은 ④이다. 빈 세 프레임에 1과 2를 넣은 뒤 다시 1을 참조하면 적중이므로 FIFO의 적재 순서는 바뀌지 않는다. 다음 0을 넣으면 프레임은 [1,2,0]이 된다. 4가 들어올 때 가장 먼저 적재한 1을, 다음 1이 들어올 때 2를, 마지막 3이 들어올 때 0을 교체한다. 고정된 프레임 위치의 최종 내용은 [4,1,3]이다. FIFO는 가장 오래전에 적재된 페이지를 기준으로 하므로 적중한 페이지를 최신 순서로 옮기는 LRU 방식과 혼동하지 않아야 한다.
선지별 해설
- 4·1·3에 의한 뒤쪽 세 번의 교체를 반영하지 않았다.
- 중간의 1 참조와 FIFO 교체 순서를 잘못 반영했다.
- 마지막 참조 3에서 교체되는 가장 오래된 0을 반영하지 못한다.
- 1→4, 2→1, 0→3으로 각 프레임이 교체된 최종 상태다.
편집 해설 근거: Arpaci-Dusseau & Arpaci-Dusseau, OSTEP Chapter 22 Beyond Physical Memory: Policies — §22.3 A Simple Policy: FIFO
76. 다음 C 프로그램이 출력하는 문자는?
#include <stdio.h>
#include <string.h>
int main(void) {
    char str1[20] = "KOREA";
    char str2[20] = "LOVE";
    char *p1 = str1;
    char *p2 = str2;
    str1[1] = p2[2];
    str2[3] = p1[4];
    strcat(str1, str2);
    printf("%c", *(p1+2));
    return 0;
}
[학습용 개정문항]
- E
- V
- R
- O
정답과 해설 보기
정답: 3
정답은 ③이다. p1은 str1, p2는 str2의 첫 문자를 가리킨다. str1[1]=p2[2]는 KOREA의 두 번째 문자를 LOVE의 세 번째 문자 V로 바꾸어 KVREA로 만든다. str2[3]=p1[4]는 LOVE의 마지막 E를 A로 바꾸어 LOVA로 만든다. strcat 후 str1은 KVREALOVA가 되지만 세 번째 문자 str1[2]는 계속 R이다. *(p1+2)는 이 문자를 읽는다. 두 배열은 수정 가능한 20칸 배열이며 합친 문자열과 종료 문자가 공간 안에 들어간다는 조건도 확인한다.
선지별 해설
- E는 초기 문자열의 다른 위치에 있으며 p1+2가 가리키는 값이 아니다.
- V로 바뀐 곳은 str1[1]이지 str1[2]가 아니다.
- 문자열 변경과 연결 뒤에도 str1[2]는 R이다.
- O는 두 번째 문자열의 일부이며 p1+2의 값이 아니다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.2.1 Array subscripting; §6.5.6 Additive operators; §7.24.3.1 strcat
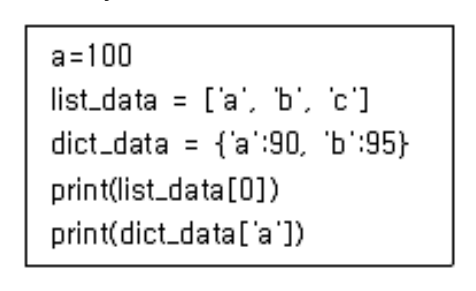
77. 이미지에 제시된 Python 자료구조에서 list_data[0]과 dict_data['a']를 차례로 출력한 결과는?
- a 90
- 100 a
- 90 a
- a 100
정답과 해설 보기
정답: 1
정답은 ①이다. list_data는 문자열 a·b·c를 차례로 저장한 리스트이므로 인덱스 0으로 읽은 값은 첫 원소인 문자열 a다. dict_data는 문자열 키 a를 숫자 90에, b를 95에 연결한 딕셔너리이므로 dict_data['a']는 90이다. 별도 변수 a에 저장한 100은 따옴표로 둘러싸인 키나 리스트 원소와 다르며 이 두 접근식에 사용되지 않는다. 실제로는 print를 두 번 호출하므로 a와 90이 서로 다른 줄에 출력되고 보기에서는 그 순서를 공백으로 나열했다.
선지별 해설
- 첫 리스트 원소 a와 문자열 키 a에 연결된 값 90의 순서다.
- 변수 a의 값 100을 리스트 접근 결과로 혼동했다.
- 리스트 원소와 딕셔너리 조회 값의 순서를 바꾸었다.
- 딕셔너리의 문자열 키 a와 별도 변수 a의 값을 혼동했다.
편집 해설 근거: Python 3.14, Built-in Types — Sequence Types — indexing; Mapping Types — dict; Python 3.14, Built-in Functions — print
78. C언어에서 정수 변수 a, b에 각각 1, 2가 저장되어 있을 때 다음 식의 연산 결과로 옳은 것은?
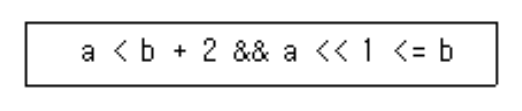
- 0
- 1
- 3
- 5
정답과 해설 보기
정답: 2
정답은 ②이다. C에서는 덧셈이 시프트보다, 시프트가 관계 비교보다, 관계 비교가 논리 AND보다 먼저 결합한다. 따라서 식은 (a < (b+2)) && ((a<<1) <= b)로 해석한다. a=1, b=2를 대입하면 왼쪽은 1<4로 참이고 오른쪽은 2<=2로 참이다. 두 조건의 논리 AND 결과는 정수 1이다. 비교 결과 1을 더하거나 시프트 횟수에 전체 비교식을 잘못 넣지 않고 연산자 우선순위에 따라 괄호를 복원하는 것이 핵심이다.
선지별 해설
- 양쪽 관계식이 모두 참이므로 0이 아니다.
- 1<4와 2<=2가 모두 참이라 논리 AND가 1을 반환한다.
- &&는 피연산자를 산술적으로 합산하지 않는다.
- 논리 결과는 0 또는 1이며 5가 될 수 없다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.6 Additive operators; §6.5.7 Bitwise shift; §6.5.8 Relational; §6.5.13 Logical AND
79. 다음 Python 코드의 출력 형태는?
a = ["대", "한", "민", "국"]
for i in a:
    print(i)
[학습용 개정문항]
- 대한민국 (줄바꿈 없이 한 줄 출력)
- 대, 한, 민, 국을 각각 한 줄씩 출력
- 대
- 대대대대
정답과 해설 보기
정답: 2
정답은 ②이다. for는 리스트의 원소를 처음부터 끝까지 하나씩 i에 대입한다. 각 반복에서 print(i)를 호출하므로 대·한·민·국이 차례로 출력된다. print의 기본 end 인수는 줄바꿈 문자이므로 각 글자는 서로 다른 줄에 놓이고 마지막 국 뒤에도 줄바꿈이 붙는다. 네 글자를 한 줄에 이어 붙이려면 end를 빈 문자열로 바꾸는 등의 추가 처리가 필요하다. i에 리스트 전체가 아니라 매번 개별 원소가 들어간다는 점도 확인해야 한다.
선지별 해설
- 기본 print는 매번 줄바꿈하므로 그대로 한 줄에 이어 붙이지 않는다.
- 네 원소가 순서대로 각각 한 줄에 출력된다.
- 반복문은 첫 원소에서 멈추지 않고 모든 원소를 순회한다.
- 매 반복에서 다음 원소를 읽으므로 첫 글자만 반복되지 않는다.
편집 해설 근거: Python 3.14 Language Reference, 8.1 The if statement — §4.2 for Statements; Python 3.14, Built-in Functions — print — end parameter
80. UNIX 시스템의 쉘(shell)의 주요 기능에 대한 설명이 아닌 것은?
- 사용자 명령을 해석하고 커널로 전달하는 기능을 제공한다.
- 반복적인 명령 프로그램을 만드는 프로그래밍 기능을 제공한다.
- 쉘 프로그램 실행을 위해 프로세스와 메모리를 관리한다.
- 초기화 파일을 이용해 사용자 환경을 설정하는 기능을 제공한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 셸은 사용자의 명령을 해석해 프로그램 실행이나 입출력 연결을 요청하고 변수·조건문·반복문 등으로 명령을 자동화할 수 있게 한다. 시작 파일을 통해 환경 변수나 사용자 설정을 적용하는 기능도 제공한다. 프로세스의 CPU 배분이나 가상 메모리 등의 핵심 자원 관리는 운영체제 커널의 역할이므로 셸의 주된 역할과 구별한다. 셸이 프로세스를 시작하고 작업 제어를 제공할 수 있다는 사실이 메모리 관리와 스케줄링 자체를 담당한다는 뜻은 아니다.
선지별 해설
- 명령의 구문을 해석하고 필요한 프로그램 실행을 요청한다.
- 스크립트의 조건·반복 등을 이용해 일련의 작업을 자동화할 수 있다.
- CPU 스케줄링과 메모리 자원 관리는 커널의 핵심 역할이다.
- 셸 종류와 실행 방식에 따라 초기화 파일로 사용자 환경을 구성할 수 있다.
편집 해설 근거: POSIX.1-2024 Issue 8, Shell Command Language — §2.1 Shell Introduction; §2.9 Shell Commands; Arpaci-Dusseau, OSTEP v1.10, 2 Introduction to Operating Systems — Virtualizing the CPU; Virtualizing Memory
정보처리기사 필기 기출문제 · 정보시스템 구축관리
81. 소프트웨어 생명주기 모델 중 나선형 모형(Spiral Model)에 관한 설명으로 틀린 것은?
- 소프트웨어 개발 프로세스를 위험 관리 측면에서 본 모델이다.
- 위험 분석은 반복 개발을 모두 마친 뒤 마지막 단계에서 한 번만 수행한다.
- 시스템을 여러 부분으로 나누어 여러 번의 개발 주기를 거치며 완성한다.
- 요구사항이나 아키텍처를 이해하기 어렵거나 핵심 기술에 위험이 있는 경우 적합하다.
정답과 해설 보기
정답: 2
정답은 ②이다. 나선형 모형은 반복 주기마다 목표와 대안을 정하고 주요 위험을 평가·해결하면서 다음 개발 활동과 계획을 결정하는 위험 중심 접근이다. 위험 분석을 마지막에 한 번만 하면 요구의 불확실성이나 핵심 기술의 실패 가능성을 일찍 줄일 수 없으므로 모형의 핵심 취지와 반대다. 필요한 경우 시제품이나 실험으로 위험을 낮춘 뒤 구현 수준을 높인다. 반복한다는 점만으로 나선형이 되는 것은 아니며 다음 활동의 선택에 위험 평가가 영향을 준다는 점이 중요하다.
선지별 해설
- 개발 대안과 다음 작업을 위험 관점에서 판단하는 모형이다.
- 위험은 매 반복에서 평가·해결해야 하며 마지막 한 번으로 미루지 않는다.
- 여러 주기를 거치며 목표와 구현을 구체화하는 방식이다.
- 기술·요구의 불확실성을 평가하고 줄이는 데 활용할 수 있다.
편집 해설 근거: Barry W. Boehm, A Spiral Model of Software Development and Enhancement (1988), 논문 보존 사본 — The spiral model; Determine objectives, alternatives, constraints; Evaluate alternatives, identify and resolve risks
82. 여러 서버 노드의 상태를 감시하고 장애 시 자원이나 업무를 다른 노드로 인계하여 서비스 중단을 줄이는 솔루션은? IBM의 역사적인 제품명 HACMP도 이에 속한다.
[학습용 개정문항]
- 고가용성 솔루션(HACMP)
- 점대점 연결 방식(Point-to-Point Mode)
- 스턱스넷(Stuxnet)
- 루팅(Rooting)
정답과 해설 보기
정답: 1
정답은 ①이다. 고가용성 클러스터는 여러 노드와 감시·전환 기능을 이용해 일부 구성 요소에 장애가 생겨도 업무 서비스를 이어가도록 설계한다. IBM HACMP는 이러한 고가용성 클러스터 솔루션의 역사적인 제품명이며 PowerHA SystemMirror로 이어진다. 공유 저장소를 사용하는 구성이나 노드가 자원을 인계받는 방식 등이 있지만 모든 고가용성 시스템이 같은 저장 구조나 정확히 두 노드를 사용하는 것은 아니다. 점대점 통신 방식, 악성코드, 모바일 장치의 관리자 권한 획득과는 목적이 다르다.
선지별 해설
- 여러 노드의 감시와 자원 인계를 통해 서비스 중단을 줄이는 고가용성 솔루션이다.
- 점대점은 두 종단의 연결 형태이며 고가용성 관리 기능 자체를 뜻하지 않는다.
- Stuxnet은 산업 제어 환경을 겨냥한 악성코드의 이름이다.
- Rooting은 장치에서 관리자 수준의 권한을 얻는 행위로 클러스터 가용성과 다르다.
편집 해설 근거: IBM, HACMP 5.5 Planning Guide — Planning an HACMP Cluster — cluster nodes, shared resources and resource groups; IBM Cloud Docs, Getting started with PowerHA Automation (2026-10-05 확인) — Getting started — PowerHA SystemMirror
83. 많은 위조 출발지 MAC 주소로 스위치의 MAC 학습 테이블 자원을 소모시켜 미학습 목적지 프레임의 플러딩을 유도하려는 공격을 이 문항의 용어로 무엇이라 하는가?
[학습용 개정문항]
- Parsing
- LAN Tapping
- Switch Jamming
- FTP Flooding
정답과 해설 보기
정답: 3
정답은 ③이다. MAC 플러딩은 많은 출발지 MAC 주소를 학습시키려 하여 스위치의 MAC 주소 테이블 자원을 소모시키는 공격이다. 그 결과 정상 목적지를 학습하지 못하면 알려지지 않은 유니캐스트 프레임이 같은 VLAN의 여러 포트로 전달되는 상황을 유도할 수 있다. 이 문항에서 Switch Jamming은 그 공격을 가리킨다. 스위치가 항상 모든 트래픽을 무조건 허브처럼 전달하는 것은 아니며 테이블 처리 방식과 포트 보안·플러딩 제한 설정에 따라 영향이 달라진다.
선지별 해설
- Parsing은 입력을 구문 분석하는 처리로 MAC 학습 테이블 소모 공격의 명칭이 아니다.
- LAN Tapping은 통신을 가로채거나 관찰하는 행위를 가리키며 제시한 테이블 소모 기법과 구별한다.
- 이 문항의 Switch Jamming은 MAC 플러딩에 의한 학습 테이블 교란을 뜻한다.
- FTP Flooding은 FTP 서비스 자원을 대상으로 하는 공격 유형으로 제시한 계층과 다르다.
편집 해설 근거: Cisco, Unified Wireless Security Integration — MAC Flooding Attack — MAC Flooding Attack; Port Security; Cisco, MAC Address and MAC Address Table Management — MAC Address Table — Unknown destination (flooding)
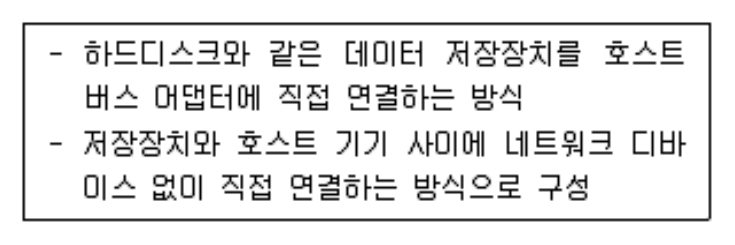
84. 다음 내용이 설명하는 스토리지 시스템은?
- DAS
- NAS
- BSA
- NFC
정답과 해설 보기
정답: 1
정답은 ①이다. DAS(Direct-Attached Storage)는 저장장치를 호스트에 직접 연결하여 사용하는 저장 구조다. 그림처럼 호스트 버스 어댑터나 장치 인터페이스를 통해 연결하며 별도의 네트워크 파일 서버를 경유하는 NAS와 구별한다. 직접 연결이라는 분류는 저장장치가 반드시 본체 내부에 있어야 한다는 뜻이 아니어서 외장 장치도 연결 방식에 따라 DAS가 될 수 있다. NAS는 네트워크를 통한 파일 서비스이고 NFC는 근거리 무선 통신 기술이므로 저장 구조의 분류와 다르다.
선지별 해설
- 호스트에 직접 연결한 저장장치라는 정의와 일치한다.
- NAS는 네트워크를 통해 파일 저장 서비스를 제공한다.
- BSA는 이 문항이 설명한 직접 연결 저장 구조의 명칭이 아니다.
- NFC는 근거리 무선 통신 기술이다.
편집 해설 근거: IBM, What Is Data Storage?, Data storage systems and architectures (2026-10-05 확인) — Data storage systems and architectures — Direct-attached storage (DAS)
85. 취약점 관리를 위해 일반적으로 수행하는 작업이 아닌 것은?
- 무결성 검사
- 응용 프로그램의 보안 설정 및 패치(Patch) 적용
- 중단 프로세스 및 닫힌 포트 위주로 확인
- 불필요한 서비스 및 악성 프로그램의 확인과 제거
정답과 해설 보기
정답: 3
정답은 ③이다. 취약점 관리는 공격에 노출된 서비스와 소프트웨어, 설정 및 변경 상태를 파악하고 필요한 조치를 적용하는 활동이다. 실행 중인 프로세스와 열려 있는 포트는 실제 접근 경로를 보여주므로 우선 점검해야 한다. 중단된 프로세스와 닫힌 포트만 주로 확인하면 현재 노출된 경로를 놓칠 수 있다. 무결성 확인, 보안 설정, 패치, 불필요한 서비스와 악성 프로그램의 제거는 위험을 줄이는 데 필요한 활동이다. 삭제나 패치도 업무 의존성과 검증을 고려해 수행한다.
선지별 해설
- 예상치 못한 파일·설정 변경을 확인하는 데 도움이 된다.
- 알려진 취약점을 수정하고 안전한 설정을 적용하는 활동이다.
- 현재 동작하는 프로세스와 열린 포트를 놓치는 편향된 점검이다.
- 불필요한 공격 표면과 악성 요소를 줄이는 활동이다.
편집 해설 근거: NIST SP 800-123 — General Server Security — §4.2.1 Remove or Disable Unnecessary Services, Applications, and Network Protocols; §6.4 Security Testing Servers
86. 소프트웨어 생명주기 모델 중 V 모델과 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 요구 분석과 설계를 생략하고 통합 테스트만 수행하는 모형이다.
- 개발 단계와 그 결과를 확인할 시험 수준을 대응시킨다.
- 개발 활동과 검증 활동 사이의 관계를 명확히 드러낸다.
- 요구·설계 단계부터 관련 시험을 준비해 조기 결함 발견을 지원한다.
정답과 해설 보기
정답: 1
정답은 ①이다. V 모형은 요구사항과 설계 등의 개발 활동을 그 결과를 확인하는 시험 수준과 대응시켜 나타낸다. 요구·설계 단계부터 관련 시험의 기준과 계획을 마련해 결함을 이르게 발견하도록 한다는 점이 핵심이다. 따라서 요구 분석과 설계를 생략하고 통합 테스트만 수행한다는 설명은 틀렸다. 세부적인 단계 이름이나 대응 관계는 적용 방법에 따라 달라질 수 있지만 개발 산출물과 검증 활동을 연결한다는 원칙은 유지된다. 모델을 사용한다는 사실만으로 신뢰성이 자동 보장되는 것은 아니다.
선지별 해설
- 요구 분석과 설계는 시험의 근거가 되므로 생략하지 않는다.
- 각 개발 단계에 대응하는 시험을 함께 고려하여 계획한다.
- 개발 활동과 시험 수준 사이의 연결을 명확히 보여준다.
- 개발 초기에 시험 준비를 시작하여 조기 결함 발견을 도울 수 있다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §2.1.1 Software Development and Software Testing — sequential models and V-model
87. 블루투스의 역사적인 공격·분석 기법과 그 설명이 올바르게 연결된 것은?
[학습용 개정문항]
- BlueBug: OPP를 통한 장치 파일 열람만을 뜻한다.
- BlueSnarf: 익명 명함 등 원치 않는 메시지를 보내는 행위다.
- BluePrinting: 장치가 공개하는 특성으로 제조사·모델 등을 식별하는 기법이다.
- BlueJacking: 취약한 연결 관리를 이용해 장치 기능을 무단 제어하는 공격이다.
정답과 해설 보기
정답: 3
정답은 ③이다. Blueprinting은 블루투스 기기가 공개하는 주소·서비스 정보 등의 특성을 조합해 제조사나 모델 등을 식별하는 분석 기법이다. 단순히 악성 명함을 보내는 행위나 기기 데이터를 훔치는 행위와 구별한다. Bluejacking은 원치 않는 메시지를 보내는 행위, Bluesnarfing은 허가 없이 정보를 얻는 공격, Bluebugging은 취약한 장치의 기능을 무단 제어하는 공격에 초점이 있다. 정찰에 이용될 수 있는 식별 기법과 직접적인 정보 탈취·제어 행위를 같은 의미로 취급하지 않아야 한다.
선지별 해설
- Bluebugging은 장치 기능의 무단 제어가 핵심으로 단순 파일 열람 정의와 다르다.
- 익명의 원치 않는 메시지 전송은 Bluejacking 쪽 설명이다.
- 장치 특성으로 제조사·모델 등을 알아내는 Blueprinting의 설명이다.
- Bluejacking의 핵심은 원치 않는 메시지 전송이며 취약한 연결 제어 자체의 일반 명칭이 아니다.
편집 해설 근거: Herfurt·Mulliner, trifinite.org Blueprinting (2004) — Method — Bluetooth Device Address; Service Discovery Protocol Records; NIST SP 800-121 Rev.2 Update 1, Guide to Bluetooth Security (2022 갱신) — §4.2 Bluetooth Threats — Bluesnarfing, Bluebugging, Bluejacking
88. DoS(Denial of Service) 공격과 관련한 내용으로 틀린 것은?
[학습용 개정문항]
- Ping of Death는 재조립 크기가 IP 허용 범위를 넘는 비정상 조각 처리의 취약점을 악용한 역사적 공격이다.
- Smurf는 멀티캐스트를 핵심 수단으로 삼아 ICMP 응답을 증폭시키는 공격이다.
- SYN Flooding은 미완료 TCP 연결 상태 등의 자원을 소모시켜 정상 접속을 방해한다.
- Land는 출발지와 목적지 IP 주소 및 포트를 같게 만든 비정상 패킷 처리를 악용한 역사적 공격이다.
정답과 해설 보기
정답: 2
정답은 ②이다. Smurf 공격은 피해자의 주소를 출발지로 위조한 ICMP 요청과 브로드캐스트 응답 증폭을 이용하는 방식으로 설명되며 멀티캐스트가 핵심이라는 보기는 틀렸다. Ping of Death는 재조립 길이가 IP의 허용 범위를 넘는 비정상 조각을 처리하는 취약점과 관련되고, SYN 플러딩은 미완료 TCP 연결 상태 등의 자원을 소모시킨다. Land는 출발지와 목적지 주소·포트를 같게 만든 비정상 패킷의 처리를 악용한 역사적인 공격이다. 일반적인 정상 단편화 자체는 공격이 아니다.
선지별 해설
- 허용 크기를 넘도록 조합되는 비정상 IP 조각의 재조립 취약점과 관련된 설명이다.
- Smurf의 대표적인 증폭 수단은 브로드캐스트이며 멀티캐스트로 바꾸면 틀린 설명이다.
- 미완료 연결 상태가 쌓여 정상 접속 처리를 방해하는 공격이다.
- 동일한 출발지·목적지 주소와 포트를 가진 비정상 패킷 처리를 악용한 설명이다.
편집 해설 근거: RFC 2644, Changing the Default for Directed Broadcasts in Routers (1999) — §2 Background; IETF RFC 4732, Internet Denial-of-Service Considerations (2006) — §2.1.1 Single-Packet Attacks; IETF RFC 4987, TCP SYN Flooding Attacks and Common Mitigations (2007) — §3 Attack Description; CERT/CC Advisory CA-97.28, IP Denial-of-Service Attacks (1997, OpenNET 보존 사본) — I. Description — identical source/destination address and port
89. 공격자의 관심을 유도하기 위해 마련하고, 비정상 접근과 공격 행동을 관찰·분석하는 데 사용하는 유인용 시스템은?
[학습용 개정문항]
- Apache
- Hadoop
- Honeypot
- MapReduce
정답과 해설 보기
정답: 3
정답은 ③이다. 허니팟은 공격자의 관심을 유도하고 접근이나 행동을 관찰하기 위해 의도적으로 마련한 유인용 시스템이다. 실제 업무 시스템과 비슷해 보이도록 구성하여 어떤 행위가 시도되는지 정보를 수집할 수 있다. Apache는 여러 소프트웨어 프로젝트에 쓰이는 이름이고, Hadoop은 분산 데이터 처리 체계, MapReduce는 분산 계산 모형이다. 허니팟을 둔다고 모든 공격을 막는 것은 아니며 탐지·분석을 돕는 목적과 업무 시스템의 정상 서비스를 제공하는 목적을 구별해야 한다.
선지별 해설
- Apache라는 이름만으로 공격자를 유인하는 시스템을 뜻하지 않는다.
- Hadoop은 분산 저장·처리를 위한 소프트웨어 체계다.
- 공격자의 접근을 유도하고 행동을 관찰하는 유인 시스템이다.
- MapReduce는 큰 계산을 분산 처리하는 프로그래밍 모형이다.
편집 해설 근거: NIST CSRC Glossary — honeypot — honeypot 정의
90. 다음이 설명하는 IT 기술은?
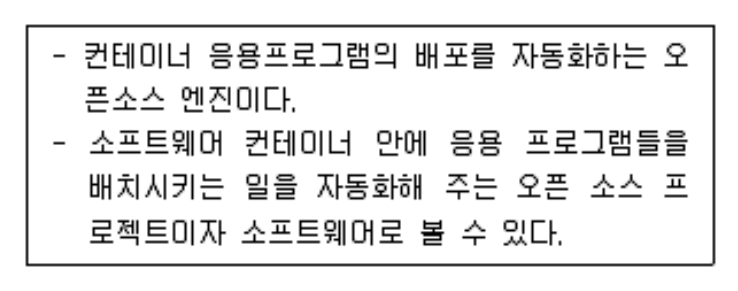
- StackGuard
- Docker
- Cipher Container
- Scytale
정답과 해설 보기
정답: 2
정답은 ②이다. Docker Engine은 이미지를 바탕으로 컨테이너를 만들고 실행·관리하는 컨테이너 기술의 핵심 구성 요소다. 응용 프로그램과 필요한 실행 환경을 이미지로 묶어 배포하고 동일한 이미지에서 컨테이너를 시작할 수 있어 그림의 설명과 맞는다. StackGuard는 스택 손상 탐지를 위한 보호 기법이고 Scytale은 고전적인 전치 암호 도구다. 컨테이너는 호스트 운영체제의 기능을 활용하므로 가상 머신과 완전히 같은 격리 방식이 아니며 제품군 전체의 라이선스를 그림의 엔진 설명만으로 일반화하지 않는다.
선지별 해설
- StackGuard는 스택 기반 메모리 손상을 탐지·방어하는 기법이다.
- 이미지와 컨테이너를 만들고 실행하는 Docker Engine에 해당한다.
- Cipher Container는 제시한 범용 컨테이너 엔진의 이름이 아니다.
- Scytale은 막대에 감는 방식으로 알려진 고전 전치 암호 도구다.
편집 해설 근거: Docker 공식 문서, Docker Engine — Docker Engine — client-server technology; daemon, APIs and CLI; Docker Docs, What is a container? — §2.1 Application Containers
91. 간트 차트(Gantt Chart)에 대한 설명으로 틀린 것은?
- 프로젝트를 이루는 소작업 별로 언제 시작되고 언제 끝나야 하는지를 한 눈에 볼 수 있도록 도와준다.
- 자원 배치 계획에 유용하게 사용된다.
- CPM 네트워크로부터 만드는 것이 가능하다.
- 수평 막대의 길이는 각 작업(Task)에 필요한 인원수를 나타낸다.
정답과 해설 보기
정답: 4
정답은 ④이다. 간트 차트는 시간 축 위에 작업의 시작과 종료를 막대로 나타내어 작업 일정과 기간을 파악하게 한다. 막대의 길이는 작업에 배정된 시간 구간을 나타내며 필요한 사람의 수를 직접 표시하는 값이 아니다. 일정과 자원 배정을 함께 보면 특정 시점의 작업 겹침이나 인력 수요를 검토하는 데 도움이 된다. CPM으로 구한 시작·종료 일정도 막대 차트로 표현할 수 있지만, 단순한 막대만으로 모든 선후 관계나 자원 제약이 자동 해결되는 것은 아니다.
선지별 해설
- 작업의 시작·종료 시점을 시간 축에서 확인할 수 있다.
- 일정과 자원 배정을 함께 검토하여 계획에 활용할 수 있다.
- 네트워크 분석으로 정한 일정을 시간 축의 막대로 표현할 수 있다.
- 가로 막대는 시간 구간을 나타내므로 인원수라는 설명은 틀렸다.
편집 해설 근거: Microsoft Project, Work with the Gantt Chart view — Use the chart — Gantt bars and timeline
92. Python 기반의 웹 크롤링(web Crawling) 프레임워크로 옳은 것은?
- Li-fi
- Scrapy
- CrawlCat
- SBAS
정답과 해설 보기
정답: 2
정답은 ②이다. Scrapy는 Python으로 웹 사이트를 순회하고 필요한 구조화 데이터를 추출하는 응용 프레임워크다. Spider에 시작 주소와 응답 처리 방법을 정하고, 응답에서 자료를 추출하거나 다음 요청을 생성하는 방식으로 사용할 수 있다. 따라서 Python 기반 웹 크롤링 프레임워크를 묻는 이 문항에 맞는다. Li-Fi는 빛을 사용하는 무선 통신 계열 용어이고 SBAS는 위성 기반 보정 시스템 용어다. 도구를 사용할 때에는 대상 사이트의 접근 조건과 요청 빈도도 고려해야 한다.
선지별 해설
- Li-Fi는 광 무선 통신 분야 용어로 제시한 프레임워크와 다르다.
- Python 기반 크롤링과 구조화 데이터 추출을 지원하는 프레임워크다.
- 이 문항이 가리키는 Python 크롤링 프레임워크의 이름은 Scrapy다.
- SBAS는 위성 기반 보정 시스템으로 웹 크롤링 도구가 아니다.
편집 해설 근거: Scrapy 2.7 공식 문서, Scrapy at a glance — Scrapy at a glance; Walk-through of an example spider
93. Secure 코딩에서 입력 데이터의 보안 약점과 관련한 설명으로 틀린 것은?
- SQL 삽입 : 사용자의 입력 값 등 외부 입력 값이 SQL 쿼리에 삽입되어 공격
- 크로스사이트 스크립트 : 검증되지 않은 외부 입력 값에 의해 브라우저에서 악의적인 코드가 실행
- 운영체제 명령어 삽입 : 운영체제 명령어 파라미터 입력 값이 적절한 사전검증을 거치지 않고 사용되어 공격자가 운영체제 명령어를 조작
- 자원 삽입 : 사용자가 내부 입력 값을 통해 시스템 내에 사용이 불가능한 자원을 지속적으로 입력함으로써 시스템에 과부하 발생
정답과 해설 보기
정답: 4
정답은 ④이다. 자원 삽입은 신뢰할 수 없는 입력을 파일명·포트 등 자원 식별자로 사용할 때 적절히 제한하지 않아 의도한 권한 범위를 벗어난 자원 접근이 가능해지는 약점이다. 내부 입력을 계속 넣어 과부하를 일으킨다는 설명은 자원 식별자 통제 실패라는 핵심을 놓친다. SQL 삽입은 입력이 SQL 명령 구조에 영향을 주는 문제이고, XSS는 신뢰할 수 없는 데이터가 브라우저에서 실행 가능한 코드로 해석되는 문제다. 입력을 단순히 받아들였다는 사실만으로 항상 취약한 것은 아니며 사용 맥락에 맞는 분리·검증이 필요하다.
선지별 해설
- 외부 입력이 SQL 명령 구조를 바꾸는 상황을 설명한다.
- 신뢰할 수 없는 입력이 실행 가능한 웹 코드로 해석되는 상황을 설명한다.
- 명령어 구성에 사용한 입력으로 운영체제 명령을 조작하는 상황을 설명한다.
- 자원 식별자 통제 실패를 설명해야 하며 단순한 내부 입력 과부하와 다르다.
편집 해설 근거: MITRE CWE-99, Improper Control of Resource Identifiers — Description; Extended Description; OWASP — SQL Injection Prevention — Primary Defenses; OWASP, Cross Site Scripting Prevention Cheat Sheet — Introduction
94. Windows의 NTFS 파일 시스템에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 파일·폴더별 ACL 접근권한 설정을 지원하지 않는다.
- 운영체제 버전과 클러스터 크기에 따라 큰 볼륨을 지원한다.
- 조건에 맞는 파일 시스템 압축을 사용해 공간을 절약할 수 있다.
- 로그와 체크포인트로 장애 후 파일 시스템 일관성 복구를 돕는다.
정답과 해설 보기
정답: 1
정답은 ①이다. NTFS는 파일과 폴더별 접근 제어 목록(ACL)을 지원하므로 사용자·그룹마다 읽기·쓰기 등 권한을 세밀하게 지정할 수 있다. 따라서 ACL을 지원하지 않는다는 설명은 틀리다. 큰 볼륨의 지원 범위는 Windows 버전과 클러스터 크기 등에 따라 달라지며 파일 시스템 압축도 적용 조건을 고려해야 한다. 로그와 체크포인트는 장애 후 파일 시스템 일관성 복구를 돕는다. 이런 기능이 있다고 모든 데이터 손실이나 보안 사고를 막는 것은 아니며 일괄적인 속도 우열도 단정할 수 없다.
선지별 해설
- NTFS는 파일·폴더별 ACL 접근 제어를 지원한다.
- 최대 볼륨 크기 등은 운영체제 버전과 클러스터 크기에 영향을 받는다.
- 지원 조건에 맞는 파일 시스템 압축을 사용할 수 있다.
- 로그와 체크포인트는 파일 시스템 일관성을 복구하는 데 쓰인다.
편집 해설 근거: Microsoft Learn, NTFS overview — Increased reliability; Increased security; Support for large volumes; Flexible allocation of capacity
95. DES에서 한 번의 암호 변환이 처리하는 데이터 블록의 길이는 몇 비트인가? 키 길이를 묻는 것이 아니다.
[학습용 개정문항]
- 8
- 24
- 64
- 132
정답과 해설 보기
정답: 3
정답은 ③이다. DES는 데이터를 64비트 블록으로 나누어 처리하는 대칭키 블록 암호다. 여기서 묻는 값은 한 번의 암호 변환이 처리하는 데이터 블록 길이이므로 64를 선택한다. DES 키는 패리티 비트를 포함하여 64비트로 표현되지만 실제 암호 연산에 쓰이는 유효 키 길이는 56비트이므로 블록 길이와 구별해야 한다. 8비트 패리티를 유효 키 강도에 더해서는 안 된다. 이 설명은 역사적인 알고리즘의 구조에 관한 것이며 철회된 DES를 새로운 시스템에 사용하라는 권고가 아니다.
선지별 해설
- 8비트는 DES의 데이터 블록 길이가 아니다.
- 24비트 블록을 처리하는 알고리즘이 아니다.
- DES가 처리하는 데이터 블록은 64비트다.
- 132비트는 DES 블록 길이와 일치하지 않는다.
편집 해설 근거: NIST FIPS 46-3, Data Encryption Standard (1999), 2005년 철회된 역사 자료 — DATA ENCRYPTION ALGORITHM — Introduction and key parity footnote
96. 기본 ACL이 없는 디렉터리에서 일반 파일을 요청 권한 0666(8진수)으로 만들었고, 이후 권한 변경 없이 실제 권한이 0644가 되었다. 보기 중 이에 해당하는 umask 값은?
[학습용 개정문항]
- 022
- 666
- 777
- 755
정답과 해설 보기
정답: 1
정답은 ①이다. 이 조건에서 새 파일 권한은 요청 권한과 umask의 비트 반전을 AND한 값이다. 따라서 0666 & ~0022 = 0644가 되어 소유자는 읽기·쓰기, 그룹과 다른 사용자는 읽기 권한을 갖는다. 0666에서 그룹·기타 사용자의 쓰기 비트를 제거한 결과다. umask는 일반적인 산술 뺄셈이 아니라 권한 비트를 끄는 마스크이다. 요청 권한에 실행 비트가 없으므로 0023 등도 같은 결과를 만들 수 있지만, 제시한 네 보기 중 조건을 만족하는 것은 022뿐이다.
선지별 해설
- 0666에서 그룹·기타 사용자의 쓰기 비트를 끄면 0644가 된다.
- 0666 & ~0666은 0000이므로 조건과 다르다.
- 0666 & ~0777은 0000이므로 조건과 다르다.
- 0666 & ~0755는 0022이므로 조건과 다르다.
편집 해설 근거: Linux man-pages, umask(2) — DESCRIPTION — mode argument 0666 and permission-bit masking
97. 다음 내용이 설명하는 로그 파일은?
- tapping
- xtslog
- linuxer
- wtmp
정답과 해설 보기
정답: 4
정답은 ④이다. 전통적인 Linux 로그인 기록에서 wtmp는 로그인·로그아웃 이력과 시스템 종료·재시작 등의 기록을 남기는 데 사용된다. 현재 접속 상태를 중심으로 조회하는 utmp와 누적 이력을 구별해야 한다. 보통 /var/log/wtmp에 저장되며 일반 텍스트 줄의 집합이 아니라 구조화된 이진 레코드이므로 last 같은 전용 도구로 읽는다. 실제 기록 여부는 시스템과 프로그램 설정에 달려 있어 모든 환경이 같은 파일을 항상 갱신한다고 가정해서는 안 된다.
선지별 해설
- tapping은 이 문항에서 설명한 로그인 이력 파일명이 아니다.
- xtslog는 제시한 전통적인 로그인 이력 파일명이 아니다.
- linuxer는 제시한 종료·재시작 이력 파일명이 아니다.
- wtmp는 로그인·로그아웃 및 시스템 종료·재시작 이력을 기록하는 파일이다.
편집 해설 근거: Linux man-pages — utmp(5), wtmp login records — DESCRIPTION — wtmp records; FILES; SEE ALSO last(1)
98. LOC 규모 예측에 세 점 추정 방식을 적용할 때 사용하는 세 가지 입력에 해당하지 않는 것은?
[학습용 개정문항]
- 낙관치
- 중간치(가장 가능성이 높은 규모)
- 비관치
- 모형치
정답과 해설 보기
정답: 4
정답은 ④이다. 세 점 추정에서는 낙관적인 규모, 가장 가능성이 높은 규모, 비관적인 규모를 각각 잡아 불확실성을 표현한다. 이 세 값을 이용해 하나의 예측치를 구할 때 관례적으로 (낙관치 + 4×중간치 + 비관치)/6 같은 가중 평균을 사용하기도 한다. 모형치는 이 세 입력 중 하나의 명칭이 아니다. 가장 가능성이 높은 중간 추정값과 세 값을 결합한 기대·예측값은 서로 다른 개념이므로 모두 기대치라고 부르면 혼동할 수 있다. 이 식이 실제 코드 규모를 보장하지도 않는다.
선지별 해설
- 상대적으로 작은 규모가 필요한 상황의 추정 입력이다.
- 가장 가능성이 높다고 판단하는 규모의 추정 입력이다.
- 상대적으로 큰 규모가 필요한 상황의 추정 입력이다.
- 낙관·중간·비관이라는 세 점 추정 입력에 포함되지 않는 명칭이다.
편집 해설 근거: R. G. Batson, NASA TM-100311 Program Risk Analysis Handbook (1987) — E. Analytical Technique for Schedule Risk Assessment — Steps 1–2 (PDF p.30)
99. 패킷의 헤더뿐 아니라 접근 가능한 페이로드까지 분석하여 응용 트래픽 식별과 정책 판단 등에 활용하는 심층 패킷 검사 기술은?
[학습용 개정문항]
- PLCP(Packet Level Control Processor)
- Traffic Distributor
- Packet Tree
- DPI(Deep Packet Inspection)
정답과 해설 보기
정답: 4
정답은 ④이다. DPI는 단순한 주소·포트 확인을 넘어 패킷의 접근 가능한 내용과 프로토콜 정보를 분석하는 심층 패킷 검사다. 응용 트래픽을 식별하거나 정책 적용·이상 징후 탐지의 판단 자료로 사용할 수 있다. 다만 암호화된 페이로드는 적절한 복호화 수단 없이 원문을 임의로 읽을 수 없고, 모든 OSI 계층의 모든 내용을 항상 파악한다는 뜻도 아니다. 트래픽을 분산하는 장치나 임의의 자료 구조 이름은 이 분석 기법 자체의 명칭과 구별한다.
선지별 해설
- PLCP라는 약어는 여기서 묻는 심층 패킷 검사 기술의 명칭이 아니다.
- 트래픽 분배라는 역할만으로 페이로드를 검사하는 기술을 뜻하지 않는다.
- Packet Tree는 제시한 심층 패킷 검사 기법의 표준 명칭이 아니다.
- DPI는 접근 가능한 패킷 내용까지 분석하는 심층 패킷 검사다.
편집 해설 근거: Juniper Networks, What is application visibility and control? — How Does Application Visibility and Control Work?; SSL decryption capabilities
100. 소프트웨어 개발 방법론의 테일러링(Tailoring)과 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 예상되는 변화를 검토 대상에서 배제하고 절차를 빠르게 적용한다.
- 프로젝트 특성에 맞게 개발 활동과 산출물 등을 조정한다.
- 위험과 제약을 식별하여 필요한 관리 활동을 정한다.
- 프로젝트에 적합한 기술 요소와 기법·도구를 선택한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 테일러링은 프로젝트의 규모·특성·위험·제약에 맞게 개발 과정과 적용 활동, 산출물 등을 조정하는 일이다. 따라서 예상되는 변화를 검토 대상에서 배제한 채 속도만 높이는 것은 적절한 설명이 아니다. 관리 측면에서는 위험과 필요한 통제를 고려하고, 기술 측면에서는 대상 시스템과 팀에 적합한 기법·도구를 선택한다. 필요한 절차를 근거 없이 빼는 것과도 구별해야 한다. 조정 이유와 적용 범위를 남겨 이후의 변경과 검토에 활용하는 것이 중요하다.
선지별 해설
- 예상되는 변화와 위험은 조정 기준에 포함해야 하므로 배제하는 설명은 틀렸다.
- 프로젝트 상황에 맞게 활동과 산출물을 조정하는 것이 핵심이다.
- 위험과 제약을 파악하여 필요한 관리 활동을 정할 수 있다.
- 대상 시스템과 팀의 여건에 적합한 기법·도구를 선택한다.
편집 해설 근거: NASA NPR 7150.2D, Software Engineering Requirements — §2.2 Principles Related to Tailoring Requirements, especially §2.2.1–2.2.2
정보처리기사 필기 기출문제 학습 방법
먼저 PDF 문제지를 시간에 맞춰 푼 뒤, 이 글에서 오답의 정답·해설·근거를 확인하세요. 법규 문항은 근거 기준일 이후 개정 여부도 함께 확인하는 것이 안전합니다.