
문제지 PDF · 웹 정답 해설
정보처리기사 필기 2021년 2회 공개기출 100문항
정보처리기사 필기 2021년 2회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.

© 자격증3001. 이 정보처리기사 필기 기출문제 게시물의 문제 재구성 문장, 해설, 재작성 도식, 편집 및 PDF 디자인은 자격증3001의 저작권 보호를 받습니다. 국가기술자격 시험 및 관련 명칭의 권리는 해당 기관에 있으며, 본 자료는 Q-Net 공식 문제지 또는 공식 해설이 아닙니다. 무단 복제·재배포를 금합니다.
정보처리기사 필기 2021년 2회 공개기출 100문항 안내
정보처리기사 필기 2021년 2회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.
이 회차의 100문항 해설을 문항별 기술 원문과 필요한 독립 계산으로 편집 검토했습니다. 질문·조건·보기를 고친 문항은 학습용 개정문항으로 표시합니다. 원 시험의 공식 원문이나 공식 정답표를 새로 확인한 자료는 아닙니다.
정보처리기사 필기 기출문제 · 소프트웨어 설계
1. 시스템을 입력·처리·출력·피드백·제어의 기능 요소로 설명하는 모형에서, 이들 기능 요소의 명칭에 해당하지 않는 것은?
[학습용 개정문항]
- Process
- Feedback
- Maintenance
- Control
정답과 해설 보기
정답: 3
정답은 ③이다. 이 문항은 시스템의 동작을 입력·처리·출력과 피드백·제어로 나누어 보는 기능 모형을 전제로 한다. 처리는 입력을 결과로 바꾸며, 피드백은 출력이나 현재 상태에 관한 정보를 다시 전달하고, 제어는 목표와의 차이에 대응하여 동작을 조절한다. 유지보수는 결함 수정과 환경 변화 대응 등 시스템을 계속 사용할 수 있게 관리하는 활동이다. 따라서 제시한 모형의 기능 요소와 구별된다. 유지보수가 실제 시스템 운영에 필요하지 않다는 뜻은 아니다.
선지별 해설
- 입력을 변환하여 결과를 만드는 처리 기능이다.
- 결과나 상태 정보를 되돌려 보내는 기능이다.
- 시스템을 지속적으로 관리·수정하는 활동으로 제시한 기능 요소 분류와 다르다.
- 목표에 맞게 시스템의 동작을 조절하는 기능이다.
편집 해설 근거: Åström·Murray, Feedback Systems (2008, 2012 전자판), 저자 제공 원문 — Chapter 1 Introduction — What Is Feedback?; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — maintenance
2. 유스케이스(Usecase)에 대한 설명 중 옳은 것은?
- 유스케이스 다이어그램은 개발자의 요구를 추출하고 분석 하기 위해 주로 사용한다.
- 액터는 대상 시스템과 상호 작용하는 사람이나 다른 시스 템에 의한 역할이다.
- 사용자 액터는 본 시스템과 데이터를 주고받는 연동 시스 템을 의미한다.
- 연동의 개념은 일방적으로 데이터를 파일이나 정해진 형 식으로 넘겨주는 것을 의미한다.
정답과 해설 보기
정답: 2
정답은 ②이다. UML의 액터는 모델링 대상 시스템과 상호작용하는 외부 역할이다. 사람이 맡는 사용자 역할뿐 아니라 다른 소프트웨어나 외부 장치의 역할도 액터가 될 수 있다. 유스케이스는 외부 액터에게 가치 있는 결과를 제공하는 시스템의 행위를 나타내므로 개발자 개인의 요구만 추출하는 도구로 제한할 수 없다. 동일한 사람이 여러 액터 역할을 맡을 수도 있다. 시스템 연동도 송신만 가능한 방식으로 한정되지 않으며 요청과 응답 등 양방향 상호작용이 가능하다.
선지별 해설
- 외부 이해관계자가 원하는 시스템의 행위를 모델링하며 개발자 요구만 대상으로 삼지 않는다.
- 액터는 대상 시스템과 상호작용하는 사람·다른 시스템 등의 외부 역할이다.
- 사용자 액터와 연동 시스템 액터를 동일하게 정의할 수 없다.
- 연동은 단방향 파일 전달만을 의미하지 않는다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §18.1 Use Cases; §18.2.1 Actor
3. 그림의 요구사항 개발 활동을 도출한 요구를 분석하고 명세한 뒤 검증하는 대표적인 흐름으로 나열한 것은? 실제 활동은 반복될 수 있다.
[학습용 개정문항]
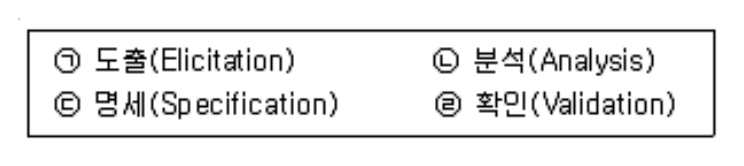
- ㉠ – ㉡ – ㉢ – ㉣
- ㉠ – ㉢ – ㉡ – ㉣
- ㉠ – ㉣ – ㉡ – ㉢
- ㉠ – ㉡ – ㉣ – ㉢
정답과 해설 보기
정답: 1
정답은 ①이다. 대표적인 요구사항 개발 흐름은 도출 → 분석 → 명세 → 검증이다. 도출에서는 이해관계자와 업무 자료에서 필요한 사항을 찾고, 분석에서는 충돌·누락·제약과 우선순위를 검토한다. 명세는 합의한 요구를 확인 가능한 형태로 기록하는 활동이며, 검증은 실제 필요와의 적합성·일관성 등을 확인하는 활동이다. 그림의 기호에 대응시키면 ㉠ → ㉡ → ㉢ → ㉣이다. 실제 프로젝트에서는 검토 결과에 따라 앞 활동으로 돌아가므로 반드시 한 번만 진행하는 고정 절차로 이해하지 않는다.
선지별 해설
- 도출·분석·명세·검증의 대표적인 흐름과 일치한다.
- 수집한 요구를 분석하는 활동보다 명세를 앞에 놓았다.
- 분석·명세보다 최종 검증 활동을 먼저 배치했다.
- 명세한 요구를 확인하는 검증보다 명세를 뒤에 놓았다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §2 Requirements Elicitation; §3 Requirements Analysis; §4 Requirements Specification; §5 Requirements Validation
4. 객체지향 기법에서 같은 클래스에 속한 각각의 객체를 의미 하는 것은?
- instance
- message
- method
- module
정답과 해설 보기
정답: 1
정답은 ①이다. 클래스는 공통된 속성과 동작을 기술하는 분류이며, 그 클래스에 속하는 구체적인 개별 객체를 인스턴스라고 한다. 예를 들어 학생 클래스에 속하는 두 학생 객체는 같은 속성 구조와 동작을 따르더라도 각각의 이름과 학번 등 상태가 다를 수 있다. 메시지는 객체 사이에 전달되는 요청이고 메서드는 동작의 구현이다. 모듈은 프로그램을 나누는 구성 단위를 가리킨다. 따라서 클래스의 개별 사례라는 질문에는 인스턴스가 대응한다.
선지별 해설
- 클래스에 속하는 구체적인 개별 객체를 뜻한다.
- 다른 객체에게 동작을 요청하거나 정보를 전달하는 개념이다.
- 객체가 수행하는 동작을 구현한 코드다.
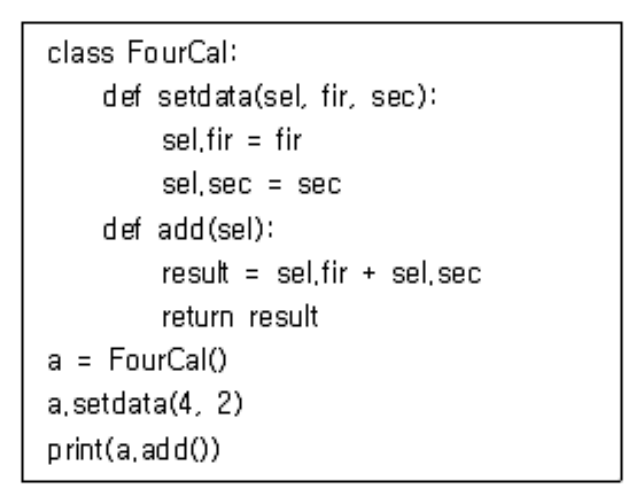
- 프로그램을 분리한 구성 단위로 개별 객체의 명칭과 다르다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §9.8 Instances; §11.4 Classes; Python 3 공식 자습서, 9 Classes — §9.3 A First Look at Classes
5. 객체지향 설계에서 외부가 알 필요 없는 내부 표현과 변경 가능한 설계 결정을 공개 인터페이스 뒤에 감추는 원칙은?
[학습용 개정문항]
- 조직화(Organizing)
- 상속(Inheritance)
- 정보 은닉(Information Hiding)
- 구조화(Structuring)
정답과 해설 보기
정답: 3
정답은 ③이다. 정보 은닉은 다른 모듈이나 객체가 알 필요 없는 내부 표현과 변경 가능성이 큰 구현 결정을 공개 인터페이스 뒤에 감추는 설계 원칙이다. 내부 구현을 바꾸더라도 외부가 의존하는 계약이 유지되면 변경의 영향을 제한할 수 있다. 캡슐화는 자료와 동작을 하나의 경계에 묶는 방식으로 정보 은닉을 지원할 수 있어 두 개념이 함께 설명되기도 한다. 원문에는 두 용어가 겹치는 선택지가 있어, 개정 문항에서는 내부 설계 결정의 은닉이라는 판정 기준과 보기를 명확히 했다.
선지별 해설
- 요소를 조직하는 일반적인 표현으로 내부 설계 결정의 은닉 원칙을 특정하지 않는다.
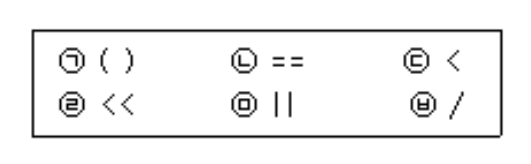
- 상속은 상위 형식의 특성과 동작을 이어받는 관계다.
- 외부의 불필요한 내부 구현 의존성을 제한하는 원칙이다.
- 구조화는 구성과 관계를 정리하는 넓은 개념이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Encapsulation; Separation of interface and implementation
6. GoF (Gangs of Four) 디자인 패턴에 대한 설명으로 틀린 것 은?
[학습용 개정문항]
- Factory Method는 생성 인터페이스를 정의하고 구체적인 생성 대상을 하위 클래스에서 정하도록 한다.
- Prototype은 원형 객체를 복제하여 새 객체를 만든다.
- Bridge의 핵심 목적은 기존 클래스의 인터페이스를 클라이언트가 요구하는 다른 인터페이스로 변환하는 것이다.
- Mediator는 여러 객체 사이의 상호작용을 중재 객체에 모아 조정한다.
정답과 해설 보기
정답: 3
정답은 ③이다. Bridge는 추상적인 기능과 그 구현을 분리하여 두 부분을 서로 독립적으로 확장할 수 있게 하는 구조 패턴이다. 기존 클래스의 인터페이스를 클라이언트가 기대하는 인터페이스에 맞추는 것은 Adapter의 핵심 목적이다. Factory Method는 구체적인 생성 대상을 하위 클래스가 결정하도록 하고, Prototype은 준비한 원형 객체를 복제하여 새 객체를 만든다. Mediator는 여러 객체 사이의 협력을 중재하는 객체를 두어 서로 직접 의존하는 복잡성을 줄인다.
선지별 해설
- 구체적인 객체 생성 결정을 하위 클래스에 맡기는 생성 패턴이다.
- 원형 객체의 복제로 객체를 만드는 생성 패턴이다.
- 인터페이스 변환은 Adapter의 설명이며 Bridge의 핵심 목적과 다르다.
- 객체 사이의 상호작용을 중재 객체로 모으는 행동 패턴이다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — p. 15 Design Space for GoF Patterns; pp. 68–69 Bridge — Intent, Applicability, Consequences
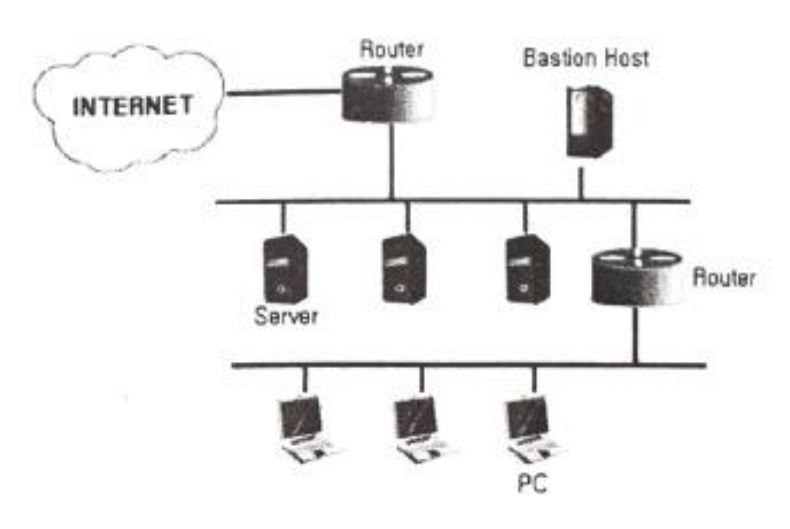
7. 요구사항 분석이 어려운 이유가 아닌 것은?
- 개발자와 사용자 간의 지식이나 표현의 차이가 커서 상호 이해가 쉽지 않다.
- 사용자의 요구는 예외가 거의 없어 열거와 구조화가 어렵 지 않다.
- 사용자의 요구사항이 모호하고 불명확하다.
- 소프트웨어 개발 과정 중에 요구사항이 계속 변할 수 있 다.
정답과 해설 보기
정답: 2
정답은 ②이다. 요구사항 분석에서는 이해관계자마다 다른 용어와 배경 지식, 암묵적인 업무 규칙, 누락된 예외 상황을 조정해야 한다. 사용자가 모든 요구를 처음부터 명확하고 완전하게 설명한다고 기대하기 어렵고 개발 중에 환경과 우선순위도 바뀔 수 있다. 그러므로 예외가 거의 없어 요구의 열거와 구조화가 쉽다는 설명은 요구 분석의 일반적인 어려움을 나타내지 않는다. 인터뷰·워크숍·모델·시제품 등을 사용하여 공통 이해를 쌓고 필요한 내용을 반복해서 확인한다.
선지별 해설
- 서로 다른 용어와 업무 지식은 의사소통을 어렵게 할 수 있다.
- 예외가 드물어 분석이 쉽다는 진술은 어려움의 원인에 해당하지 않는다.
- 모호한 요구는 해석 차이와 누락을 만들 수 있다.
- 환경과 이해의 변화에 따라 요구도 바뀔 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §2 Requirements Elicitation; §3 Requirements Analysis
8. ISO/IEC 25010:2011 제품 품질 모형의 품질 특성 또는 하위 특성 명칭에 해당하지 않는 것은? 이 문항은 2011년 판을 기준으로 한다.
[학습용 개정문항]
- 가용성 (Availability)
- 독립성 (Isolation)
- 변경 용이성 (Modifiability)
- 사용성(Usability)
정답과 해설 보기
정답: 2
정답은 ②이다. 이 문항에 명시한 ISO/IEC 25010:2011 제품 품질 모형에서 가용성은 신뢰성의 하위 특성이고 변경 용이성은 유지보수성의 하위 특성이다. 사용성은 그 자체로 주요 품질 특성이다. 반면 Isolation은 이 판의 제품 품질 특성·하위 특성 목록에 제시된 명칭이 아니다. 다만 격리나 독립성이 모든 시스템에서 품질과 무관하다는 뜻은 아니다. 트랜잭션 격리와 장애 격리 등 다른 문맥에서는 중요한 요구가 될 수 있으며, 여기서는 특정 표준의 명칭을 비교한다.
선지별 해설
- 2011년 모형에서 신뢰성의 하위 특성이다.
- 해당 판의 품질 특성·하위 특성 목록에 없는 명칭이다.
- 2011년 모형에서 유지보수성의 하위 특성이다.
- 2011년 모형의 주요 제품 품질 특성이다.
편집 해설 근거: ISO/IEC 25010:2011, Software quality model (문항에 명시한 구판) — §4.2 Product quality model; §4.2.4 Usability; §4.2.5.2 Availability; §4.2.7.4 Modifiability
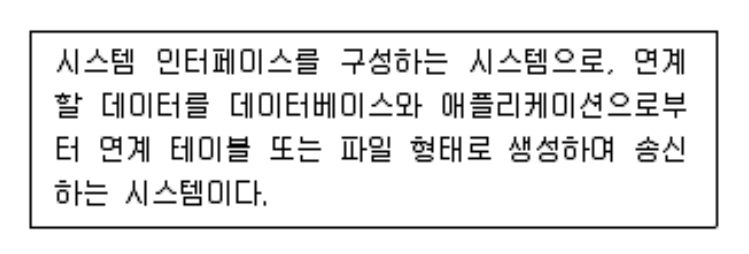
9. 다음 설명에 해당하는 시스템으로 옳은 것은?
- 연계 서버
- 중계 서버
- 송신 시스템
- 수신 시스템
정답과 해설 보기
정답: 3
정답은 ③이다. 그림은 연계할 원천 데이터를 자신의 데이터베이스나 응용 프로그램에서 찾아 연계 테이블 또는 파일을 만드는 쪽을 설명한다. 다른 시스템으로 보낼 자료를 준비하는 역할이므로 송신 시스템이다. 수신 시스템은 전달받은 자료를 해석하고 자신의 업무 처리에 반영하는 쪽이다. 중계 서버나 연계 서버는 두 시스템 사이의 전달·변환 등을 맡을 수 있지만, 이름만으로 원천 데이터를 소유하고 보내는 역할을 뜻하지는 않는다. 역할은 해당 데이터 흐름의 방향을 기준으로 판단한다.
선지별 해설
- 연계를 지원하는 서버라는 넓은 명칭으로 그림의 원천 송신 역할을 특정하지 않는다.
- 전달을 매개하는 역할과 원천 자료를 준비하는 역할은 구별된다.
- 자신의 자료를 추출·가공하여 다른 시스템으로 보내는 역할이다.
- 다른 시스템에서 온 자료를 받아 사용하는 역할이다.
편집 해설 근거: Hohpe·Woolf, Enterprise Integration Patterns — Introduction to Messaging Systems — Basic Messaging Concepts — Channels; Messages; Endpoints
10. 요구 분석·설계 산출물을 작성하고 관리하는 CASE 지원 기능과 가장 거리가 먼 것은?
[학습용 개정문항]
- 구조적 모델의 작성·분석
- 요구 확인을 위한 프로토타입 작성
- 산출물과 관계를 보관하는 정보 저장소
- 일반 운영 작업의 일괄 실행 시간을 예약하는 기능만 제공
정답과 해설 보기
정답: 4
정답은 ④이다. CASE는 요구·설계·구현·시험 등 소프트웨어 공학 활동을 도구로 지원하는 접근이다. 구조적 모델의 작성, 시제품을 통한 요구 확인, 산출물을 보관하고 연결하는 저장소는 개발 정보를 표현하고 관리하는 기능과 연결된다. 반면 단순한 운영 작업의 일괄 실행 예약만으로는 요구 분석과 설계 모델을 작성·관리하는 기능이라고 할 수 없다. 실제 CASE 도구 내부에 배치 처리가 쓰일 수 있으므로 일괄 처리 기술 자체가 CASE에 절대 사용되지 않는다고 단정해서는 안 된다.
선지별 해설
- 요구와 처리 흐름을 구조적인 모델로 표현하는 데 쓰인다.
- 시제품을 만들어 요구나 설계안을 확인할 수 있다.
- 개발 산출물과 그 관계를 보관·관리할 수 있다.
- 일반 작업의 실행 예약만으로는 요구·설계 모델 작성 및 관리 기능이 되지 않는다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.485 CASE tool; §3.737 computer-aided software engineering; IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §8.1 Requirements Management Tools; §8.2 Requirements Modeling Tools
11. 객체에게 어떤 행위를 하도록 지시하는 명령은?
- Class
- Package
- Object
- Message
정답과 해설 보기
정답: 4
정답은 ④이다. 객체 사이에서 동작의 수행을 요청하거나 정보를 전달하는 상호작용을 메시지로 표현할 수 있다. 예를 들어 주문 객체가 결제 객체에 결제를 요청하면, 보내는 쪽과 받는 쪽 사이의 메시지를 모델링한다. 클래스는 공통된 속성과 동작을 정의하는 분류이고 객체는 그 구체적인 사례다. 패키지는 모델 요소 등을 묶어 조직하는 단위다. 메시지가 언제나 동기적인 메서드 호출만 의미하는 것은 아니며, UML에서는 비동기 신호와 응답 등도 구별한다.
선지별 해설
- 객체의 공통 구조와 동작을 정의하는 분류다.
- 관련 모델 요소를 묶어 조직하는 단위다.
- 상태와 동작을 가지는 개별 대상이다.
- 객체 사이에 동작 요청이나 정보를 전달하는 상호작용이다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §17.4 Messages
12. 서브시스템이 입력 데이터를 받아 처리하고 결과를 다른 시 스템에 보내는 작업이 반복되는 아키텍처 스타일은?
- 클라이언트 서버 구조
- 계층 구조
- MVC 구조
- 파이프 필터 구조
정답과 해설 보기
정답: 4
정답은 ④이다. 파이프-필터 구조는 입력 데이터를 처리하는 필터들을 데이터 전달 통로인 파이프로 연결한다. 앞 필터의 출력이 다음 필터의 입력이 되어 여러 처리 단계를 구성하므로, 자료 정제 → 변환 → 집계 같은 흐름에 적용할 수 있다. 각 필터는 맡은 변환에 집중하며 연결 방식과 자료 형식에 맞추어 조합된다. 클라이언트-서버는 요청자와 서비스 제공자의 역할을, 계층 구조는 책임 수준을, MVC는 모델·화면·제어의 분리를 중심으로 하는 구조다.
선지별 해설
- 요청하는 클라이언트와 서비스를 제공하는 서버를 중심으로 한 구조다.
- 서로 다른 책임 수준의 계층으로 구분하는 구조다.
- 모델·뷰·컨트롤러의 책임을 나누는 구조다.
- 연결한 처리 단계의 출력이 다음 단계의 입력이 된다.
편집 해설 근거: Microsoft Azure Architecture Center, Pipes and Filters pattern (2026-10-05 확인) — Solution
13. 럼바우(Rumbaugh)의 객체지향 분석에서 사용하는 분석 활 동으로 옳은 것은?
- 객체 모델링, 동적 모델링, 정적 모델링
- 객체 모델링, 동적 모델링, 기능 모델링
- 동적 모델링, 기능 모델링, 정적 모델링
- 정적 모델링, 객체 모델링, 기능 모델링
정답과 해설 보기
정답: 2
정답은 ②이다. 럼바우 등의 OMT는 시스템을 객체·동적·기능 모델의 서로 다른 관점으로 분석한다. 객체 모델은 객체의 분류와 관계 등 구조를, 동적 모델은 사건에 따른 상태와 변화를, 기능 모델은 입력을 출력으로 바꾸는 자료 변환을 다룬다. 세 관점은 서로 보완적이며 하나가 다른 관점을 모두 대신하지 않는다. 객체 모델에 정적인 구조가 포함된다는 사실과 정적 모델을 독립적인 세 번째 모델로 나열하는 것은 구별해야 한다. 보기 중 세 관점을 모두 포함한 것은 ②다.
선지별 해설
- 기능 모델이 빠지고 정적 모델을 별도의 구성으로 나열했다.
- 객체·동적·기능의 세 관점과 일치한다.
- 객체 모델이 빠져 있다.
- 동적 모델이 빠져 있다.
편집 해설 근거: Dov Dori, On Bridging the Analysis–Design and Structure–Behavior Grand Canyons with Object Paradigms (1996), 저자 제공 원문 — p.26, OMT object, dynamic and functional models
14. UML 다이어그램이 아닌 것은?
- 액티비티 다이어그램(Activity diagram)
- 절차 다이어그램(Procedural diagram)
- 클래스 다이어그램(Class diagram)
- 시퀀스 다이어그램(Sequence diagram)
정답과 해설 보기
정답: 2
정답은 ②이다. UML 2.5.1의 다이어그램 분류에는 활동, 클래스, 시퀀스 다이어그램이 포함된다. 활동 다이어그램은 작업의 흐름과 제어·자료 흐름을, 클래스 다이어그램은 분류자와 관계 같은 구조를, 시퀀스 다이어그램은 참여자 사이의 메시지 교환을 나타내는 데 사용한다. Procedural diagram은 해당 UML 다이어그램 분류의 이름이 아니다. 절차적인 알고리즘을 UML의 활동 다이어그램으로 표현할 수 있다는 사실과 절차 다이어그램이라는 공식 분류가 존재한다는 주장은 서로 다르다.
선지별 해설
- UML의 행동을 표현하는 활동 다이어그램이다.
- UML의 정해진 다이어그램 분류 명칭에 해당하지 않는다.
- UML의 구조를 표현하는 클래스 다이어그램이다.
- UML의 상호작용을 표현하는 시퀀스 다이어그램이다.
편집 해설 근거: OMG UML 2.5.1 (2017) — Annex A Diagrams
15. UML에서 한 요소가 다른 요소의 명세를 구현하거나 충족함을 나타내는 관계는? 예를 들어 클래스가 인터페이스의 계약을 구현하는 경우다.
[학습용 개정문항]
- Dependency
- Realization
- Generalization
- Association
정답과 해설 보기
정답: 2
정답은 ②이다. UML의 실체화는 한 요소가 다른 요소의 명세를 구현하거나 충족하는 관계를 표현한다. 인터페이스가 제공한 오퍼레이션 계약을 클래스가 구현하는 경우가 대표적인 예다. 의존은 다른 요소의 정의에 기대는 관계이고, 일반화는 보다 일반적인 분류자와 특수한 분류자의 관계이며, 연관은 인스턴스 사이의 연결을 표현한다. 원문의 다른 객체에게 오퍼레이션을 수행하도록 요청한다는 설명은 메시지와 혼동되므로, 개정 문항은 명세와 구현의 관계를 묻도록 정리했다.
선지별 해설
- 다른 요소의 정의나 존재에 의존하는 관계다.
- 명세와 이를 구현·충족하는 요소 사이의 관계다.
- 일반적인 분류자와 특수한 분류자의 관계다.
- 인스턴스 사이에 존재할 수 있는 연결을 나타낸다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §7.8.14 Realization; §10.4 Interfaces; §10.5.6 InterfaceRealization
16. CASE 기능을 단계별로 구분하여 상위 CASE를 분석·설계 모델의 작성·검토 지원으로 한정할 때, 이 범위에 가장 직접적으로 해당하지 않는 것은?
[학습용 개정문항]
- 모델들 사이의 모순검사 기능
- 전체 소스코드 생성 기능
- 모델의 오류검증 기능
- 자료흐름도 작성 기능
정답과 해설 보기
정답: 2
정답은 ②이다. 분석·설계의 모델 작성과 검토를 지원하는 범위를 상위 CASE로 구분하면, 자료 흐름도 작성과 모델의 오류·불일치 검사는 이 범위에 속한다. 전체 소스 코드를 생성하는 기능은 구현 단계 지원과 연결되므로 질문에서 한정한 분석·설계 모델 지원 기능과 구별된다. 오늘날 통합 개발·모델링 도구는 여러 단계의 기능을 함께 제공할 수 있다. 따라서 어떤 도구도 모델과 코드 생성을 동시에 지원할 수 없다는 뜻으로 받아들여서는 안 된다.
선지별 해설
- 분석·설계 모델의 일관성 검토를 지원한다.
- 구현 코드의 생성은 질문에서 한정한 모델 작성·검토의 범위를 벗어난다.
- 작성한 모델의 구조와 규칙 위반을 확인한다.
- 요구와 처리 흐름을 표현하는 분석 모델 작성 기능이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §8.2 Requirements Modeling Tools; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — CASE tool; computer-aided software engineering (CASE)
17. 요구사항의 변경 이력과 영향을 관리하는 도구의 직접적인 기능과 가장 거리가 먼 것은?
[학습용 개정문항]
- 요구 변경안의 비용·편익 분석 지원
- 기존·신규 시스템에 부하를 발생시켜 성능 시험을 직접 실행
- 요구사항 변경과 관련 산출물 추적
- 요구사항 변경의 영향 평가
정답과 해설 보기
정답: 2
정답은 ②이다. 요구사항 변경 관리에서는 어떤 요구가 왜 바뀌는지, 영향을 받는 설계·코드·시험은 무엇인지, 변경의 비용과 편익이 어떠한지 확인해야 한다. 관리 도구는 속성과 이력의 저장, 추적 관계 및 변경 통제를 지원한다. 기존 시스템과 신규 시스템에 실제 부하를 가하여 성능을 측정하는 일은 성능 시험 도구의 직접적인 기능이다. 그 측정 결과가 요구 확인에 활용될 수는 있지만, 성능 시험의 실행 자체와 요구 변경 이력을 관리하는 기능은 구별한다.
선지별 해설
- 변경안을 평가하고 채택 여부를 판단하는 데 활용된다.
- 실제 성능 부하 시험의 실행은 변경 이력 관리의 직접 기능과 다르다.
- 변경한 요구와 관련 산출물의 연결을 추적하는 기능이다.
- 변경의 파급 범위를 확인하여 의사결정을 돕는다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §6.2 Requirements Change Control; §8.1 Requirements Management Tools; Apache JMeter 공식 프로젝트, 기능과 성능 시험 — What can I do with it?
18. 애자일 개발 방법론이 아닌 것은?
- 스크럼(Scrum)
- 익스트림 프로그래밍(XP, eXtreme Programming)
- 기능 주도 개발(FDD, Feature Driven Development)
- 하둡(Hadoop)
정답과 해설 보기
정답: 4
정답은 ④이다. Hadoop은 여러 컴퓨터를 이용하여 대규모 데이터를 저장하고 처리하는 분산 컴퓨팅 소프트웨어 프로젝트다. 개발팀의 반복 주기와 협업 방식을 정하는 애자일 개발 방법론의 이름은 아니다. Scrum은 반복적인 검사와 적응을 지원하는 프레임워크이고 XP는 시험·피드백 등 개발 실천을 강조하며 FDD는 기능 단위를 중심으로 개발을 조직하는 방법이다. 애자일 방식으로 Hadoop을 개발하거나 활용할 수 있다는 사실이 Hadoop 자체를 개발 방법론으로 바꾸지는 않는다.
선지별 해설
- 짧은 주기에서 결과를 검사하고 적응하는 애자일 프레임워크다.
- 시험과 피드백 등 구체적인 개발 실천을 강조하는 방법이다.
- 기능을 중심으로 개발을 조직하는 방법이다.
- 대규모 데이터의 분산 저장·처리를 위한 소프트웨어 프로젝트다.
편집 해설 근거: Apache Hadoop, What Is Apache Hadoop? — What Is Apache Hadoop?; Schwaber·Sutherland, The Scrum Guide (2020) — Scrum Definition; Scrum Theory; Ron Jeffries, What is Extreme Programming? (2011) — What Is Extreme Programming?
19. GoF(Gangs of Four) 디자인 패턴 중 생성패턴으로 옳은 것은?
- singleton pattern
- adapter pattern
- decorator pattern
- state pattern
정답과 해설 보기
정답: 1
정답은 ①이다. Singleton은 클래스의 인스턴스 수를 하나로 제한하고 그 인스턴스에 접근할 수 있는 지점을 제공하려는 생성 패턴이다. Adapter는 인터페이스를 맞추고 Decorator는 객체를 감싸 책임을 덧붙이는 구조 패턴이다. State는 객체의 내부 상태에 따라 동작이 달라지는 것을 상태 객체들로 표현하는 행동 패턴이다. Singleton이 생성 패턴이라는 사실이 모든 프로그램에서 공유 인스턴스를 사용하는 것이 바람직하다는 뜻은 아니며 동시성과 시험 용이성도 고려해야 한다.
선지별 해설
- 객체 생성과 인스턴스 관리에 관한 생성 패턴이다.
- 인터페이스를 변환하는 구조 패턴이다.
- 객체를 감싸 기능을 덧붙이는 구조 패턴이다.
- 상태에 따른 동작을 분리하는 행동 패턴이다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — p. 15 Design Space for GoF Patterns; Singleton
20. 사용자 인터페이스(UI)의 일반적인 설계 목표에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 사용자가 일으킬 수 있는 오류를 줄이도록 돕는다.
- 사용자의 편의성을 높이기 위해 불필요한 작업시간을 늘린다.
- 작업을 수행하는 구체적인 조작 방법을 제시한다.
- 사용자의 필요와 맥락을 고려한 상호작용을 제공한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 사용자 인터페이스는 사용자가 목표를 이해하고 실행하며 결과를 확인할 수 있도록 돕는 접점이다. 좋은 설계는 오류를 예방하거나 복구하기 쉽게 하고, 필요한 작업의 절차와 상태를 드러내며, 사용자의 맥락과 능력을 고려한다. 편의성과 효율을 높이려는 목표에 불필요한 작업시간을 늘린다는 설명은 맞지 않는다. 다만 안전 확인이나 학습처럼 시간이 필요한 절차도 있으므로, 무조건 클릭 수나 시간을 줄이는 것만이 좋은 인터페이스의 유일한 기준은 아니다.
선지별 해설
- 오류의 발생 가능성과 영향을 줄이는 데 도움을 주는 목표다.
- 불필요한 작업시간의 증가는 사용자 편의성·효율 향상의 목표와 어긋난다.
- 목표를 수행할 수 있는 구체적인 조작 방법을 드러낸다.
- 사용자의 필요와 맥락을 고려한 상호작용을 지향한다.
편집 해설 근거: Jakob Nielsen, 10 Usability Heuristics for User Interface Design — Error prevention; Recognition rather than recall; Flexibility and efficiency of use
정보처리기사 필기 기출문제 · 소프트웨어 개발
21. n개 원소에 대한 일반적인 이진 힙 정렬을 설명한 것으로 틀린 것은? Θ는 점근적으로 정확한 시간 차수를 뜻한다.
[학습용 개정문항]
- 최대 힙을 구성한 뒤 최댓값을 정렬 구간으로 옮기는 과정을 반복할 수 있다.
- 평균 시간 복잡도는 Θ(n log n)이다.
- 힙은 완전 이진트리 형태로 원소를 구성한다.
- 최악 시간 복잡도는 Θ(2^n)이다.
정답과 해설 보기
정답: 4
정답은 ④이다. 이진 힙을 이용하는 일반적인 힙 정렬은 힙을 구성한 뒤 최댓값을 꺼내 정렬 구간으로 이동시키는 작업을 반복한다. 힙은 완전 이진트리 형태를 배열로 표현할 수 있으며 높이가 로그 규모이므로 한 번의 복구가 O(log n)에 수행된다. 이를 반복하는 정렬 단계의 최악 시간은 Θ(n log n)이다. 단순한 상한인 O 표기에서는 더 큰 함수도 상한이 될 수 있으므로, 개정 문항은 증가 차수를 양쪽에서 묶는 Θ 표기로 비교하여 지수 시간이라는 오답을 분명하게 했다.
선지별 해설
- 최대 힙에서 가장 큰 값을 순서대로 정렬 구간에 놓는 방식이다.
- 일반적인 힙 정렬의 평균 시간 차수와 일치한다.
- 완전 이진트리 형태의 이진 힙을 배열로 표현할 수 있다.
- 최악 시간이 지수적으로 증가하지 않으며 Θ(n log n)이다.
편집 해설 근거: NIST DADS, heapsort — Definition
22. 격리한 단위의 내부 동작보다 실제 모듈들을 연결하는 통합 테스트의 주된 대상에 해당하는 것은?
[학습용 개정문항]
- 알고리즘 오류에 따른 원치 않는 결과
- 탈출구가 없는 반복문의 사용
- 모듈 간의 비정상적 상호작용으로 인한 원치 않는 결과
- 틀린 계산 수식에 의한 잘못된 결과
정답과 해설 보기
정답: 3
정답은 ③이다. 단위 테스트는 함수나 모듈처럼 분리한 작은 구성요소의 동작에 초점을 둔다. 내부 알고리즘, 계산식, 반복문의 종료 조건 등은 그 단위 안에서 집중적으로 검사할 수 있다. 실제 모듈들을 연결했을 때 나타나는 자료 전달과 호출 규약 등 상호작용의 결함은 통합 테스트의 핵심 대상이다. 단위 테스트에서도 모의 객체 등을 통해 계약 위반의 일부를 발견할 수 있으므로, 상호작용 오류를 절대로 발견할 수 없다는 식의 원문 표현은 피해야 한다.
선지별 해설
- 한 단위의 알고리즘이 만드는 잘못된 결과는 단위 테스트의 주요 대상이다.
- 반복이 끝나지 않는 내부 제어 오류를 검사할 수 있다.
- 실제 구성요소를 연결한 상호작용은 통합 테스트의 주된 대상이다.
- 단위 내부의 잘못된 계산식을 검사할 수 있다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §2.2.1 Component Testing; §2.2.2 Integration Testing
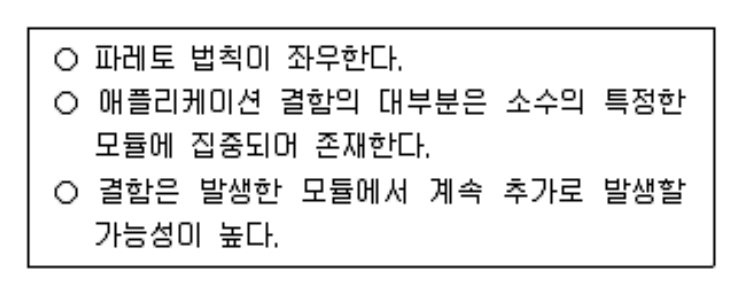
23. 다음 설명의 소프트웨어 테스트의 기본원칙은?
- 살충제 패러독스
- 결함 집중
- 오류 부재의 궤변
- 완벽한 테스팅은 불가능
정답과 해설 보기
정답: 2
정답은 ②이다. 결함 집중 원칙은 발견한 결함이나 운영 장애의 많은 부분이 상대적으로 적은 수의 구성요소에 모이는 경향을 말한다. 그림의 파레토 법칙은 이처럼 분포가 고르지 않을 수 있음을 설명하는 비유다. 모든 프로젝트에서 정확히 20%의 모듈에 80%의 결함이 있어야 한다는 수학적 보장은 아니다. 결함 이력과 변경량 등을 참고해 시험 우선순위를 정하되, 다른 영역을 검사하지 않아도 된다는 결론으로 확대해서는 안 된다.
선지별 해설
- 같은 시험을 반복하면 새로운 결함을 찾는 효과가 줄 수 있다는 원칙이다.
- 많은 결함이 일부 구성요소에 모이는 경향을 말한다.
- 결함이 적어도 사용자 필요를 충족하지 못하면 성공한 제품이 아니라는 원칙이다.
- 모든 입력과 경로를 전부 시험하기 어렵다는 원칙이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §1.3 Seven Testing Principles — Defects cluster together
24. 버전 관리 항목 중 저장소에 새로운 버전의 파일로 갱신하 는 것을 의미하는 용어는?
- 형상 감사(Configuration Audit)
- 롤백 (Rollback)
- 단위 테스트(Unit Test)
- 체크인(Check-In)
정답과 해설 보기
정답: 4
정답은 ④이다. 체크인은 작업한 파일이나 변경 집합을 버전 관리 저장소에 새 이력으로 기록하는 동작을 뜻한다. 도구에 따라 커밋이라는 표현을 쓰며, 분산 버전 관리에서는 로컬 커밋과 원격 저장소 전송을 구별하기도 한다. 형상 감사는 실제 산출물과 기준선·변경 기록의 일치 여부를 확인하는 활동이고, 롤백은 이전 상태로 되돌리는 작업이다. 단위 테스트는 작은 구성요소의 동작을 검사하는 활동이다. 새 버전의 저장이라는 질문에는 체크인이 해당한다.
선지별 해설
- 산출물과 기준·기록의 일치 여부를 확인하는 활동이다.
- 변경을 되돌려 이전 상태로 복원하는 동작이다.
- 작은 구성요소의 동작을 검사하는 활동이다.
- 변경한 내용과 이력을 버전 관리 저장소에 기록하는 동작이다.
편집 해설 근거: Microsoft Learn, Develop code and manage pending changes — TFVC — Check in your changes
25. 소프트웨어 테스트와 관련한 설명으로 틀린것은?
- 화이트 박스 테스트는 모듈의 논리적인 구조를 체계적으 로 점검할 수 있다.
- 블랙박스 테스트는 프로그램의 구조를 고려하지 않는다.
- 테스트 케이스에는 일반적으로 시험 조건,테스트 데이터, 예상 결과가 포함되어야한다.
- 화이트박스 테스트에서 기본 경로(BasisPath)란 흐름 그 래프의 시작 노드에서 종료노드까지의 서로 독립된 경로 로 싸이클을 허용하지 않는 경로를 말한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 기본 경로 시험은 제어 흐름 그래프에서 서로 독립적인 실행 경로의 집합을 선택하여 검사하는 구조 기반 기법이다. 반복문도 제어 구조이므로 기본 경로에 반복 구간이 포함될 수 있다. 사이클을 전혀 허용하지 않는 경로라고 정의하는 것은 잘못이다. 화이트박스 시험은 내부 구조를 이용하고 블랙박스 시험은 명세상의 입력·출력과 동작을 중심으로 설계한다. 시험 사례는 수행 조건과 입력, 기대 결과를 분명하게 하여 실제 결과를 판정할 수 있게 해야 한다.
선지별 해설
- 내부 제어·자료 흐름을 토대로 구조를 검사할 수 있다.
- 시험 설계의 근거로 내부 구조 대신 외부 명세를 사용하는 취지다.
- 수행 조건과 입력 및 기대 결과가 있어야 결과를 판정할 수 있다.
- 독립적인 기본 경로는 반복 구간을 포함할 수 있으므로 사이클 금지 정의는 틀렸다.
편집 해설 근거: NIST SP 500-235, Structured Testing (1996) — §2 Cyclomatic Complexity; §6.1 Generating a basis set of paths; ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §4.2 Black-box Test Techniques; §4.3 White-box Test Techniques
26. 애플리케이션의 처리량, 응답시간, 경과시간, 자원사용률에 대해 가상의 사용자를 생성하고 테스트를 수행함으로써 성 능 목표를 달성하였는지를 확인하는 테스트 자동화 도구는?
- 명세 기반 테스트 설계 도구
- 코드 기반 테스트 설계 도구
- 기능 테스트 수행 도구
- 성능 테스트 도구
정답과 해설 보기
정답: 4
정답은 ④이다. 가상 사용자의 요청을 발생시키고 응답시간과 처리량, 자원 사용 등을 측정하여 성능 목표를 평가하는 도구는 성능 테스트 도구다. 예를 들어 JMeter는 여러 요청을 통해 부하를 만들고 처리 성능을 관찰하는 데 쓰인다. 부하 조건과 측정 구간, 요청의 종류가 달라지면 결과도 달라지므로 목표와 시험 시나리오를 함께 정해야 한다. 명세·코드 기반 설계 도구는 시험 사례를 만드는 근거에 초점을 두고, 기능 시험 도구는 요구한 기능의 결과가 맞는지를 확인한다.
선지별 해설
- 명세를 근거로 시험 사례를 설계하는 도구다.
- 코드의 구조를 근거로 시험 사례를 설계하는 도구다.
- 주로 요구한 기능의 결과를 자동 확인한다.
- 부하 조건에서 응답시간·처리량 등 성능을 평가한다.
편집 해설 근거: Apache JMeter 공식 프로젝트, 기능과 성능 시험 — What can I do with it?; Apache JMeter User Manual, Glossary — Elapsed time; Latency; Throughput
27. 소프트웨어 형상 관리에 대한 설명으로 거리가 먼 것은?
[학습용 개정문항]
- 소프트웨어에 가해지는 변경을 제어하고 관리한다.
- 계획서·분석서·설계서·코드·시험 사례 등을 관리 대상으로 삼을 수 있다.
- Ant·Maven·Gradle은 모두 소스 파일의 버전 이력을 저장하는 버전 관리 시스템이다.
- 유지보수 단계뿐 아니라 개발 단계에도 적용할 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. 형상 관리는 개발과 유지보수 전 과정에서 산출물의 식별·변경 통제·상태 기록·감사를 수행한다. 코드뿐 아니라 계획서와 요구·설계 문서, 시험 사례도 관리 대상이 될 수 있다. Ant·Maven·Gradle은 대표적인 빌드 자동화 도구이며 소스의 버전 이력을 저장하는 Git 같은 버전 관리 시스템과는 역할이 다르다. 빌드 자동화도 넓은 형상 관리 과정에 활용되므로, 이들 도구가 형상 관리와 전혀 관련이 없다고 표현하지 않고 도구의 직접적인 기능을 비교한다.
선지별 해설
- 승인한 절차에 따라 변경을 통제하고 추적한다.
- 개발 산출물 가운데 관리할 항목을 식별하여 범위에 포함할 수 있다.
- 세 도구는 빌드 자동화 도구이며 모두 버전 이력 저장 시스템이라는 설명은 틀렸다.
- 개발과 유지보수 전 과정에 적용할 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Configuration Management §2 Identification; §3 Change Control; §4 Status Accounting; §5 Auditing; Apache Ant User Manual, Introduction — Introduction; Apache Maven, What is Maven? — What is Maven?; Gradle Build Tool, project introduction (2026-10-05 확인) — Gradle Build Tool
28. DRM의 콘텐츠 포장·배포·이용 권한 제어 역할과 달리, 여러 원천 데이터를 통합하여 분석에 활용하는 저장 환경을 뜻하는 것은?
[학습용 개정문항]
- Data warehouse
- DRM Controller
- Packager
- Contents Distributor
정답과 해설 보기
정답: 1
정답은 ①이다. 데이터 웨어하우스는 여러 원천의 데이터를 분석에 활용할 수 있도록 통합·저장하는 환경이다. DRM에서 콘텐츠를 포장하고 배포하거나 이용 권한을 집행하는 역할의 명칭과는 다르다. 패키저는 암호화와 관련 메타데이터를 포함한 배포 콘텐츠를 준비하고, 배포자는 콘텐츠를 전달하며, 제어 구성요소는 이용권한을 확인하여 재생 등을 제어한다. 실제 DRM 제품의 세부 구성과 명칭은 다를 수 있고 운영 분석용 저장소가 부가적으로 쓰일 수도 있다.
선지별 해설
- 분석을 위한 데이터 통합·저장 환경을 뜻한다.
- 이용 권한에 따라 콘텐츠 사용을 제어하는 역할을 가리킨다.
- 배포할 보호 콘텐츠와 메타데이터를 준비하는 역할이다.
- 콘텐츠를 사용자에게 전달하는 역할이다.
편집 해설 근거: Microsoft PlayReady, Content Encryption (2026-10-05 확인) — Content Encryption; AWS — What is OLAP? — What is OLAP?
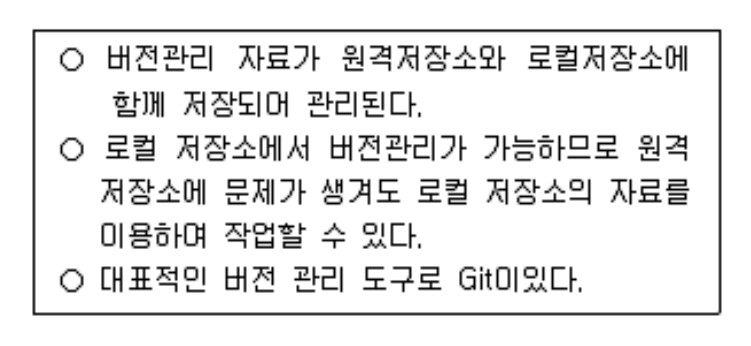
29. 다음 설명의 소프트웨어 버전 관리도구 방식은?
- 단일 저장소 방식
- 분산 저장소 방식
- 공유폴더 방식
- 클라이언트·서버 방식
정답과 해설 보기
정답: 2
정답은 ②이다. 분산 버전 관리에서는 개발자가 전체 프로젝트 이력을 포함하는 저장소를 로컬에 가질 수 있다. 따라서 원격 서버에 연결되지 않아도 이력 조회나 새 커밋 작성 등을 할 수 있고, 이후 다른 저장소와 변경을 교환한다. Git이 대표적인 예다. 여러 사람이 쓰는 원격 저장소를 함께 운영하더라도 로컬 저장소들이 이력을 가진다는 분산 구조는 유지된다. 단순 공유 폴더에 파일을 놓는 방식이나 모든 이력 작업을 중앙 서버에 의존하는 구조와 구별된다.
선지별 해설
- 중앙의 단일 저장소에만 이력을 두는 설명과 다르다.
- 개별 로컬 저장소가 이력을 보유하고 변경을 교환하는 구조다.
- 공유 폴더의 파일 접근만으로 이력 분산을 설명할 수 없다.
- 중앙 서버 의존을 중심으로 한 방식과 그림의 로컬 이력 보유는 다르다.
편집 해설 근거: Git 공식 프로젝트, About Git — Distributed
30. 입력·출력 명세를 중심으로 하는 블랙박스 시험보다 코드 내부 구조를 기준으로 하는 화이트박스 시험 관점에 해당하는 것은?
[학습용 개정문항]
- 잘못된 입력을 주었을 때 명세된 오류 처리가 나오는지 확인
- 정상 입력에서 요구된 기능 결과가 나오는지 확인
- 코드 내부 반복문과 분기 경로의 실행 여부를 커버리지로 확인
- 입력 경계값에서 명세된 출력이 나오는지 확인
정답과 해설 보기
정답: 3
정답은 ③이다. 블랙박스 시험은 내부 코드를 보지 않고 명세와 입력·출력의 관계를 근거로 사례를 설계한다. 잘못된 입력 처리, 정상 기능 결과, 경계값의 출력 등을 검사할 수 있다. 반면 코드 내부의 특정 반복문이나 분기 경로가 실행되었는지 확인하는 커버리지 기준은 구조 기반인 화이트박스 시험의 관점이다. 반복문 결함도 잘못된 출력으로 나타나면 블랙박스 시험에서 발견할 수 있으므로, 결함의 발생 위치가 아니라 시험을 설계하고 평가하는 근거를 구별해야 한다.
선지별 해설
- 외부 입력에 대해 명세한 오류 처리가 나오는지 확인할 수 있다.
- 정상 입력에서 요구한 기능 결과가 나오는지 확인한다.
- 코드 내부 경로의 실행 여부를 직접 기준으로 삼는 구조 기반 관점이다.
- 명세에 따른 입력 경계와 출력 결과를 비교한다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §4.2 Black-box Test Techniques; §4.3 White-box Test Techniques
31. 그림의 자료를 오름차순 버블 정렬한다. 각 PASS는 왼쪽부터 인접한 두 값을 비교·교환하여 미정렬 구간의 최댓값을 오른쪽 끝에 놓는다. PASS 2를 마친 결과는?
[학습용 개정문항]
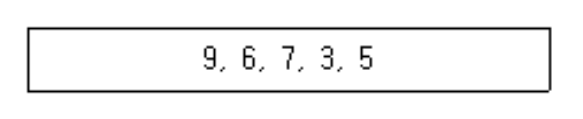
- 3, 5, 6, 7, 9
- 6, 7, 3, 5, 9
- 3, 5, 9, 6, 7
- 6, 3, 5, 7, 9
정답과 해설 보기
정답: 4
정답은 ④이다. 왼쪽에서 오른쪽으로 인접한 두 값을 비교하여 큰 값을 오른쪽으로 옮긴다. 초기 자료 9, 6, 7, 3, 5에 한 회전을 적용하면 6, 7, 3, 5, 9가 되어 최댓값 9가 끝에 놓인다. 두 번째 회전에서는 6과 7은 그대로 두고, 7과 3을 교환한 뒤 7과 5를 교환한다. 결과는 6, 3, 5, 7, 9다. 하나의 비교·교환과 미정렬 구간 전체를 훑는 한 회전을 혼동하지 않아야 하며, 반대 방향으로 순회하는 구현과 구별하도록 방향을 명시했다.
선지별 해설
- 세 번째 회전을 마친 정렬 완료 결과다.
- 첫 번째 회전을 마친 결과다.
- 명시한 방향으로 두 번 회전한 결과와 다르다.
- 두 번째 회전 뒤 7과 9가 오른쪽의 정렬 구간에 놓인 결과다.
편집 해설 근거: NIST DADS, bubble sort (2023-04-07) — Definition
32. N개 원소에 대한 일반적인 비교 기반 구현에서 최악 시간 복잡도가 Θ(N log N)인 정렬 알고리즘은? Θ는 점근적으로 정확한 차수를 뜻한다.
[학습용 개정문항]
- 합병정렬
- 버블정렬
- 선택정렬
- 삽입정렬
정답과 해설 보기
정답: 1
정답은 ①이다. 일반적인 합병 정렬은 자료를 반으로 나누어 각각 정렬한 뒤 두 정렬 구간을 합친다. 한 단계에서 합병하는 전체 자료량은 Θ(N)이고 분할 깊이는 Θ(log N)이므로 최악 시간은 Θ(N log N)이다. 일반적인 버블·선택·삽입 정렬은 최악의 경우 Θ(N²) 시간이 든다. 이미 정렬된 입력에서는 조기 종료를 적용한 버블 정렬이나 삽입 정렬의 성능이 달라질 수 있으므로, 입력 상태와 상한만 모호하게 제시한 원문 대신 최악의 정확한 차수를 비교한다.
선지별 해설
- 분할·정복과 선형 합병을 사용하여 최악 Θ(N log N)에 정렬한다.
- 일반적인 버블 정렬의 최악 시간은 Θ(N²)이다.
- 일반적인 선택 정렬은 최악 Θ(N²) 비교가 필요하다.
- 일반적인 삽입 정렬의 최악 시간은 Θ(N²)이다.
편집 해설 근거: NIST DADS, merge sort — Definition
33. 다음 postfix로 표현된 연산식의 연산 결과로 옳은 것은?
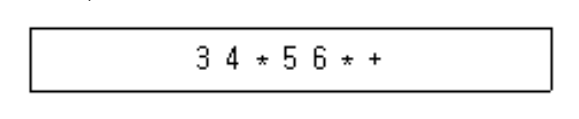
- 35
- 42
- 81
- 360
정답과 해설 보기
정답: 2
정답은 ②이다. 후위 표기식은 연산자를 두 피연산자 뒤에 쓰므로 스택을 이용하여 왼쪽부터 계산할 수 있다. 그림의 식은 3 4 * 5 6 * +다. 3과 4를 저장한 뒤 *를 만나면 두 수를 꺼내 12를 넣고, 5와 6 뒤의 *에서는 30을 만든다. 마지막 +가 12와 30을 더하므로 결과는 42다. 일반적인 중위식으로 표현하면 (3×4)+(5×6)이다. 뺄셈·나눗셈이라면 먼저 꺼낸 값을 오른쪽 피연산자로 삼는 순서에도 주의해야 한다.
선지별 해설
- 그림의 두 곱을 계산하여 더한 값과 다르다.
- 3×4=12와 5×6=30을 더한 결과다.
- 후위식의 연산자 위치와 피연산자 묶음을 잘못 적용한 값이다.
- 두 곱 12와 30을 곱한 값으로 마지막 +와 맞지 않는다.
편집 해설 근거: NIST DADS, stack — Definition; ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.5 Multiplicative operators; §6.5.6 Additive operators
34. 여러 응용을 공통 메시징 기반과 공통 데이터·명령 체계에 연결하여 공유 인터페이스로 협력하게 하는 EAI 통합 구조는? 메시지 라우팅이나 발행·구독을 활용할 수 있다.
[학습용 개정문항]
- Message Bus
- Point-to-point
- Hub &Spoke
- Hybrid
정답과 해설 보기
정답: 1
정답은 ①이다. Message Bus는 여러 응용이 공유하는 메시징 기반과 공통 데이터·명령 체계를 통해 서로 협력하도록 하는 통합 구조다. 응용들은 공통 인터페이스와 어댑터를 이용하여 버스에 연결되고, 필요에 따라 라우팅이나 발행·구독 방식으로 메시지를 교환한다. Point-to-point는 응용 사이의 직접 연결을, Hub & Spoke는 중앙 허브에 모이는 연결을, Hybrid는 여러 유형의 결합을 강조한다. 단순히 미들웨어가 있다는 단서만으로는 여러 보기를 배제할 수 없어 공통 버스라는 구조를 명시했다.
선지별 해설
- 공통 메시징 기반과 인터페이스를 통해 응용을 연결하는 구조다.
- 개별 응용 사이의 직접적인 연결을 중심으로 한다.
- 중앙 허브에 응용들이 연결되는 구조를 중심으로 한다.
- 여러 통합 구조를 결합하는 유형이다.
편집 해설 근거: Hohpe·Woolf, Enterprise Integration Patterns, Message Bus — Message Bus — Common communication infrastructure; Adapters; Common Command Structure
35. 인터페이스 구현 검증 도구가 아닌 것은?
- Foxbase
- STAF
- watir
- xUnit
정답과 해설 보기
정답: 1
정답은 ①이다. FoxBASE는 데이터베이스를 만들고 조회·수정하며 관련 응용을 개발하는 데이터베이스 제품이다. Fox Software의 당시 제품 안내에서도 데이터베이스 관리 시스템으로 소개한다. STAF는 시험 자동화를 지원하는 프레임워크이고 Watir는 브라우저를 조작하여 웹 응용을 시험하는 도구다. xUnit은 JUnit 등과 같이 시험 사례와 단언을 구성하는 단위 시험 프레임워크 계열을 가리킨다. 이들 시험 도구가 모든 종류의 인터페이스 검증을 자동으로 대신한다는 뜻은 아니다.
선지별 해설
- 데이터베이스 관리·응용 개발 제품으로 시험 자동화 프레임워크의 분류와 다르다.
- 여러 환경에서 시험 작업을 자동화하고 조정하는 프레임워크다.
- 브라우저를 자동 조작하여 웹 응용의 동작을 시험한다.
- 시험 사례와 단언을 실행하는 단위 시험 프레임워크 계열이다.
편집 해설 근거: Fox Software, FoxBASE+ 2.10 제품 안내(1988), 보존 원본 — p.1 FoxBASE+ 2.10 Is Here!; p.2 FoxCentral; STAF V3 User Guide, Version 3.4.26 (2016) — §1.0 Overview; Watir Project, 제품 소개 (2026-10-05 확인) — About Watir
36. 클린코드 작성원칙에 대한 설명으로 틀린 것은?
- 코드의 중복을 최소화 한다.
- 코드가 다른 모듈에 미치는 영향을 최대화하도록 작성한 다.
- 누구든지 코드를 쉽게 읽을 수 있도록 작성한다.
- 간단하게 코드를 작성한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 읽기 쉽고 변경하기 쉬운 코드는 의도를 드러내는 이름과 단순한 흐름, 적절한 책임 분리, 불필요한 중복의 제거를 지향한다. 한 모듈의 변경이 다른 모듈에 미치는 영향을 최대화하는 것은 이러한 목적과 반대다. 인터페이스와 의존성을 관리하여 필요한 변경의 범위를 제한하는 편이 수정과 시험에 유리하다. 다만 코드가 짧기만 하거나 중복을 없애기 위해 지나치게 복잡한 추상화를 도입하는 것도 바람직하지 않으므로 이해 가능성을 함께 판단해야 한다.
선지별 해설
- 같은 의도가 여러 곳에 흩어져 수정 누락이 생기는 일을 줄인다.
- 다른 모듈에 대한 변경 영향을 크게 만드는 것은 유지보수를 어렵게 한다.
- 팀이 의도와 동작을 이해할 수 있어야 수정과 검토가 쉽다.
- 필요 이상의 복잡성을 줄이는 목표와 연결된다.
편집 해설 근거: Google Engineering Practices, What to look for in a code review — Complexity; Naming; Design; IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles
37. 소프트웨어 패키징에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 개발자 편의만 고려하면 되며 사용자의 설치·실행 환경은 고려하지 않아도 된다.
- 신규·변경 코드와 배포에 필요한 자원을 식별하여 패키지를 구성한다.
- 사용자의 설치·업데이트를 돕기 위해 문서와 버전 정보를 관리한다.
- 지원 대상 플랫폼과 실행 환경에 맞는 배포 형식을 선택한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 패키징은 배포할 코드와 자원, 의존성·버전 정보 및 설치에 필요한 내용을 사용 환경에 맞는 형태로 구성하는 작업이다. 사용자가 설치하고 업데이트하며 문제를 해결할 수 있도록 지원 조건과 문서를 제공해야 한다. 개발자가 만들기 편하다는 이유만으로 사용자 설치와 실행 환경을 고려하지 않아도 된다는 설명은 틀렸다. 모든 패키지가 상용 제품이어야 하거나 하나의 패키지가 모든 운영체제에서 동작하는 것은 아니므로, 지원 대상과 배포 형식을 명확히 정하는 것이 중요하다.
선지별 해설
- 사용자의 설치·실행 조건을 무시해도 된다는 설명은 틀렸다.
- 배포할 변경 내용과 구성 파일을 식별해야 한다.
- 설치와 갱신을 위해 버전 및 사용 정보를 관리해야 한다.
- 지원하는 플랫폼과 실행 조건에 맞추어 배포 형식을 선택한다.
편집 해설 근거: Python Packaging User Guide — Binary distribution format — File Format; File name convention; The .dist-info directory
38. 공학적으로 잘된 소프트웨어(Well Engineered Software)의 설명 중 틀린 것은?
[학습용 개정문항]
- 변경과 유지보수가 용이하도록 설계한다.
- 요구한 신뢰성 수준을 확보하도록 한다.
- 사용자의 능력·작업 맥락·접근성 요구를 무시하고 한 가지 조작 방식만 강요한다.
- 위험과 요구사항에 맞는 충분한 검증을 수행한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 잘 설계한 소프트웨어는 요구한 신뢰성과 유지보수성, 사용성을 확보하고 위험과 목적에 맞는 검증을 거쳐야 한다. 사용자의 능력이나 작업 맥락, 접근성 필요를 무시한 채 한 가지 조작만 강요하는 것은 사용자 중심 설계에 어긋난다. 반면 같은 동작에 일관된 표현과 조작을 사용하는 것은 일반적으로 좋은 원칙이다. 원문의 일관된 인터페이스를 제공한다는 문장을 그대로 오답으로 설명하면 일관성이 나쁘다는 오해를 낳으므로 사용자 차이를 무시하는 조건을 명시했다.
선지별 해설
- 변경을 이해하고 수행하기 쉽게 하는 것은 중요한 품질 목표다.
- 필요한 조건에서 신뢰할 수 있는 동작을 제공해야 한다.
- 사용자의 능력·맥락·접근성 요구를 무시하는 설계는 적절하지 않다.
- 위험과 요구에 맞는 충분한 검증이 필요하다.
편집 해설 근거: Jakob Nielsen, 10 Usability Heuristics for User Interface Design — Consistency and standards; Flexibility and efficiency of use; ISO/IEC 25010:2011, Software quality model (문항에 명시한 구판) — §4.2.4 Usability; §4.2.5 Reliability; §4.2.7 Maintainability
39. 테스트와 디버그의 목적으로 옳은 것은?
[학습용 개정문항]
- 테스트는 동작을 평가하고 결함·실패를 드러내며, 디버깅은 실패 원인을 조사하여 결함을 수정한다.
- 테스트는 결함을 수정하는 활동이고 디버깅은 시험 사례를 실행하는 활동만 뜻한다.
- 둘 다 오류를 찾기만 하고 결함을 수정하는 일은 포함하지 않는다.
- 둘 다 소프트웨어의 결함 발견 및 수정과 무관하다.
정답과 해설 보기
정답: 1
정답은 ①이다. 테스트는 소프트웨어와 산출물을 평가하고 결함이나 실패를 드러내며 요구 충족 여부에 관한 정보를 얻는 활동이다. 디버깅은 관찰한 실패의 원인을 조사하고 결함을 찾아 수정하는 활동이다. 따라서 두 활동은 서로 관련되지만 같은 일은 아니다. 수정 후에는 해당 문제가 해결되었는지 확인하는 재시험과 다른 부분에 악영향이 없는지 살피는 회귀 시험이 필요할 수 있다. 디버깅도 원인을 찾는 과정을 포함하므로 단순히 테스트는 찾기, 디버깅은 수정만이라고 제한하지 않는다.
선지별 해설
- 테스트의 평가·실패 관찰과 디버깅의 원인 조사·수정 목적을 적절히 구별했다.
- 테스트와 디버깅의 주된 목적을 바꾸어 설명했다.
- 디버깅에는 결함의 수정이 포함되므로 틀렸다.
- 두 활동 모두 소프트웨어의 결함·실패와 관련된다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §1.1.2 Testing and Debugging; §2.3.4 Change-related Testing
40. 다음 중 스택을 이용한 연산과 거리가 먼 것은?
- 선택정렬
- 재귀호출
- 후위표현(Post-fix expression)의 연산
- 깊이우선탐색
정답과 해설 보기
정답: 1
정답은 ①이다. 재귀 호출은 호출한 함수로 되돌아갈 정보와 지역 상태를 호출 스택에 보관하는 방식으로 설명할 수 있다. 후위식 계산은 피연산자와 중간 결과를 스택에 넣고 꺼내며, 깊이우선탐색도 명시적인 스택이나 재귀 호출로 되돌아갈 위치를 관리한다. 일반적인 선택 정렬은 남은 구간의 최솟값을 찾아 앞자리와 교환하므로 이러한 스택 사용이 핵심인 알고리즘은 아니다. 선택 정렬을 어떤 방식으로 구현해도 스택과 무관하다는 절대적인 주장은 아니다.
선지별 해설
- 남은 구간의 최솟값 선택·교환이 중심이며 스택이 핵심 자료구조가 아니다.
- 함수 호출의 복귀 정보와 상태를 스택으로 관리할 수 있다.
- 피연산자와 중간 결과를 후입선출로 처리한다.
- 최근 탐색 지점으로 되돌아가는 데 스택이나 재귀를 사용한다.
편집 해설 근거: NIST DADS, stack — Definition; Note; NIST DADS — depth-first search — Definition
정보처리기사 필기 기출문제 · 데이터베이스 구축
41. 병렬 데이터베이스 환경 중 수평 분할에서 활용되는 분할 기법이 아닌 것은?
- 라운드-로빈
- 범위 분할
- 예측 분할
- 해시 분할
정답과 해설 보기
정답: 3
정답은 ③이다. 수평 분할은 한 릴레이션의 행들을 여러 저장 위치로 나누는 방식이다. 라운드 로빈은 행을 차례로 순환 배정하고, 범위 분할은 분할 속성값의 구간에 따라 배정하며, 해시 분할은 속성값에 해시 함수를 적용한 결과로 위치를 결정한다. 이 문항에서 비교하는 대표적인 세 배치 방식에 예측 분할이라는 명칭은 포함되지 않는다. 수평 분할은 열을 나누는 수직 분할과도 다르며, 질의의 조건과 데이터 분포에 따라 적합한 배치 방식이 달라질 수 있다.
선지별 해설
- 행을 여러 위치에 순환하여 나누는 수평 분할 방식이다.
- 속성값의 범위별로 행을 나누는 방식이다.
- 비교하는 대표적인 라운드 로빈·범위·해시 분할의 명칭에 해당하지 않는다.
- 분할 키의 해시값을 기준으로 행을 배정한다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 21 저자 자료 — slides 21.5–21.7 I/O Parallelism; Range Partitioning
42. 시스템 카탈로그에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 무결성을 유지하려면 일반 사용자가 시스템 카탈로그 행을 직접 수정해야 한다.
- 스키마와 데이터베이스 객체에 관한 정보를 포함한다.
- 저장되는 정보를 메타데이터라고 부를 수 있다.
- 정식 객체 생성·변경 명령에 맞추어 DBMS가 정보를 생성하고 유지한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 시스템 카탈로그에는 테이블·열·자료형·제약조건 등 데이터베이스 객체에 대한 메타데이터가 저장된다. DBMS는 CREATE나 ALTER 같은 정식 명령의 실행에 맞추어 필요한 카탈로그 정보를 관리한다. 일반 사용자가 무결성 유지를 위해 카탈로그 행을 직접 수정해야 한다는 설명은 잘못이다. 일부 DBMS에서는 권한 있는 관리자가 내부 카탈로그를 직접 조작할 여지가 있지만 통상적인 스키마 관리 방법은 아니며, 공식 명령을 우회하는 변경은 일관성을 훼손할 수 있다.
선지별 해설
- 무결성 유지를 위해 일반 사용자가 카탈로그 행을 직접 고쳐야 하는 것은 아니다.
- DBMS가 사용하는 객체 정의와 관련 정보를 보관한다.
- 데이터를 설명하는 데이터이므로 메타데이터라 부른다.
- 정식 객체 생성·변경 명령에 따라 DBMS가 관리한다.
편집 해설 근거: PostgreSQL 18, Chapter 52 System Catalogs — Chapter 52 System Catalogs — introduction
43. SQL 문에서 SELECT에 대한 설명으로 옳지않은 것은?
[학습용 개정문항]
- FROM 절에는 조회할 테이블이나 테이블 식을 지정한다.
- 결과의 중복 행을 제거하려면 WHERE 절에 DISTINCT 키워드를 쓴다.
- HAVING은 그룹 조건을 지정하며 GROUP BY와 함께 사용할 수 있다.
- ORDER BY 절에는 결과 정렬 기준을 지정한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 결과 행의 중복을 제거하려면 SELECT DISTINCT 형태로 DISTINCT를 지정한다. WHERE는 개별 행이 만족해야 하는 조건을 적는 절이므로 DISTINCT를 거기에 놓지 않는다. FROM은 읽을 테이블이나 테이블 식을, ORDER BY는 결과 정렬 기준을 지정한다. HAVING은 그룹에 대한 조건을 적용하며 GROUP BY와 함께 쓸 수 있다. HAVING을 사용할 때 GROUP BY가 반드시 필요한 것은 아니므로 두 절이 항상 한 쌍이라고 암기하지 않는 것이 중요하다.
선지별 해설
- 조회 원천인 테이블이나 테이블 식을 지정한다.
- 중복 제거는 SELECT DISTINCT이며 WHERE DISTINCT가 아니다.
- 집계한 그룹의 조건을 지정하고 GROUP BY와 함께 쓸 수 있다.
- 결과 행을 지정한 기준에 따라 정렬한다.
편집 해설 근거: PostgreSQL 18 — SELECT — SELECT syntax; DISTINCT Clause; HAVING Clause; ORDER BY Clause
44. SQL에서 VIEW를 삭제할 때 사용하는 명령은?
- ERASE
- KILL
- DROP
- DELETE
정답과 해설 보기
정답: 3
정답은 ③이다. 뷰라는 데이터베이스 객체의 정의를 제거할 때는 DROP VIEW 뷰이름을 사용한다. DELETE는 테이블이나 갱신 가능한 뷰를 통해 행을 삭제하는 명령으로, 뷰 객체 자체를 없애는 것과 다르다. 일반적인 뷰를 삭제한다고 원본 테이블의 모든 행이 함께 지워지는 것은 아니다. 다른 객체가 그 뷰에 의존한다면 의존성 처리 규칙과 권한에 따라 명령이 거절되거나 추가 선택이 필요할 수 있다. ERASE와 KILL은 여기서 요구하는 SQL 뷰 제거 명령이 아니다.
선지별 해설
- SQL의 뷰 정의 제거 명령이 아니다.
- SQL의 뷰 정의 제거 명령이 아니다.
- DROP VIEW로 뷰 객체를 제거한다.
- 행을 삭제하는 명령이며 뷰 정의를 제거하는 명령과 다르다.
편집 해설 근거: PostgreSQL 18, DROP VIEW — Synopsis; Description; CASCADE; RESTRICT
45. DDL(Data Definition Language) 명령 계열 중 스키마·도메인·인덱스 등을 새로 정의할 때 사용하는 것은?
[학습용 개정문항]
- ALTER
- SELECT
- CREATE
- INSERT
정답과 해설 보기
정답: 3
정답은 ③이다. CREATE는 데이터베이스 객체를 새로 정의할 때 사용하는 명령 계열이다. 예를 들어 CREATE SCHEMA는 스키마를, CREATE DOMAIN은 도메인을, CREATE INDEX는 인덱스를 만든다. ALTER는 이미 존재하는 객체의 정의를 변경하고 SELECT는 데이터를 조회하며 INSERT는 행을 추가한다. 객체 정의를 다루는 언어를 DDL, 즉 Data Definition Language라고 한다. 객체 종류와 DBMS에 따라 구체적인 문법과 필요한 권한이 다르므로 CREATE 뒤에 대상과 옵션을 지정한다.
선지별 해설
- 기존 객체의 정의를 변경한다.
- 자료를 조회하는 명령이다.
- 새 스키마·도메인·인덱스 등 객체를 정의한다.
- 테이블에 데이터 행을 추가한다.
편집 해설 근거: PostgreSQL 18, CREATE SCHEMA — Synopsis; Description; PostgreSQL 18, CREATE INDEX — Synopsis; Description; PostgreSQL 18: Data Definition — Data Definition
46. R1(학번, 학점수)의 행은 (20201111, 15), (20202222, 20)이고 R2(학번, 과목번호)의 행은 (20202222, CS200), (20203333, CS300)이다. 다음 SQL의 결과는?
SELECT 학번 FROM R1
INTERSECT
SELECT 학번 FROM R2;
[학습용 개정문항]
- 열 (학번, 학점수, 과목번호): (20202222, 20, CS200)
- 열 (학번): (20202222)
- 열 (학번): (20201111), (20202222), (20203333)
- 열 (학번, 학점수, 과목번호): (20201111, 15, NULL), (20202222, 20, CS200), (20203333, NULL, CS300)
정답과 해설 보기
정답: 2
정답은 ②이다. 각 SELECT는 해당 테이블에서 학번 열 하나만 뽑는다. R1의 학번 집합은 {20201111, 20202222}이고 R2의 학번 집합은 {20202222, 20203333}이다. INTERSECT는 두 조회 결과에 공통으로 있는 행을 남기므로 결과는 학번 20202222 한 행이다. 학점수와 과목번호는 SELECT 목록에 없으므로 결과에 나타나지 않는다. 모든 학번을 합치는 UNION이나 두 테이블의 열을 결합하는 JOIN과 구별해야 한다.
선지별 해설
- 공통 학번의 여러 열을 결합한 모양으로 SELECT의 단일 열 결과가 아니다.
- 두 학번 집합에 공통인 20202222만 남는다.
- 두 집합의 합집합으로 INTERSECT가 아닌 UNION에 해당한다.
- 모든 행과 양쪽 열을 결합한 모양으로 교집합의 결과가 아니다.
편집 해설 근거: PostgreSQL 18 — SELECT — INTERSECT Clause
47. 데이터베이스 설계 시 물리적 설계 단계에서 수행하는 사항 이 아닌 것은?
[학습용 개정문항]
- 관련 레코드 집중 배치의 분석과 설계
- 인덱스 등 접근 경로 설계
- 저장 레코드의 형식과 배치 설계
- 테이블·속성·키·관계로 이루어진 논리적 스키마 정의
정답과 해설 보기
정답: 4
정답은 ④이다. 물리적 설계에서는 저장 레코드의 형식과 배치, 관련 레코드의 집중, 인덱스 등 접근 경로를 작업 부하와 저장 장치의 특성에 맞추어 정한다. 반면 테이블·속성·키·관계 등 논리적 스키마를 정의하는 것은 논리적 설계의 핵심 활동이다. 실제 DBMS에서는 자료형과 인덱스 등 선택이 맞물릴 수 있으므로 단순히 목표 DBMS에 맞춘다는 말만으로 단계를 구별하기 어렵다. 개정 문항은 논리 구조 정의라는 대상을 명확히 하였다.
선지별 해설
- 관련 레코드를 물리적으로 가까이 배치하는 방식을 검토한다.
- 인덱스 등 데이터 접근 방법을 정한다.
- 저장되는 레코드의 표현과 배치를 정한다.
- 테이블·속성·키·관계의 논리 구조를 정의하는 활동이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Physical Database Design — Physical Database Design and Tuning; Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relational Model
48. 릴레이션의 기본키를 구성하는 모든 열은 NULL을 허용하지 않고, 기본키 값의 전체 조합은 각 행마다 유일해야 한다는 제약은?
[학습용 개정문항]
- 참조 무결성
- 보안 무결성
- 개체 무결성
- 정보 무결성
정답과 해설 보기
정답: 3
정답은 ③이다. 개체 무결성은 기본키를 통해 각 행을 분명히 식별하도록 하는 제약이다. 기본키의 구성 열은 NULL을 가질 수 없고 기본키 값 전체는 행마다 유일해야 한다. 두 열로 된 복합 기본키라면 각각의 열 값은 다른 행에 반복될 수 있어도 두 값을 합친 조합은 중복될 수 없다. 참조 무결성은 외래키가 참조하는 값과의 관계를 다루는 별도의 제약이다. 원문의 각 속성이 모두 독립적으로 유일해야 한다는 오해를 피하도록 전체 조합의 유일성을 명시했다.
선지별 해설
- 외래키와 참조 대상 사이의 일관성을 다루는 제약이다.
- 기본키의 NULL 금지와 유일성을 지칭하는 명칭이 아니다.
- 기본키로 각 행을 식별하게 하는 제약이다.
- 이 문항의 기본키 규칙을 가리키는 정규 명칭이 아니다.
편집 해설 근거: PostgreSQL 18 — Constraints — §5.5.4 Primary Keys; §5.5.5 Foreign Keys
49. 병행제어 기법의 종류가 아닌 것은?
- 로킹 기법
- 시분할 기법
- 타임 스탬프 기법
- 다중 버전 기법
정답과 해설 보기
정답: 2
정답은 ②이다. 데이터베이스 병행 제어는 여러 트랜잭션이 동시에 실행되어도 충돌을 조정하고 필요한 격리 수준과 일관성을 유지하는 일이다. 로킹은 접근 권한을 잠금으로 조정하고, 타임스탬프 기법은 정한 순서에 맞추어 충돌을 처리하며, 다중 버전 기법은 여러 데이터 버전을 이용한다. 시분할은 CPU 시간을 나누어 여러 작업을 실행하는 운영체제의 스케줄링 개념으로, 이 문항의 트랜잭션 충돌 제어 기법에 해당하지 않는다. 동시 실행 자체를 모두 금지하는 것과도 다르다.
선지별 해설
- 잠금으로 충돌하는 데이터 접근을 제어한다.
- CPU 시간을 나누는 실행 방식으로 데이터베이스 트랜잭션 충돌 제어 기법과 다르다.
- 타임스탬프 순서를 기준으로 충돌을 처리한다.
- 데이터의 여러 버전을 이용하여 동시 접근을 조정한다.
편집 해설 근거: Database System Concepts, Concurrency Control — Timestamp-Based Protocols; PostgreSQL 18 — Transaction Isolation — Transaction Isolation; Arpaci-Dusseau, OSTEP v1.10, 7 Scheduling: Introduction — Scheduling Metrics; Round Robin
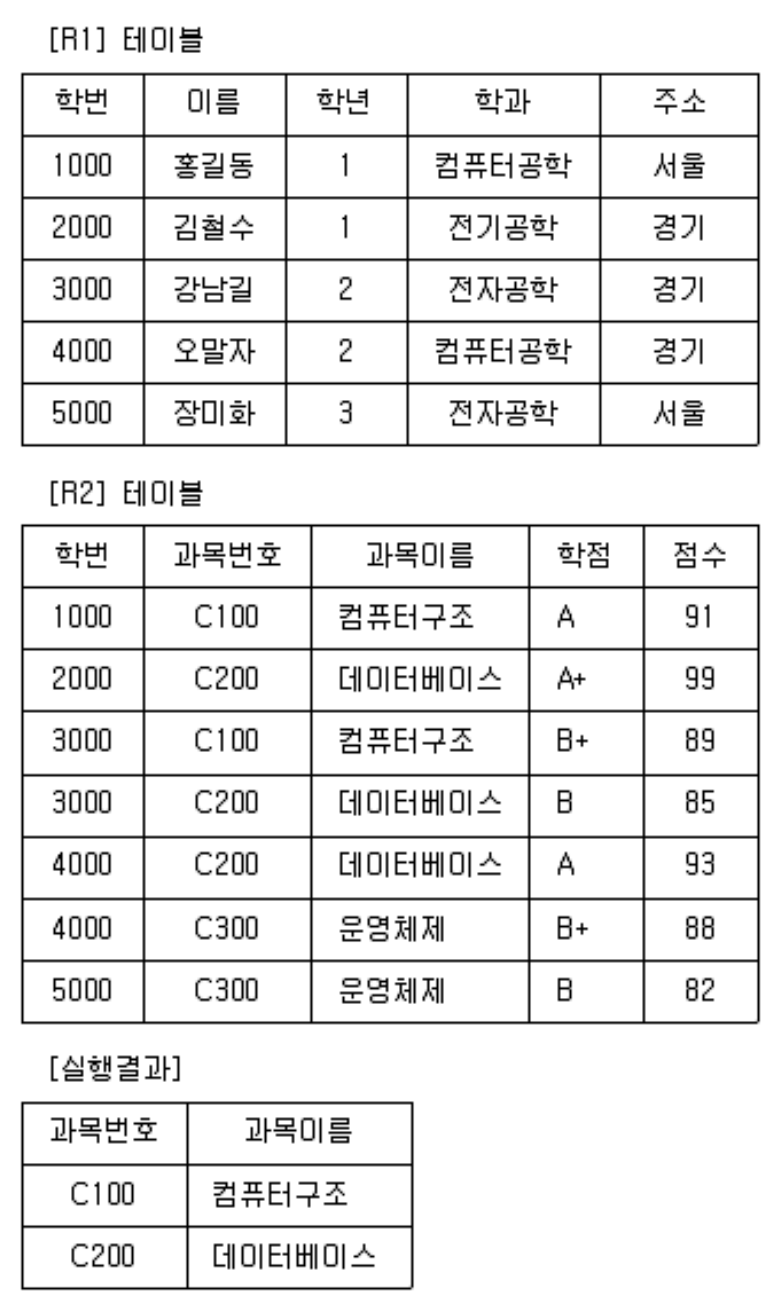
50. 다음 R1과 R2의 테이블에서 아래의 실행 결과를 얻기 위 한 SQL문은?
[학습용 개정문항]
- SELECT 과목번호, 과목이름 FROM R1, R2 WHERE R1.학번 = R2.학번 AND R1.학과 = '전자공학' AND R1.이름 = '강남길';
- SELECT 과목번호, 과목이름 FROM R1, R2 WHERE R1.학번 = R2.학번 OR R1.학과 = '전자공학' OR R1.이름 = '홍길동';
- SELECT 과목번호, 과목이름 FROM R1, R2 WHERE R1.학번 = R2.학번 AND R1.학과 = '컴퓨터공학' AND R1.이름 = '강남길';
- SELECT 과목번호, 과목이름 FROM R1, R2 WHERE R1.학번 = R2.학번 OR R1.학과 = '컴퓨터공학' OR R1.이름 = '홍길동';
정답과 해설 보기
정답: 1
정답은 ①이다. 결과에 나타난 과목은 전자공학과 강남길의 수강 내역이다. R1에서 그 학생의 학번은 3000이며 R2에는 3000의 과목 C100·컴퓨터구조와 C200·데이터베이스가 있다. 두 테이블을 R1.학번=R2.학번으로 결합하고 학과와 이름 조건도 모두 AND로 만족시켜야 이 두 행이 나온다. OR로 연결하면 학생과 수강 행이 올바르게 짝지어지지 않아도 일부 조건만으로 통과할 수 있다. 컴퓨터공학 조건은 강남길의 학과와 다르므로 ③도 결과를 얻지 못한다.
선지별 해설
- 학번 결합, 전자공학과, 강남길이라는 세 조건을 모두 적용한다.
- OR 때문에 목표 학생 외의 행과 맞지 않는 결합까지 포함될 수 있다.
- 강남길은 전자공학과이므로 컴퓨터공학 조건을 동시에 만족하지 않는다.
- OR로 묶인 조건이어서 목표 학생의 두 수강 내역만 추리지 못한다.
편집 해설 근거: PostgreSQL 18 — SELECT — FROM Clause; WHERE Clause; PostgreSQL, Logical Operators — AND; OR
51. 다음 관계 대수 중 순수 관계 연산자가 아닌 것은?
- 차집합(difference)
- 프로젝트(project)
- 조인(join)
- 디비전 (division)
정답과 해설 보기
정답: 1
정답은 ①이다. 차집합은 두 집합에 대해 첫 집합에만 있는 원소를 구하는 일반적인 집합 연산으로, 관계 대수에서는 서로 호환되는 두 릴레이션에 적용한다. 프로젝트는 필요한 속성을 선택하고, 조인은 관련 튜플들을 조건에 따라 결합하며, 디비전은 다른 관계의 모든 관련 값에 대응하는 대상을 구하는 데 쓰이는 관계 연산이다. 이 문항의 순수 관계 연산자와 일반 집합 연산자의 교재식 구분에서는 차집합이 후자에 속한다. 차집합이 관계 대수의 연산자가 아니라는 뜻은 아니다.
선지별 해설
- 관계 대수에서도 쓰지만 일반 집합 연산자로 분류된다.
- 필요한 속성을 선택하는 관계 연산이다.
- 관련 튜플을 결합하는 관계 연산이다.
- 모든 관련 값에 대응하는 대상을 찾는 관계 연산이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — Set Operations; Projection; Joins; Division
52. 고전적인 제1정규형 관계 데이터 모형의 릴레이션에 대한 설명으로 틀린 것은? SQL의 중복 허용 조회 결과와 구별한다.
[학습용 개정문항]
- 모든 속성 값은 원자 값을 갖는다.
- 한 릴레이션에 포함된 튜플은 모두 상이하다.
- 한 릴레이션에 포함된 튜플 사이에는 순서가 없다.
- 한 릴레이션을 구성하는 속성 사이에는 순서가 존재한 다.
정답과 해설 보기
정답: 4
정답은 ④이다. 고전적인 제1정규형 관계 모형에서는 각 속성 위치에 해당 도메인의 원자값을 두고 릴레이션을 튜플들의 집합으로 본다. 집합에는 같은 튜플이 중복되지 않으며 튜플을 나열하는 순서도 의미가 없다. 속성 역시 이름으로 식별하므로 그 표시 순서가 관계의 의미를 바꾸지 않는다. SQL의 조회 결과에는 중복 행이 있을 수 있고 ORDER BY로 표시 순서를 지정할 수도 있으므로, 수학적인 관계 모형과 실제 SQL 결과의 특징을 구별해야 한다.
선지별 해설
- 문항에서 한정한 제1정규형 관계 모형의 원자값 조건이다.
- 릴레이션을 집합으로 보므로 동일 튜플은 중복되지 않는다.
- 튜플의 나열 순서는 관계의 의미에 포함되지 않는다.
- 속성은 이름으로 식별하므로 표시 순서가 본질적인 순서를 뜻하지 않는다.
편집 해설 근거: E. F. Codd — A Relational Model of Data (paper mirror) — §1.3 A Relational View of Data; Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relational Model
53. 릴레이션 R의 차수는 4, 카디널리티는 5이고 S의 차수는 6, 카디널리티는 7이다. 같은 이름의 속성은 미리 바꾸어 구별하였다. R×S의 차수와 카디널리티는?
[학습용 개정문항]
- 24, 35
- 24, 12
- 10, 35
- 10, 12
정답과 해설 보기
정답: 3
정답은 ③이다. 카티션 프로덕트에서는 R의 각 튜플에 S의 모든 튜플을 하나씩 결합한다. R의 5개 튜플마다 S의 7개 튜플이 대응하므로 결과의 튜플 수인 카디널리티는 5×7=35다. 각 결과 튜플에는 R의 속성 4개와 S의 속성 6개가 함께 들어가므로 차수는 4+6=10이다. 속성 수는 더하고 행의 조합 수는 곱한다는 점을 구별해야 한다. 같은 이름의 속성이 있다면 이름을 바꾸어 두 관계의 속성이 구분되도록 한다.
선지별 해설
- 차수를 4×6으로 곱한 것이 잘못이다.
- 차수를 곱하고 카디널리티를 더하여 두 계산을 모두 잘못했다.
- 차수 4+6=10, 카디널리티 5×7=35다.
- 차수는 맞지만 튜플 조합 수를 5+7로 더한 것이 잘못이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — Cross-Product; PostgreSQL 18 — Cross Join — Joined Tables — CROSS JOIN
54. 전통적인 제1정규형 관계 데이터 모형에서 속성(attribute)에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 속성은 개체의 특성을 기술한다.
- 속성은 데이터베이스를 구성하는 가장 작은 논리적 단위 이다.
- 속성은 파일 구조상 데이터 항목 또는 데이터 필드에 해 당된다.
- 속성의 수를 "cardinality" 라고 한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 관계 모형에서 속성은 이름과 도메인을 갖는 열로서 대상의 특징을 나타낸다. 전통적인 제1정규형 모형에서는 한 속성 위치에 원자값을 저장하며, 파일의 필드와 대응시켜 설명할 수 있다. 릴레이션의 속성 수는 차수 또는 애리티이고, 튜플의 수는 카디널리티다. 따라서 속성 수를 카디널리티라고 한 ④는 두 개념을 바꾸어 설명한 것이다. 예를 들어 열이 4개이고 행이 10개인 관계라면 차수는 4, 카디널리티는 10이다.
선지별 해설
- 열의 이름과 값으로 대상의 특성을 표현한다.
- 제1정규형 모형에서 원자값을 담는 논리적 항목으로 설명할 수 있다.
- 전통적인 파일 구조의 데이터 필드와 대응된다.
- 속성 수는 차수이고 카디널리티는 튜플 수다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relation Schema; Relation Instance
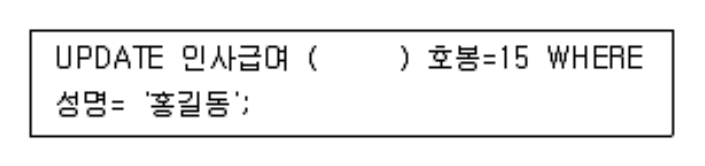
55. 다음 SQL 문에서 ( ) 안에 들어갈 내용으로 옳은 것은?
- SET
- FROM
- INTO
- IN
정답과 해설 보기
정답: 1
정답은 ①이다. UPDATE 문은 지정한 행의 열 값을 바꾸며, SET 절에서 바꿀 열과 새 값을 적는다. 따라서 그림의 빈칸에는 SET이 들어가 UPDATE 인사급여 SET 호봉=15 WHERE 성명=… 형태가 된다. WHERE는 성명이 홍길동인 행만 변경하도록 대상을 제한한다. 같은 이름의 행이 여러 개면 그 조건을 만족하는 모든 행이 바뀔 수 있으므로 성명만으로 한 사람을 유일하게 식별한다고 가정해서는 안 된다. INTO와 IN은 이 대입 절의 키워드가 아니다.
선지별 해설
- 변경할 열과 대입할 값을 지정하는 절이다.
- 이 위치에서 열 대입 목록을 시작하는 키워드가 아니다.
- 주로 INSERT의 대상 등을 지정할 때 쓰며 UPDATE의 대입 절과 다르다.
- 집합에 값이 포함되는지 검사하는 연산 등에 쓰인다.
편집 해설 근거: PostgreSQL 18 — UPDATE — Synopsis; Description; WHERE condition
56. 관계 데이터베이스 모델에서 차수(Degree)의 의미는?
- 튜플의 수
- 테이블의 수
- 데이터베이스의 수
- 애트리뷰트의 수
정답과 해설 보기
정답: 4
정답은 ④이다. 릴레이션의 차수는 그 관계 스키마를 구성하는 속성의 수다. 예를 들어 학번·이름·학과라는 세 열로 정의한 학생 릴레이션의 차수는 3이다. 학생 행을 추가하거나 삭제하면 튜플 수인 카디널리티가 달라지지만 열 정의를 바꾸지 않는 한 차수는 그대로다. 테이블 수나 데이터베이스 수는 여러 객체를 세는 수치로서 한 릴레이션의 차수와는 다르다. 속성 수와 튜플 수를 열과 행의 관점으로 구별하면 용어를 혼동하지 않을 수 있다.
선지별 해설
- 튜플 수는 카디널리티다.
- 테이블의 개수는 개별 릴레이션의 차수가 아니다.
- 데이터베이스의 개수는 릴레이션의 차수가 아니다.
- 스키마에 정의한 속성의 개수가 차수다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relation Schema; Relation Instance
57. Chen 방식의 기본 E-R 다이어그램 표기에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 개체 — 사각형
- 속성 — 타원
- 관계 — 마름모
- 요소 사이의 연결 — 삼각형
정답과 해설 보기
정답: 4
정답은 ④이다. Chen 방식의 E-R 표기에서는 개체 집합을 사각형, 속성을 타원, 관계를 마름모로 나타내고 이 요소들을 선으로 연결한다. 따라서 연결 자체를 삼각형으로 나타낸다는 설명은 맞지 않는다. 표기법에 따라 까마귀발이나 다른 기호를 사용할 수 있으며, 확장 E-R에서는 일반화·특수화를 별도 기호로 나타내기도 한다. 그런 다른 용도의 삼각형과 기본 E-R의 연결선을 혼동하면 안 된다. 문항은 Chen의 기본 표기법을 기준으로 비교한다.
선지별 해설
- Chen 표기에서 개체를 나타내는 기본 도형이다.
- Chen 표기에서 속성을 나타내는 기본 도형이다.
- Chen 표기에서 관계를 나타내는 기본 도형이다.
- 연결은 선으로 나타내며 삼각형이 아니다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, ER Model — ER Model Basics
58. 트랜잭션의 실행이 실패하였음을 알리는 연산자로 트랜잭션 이 수행한 결과를 원래의 상태로 원상 복귀 시키는 연산은?
- COMMIT 연산
- BACKUP 연산
- LOG 연산
- ROLLBACK 연산
정답과 해설 보기
정답: 4
정답은 ④이다. ROLLBACK은 아직 확정하지 않은 현재 트랜잭션의 변경을 취소하여 그 트랜잭션 전 상태로 되돌리는 명령이다. 일부 구간만 취소하려면 DBMS가 지원하는 SAVEPOINT 등을 사용할 수 있다. COMMIT은 변경을 확정하고, 백업은 별도의 복구용 사본을 만들며, 로그는 변경과 복구에 필요한 기록을 남기는 기능이다. 이미 COMMIT한 과거의 모든 변경을 일반적인 ROLLBACK 한 번으로 취소하는 것은 아니므로 확정 전 변경이라는 적용 범위를 구별해야 한다.
선지별 해설
- 현재 트랜잭션의 변경을 확정한다.
- 복구에 사용할 사본을 만드는 작업이다.
- 변경·복구에 필요한 기록을 남기는 개념이다.
- 현재 트랜잭션의 확정 전 변경을 취소한다.
편집 해설 근거: PostgreSQL 18, 3.4 Transactions — §3.4 Transactions — BEGIN, COMMIT and ROLLBACK
59. 속성 간 종속성을 고려하지 않은 관계 스키마의 정규화 과정에서 다루는 대표적인 삽입·삭제·갱신 이상 분류에 속하지 않는 것은?
[학습용 개정문항]
- 검색 이상
- 삽입 이상
- 삭제 이상
- 갱신 이상
정답과 해설 보기
정답: 1
정답은 ①이다. 정규화에서 다루는 대표적인 갱신 이상은 삽입·삭제·수정 과정에서 불필요한 제약이나 정보 손실, 불일치가 생기는 현상이다. 삽입 이상은 다른 정보 없이는 필요한 사실을 저장하기 어려운 경우, 삭제 이상은 한 사실을 지우면서 다른 필요한 정보까지 잃는 경우, 갱신 이상은 중복된 사실의 일부만 고쳐 불일치가 생기는 경우다. 검색 이상은 이 세 종류를 나열하는 정규화 문맥의 표준적인 명칭이 아니다. 동시성 때문에 생기는 비일관적 읽기와는 다른 분류다.
선지별 해설
- 정규화에서 비교하는 삽입·삭제·갱신 이상의 세 분류에 속하지 않는다.
- 독립적인 사실을 넣기 위해 불필요한 다른 정보가 필요할 수 있다.
- 어떤 사실의 삭제로 보존해야 할 다른 정보도 사라질 수 있다.
- 중복 사실의 일부만 바뀌어 데이터가 불일치할 수 있다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — Pitfalls in Relational Database Design; Functional Dependencies; Decomposition
60. 관계 스키마가 BCNF(Boyce-Codd Normal Form)를 만족하는 정확한 조건은?
[학습용 개정문항]
- 모든 비자명한 함수 종속 X→Y에서 결정자 X가 슈퍼키다.
- 모든 이행적 함수 종속만 제거하면 충분하다.
- 모든 부분 함수 종속만 제거하면 충분하다.
- 속성의 값이 원자값이기만 하면 충분하다.
정답과 해설 보기
정답: 1
정답은 ①이다. BCNF는 스키마에서 성립하는 모든 비자명한 함수 종속 X→Y의 결정자 X가 슈퍼키여야 한다는 조건이다. 비자명하다는 것은 Y가 X의 부분집합으로만 이루어지지 않는다는 뜻이다. 후보키는 최소성을 갖춘 슈퍼키이지만 BCNF의 결정자에 최소성까지 요구하지는 않는다. 예를 들어 A가 후보키이면 A에 다른 속성을 추가한 집합도 슈퍼키일 수 있다. 부분 함수 종속이나 이행적 종속을 제거한다는 설명만으로 BCNF의 정확한 조건을 대신할 수 없다.
선지별 해설
- 모든 비자명한 함수 종속의 결정자가 슈퍼키라는 것이 BCNF 조건이다.
- 이행적 종속을 제거한다는 표현만으로 BCNF의 정확한 조건이 되지 않는다.
- 부분 종속 제거는 주로 제2정규형의 조건과 관련된다.
- 원자값 조건은 제1정규형의 출발점이다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — Boyce-Codd Normal Form
정보처리기사 필기 기출문제 · 프로그래밍 언어 활용
61. 무선 LAN에서 매체의 사용 상태를 감지하고 대기·백오프 등을 이용해 동시 송신의 가능성을 줄이는 충돌 회피 방식은? RTS/CTS는 필요에 따라 선택적으로 사용할 수 있다.
[학습용 개정문항]
- STA
- Collision Domain
- CSMA/CA
- CSMA/CD
정답과 해설 보기
정답: 3
정답은 ③이다. CSMA/CA는 공유 무선 매체의 사용 상태를 감지하고 대기·백오프 등으로 동시에 송신할 가능성을 줄이는 충돌 회피 방식이다. IEEE 802.11에서는 수신 확인 ACK와 선택적인 RTS/CTS 교환 등을 함께 사용할 수 있다. 충돌 회피라는 이름이 충돌을 완전히 없앤다는 뜻은 아니다. CSMA/CD는 송신 도중 충돌을 검출하는 방식이며, STA는 무선 통신에 참여하는 스테이션, 충돌 도메인은 충돌 가능성이 공유되는 영역을 가리키므로 매체 접근 방식의 이름과 구별한다.
선지별 해설
- 무선 통신의 스테이션을 가리키는 용어다.
- 충돌 가능성이 공유되는 네트워크 영역이다.
- 캐리어 감지와 백오프 등을 활용하는 충돌 회피 방식이다.
- 충돌 회피보다 송신 중 충돌 검출을 중심으로 하는 방식이다.
편집 해설 근거: IEEE 802.11 TGa — 802.11 MAC principles (1997) — p.4, 802.11 MAC principles; 802.11 Medium Sharing
62. 다음 중 가장 약한 결합도(Coupling)는?
- Common Coupling
- Content Coupling
- External Coupling
- Stamp Coupling
정답과 해설 보기
정답: 4
정답은 ④이다. 전통적인 모듈 결합도 비교에서 스탬프 결합은 레코드나 구조체 같은 복합 자료를 인수로 넘겨 그 구조에 의존하는 경우다. 필요한 단순 값만 주고받는 자료 결합보다는 강하지만, 보기의 공통 자료 영역 공유·외부 규약 공유·다른 모듈 내부 직접 접근보다 약한 것으로 분류한다. 공통 결합은 공유 전역 상태에, 내용 결합은 다른 모듈의 내부 구현에 직접 의존한다. 실제 설계에서는 명칭의 순위만 볼 것이 아니라 공유 범위와 변경 영향도 함께 살펴야 한다.
선지별 해설
- 여러 모듈이 공유하는 공통 데이터 영역에 의존한다.
- 다른 모듈의 내부 코드나 자료에 직접 의존하는 강한 결합이다.
- 외부에서 정한 자료 형식이나 통신 규약 등에 함께 의존한다.
- 구조화한 자료를 인수로 전달하는 결합으로 보기 중 상대적으로 약하다.
편집 해설 근거: University of Texas at El Paso, CS4311 Lecture 6 — Cohesion and Coupling — Coupling; Common Coupling; External Coupling; Stamp Coupling; CMU SEI, Candidate Complexity Metrics (2016), Appendix A.6 — Appendix A.6 Coupling
63. 다음 C 프로그램의 출력은?
#include <stdio.h>
int main(void) {
    int a = 4;
    int b = 7;
    int c = a | b;
    printf("%d", c);
    return 0;
}
[학습용 개정문항]
- 3
- 4
- 7
- 10
정답과 해설 보기
정답: 3
정답은 ③이다. 비트 OR 연산자 |는 같은 자리의 두 비트 중 하나라도 1이면 결과 비트를 1로 만든다. 4는 이진수 100이고 7은 111이므로 100 | 111은 111, 즉 십진수 7이다. 두 수를 더하는 연산이 아니며 참·거짓으로 해석하는 논리 OR 연산자 ||와도 다르다. c에는 이 정수 결과가 저장되고 printf의 %d로 7이 출력된다. 이미지의 헤더와 인용부호를 표준 C 문법으로 옮겨 실제 학습 코드의 모양을 명확하게 했다.
선지별 해설
- 4와 7의 XOR 결과 3과 혼동한 값이다.
- 4와 7의 비트 AND 결과 4와 혼동한 값이다.
- 비트 OR의 결과 111(2), 즉 7이다.
- 제시한 비트 연산의 결과가 아니다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.12 Bitwise inclusive OR operator; §7.21.6.1
64. 이미지의 Python FourCal 덧셈 프로그램이 출력하는 값은?
- 0
- 2
- 4
- 6
정답과 해설 보기
정답: 4
정답은 ④이다. a=FourCal()로 인스턴스를 만들고 a.setdata(4, 2)를 호출하면 첫 매개변수 sel에는 그 인스턴스가 자동으로 전달된다. 따라서 sel.fir에는 4, sel.sec에는 2가 저장된다. 이어 a.add()는 두 속성을 더한 6을 반환하고 print가 이를 출력한다. 관례적으로 첫 매개변수를 self라고 쓰지만 self가 강제된 예약어는 아니므로 그림처럼 sel이라는 이름을 써도 된다. 속성의 저장과 메서드 호출을 순서대로 추적하면 새 값이 어디에 남는지 확인할 수 있다.
선지별 해설
- 두 속성은 4와 2로 설정되므로 합이 0이 아니다.
- 두 번째 피연산자만 본 값이다.
- 첫 번째 피연산자만 본 값이다.
- 인스턴스 속성 4와 2의 합이다.
편집 해설 근거: Python 3 공식 자습서, 9 Classes — §9.3.3 Instance Objects; §9.3.4 Method Objects; §9.4 Random Remarks
65. 교착상태의 해결 방법 중 은행원 알고리즘(Banker's Algorithm)이 해당되는 기법은?
- Detection
- Avoidance
- Recovery
- Prevention
정답과 해설 보기
정답: 2
정답은 ②이다. 은행원 알고리즘은 각 프로세스가 앞으로 요구할 수 있는 최대 자원량을 이용해 요청을 승인한 뒤에도 안전한 실행 순서가 존재하는지 검사한다. 안전 상태를 유지할 수 있을 때 자원을 할당하므로 교착상태 회피에 속한다. 예방은 교착에 필요한 조건 중 하나가 성립하지 않도록 제약하고, 탐지는 이미 발생한 교착 여부를 찾아내며, 복구는 종료나 자원 회수 등으로 그 상태를 해소한다. 안전하지 않은 상태라는 사실이 이미 교착상태라는 뜻은 아니라는 점도 구별해야 한다.
선지별 해설
- 현재의 교착 여부를 찾아내는 탐지 기법과 다르다.
- 안전 상태를 유지하도록 요청을 사전에 심사하는 회피 기법이다.
- 발생한 교착을 종료·자원 회수 등으로 해소하는 단계다.
- 필요조건 자체를 성립하지 않게 하는 예방과 구별된다.
편집 해설 근거: Silberschatz·Galvin·Gagne, Operating System Concepts 9판, 7 Deadlocks — Deadlock Avoidance; Safe State; Banker’s Algorithm
66. CIDR(Classless Inter-Domain Routing) 표기로 203.241.132.82/27과 같이 사용되었다면, 해당 주소의 서브 넷 마스크(subnet mask)는?
- 255.255.255.0
- 255.255.255.224
- 255.255.255.240
- 255.255.255.248
정답과 해설 보기
정답: 2
정답은 ②이다. /27은 IPv4 주소 32비트 중 앞의 27비트가 네트워크 접두부임을 뜻한다. 마스크는 1을 27개 쓴 뒤 0을 5개 붙인 형태다. 앞 세 옥텟은 각각 11111111이므로 255이고 마지막 옥텟은 11100000이므로 128+64+32=224다. 따라서 서브넷 마스크는 255.255.255.224다. 주소의 첫 옥텟을 보고 예전 클래스의 기본 마스크를 적용하는 것이 아니라 명시된 접두부 길이를 따라야 한다.
선지별 해설
- /24에 해당하는 마스크다.
- 앞 27비트가 1인 /27의 마스크다.
- 앞 28비트가 1인 /28의 마스크다.
- 앞 29비트가 1인 /29의 마스크다.
편집 해설 근거: RFC 4632, Classless Inter-domain Routing (2006) — §3.1 Basic Concept and Prefix Notation
67. 다음 Java 프로그램의 출력은?
public class Operator {
    public static void main(String[] args) {
        int x = 5, y = 0, z = 0;
        y = x++;
        z = --x;
        System.out.print(x + ", " + y + ", " + z);
    }
}
[학습용 개정문항]
- 5, 5, 5
- 5, 6, 5
- 6, 5, 5
- 5, 6, 4
정답과 해설 보기
정답: 1
정답은 ①이다. 처음 x=5다. y=x++에서 후위 증가식의 값은 증가 전의 5이므로 y에는 5가 들어가고 그 뒤 x는 6이 된다. 다음 z=–x에서는 x를 먼저 1 줄여 5로 만든 뒤 그 값을 사용하므로 z도 5다. 따라서 출력 시점의 x·y·z는 모두 5이며 5, 5, 5가 출력된다. 각 식이 별도의 문장이므로 대입과 증감이 진행되는 순서를 문장별로 정리하면 된다. 모든 증감 연산이 같은 시점의 값을 사용한다고 계산하면 오답이 된다.
선지별 해설
- 후위 증가와 전위 감소를 차례대로 적용한 세 변수의 값이다.
- y에는 증가 전 값 5가 저장되므로 6이 아니다.
- 전위 감소 뒤 x는 5가 된다.
- y는 5이고 z는 5이므로 두 값 모두 잘못되었다.
편집 해설 근거: Oracle Java SE 17 Language Specification, Chapter 15 Expressions — §15.14.2 Postfix Increment Operator; §15.15.2 Prefix Decrement Operator
68. 프로세스 적재 정책과 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 반복해서 접근하는 코드나 자료는 시간 지역성을 보일 수 있다.
- 공간 지역성은 가까운 주소를 이어서 참조할 가능성이 높은 경향이다.
- 유용한 프로세스 처리 시간이 페이지 교환 시간보다 크기 때문에 스레싱이 발생한다.
- 필요한 작업 집합의 프레임을 확보하거나 동시 실행 부하를 조정하면 스레싱 완화에 도움이 된다.
정답과 해설 보기
정답: 3
정답은 ③이다. 스레싱은 필요한 작업 집합을 충분히 메모리에 두지 못해 페이지 부재와 교환이 지나치게 반복되고 실제 작업보다 페이징에 자원을 소모하는 상태다. 따라서 실제 처리 시간이 페이지 교환 시간보다 크기 때문에 스레싱이 발생한다는 설명은 원인을 거꾸로 잡은 것이다. 시간 지역성은 최근 사용한 주소를 다시 사용할 가능성이고 공간 지역성은 가까운 주소를 사용할 가능성이다. 충분한 프레임을 확보하거나 동시에 실행하는 작업량을 조정하여 과도한 페이지 교환을 줄일 수 있다.
선지별 해설
- 반복해서 사용하는 코드나 자료는 시간 지역성을 보일 수 있다.
- 서로 가까운 주소를 이어서 참조하는 경향이다.
- 스레싱은 유용한 처리보다 페이징 부담이 과도해지는 상태이므로 반대 설명이다.
- 작업 집합을 위한 프레임 확보와 부하 조정이 완화에 도움이 된다.
편집 해설 근거: Arpaci-Dusseau, OSTEP, 22 Beyond Physical Memory: Policies (2025 개정 표시본) — Thrashing; Arpaci-Dusseau, OSTEP v1.10, 18 Paging: Introduction — Paging: Introduction
69. 프레임워크(Framework)에 대한 설명으로 옳은 것은?
- 소프트웨어 구성에 필요한 기본 구조를 제공함으로써 재 사용이 가능하게 해준다
- 소프트웨어 개발 시 구조가 잡혀 있기 때문에 확장이 불 가능하다.
- 소프트웨어 아키텍처(Architecture)와 동일한 개념이다.
- 모듈화(Modularity)가 불가능하다.
정답과 해설 보기
정답: 1
정답은 ①이다. 프레임워크는 일정한 응용 영역에서 재사용할 수 있는 기본 구조와 협력하는 구성요소를 제공한다. 개발자는 정해진 확장 지점이나 설정을 이용하여 필요한 동작을 구체화할 수 있다. 기본 구조가 있다는 이유로 확장이 불가능한 것은 아니며, 오히려 허용한 방식으로 확장하도록 설계하는 경우가 많다. 아키텍처는 시스템의 구조와 중요한 설계 결정을 가리키는 더 넓은 개념이므로 프레임워크와 동일한 말은 아니다. 모듈화 역시 프레임워크와 양립할 수 있다.
선지별 해설
- 공통 구조와 구성요소를 재사용하여 응용을 만들 수 있게 한다.
- 확장 지점이나 설정으로 응용별 동작을 추가할 수 있다.
- 프레임워크는 특정 아키텍처를 구현할 수 있지만 두 용어가 같은 뜻은 아니다.
- 구성요소와 역할을 모듈로 분리할 수 있다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — Overview of Frameworks; Comparing Class Libraries and Frameworks; Benefits and Limitations
70. 다음 Java 프로그램의 출력은?
public class Array1 {
    public static void main(String[] args) {
        int cnt = 0;
        do {
            cnt++;
        } while (cnt < 0);
        if (cnt == 1)
            cnt++;
        else
            cnt = cnt + 3;
        System.out.printf("%d", cnt);
    }
}
[학습용 개정문항]
- 2
- 3
- 4
- 5
정답과 해설 보기
정답: 1
정답은 ①이다. cnt는 0에서 시작하지만 do-while은 본문을 먼저 실행한 뒤 조건을 검사한다. 첫 본문에서 cnt++로 1이 되고 cnt<0은 거짓이므로 반복이 끝난다. 이어 if(cnt==1)가 참이어서 cnt++를 한 번 더 실행하여 2가 된다. else의 cnt=cnt+3은 실행되지 않는다. 따라서 출력은 2다. 반복문의 조건이 처음부터 거짓일 것이라고 보고 본문을 생략하거나, if와 else를 둘 다 실행하는 것으로 계산하지 않아야 한다.
선지별 해설
- do 본문 한 번과 참인 if 분기의 증가를 반영한 결과다.
- 실행되지 않는 증가나 분기를 잘못 반영한 값이다.
- 거짓인 else의 +3을 적용했을 때 나오는 잘못된 값이다.
- if와 else를 함께 적용하는 등 실제 제어 흐름과 다른 값이다.
편집 해설 근거: Oracle Java SE 17 Language Specification, Chapter 14 Blocks and Statements — §14.13 The do Statement; §14.9 The if Statement
71. 리눅스 Bash 쉘(Shell)에서 export와 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 현재 셸에서 변수 값을 출력하려면 반드시 먼저 export해야 한다.
- export -p는 내보내기로 표시된 변수 목록을 보여준다.
- set -a 등이 꺼진 일반 상태에서 새로 만든 비수출 셸 변수는 자식 명령의 환경에 자동 포함되지 않는다.
- export는 이후 실행할 자식 명령의 환경에 값을 포함하며 영구 저장이나 부모로의 역전파를 보장하지 않는다.
정답과 해설 보기
정답: 1
정답은 ①이다. export는 셸 변수를 이후 실행하는 자식 명령의 환경에 포함하도록 표시하는 명령이다. 현재 셸에서 변수 값을 출력하는 데에는 printf나 echo를 사용할 수 있으며 export가 선행되어야 하는 것은 아니다. export -p는 내보내기로 표시된 변수들을 보여준다. 내보낸 값은 자식 프로세스가 상속하지만 자식의 변경이 부모 셸로 역전파되거나 셸을 종료한 뒤 자동으로 영구 저장되지는 않는다. 원문의 전역 변수처럼 끝까지 기억된다는 설명도 부정확하여 상속 범위를 명시했다.
선지별 해설
- 현재 셸 변수는 export 없이도 printf 등으로 출력할 수 있다.
- 내보내기로 표시한 변수의 목록을 보여준다.
- 새로 만든 일반 셸 변수는 자동으로 자식 명령의 환경에 포함되지 않는다.
- export는 이후 자식 명령의 환경으로 전달하며 영구 저장을 뜻하지 않는다.
편집 해설 근거: GNU Bash Reference Manual, Edition 5.3 (2025) — §4.1 Bourne Shell Builtins — export; §3.7.4 Environment
72. ASCII 실행 문자 집합을 사용하는 환경에서 다음 C 프로그램의 출력은?
#include <stdio.h>
int main(void) {
    char a;
    a = 'A' + 1;
    printf("%d", a);
    return 0;
}
[학습용 개정문항]
- 1
- 11
- 66
- 98
정답과 해설 보기
정답: 3
정답은 ③이다. ASCII 실행 문자 집합을 사용한다는 조건에서 대문자 A의 코드값은 65다. 문자 상수 A에 정수 1을 더하면 66이 되고 이 값은 char 변수 a에 저장된다. printf의 %d는 전달받은 값을 정수로 표시하므로 문자 B가 아니라 66을 출력한다. 가변 인수로 전달할 때 char는 정수 승격을 거친다. C 언어 자체가 모든 실행 환경에서 A를 65로 보장하는 것은 아니므로 ASCII라는 전제가 없으면 숫자 66을 보편적인 결과로 단정할 수 없다.
선지별 해설
- 더한 증가량만 본 값이다.
- ASCII의 A 코드와 맞지 않는다.
- ASCII A의 65에 1을 더한 정수값이다.
- 소문자 b의 ASCII 값으로 대문자 A를 사용한 코드와 다르다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §5.2.1 Character sets; §6.4.4.4 Character constants; §6.3.1.1; §7.21.6.1; RFC 20, ASCII format for Network Interchange — §2 Standard Code — column 4, row 1 (A); §3 Character Representation
73. 다음 C11 프로그램은 행 포인터로 2차원 배열의 유효한 원소만 읽는다. 출력값은?
#include <stdio.h>
int main(void) {
    int a[2][2] = {{11, 22}, {44, 55}};
    int (*p)[2] = a;
    int sum = 0;
    for (int i = 1; i < 4; i++)
        sum += p[i / 2][i % 2];
    printf("%d", sum);
    return 0;
}
[학습용 개정문항]
- 55
- 77
- 121
- 132
정답과 해설 보기
정답: 3
정답은 ③이다. p는 정수 두 개로 이루어진 행을 가리키는 포인터이므로 p[행][열]로 각 하위 배열 안의 원소에 접근한다. i=1일 때 i/2=0, i%2=1이어서 22를 더하고, i=2일 때 44, i=3일 때 55를 더한다. 합은 22+44+55=121이다. 원본처럼 첫 행의 int 포인터를 계속 증가시켜 다음 행의 원소를 역참조하면 하위 배열의 경계를 벗어나는 문제가 있으므로 결과를 표준 C가 보장하지 않는다. 개정 코드는 행과 열을 나누어 유효한 범위의 접근만 수행한다.
선지별 해설
- 마지막 원소 하나만 더한 값이다.
- 22와 55만 더하여 중간의 44가 빠진 값이다.
- i=1, 2, 3에 대응하는 22·44·55의 합이다.
- 첫 원소 11까지 포함한 전체 합으로 반복문은 i=1에서 시작한다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.2.1 Array subscripting; §6.5.6 Additive operators
74. 매핑할 가상 주소 영역과 엔트리 크기가 같고 페이지마다 엔트리 하나를 두는 선형 페이지 테이블을 사용한다. 페이지 크기를 줄일 때의 설명으로 틀린 것은?
[학습용 개정문항]
- 페이지 할당 경계에서 낭비하는 공간을 줄일 수 있다.
- 같은 크기의 자료를 담는 데 필요한 페이지 수가 늘어난다.
- 평균적인 내부 단편화가 줄어드는 경향이 있다.
- 페이지 테이블의 크기가 감소한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 같은 크기의 가상 주소 영역을 같은 크기의 페이지 테이블 엔트리로 매핑한다면 페이지를 작게 할수록 필요한 페이지 수가 늘고 선형 페이지 테이블도 커진다. 페이지 할당 경계 때문에 남는 내부 공간은 평균적으로 줄어드는 경향이 있지만, 더 많은 주소 변환 정보가 필요한 부담이 있다. 작은 페이지가 실제 입출력 시간을 항상 늘린다고 단정할 수는 없다. 장치와 묶음 전송, 지역성 등에 따라 결과가 달라지므로 개정 보기에서는 같은 자료량을 담는 페이지 수의 증가를 비교한다.
선지별 해설
- 페이지 경계의 내부 낭비를 줄여 할당 공간 이용을 개선할 수 있다.
- 같은 자료량을 담는 데 더 많은 페이지가 필요하다.
- 평균적인 페이지 내부의 남는 공간은 줄어드는 경향이 있다.
- 엔트리 수가 늘어나므로 명시한 선형 페이지 테이블 크기는 감소하지 않는다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 18 Paging: Introduction — Simple Example and Overview; Where Are Page Tables Stored?; Arpaci-Dusseau, OSTEP, 22 Beyond Physical Memory: Policies (2025 개정 표시본) — Thrashing
75. 다음 중 가장 강한 응집도(Cohesion)는?
- Sequential Cohesion
- Procedural Cohesion
- Logical Cohesion
- Coincidental Cohesion
정답과 해설 보기
정답: 1
정답은 ①이다. 순차적 응집은 한 처리의 출력이 다음 처리의 입력으로 이어지는 관계로 기능들을 묶은 경우다. 절차적 응집은 실행 순서 때문에, 논리적 응집은 비슷한 범주의 기능이라는 이유로, 우연적 응집은 뚜렷한 관련 없이 요소를 묶은 경우다. 전통적인 응집도 분류에서 보기 중 가장 강한 것은 순차적 응집이다. 전체 분류에서는 단일 목적을 위해 모든 요소가 협력하는 기능적 응집을 더 높게 두지만 그 항목은 이 문제의 보기에 없다.
선지별 해설
- 앞 처리의 출력이 뒤 처리의 입력으로 이어지며 보기 중 가장 강하다.
- 주로 실행 순서만 공유하는 묶음으로 순차적 응집보다 약하다.
- 비슷한 범주의 기능을 모은 것으로 자료 흐름의 연결보다 약하다.
- 관련성이 뚜렷하지 않은 요소를 우연히 함께 둔 약한 응집이다.
편집 해설 근거: University of Texas at El Paso, CS4311 Lecture 6 — Cohesion and Coupling — slide 6 Type of Cohesion; slide 14 Sequential Cohesion
76. TCP 프로토콜과 관련한 설명으로 틀린 것은?
[학습용 개정문항]
- 인접 노드 사이의 프레임 전송을 직접 담당한다.
- 수신 측 여력에 맞추는 흐름 제어 기능을 수행한다.
- 논리적인 TCP 연결에서 전이중 방식의 바이트 스트림을 제공한다.
- 데이터와 상대 방향의 ACK 정보를 같은 세그먼트에 실을 수 있다.
정답과 해설 보기
정답: 1
정답은 ①이다. TCP는 끝단 응용 사이에 신뢰할 수 있는 순서 있는 바이트 스트림을 제공하는 전송 계층 프로토콜이다. 흐름 제어로 수신 측이 받아들일 수 있는 양을 조정하며 한 연결에서 양방향으로 데이터를 보낼 수 있다. TCP 세그먼트에는 데이터와 상대 방향의 ACK 정보를 함께 실을 수도 있다. 인접 노드 사이의 프레임 전달은 데이터 링크 계층의 역할이므로 TCP의 역할과 다르다. 여기서 연결은 논리적인 상태 관리이지 전용 물리 회선을 배정한다는 뜻은 아니다.
선지별 해설
- 인접 노드의 프레임 전달은 데이터 링크 계층의 역할이다.
- 수신 윈도 등으로 수신 측 처리 여력에 맞추어 전송을 조정한다.
- 한 연결에서 양방향 바이트 스트림을 제공한다.
- 데이터를 보내는 세그먼트에 ACK 정보를 함께 실을 수 있다.
편집 해설 근거: IETF RFC 9293, Transmission Control Protocol (2022) — §2.2 Model of Operation; §3.1 Header Format; §3.8.6 Managing the Window; ITU-T X.200 (07/1994), OSI Basic Reference Model — §7.6 Data Link Layer
77. 그림에서 ㉠은 식을 묶는 괄호다. 괄호로 지정한 묶음을 먼저 처리하고, 나머지 C 연산자를 결합 우선순위가 높은 순서로 나열한 것은?
[학습용 개정문항]
- ㉠, ㉥, ㉣, ㉢, ㉡, ㉤
- ㉠, ㉣, ㉥, ㉢, ㉡, ㉤
- ㉠, ㉣, ㉥, ㉢, ㉤, ㉡
- ㉠, ㉥, ㉣, ㉤, ㉡, ㉢
정답과 해설 보기
정답: 1
정답은 ①이다. 그림의 괄호는 먼저 묶어 계산할 식의 범위를 정한다. 제시된 연산자들의 결합 우선순위는 나눗셈 /, 시프트 <<, 관계 비교 <, 동등 비교 ==, 논리 OR || 순서다. 따라서 기호로는 ㉠ → ㉥ → ㉣ → ㉢ → ㉡ → ㉤이다. 괄호 자체를 일반적인 이항 연산자로 볼 필요는 없으며 표현식의 결합을 지정하는 문법으로 이해한다. 우선순위가 높다는 사실과 피연산자의 실제 평가 순서가 항상 왼쪽부터라는 주장은 별개다.
선지별 해설
- 괄호 묶음 뒤에 /, <<, <, ==, || 순서가 맞다.
- 나눗셈이 시프트보다 높은 우선순위를 가진다.
- 논리 OR보다 동등 비교가 먼저 결합한다.
- 관계 비교가 논리 OR와 동등 비교보다 높은 우선순위를 가진다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.5.1 Primary expressions; §6.5.5–§6.5.9; §6.5.14
78. C언어 라이브러리 중 stdlib.h에 대한설명으로 옳은 것은?
[학습용 개정문항]
- strtol·atoi 등의 수치 변환과 malloc·free 등의 메모리 관리 함수를 선언한다.
- 문자열 길이를 구하는 strlen을 선언하는 헤더다.
- 표준 입출력 함수들을 선언하는 헤더다.
- 삼각함수·제곱근 등 수학 함수를 선언하는 헤더다.
정답과 해설 보기
정답: 1
정답은 ①이다. C 표준 라이브러리의 stdlib.h에는 strtol·atoi 같은 문자열의 수치 변환, malloc·free 같은 동적 메모리 관리, 프로그램 종료와 검색·정렬 등의 일반 유틸리티가 선언된다. strlen은 string.h, 표준 입출력 함수는 stdio.h, 삼각함수와 제곱근 같은 수학 함수는 math.h와 관련된다. 수치를 문자열로 바꾸는 비표준 itoa를 모든 표준 C 환경의 stdlib.h 함수로 설명해서는 안 된다. 개정 보기에서는 실제 표준 함수 이름으로 범위를 분명히 했다.
선지별 해설
- stdlib.h에 선언되는 수치 변환과 동적 메모리 관리 함수들이다.
- strlen은 string.h에 선언된다.
- 표준 입출력은 stdio.h가 담당한다.
- 삼각함수·제곱근 등은 math.h에 선언된다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §7.22 General utilities <stdlib.h>; §7.24 String handling; §7.21 Input/output; §7.12 Mathematics
79. ECMAScript 2015 이후의 JavaScript 객체 모델에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 프로토타입의 개념이 존재한다.
- class 문법을 지원하므로 객체 상속에서 프로토타입 연결은 사용하지 않는다.
- 객체의 프로토타입 연결을 통해 상속된 속성을 찾을 수 있다.
- 객체지향 프로그래밍을 지원한다.
정답과 해설 보기
정답: 2
정답은 ②이다. JavaScript의 객체는 프로토타입 연결을 통해 다른 객체의 속성과 동작을 상속할 수 있다. ECMAScript 2015부터 class 문법도 제공하지만 그 문법이 프로토타입 기반 객체 모델을 없앤 것은 아니다. 따라서 class가 존재한다는 이유만으로 프로토타입을 사용하지 않는다고 주장하는 ②가 틀렸다. 객체지향 방식뿐 아니라 함수와 절차 중심의 프로그래밍도 지원한다. 원문의 클래스 기반 상속 지원이라는 표현만으로는 오답을 확정하기 어려워 상속의 실제 기반을 묻도록 고쳤다.
선지별 해설
- 프로토타입 객체와 연결이 존재한다.
- class 문법을 사용해도 프로토타입 기반 객체 모델이 유지된다.
- 프로토타입 연결을 통해 상속된 속성을 찾을 수 있다.
- 객체지향 프로그래밍을 지원하지만 그것만 가능한 것은 아니다.
편집 해설 근거: Ecma TC39, ECMAScript Language Specification — Overview — §4.3 ECMAScript Overview; §4.3.1 Objects
80. OSI 7계층 중 네트워크 계층에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 서로 다른 네트워크를 거쳐 패킷을 최종 목적지로 전달하는 역할을 한다.
- 인접한 두 노드 사이의 프레임 전달을 직접 담당한다.
- IP 패킷에는 발신지와 목적지의 논리 주소가 포함된다.
- 라우터나 L3 스위치는 패킷의 다음 전달 경로를 선택할 수 있다.
정답과 해설 보기
정답: 2
정답은 ②이다. 네트워크 계층은 여러 네트워크를 거쳐 목적지로 데이터를 전달하는 경로 선택과 중계 기능을 다룬다. IP에서는 출발지와 목적지의 논리 주소를 사용하며 라우터가 다음 전달 방향을 정한다. 인접한 두 노드 사이에서 프레임을 전달하는 것은 데이터 링크 계층의 역할이다. 스위치라는 장치 이름만으로 계층을 확정해서는 안 되며 L2 스위칭과 L3 라우팅 기능을 구별해야 한다. 개정 보기에서는 네트워크 계층 기능을 수행하는 L3 스위치임을 명시했다.
선지별 해설
- 여러 네트워크를 지나는 목적지 전달을 다룬다.
- 인접 노드의 프레임 전달은 데이터 링크 계층의 역할이다.
- IP 패킷은 출발지·목적지 논리 주소를 포함한다.
- 라우터와 L3 스위치는 네트워크 계층의 전달 기능을 수행할 수 있다.
편집 해설 근거: ITU-T X.200 (07/1994), OSI Basic Reference Model — §7.5 Network Layer; §7.6 Data Link Layer; IETF RFC 791, Internet Protocol (1981) — §3.1 Internet Header Format
정보처리기사 필기 기출문제 · 정보시스템 구축관리
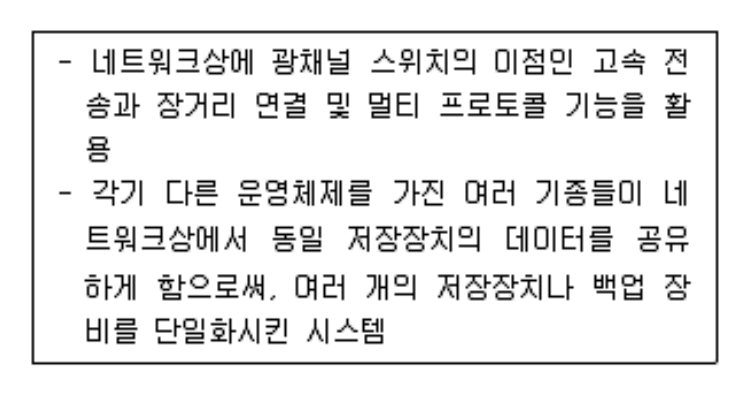
81. 다음 내용이 설명하는 것은?
- SAN
- MBR
- NAC
- NIC
정답과 해설 보기
정답: 1
정답은 ①이다. SAN은 서버와 저장 장치 사이에 블록 수준 저장 접근을 제공하는 저장 영역 네트워크다. 여러 서버가 저장 자원을 중앙에서 관리하고 활용할 수 있으며 Fibre Channel은 대표적인 연결 기술이다. SAN이 반드시 광채널만을 사용해야 하는 것은 아니고 IP 기반 iSCSI 등도 가능하다. 또한 서로 다른 서버가 같은 블록 장치를 동시에 읽고 쓴다고 파일 일관성이 자동 보장되지는 않으므로 공유 방식에 맞는 파일 시스템과 조정이 필요하다. NIC·NAC·MBR은 이러한 저장 네트워크의 명칭이 아니다.
선지별 해설
- 서버와 공유 저장 자원을 연결하는 저장 영역 네트워크다.
- 디스크의 부트 관련 영역을 가리키는 용어다.
- 네트워크 접근 제어를 가리킨다.
- 네트워크에 연결하는 인터페이스 장치다.
편집 해설 근거: IBM, What is a storage area network (SAN)? (2026-10-05 확인) — What is a storage area network?; SAN protocols; IETF RFC 7143, iSCSI Protocol (Consolidated, 2014) — §1 Introduction
82. SSH(Secure Shell)에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- SSH의 기본 등록 포트는 TCP 220번이다.
- 협상한 암호와 무결성 보호로 세션 데이터를 보호할 수 있다.
- 공개키 사용자 인증에서는 서버가 해당 사용자의 허용된 키인지 확인하고 개인키 보유 증명을 검증한다.
- 연결된 컴퓨터 사이에서 원격 명령 실행이나 셸 세션을 제공한다.
정답과 해설 보기
정답: 1
정답은 ①이다. SSH 서버가 일반적으로 사용하는 등록 포트는 TCP 22번이며 220번이 아니다. 관리자가 다른 포트로 설정할 수 있다는 사실과 기본 등록 포트는 구별한다. SSH는 원격 셸과 명령 실행 등을 지원하고 협상한 암호와 무결성 보호로 세션 데이터를 보호한다. 공개키 사용자 인증에서는 서버가 해당 사용자에게 허용한 키인지 확인하고 클라이언트가 개인키를 보유했음을 증명한다. 모든 인증이 반드시 개별 키 파일의 수동 등록만으로 이루어진다고 제한할 수는 없다.
선지별 해설
- 기본 등록 포트는 22번으로 220번이라는 설명이 틀렸다.
- 협상한 암호와 무결성 보호를 통해 세션 데이터를 보호할 수 있다.
- 서버가 허용한 사용자 키인지 확인하는 것이 공개키 인증의 핵심이다.
- 원격 셸과 명령 실행 등을 제공한다.
편집 해설 근거: IETF RFC 4253, SSH Transport Layer Protocol (2006) — §4.1 Use over TCP/IP; §6.3 Encryption; §6.4 Data Integrity; IETF RFC 4252, SSH Authentication Protocol (2006) — §7 Public Key Authentication Method: publickey; IETF RFC 4254, SSH Connection Protocol (2006) — §6 Interactive Sessions
83. 컴포넌트 기반 개발(CBD)에서 활동의 주된 목적을 기준으로 구별할 때, 요구 분석 단계의 산출물에 가장 적합한 것은?
[학습용 개정문항]
- 클래스 설계서
- 통합시험 결과서
- 프로그램 코드
- 사용자 요구사항 정의서
정답과 해설 보기
정답: 4
정답은 ④이다. 요구 분석의 주된 산출물은 사용자가 필요로 하는 기능과 품질 조건, 제약 등을 정의한 요구사항 문서다. 이 내용은 이후 컴포넌트의 책임과 인터페이스를 설계하고 구현·시험할 기준이 된다. 클래스 설계서는 설계, 프로그램 코드는 구현, 통합시험 결과서는 구성요소를 연결한 시험의 결과에 해당한다. 실제 CBD 절차의 단계명과 산출물 명칭은 적용하는 표준이나 조직에 따라 다를 수 있으므로, 이름이 명시되지 않은 단일 표준이 있다고 가정하지 않고 활동의 목적에 따라 구별한다.
선지별 해설
- 클래스 구조와 관계를 구체화하는 설계 활동의 산출물이다.
- 통합 시험의 수행 결과를 기록한 산출물이다.
- 기능을 실행 가능하게 구현한 산출물이다.
- 사용자 필요와 제약을 정의하는 요구 분석의 산출물이다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §3 Requirements Analysis; §4 Requirements Specification
84. 기밀성을 중심으로 보안 등급에 따른 접근을 통제한다. 높은 등급을 읽는 것을 금지하는 no read up과 낮은 등급으로 쓰는 것을 금지하는 no write down이 대표 규칙인 모델은?
[학습용 개정문항]
- Clark-Wilson Integrity Model
- PDCA Model
- Bell-Lapadula Model
- Chinese Wall Model
정답과 해설 보기
정답: 3
정답은 ③이다. Bell–LaPadula 모델은 보안 등급에 따른 정보 흐름을 통제하여 기밀성을 지키는 데 초점을 둔다. 단순 보안 성질은 자신보다 높은 등급의 정보를 읽지 못하게 하는 no read up이고, 별표 성질은 높은 정보가 낮은 등급으로 흘러가는 쓰기를 막는 no write down으로 설명한다. 같은 등급의 접근까지 무조건 금지하는 것은 아니다. 실제 허용에는 범주와 임의적 접근 권한 같은 조건도 함께 적용될 수 있다. 무결성이나 이해 상충을 중심으로 한 다른 모델과 구별한다.
선지별 해설
- 잘 형성된 거래와 직무 분리 등으로 무결성을 보호하는 모델이다.
- 계획·실행·점검·개선의 관리 순환으로 접근 제어 모델이 아니다.
- no read up·no write down으로 기밀성 흐름을 제한하는 모델이다.
- 이해 상충 집단 사이의 정보 접근을 제한하는 모델이다.
편집 해설 근거: Bell·LaPadula, Secure Computer System: Unified Exposition and Multics Interpretation (1976), IEEE 보존 원문 — Simple-security condition; *-property
85. 2021년 시험의 기술 문맥에서, Hadoop과 관계형 데이터베이스 사이의 대량 데이터 전송을 위해 설계된 Apache 도구는?
[학습용 개정문항]
- Apnic
- Topology
- Sqoop
- SDB.
정답과 해설 보기
정답: 3
정답은 ③이다. Sqoop은 Hadoop과 관계형 데이터베이스 등 구조화된 데이터 저장소 사이의 대량 자료 전송을 위해 개발된 Apache 도구다. 가져오기에서는 데이터베이스의 테이블 내용을 Hadoop 쪽으로 옮기고 내보내기에서는 Hadoop의 자료를 외부 저장소로 전달할 수 있다. APNIC은 인터넷 번호 자원과 관련된 조직이고 topology는 연결 구조를 뜻하므로 이 제품의 이름이 아니다. Sqoop은 2021년에 Apache Attic으로 이동한 보존 프로젝트이므로 시험 당시의 도구 역할과 현재 유지보수 상태를 구별한다.
선지별 해설
- 인터넷 번호 자원과 관련된 조직의 이름이다.
- 네트워크 등의 연결 구조를 뜻하는 일반 용어다.
- Hadoop과 구조화된 저장소 사이의 대량 데이터 전송 도구다.
- 제시한 Apache 전송 도구의 이름이 아니다.
편집 해설 근거: Apache Sqoop 1.4.7 User Guide (보존 문서) — §1 Introduction; sqoop-import; sqoop-export; Apache Attic, Apache Sqoop, 2021년 은퇴 기록 — Project Retirement
86. 라우팅 프로토콜인 OSPF(Open Shortest Path First)에 대 한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 링크 상태 정보를 갱신하여 네트워크 변화에 따른 경로 재계산을 수행한다.
- 거리 벡터 라우팅 프로토콜이다.
- 일부 OSPF 제어 패킷 전송에 IP 멀티캐스트를 사용한다.
- 최단 경로 계산에 Dijkstra 알고리즘을 사용한다.
정답과 해설 보기
정답: 2
정답은 ②이다. OSPF는 링크 상태 라우팅 프로토콜이다. 라우터들이 링크 상태 정보를 교환하여 영역 내 토폴로지 데이터베이스를 구성하고 최단 경로 계산에 Dijkstra 알고리즘을 사용한다. 거리 벡터를 이웃에게 반복 전달하는 RIP 같은 방식과 구별된다. OSPF 제어 패킷에는 멀티캐스트 전송이 활용될 수 있지만, 이를 일반 사용자 멀티캐스트 트래픽의 라우팅을 OSPFv2 자체가 모두 제공한다는 의미로 확대하면 안 된다. 수렴 시간 역시 환경과 설정의 영향을 받는다.
선지별 해설
- 토폴로지 변화에 따라 링크 상태 갱신과 경로 재계산을 수행한다.
- 링크 상태 방식이므로 거리 벡터 방식이라는 설명이 틀렸다.
- 일부 제어 메시지의 전달에 IP 멀티캐스트를 사용할 수 있다.
- 최단 경로 트리를 계산하는 데 Dijkstra 알고리즘을 사용한다.
편집 해설 근거: IETF RFC 2328, OSPF Version 2 (1998) — §2 The Link-State Database: Organization and Calculations; §8.1 Sending protocol packets; §16.1 Calculating the shortest-path tree
87. 다음 중 소프트웨어 규모·공수 추정보다, 작업의 선후 관계와 소요시간을 네트워크로 표현하여 일정과 주요 경로를 분석하는 데 직접 초점을 둔 기법은?
[학습용 개정문항]
- COCOMO
- Putnam
- Function-Point
- PERT
정답과 해설 보기
정답: 4
정답은 ④이다. PERT는 작업 사이의 선후 관계와 소요시간을 네트워크로 표현하여 전체 일정과 중요한 경로를 분석하는 기법이다. COCOMO와 Putnam 계열 모형은 소프트웨어 규모·개발 특성 등과 공수를 연결하는 추정에 쓰이고, 기능점수는 사용자 기능 관점의 규모를 산정한 뒤 생산성 자료와 결합하여 공수 추정에 활용할 수 있다. PERT도 작업량이나 비용 계획과 연계할 수 있으므로 비용 추정과 절대로 무관하다고 단정하는 대신, 직접적인 중심 목적을 비교한다.
선지별 해설
- 소프트웨어 규모와 비용 요인 등을 사용한 공수 추정 모형이다.
- 개발 규모·일정·인력의 관계를 다루는 추정 모형 계열이다.
- 사용자 기능 관점의 규모 측정으로 공수 추정의 입력이 될 수 있다.
- 작업 의존관계와 소요시간을 이용한 네트워크 일정 분석이 중심이다.
편집 해설 근거: R. G. Batson, NASA TM-100311 Program Risk Analysis Handbook (1987) — §E Analytical Technique; network construction and time estimates; Barry W. Boehm, Software Engineering Economics (1984), 저자 논문 보존 사본 — Software cost-estimation models; COCOMO
88. 코드의 기입 과정에서 원래 '12536‘으로 기입되어야 하는데 ’12936‘으로 표기되었을 경우, 어떤 코드 오류에 해당하는 가?
- Addition Error
- Omission Error
- Sequence Error
- Transcription Error
정답과 해설 보기
정답: 4
정답은 ④이다. 12536과 12936은 자릿수가 같고 세 번째 위치의 5가 9로 잘못 옮겨 적혔다. 따라서 문자를 다른 문자로 잘못 기록한 전사 오류로 볼 수 있다. Addition Error는 불필요한 문자가 추가된 경우, Omission Error는 필요한 문자가 빠진 경우, Sequence Error는 순서가 뒤바뀐 경우와 구별한다. 이 예에서는 문자가 늘거나 줄지 않았고 기존 문자 두 개의 위치를 바꾼 것도 아니다. 먼저 길이와 달라진 위치를 확인하면 오류 유형을 판정하기 쉽다.
선지별 해설
- 문자가 더해져 자릿수가 증가한 예가 아니다.
- 문자가 빠져 자릿수가 줄어든 예가 아니다.
- 문자들의 위치가 서로 바뀐 예가 아니다.
- 같은 위치의 5를 9로 잘못 기록한 전사 오류다.
편집 해설 근거: NBS FIPS PUB 45 (1976), Guide for Data Element Standards, 역사 자료 — §4.4.1.2 Self-Checking Codes, printed p. 22 — transcription and transposition examples
89. ISO/IEC 12207:1995의 다섯 기본 생명주기 프로세스(Primary life cycle processes)에 해당하지 않는 것은?
[학습용 개정문항]
- 획득 프로세스
- 개발 프로세스
- 성능평가 프로세스
- 유지보수 프로세스
정답과 해설 보기
정답: 3
정답은 ③이다. ISO/IEC 12207:1995의 기본 생명주기 프로세스는 획득·공급·개발·운영·유지보수의 다섯 가지다. 따라서 성능평가는 이 다섯 기본 프로세스의 이름에 포함되지 않는다. 성능을 평가하는 활동 자체가 소프트웨어 생명주기에서 불필요하다는 뜻은 아니다. 최신 판은 프로세스의 묶음과 명칭이 달라졌으므로 판본을 생략한 채 이 목록을 현재 모든 12207 표준의 구조라고 소개하면 부정확하다. 개정 문항에서는 원문의 분류에 해당하는 1995년 판을 명시했다.
선지별 해설
- 1995년 판의 기본 프로세스 중 하나다.
- 1995년 판의 기본 프로세스 중 하나다.
- 1995년 판의 다섯 기본 프로세스 명칭에 포함되지 않는다.
- 1995년 판의 기본 프로세스 중 하나다.
편집 해설 근거: AS/NZS ISO/IEC 12207:1997 — ISO/IEC 12207:1995 동일 채택본, 대학 보존 자료 — Preface (ISO/IEC 12207:1995 동일 채택 명시); §4.1.1.1 Primary life cycle processes; §5
90. 초기 COCOMO 81에서 Organic·Semidetached·Embedded의 세 개발 모드로 프로젝트를 구분하는 비용 추정 모형은?
[학습용 개정문항]
- PUTNAM
- COCOMO
- FP
- SLIM
정답과 해설 보기
정답: 2
정답은 ②이다. 초기 COCOMO 모형은 프로젝트의 개발 환경과 제약을 Organic·Semidetached·Embedded의 세 모드로 나누어 공수와 일정의 관계를 추정했다. 익숙하고 비교적 유연한 환경인지, 경험과 제약이 혼재하는지, 하드웨어·운영 조건 등 강한 제약에 묶이는지에 따라 모형의 계수가 달라진다. 이 구분을 소프트웨어의 크기 하나만으로 판정해서는 안 된다. Putnam과 SLIM은 다른 추정 모형 계열이며 기능점수는 사용자 기능 관점의 규모 측정 방법이다.
선지별 해설
- 다른 인력·일정 추정 모형 계열이다.
- 초기 COCOMO의 세 개발 모드와 일치한다.
- 사용자 기능을 기준으로 규모를 산정하는 방식이다.
- Putnam 모형과 관련된 추정 도구·모형 계열이다.
편집 해설 근거: Barry W. Boehm, Software Engineering Economics (1984), 저자 논문 보존 사본 — COCOMO modes — Organic, Semidetached and Embedded
91. ISO/IEC 15504-2:2003(SPICE 계열)의 프로세스 능력 수준과 명칭을 잘못 연결한 것은?
[학습용 개정문항]
- 수준 7 – 미완성 단계
- 수준 5 – 최적화 단계
- 수준 4 – 예측 단계
- 수준 3 – 확립 단계
정답과 해설 보기
정답: 1
정답은 ①이다. ISO/IEC 15504-2:2003의 능력 수준은 0부터 5까지 여섯 단계이며 수준 7은 없다. 순서는 0 미완성, 1 수행, 2 관리, 3 확립, 4 예측, 5 최적화다. 따라서 미완성 단계를 수준 7에 연결한 ①이 틀렸다. 이 수준은 개별 프로세스의 수행 능력을 평가하는 척도이며 시험 점수나 제품의 등급을 뜻하지 않는다. 후속 표준과 다른 평가 모형에서는 명칭과 세부 요건이 달라질 수 있으므로 이 문항에서는 원문의 분류에 맞는 판본을 명시한다.
선지별 해설
- 미완성은 수준 0이며 수준 7은 이 척도에 없다.
- 수준 5는 최적화 과정이다.
- 수준 4는 예측 가능한 과정이다.
- 수준 3은 확립된 과정이다.
편집 해설 근거: ISO/IEC 15504-2:2003, Process assessment — Performing an assessment, 표준 원문 미리보기 — Contents, §5.1–§5.6 Measurement framework for process capability
92. PC, TV, 휴대폰에서 원하는 콘텐츠를 끊김없이 자유롭게 이 용할 수 있는 서비스는?
- Memristor
- MEMS
- SNMP
- N-Screen
정답과 해설 보기
정답: 4
정답은 ④이다. N-Screen은 TV·PC·휴대기기처럼 여러 단말에서 같은 콘텐츠를 이용하거나 이용 흐름을 이어가는 서비스 개념이다. 단말의 화면과 재생 능력, 통신 방식이 다르므로 형식 변환과 상태 연계 등이 필요할 수 있다. 이름에 N이 붙는 것은 여러 화면으로 사용 범위를 넓힌다는 뜻이지 모든 콘텐츠가 아무 제약 없이 자동 호환된다는 뜻은 아니다. Memristor는 소자, MEMS는 미세 전자기계 시스템, SNMP는 네트워크 관리 프로토콜이므로 질문의 미디어 서비스와 구별된다.
선지별 해설
- 상태에 따른 전기적 특성을 이용하는 소자 개념이다.
- 미세한 기계·전자 요소를 결합하는 기술 분야다.
- 네트워크 장비의 상태와 관리 정보를 다루는 프로토콜이다.
- 여러 단말에서 동일 콘텐츠를 이용하거나 이어 보는 서비스다.
편집 해설 근거: ITU-T Y Supplement 43 (02/2017), Deployment Models of N-screen services — Summary
93. SHA-256과 같은 고정 길이 암호학적 해시 함수에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 허용된 길이의 입력 메시지를 일정한 길이의 요약값으로 변환한다.
- 주된 목적과 정의는 공개키 암호의 공개키·개인키 쌍을 생성하는 것이다.
- SHA-256과 SHA-512가 대표적인 예다.
- 요약값으로부터 원문을 역산하기 어렵도록 설계한다.
정답과 해설 보기
정답: 2
정답은 ②이다. SHA-256 같은 고정 길이 암호학적 해시 함수는 허용된 길이의 메시지를 정해진 길이의 요약값으로 변환한다. 같은 입력은 같은 요약값을 만들며, 주어진 요약값에서 원문을 찾거나 서로 다른 입력의 충돌을 찾기 어렵도록 설계한다. 주된 역할은 데이터의 요약과 무결성 확인 등이며 공개키 암호의 키를 만드는 용도로만 정의되지 않는다. 일부 키 유도 과정에 해시가 사용될 수는 있지만 그것이 해시 전체의 주된 목적이라는 설명은 잘못이다.
선지별 해설
- 고정 길이 암호학적 해시 함수의 입력·출력 형태다.
- 일부 키 유도에 쓰일 수 있어도 주된 정의와 목적을 공개키 생성으로 제한할 수 없다.
- SHA-256·SHA-512는 표준화된 암호학적 해시 알고리즘이다.
- 요약값에서 원문을 역산하기 어렵도록 설계하는 성질이다.
편집 해설 근거: NIST FIPS 180-4, Secure Hash Standard (2015) — §3 Notation and Conventions; §6 Secure Hash Algorithms
94. IPSec(IP Security)에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 암호화 수행 시 일방향 해시 처리만 지원한다.
- ESP는 협상한 알고리즘과 설정에 따라 기밀성·무결성·데이터 출처 인증을 제공할 수 있다.
- 전송(Transport) 모드와 터널(Tunnel) 모드로 사용할 수 있다.
- AH는 기밀성 없이 인증과 무결성 보호를 제공하며 보호 대상에서 일부 변동 필드는 제외한다.
정답과 해설 보기
정답: 1
정답은 ①이다. IPsec은 IP 계층의 통신 보호를 위한 체계로 암호화·인증·무결성 등 보안 서비스를 구성한다. ESP의 암호화는 수신 측이 적절한 키로 복호화하여 데이터를 사용해야 하므로 일방향 해시만 지원한다는 설명은 틀렸다. ESP가 제공하는 구체적인 서비스는 협상한 알고리즘과 설정에 달려 있으며 AH는 기밀성을 제공하지 않고 인증·무결성을 다룬다. AH가 전송 중 변할 수 있는 모든 IP 헤더 비트까지 그대로 보호하는 것은 아니며, 전송 모드와 터널 모드를 구별한다.
선지별 해설
- ESP에는 복호화 가능한 기밀성 암호화가 사용되므로 일방향 처리만 있다는 주장은 틀렸다.
- 선택한 알고리즘과 구성에 따라 기밀성·무결성·데이터 출처 인증을 제공할 수 있다.
- 전송 모드와 터널 모드를 지원한다.
- AH는 기밀성 없이 데이터 출처 인증과 무결성 보호를 제공한다.
편집 해설 근거: IETF RFC 4301, Security Architecture for the Internet Protocol (2005) — §3.2 How IPsec Works; §3.3 Where IPsec May Be Implemented; RFC 4302, IP Authentication Header — §1 Introduction; §3.3.3.1 Handling Mutable Fields
95. 메모리상에서 프로그램의 복귀 주소와 변수 사이에 특정 값 을 저장해 두었다가 그 값이 변경되었을 경우 오버플로우 상태로 가정하여 프로그램 실행을 중단하는 기술은?
- Stack Guard
- Bridge
- ASLR
- FIN
정답과 해설 보기
정답: 1
정답은 ①이다. StackGuard는 함수의 스택 영역에 카나리 값을 두고 함수에서 복귀하기 전에 그 값이 예상과 같은지 확인하는 방식으로 설명된다. 연속적인 버퍼 덮어쓰기가 복귀 주소에 이르는 과정에서 카나리도 바뀌면 비정상 종료하여 변조된 주소로 제어가 넘어가는 일을 막는다. ASLR은 메모리 배치의 주소를 무작위화하는 다른 방어 기법이다. 카나리가 바뀌지 않는 형태의 메모리 손상도 있을 수 있으므로 스택 보호가 모든 버퍼 오류를 완전히 탐지한다고 보장해서는 안 된다.
선지별 해설
- 카나리 변조를 검사하여 위험한 복귀를 막는 스택 보호 방식이다.
- 일반적인 연결 또는 설계 패턴의 명칭으로 카나리 검사와 다르다.
- 메모리 배치 주소를 무작위화하는 기법이다.
- TCP 연결 종료에 쓰이는 플래그로 스택 보호와 다르다.
편집 해설 근거: Cowan et al., StackGuard (USENIX Security 1998) — Detecting Return Address Change Before Return — Detecting Return Address Change Before Return
96. 침입차단 시스템(방화벽) 중 다음과 같은 형태의 구축 유형 은?
- Block Host
- Tree Host
- Screened Subnet
- Ring Homed
정답과 해설 보기
정답: 3
정답은 ③이다. 그림은 외부망과 내부망 사이에 별도의 중간 네트워크를 두고 그곳에 외부 공개 서버를 배치한 구조다. 두 경계의 필터링을 통해 중간망과 내부망을 구분하는 스크린드 서브넷이며 중간 영역을 DMZ라고 부른다. 외부에 공개한 서버가 침해되더라도 내부망까지 곧바로 접근하지 못하도록 허용 경로를 제한하는 데 목적이 있다. 라우터와 방화벽 장치의 수만 보고 판단하기보다 별도 서브넷의 배치와 통과 정책을 함께 보아야 한다.
선지별 해설
- 그림의 분리된 중간 서브넷을 지칭하는 표준적인 유형명이 아니다.
- 이 방화벽 배치 유형의 명칭이 아니다.
- 외부망과 내부망 사이에 별도의 중간 서브넷을 둔 구조다.
- 그림의 DMZ 배치를 지칭하는 유형명이 아니다.
편집 해설 근거: NIST SP 800-41 Rev.1, Guidelines on Firewalls and Firewall Policy (2009) — §3 Firewalls and Network Architectures — DMZ; Figure 3-2
97. 다음 중 접근 주체의 식별·인증이나 접근 권한의 결정과 달리, 장애 상황에서 서비스 연속성을 유지하는 데 직접 초점을 둔 기능은?
[학습용 개정문항]
- 식별 및 인증
- 임의적 접근 통제
- 고가용성 지원
- 강제적 접근 통제
정답과 해설 보기
정답: 3
정답은 ③이다. 식별과 인증은 누가 접근하는지 확인하고, 임의적·강제적 접근 통제는 어떤 주체가 어떤 객체를 사용할 수 있는지 정하는 기능이다. 고가용성은 장애가 나도 서비스가 계속 제공되도록 중복 구성과 장애 전환 등을 지원하는 기능이다. 가용성 역시 보안의 중요한 목표이므로 고가용성이 보안과 전혀 무관하다고 설명해서는 안 된다. 개정 문항은 보안성의 포함 여부가 아니라 접근 주체·권한 통제와 장애 중 서비스 연속성이라는 직접적인 목적의 차이를 묻는다.
선지별 해설
- 주체의 식별과 그 신원의 확인에 초점을 둔다.
- 소유자 등의 재량에 따라 접근 권한을 정하는 통제다.
- 장애 상황에서도 서비스의 연속성을 유지하는 데 직접 초점을 둔다.
- 중앙의 보안 정책과 등급 등에 따라 접근 권한을 통제한다.
편집 해설 근거: Peter Reiher, OSTEP v1.10, 54 Authentication — Authentication; NIST CSRC Glossary, mandatory access control — Definition; NIST CSRC Glossary, Availability — Definition
98. 서버에 열린 포트 정보를 스캐닝해서 보안취약점을 찾는데 사용하는 도구는?
- type
- mkdir
- ftp
- nmap
정답과 해설 보기
정답: 4
정답은 ④이다. Nmap은 네트워크 탐색과 보안 점검을 위해 호스트와 포트의 상태, 서비스 정보 등을 조사할 수 있는 도구다. 열린 포트를 확인하면 불필요하게 노출된 서비스나 추가 점검 대상을 찾는 데 도움이 된다. 다만 포트가 열려 있다는 사실만으로 취약점의 존재나 악용 가능성이 확정되는 것은 아니며 서비스 설정과 버전 등을 추가로 확인해야 한다. type은 명령 해석 등을 확인하고 mkdir은 디렉터리를 만들며 ftp는 파일 전송에 쓰이므로 포트 탐색 도구와 역할이 다르다.
선지별 해설
- 일반적인 셸에서 명령의 해석 등을 확인하는 명령이다.
- 디렉터리를 생성하는 명령이다.
- 파일 전송 프로토콜이나 클라이언트를 가리킨다.
- 호스트·포트·서비스 상태 등을 조사하는 네트워크 탐색 도구다.
편집 해설 근거: Gordon Lyon, Nmap Network Scanning — Chapter 1 Introduction — Introduction
99. 서로 다른 네트워크 대역에 있는 호스트들 상호간에 통신할 수 있도록 해주는 네트워크 장비는?
- L2 스위치
- HIPO
- 라우터
- RAD.
정답과 해설 보기
정답: 3
정답은 ③이다. 라우터는 목적지의 네트워크 주소와 라우팅 정보를 이용하여 서로 다른 IP 네트워크 사이로 패킷을 전달한다. L2 스위치는 주로 같은 링크 또는 VLAN 안에서 MAC 주소에 따라 프레임을 전달한다. 실제 장비가 L3 기능을 겸하면 라우팅도 가능하지만 보기에서 명시한 L2 기능과는 구별한다. HIPO는 시스템을 계층과 입력·처리·출력으로 문서화하는 기법이고 RAD는 빠른 응용 개발 접근을 가리켜 네트워크 전달 장비의 이름이 아니다.
선지별 해설
- 주로 같은 링크나 VLAN에서 MAC 주소를 이용해 프레임을 전달한다.
- 계층 및 입력·처리·출력에 관한 문서화 기법이다.
- 서로 다른 IP 네트워크 사이의 경로를 선택하여 패킷을 전달한다.
- 응용 개발 접근의 명칭으로 네트워크 장비가 아니다.
편집 해설 근거: IETF RFC 791, Internet Protocol (1981) — §2.2 Model of Operation; §2.3 Function Description; ITU-T X.200 (07/1994), OSI Basic Reference Model — Network Layer
100. 암호화 키와 복호화 키가 동일한 암호화 알고리즘은?
- RSA
- AES
- DSA
- ECC
정답과 해설 보기
정답: 2
정답은 ②이다. AES는 동일한 비밀키를 공유하여 암호화와 복호화를 수행하는 대칭키 블록 암호다. 블록 길이는 128비트이며 지원하는 키 길이는 128·192·256비트다. RSA는 공개키와 개인키의 쌍을 사용하는 비대칭 방식이고 DSA는 전자서명을 위한 알고리즘이다. ECC는 타원곡선을 사용하는 공개키 암호 기술 계열을 가리키므로 하나의 대칭키 암호 이름이 아니다. 전자서명과 암호화를 같은 연산으로 취급하거나 AES의 키 길이와 블록 길이를 혼동하지 않도록 한다.
선지별 해설
- 공개키·개인키의 쌍을 사용하는 비대칭 방식이다.
- 같은 비밀키를 사용하는 대칭키 블록 암호다.
- 전자서명 알고리즘으로 동일 키의 대칭 암호가 아니다.
- 타원곡선 기반 공개키 암호 기술 계열이다.
편집 해설 근거: NIST FIPS 197-upd1 (2023), Advanced Encryption Standard — §1 Introduction; §3.1 Inputs and Outputs; IETF RFC 6090, Fundamental Elliptic Curve Cryptography Algorithms (2011) — §1 Introduction
정보처리기사 필기 기출문제 학습 방법
먼저 PDF 문제지를 시간에 맞춰 푼 뒤, 이 글에서 오답의 정답·해설·근거를 확인하세요. 법규 문항은 근거 기준일 이후 개정 여부도 함께 확인하는 것이 안전합니다.