
문제지 PDF · 웹 정답 해설
정보처리기사 필기 2020년 4회 공개기출 100문항
정보처리기사 필기 2020년 4회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.

© 자격증3001. 이 정보처리기사 필기 기출문제 게시물의 문제 재구성 문장, 해설, 재작성 도식, 편집 및 PDF 디자인은 자격증3001의 저작권 보호를 받습니다. 국가기술자격 시험 및 관련 명칭의 권리는 해당 기관에 있으며, 본 자료는 Q-Net 공식 문제지 또는 공식 해설이 아닙니다. 무단 복제·재배포를 금합니다.
정보처리기사 필기 2020년 4회 공개기출 100문항 안내
정보처리기사 필기 2020년 4회 100문항을 과목별로 풀고 문항별 정답, 상세해설, 확인 가능한 근거 URL을 확인하세요.
이 회차의 100문항 해설을 문항별 기술 원문과 필요한 독립 계산으로 편집 검토했습니다. 질문·조건·보기를 고친 문항은 학습용 개정문항으로 표시합니다. 원 시험의 공식 원문이나 공식 정답표를 새로 확인한 자료는 아닙니다.
정보처리기사 필기 기출문제 · 소프트웨어 설계
1. XP(eXtreme Programming)의 기본원리로 볼 수 없는 것은?
- Linear Sequential Method
- Pair Programming
- Collective Ownership
- Continuous Integration
정답과 해설 보기
정답: 1
정답은 ①이다. XP는 짧은 개발 주기와 반복적인 피드백을 활용하며 짝 프로그래밍, 공동 코드 소유, 지속적인 통합을 주요 실천으로 제시한다. 짝 프로그래밍은 두 사람이 함께 코드를 작성하고 검토하는 방식이고, 공동 소유는 팀이 공통 규칙과 시험을 바탕으로 코드를 함께 개선한다는 뜻이다. 지속적인 통합은 변경 사항을 자주 합치고 확인하는 실천이다. 선형 순차 방법은 이와 같은 XP 실천의 이름이 아니며, 개발 활동을 순차적으로 진행하는 생명주기 접근을 가리킨다.
선지별 해설
- 선형 순차 생명주기 접근으로 XP의 대표 실천에 해당하지 않는다.
- 두 개발자가 함께 작업하는 XP 실천이다.
- 팀이 코드에 공동 책임을 갖고 개선하는 실천이다.
- 변경을 자주 통합하고 확인하는 XP 실천이다.
편집 해설 근거: Ron Jeffries, What is Extreme Programming? (2011) — Core Practices — Pair Programming; Collective Code Ownership; Continuous Integration
2. 럼바우(Rumbaugh) 객체지향 분석 기법에서 동적 모델링에 활용되는 다이어그램은?
- 객체 다이어그램(Object Diagram)
- 패키지 다이어그램(Package Diagram)
- 상태 다이어그램(State Diagram)
- 자료 흐름도(Data Flow Diagram)
정답과 해설 보기
정답: 3
정답은 ③이다. Rumbaugh의 OMT는 시스템을 객체·동적·기능의 관점으로 나누어 분석한다. 동적 모델은 사건이 발생했을 때 객체의 상태가 어떻게 바뀌는지, 상태에 따라 어떤 동작이 가능한지를 표현하므로 상태 다이어그램이 대응한다. 객체 모델은 클래스·객체와 관계 같은 정적 구조를, 기능 모델은 자료의 변환과 처리를 다룬다. 따라서 자료 흐름도는 기능 모델의 단서이며, 객체 다이어그램이나 패키지 다이어그램과 상태 변화의 표현을 구별해야 한다.
선지별 해설
- 객체와 관계의 구조를 나타내는 관점이다.
- 모델 요소를 묶는 패키지와 의존 구조 등을 표현한다.
- 사건에 따른 상태 변화를 나타내므로 동적 모델에 대응한다.
- 자료의 처리와 변환을 나타내는 기능 모델의 표현이다.
편집 해설 근거: Dov Dori, On Bridging the Analysis–Design and Structure–Behavior Grand Canyons with Object Paradigms (1996), 저자 제공 원문 — printed p. 26 — object, dynamic and functional models; OMG UML 2.5.1 (2017) — §14 StateMachines
3. 구조적 분석·설계용 CASE 도구의 모델링 지원과 비교할 때, 컴파일러의 주된 작업을 직접 나타내는 것은?
[학습용 개정문항]
- S/W 라이프 사이클 전 단계의 연결
- 그래픽 지원
- 다양한 소프트웨어 개발 모형 지원
- 언어 번역
정답과 해설 보기
정답: 4
정답은 ④이다. 컴파일러의 중심 작업은 원시 프로그램을 다른 언어나 목적 코드로 번역하는 것이다. 구조적 분석·설계용 CASE 도구는 다이어그램 작성, 자료 사전 관리, 모델의 일관성 검사처럼 설계 작업을 지원한다. 생명주기 산출물을 연결하거나 여러 개발 방법을 지원하는 것도 CASE 환경에서 기대할 수 있다. 넓은 의미의 CASE 환경에는 코드 생성이나 컴파일러 연동이 포함될 수 있으므로 언어 번역 기능이 어떤 CASE 제품에도 절대 존재할 수 없다고 해석해서는 안 된다.
선지별 해설
- 생명주기 산출물의 연결과 추적을 지원하는 CASE 환경의 기능이다.
- 분석·설계 모델을 그림으로 작성하는 지원 기능이다.
- 제품에 따라 여러 개발 방법이나 모델링 기법을 지원할 수 있다.
- 원시 프로그램의 언어 번역은 컴파일러의 중심 역할을 직접 나타낸다.
편집 해설 근거: Connell·Wenneson, NASA CR-177625 Software Engineering Guidebook (1993) — §4.1.1.6 CASE Tools for Structured Analysis; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.485 CASE tool; §3.737 computer-aided software engineering; §3.681 compiler
4. 객체지향 기법의 캡슐화(Encapsulation)에 대한 설명으로 틀 린 것은?
[학습용 개정문항]
- 공개 인터페이스를 적절히 설계하면 사용 방법을 단순화할 수 있다.
- 안정된 인터페이스를 통해 소프트웨어 재사용에 도움이 될 수 있다.
- 내부 변경이 다른 부분에 미치는 영향을 줄일 수 있다.
- 상위 형식의 특성을 하위 형식이 물려받는 관계를 뜻한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 캡슐화는 관련 상태와 동작을 묶고 공개 인터페이스를 통해 다루도록 하는 설계 원칙이다. 구현의 세부 사항을 외부에서 직접 사용하지 않으면 내부 변경의 영향이 줄어들고 이해하기 쉬운 인터페이스나 재사용에 도움이 될 수 있다. 반면 상위 형식의 특성을 하위 형식으로 이어받는 관계는 상속의 설명이다. 캡슐화만 적용하면 인터페이스가 반드시 단순해지거나 재사용성이 자동으로 높아지는 것은 아니므로 효과는 적절한 설계와 사용 방식에 달려 있다.
선지별 해설
- 공개할 기능을 적절히 제한하면 인터페이스를 단순하게 만들 수 있다.
- 안정된 인터페이스로 사용하면 재사용에 도움이 될 수 있다.
- 외부의 내부 구현 의존을 제한하면 변경의 전파를 줄일 수 있다.
- 상위 형식과 하위 형식의 상속 관계를 설명하며 캡슐화의 정의가 아니다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Encapsulation; Separation of interface and implementation; OMG UML 2.5.1 (2017) — §9.2 Classifiers — Generalization
5. 이미지의 설명에 해당하는 객체지향 설계 원칙은?
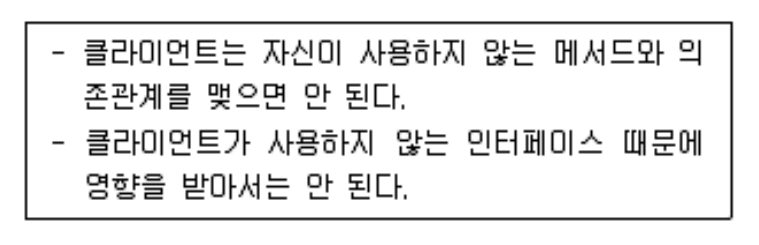
- 인터페이스 분리 원칙
- 단일 책임 원칙
- 개방 폐쇄의 원칙
- 리스코프 교체의 원칙
정답과 해설 보기
정답: 1
정답은 ①이다. 인터페이스 분리 원칙은 클라이언트가 자신에게 필요하지 않은 기능에 의존하도록 강요받지 않게 하라는 원칙이다. 여러 종류의 사용자를 위해 하나의 거대한 인터페이스를 만들면 사용하지 않는 기능의 변경에도 영향을 받을 수 있으므로, 역할에 맞는 작은 인터페이스로 나누는 방법을 고려한다. 단일 책임은 변경 이유, 개방 폐쇄는 확장과 수정, 리스코프 치환은 하위 형식의 대체 가능성에 초점을 둔다. 인터페이스 분리가 모든 메서드를 하나씩 별도 인터페이스로 만들라는 의미는 아니다.
선지별 해설
- 사용하지 않는 기능에 대한 클라이언트의 불필요한 의존을 줄이는 원칙이다.
- 서로 다른 변경 이유를 갖는 책임을 분리하는 원칙이다.
- 기존 코드를 덜 수정하면서 확장할 수 있는 구조를 지향한다.
- 기존 형식의 계약을 지키며 하위 형식으로 대체할 수 있어야 한다는 원칙이다.
편집 해설 근거: Robert C. Martin, Solid Relevance (2020-10-18) — ISP) The Interface Segregation Principle; SRP; OCP; LSP
6. 파이프 필터 형태의 소프트웨어 아키텍처에 대한 설명으로 옳은 것은?
[학습용 개정문항]
- 중앙 저장소를 공유하는 것만으로 구성되며 처리 결과를 다음 필터로 전달하지 않는다.
- 서브시스템이 입력 데이터를 받아 처리하고 결과를 다음 서브시스템으로 넘겨주는 과정을 반복한다.
- 추상 수준에 따라 나누는 계층 모델과 동일한 구조이다.
- 반드시 모델·뷰·제어의 세 서브시스템으로 구성된다.
정답과 해설 보기
정답: 2
정답은 ②이다. 파이프-필터 구조에서는 각 필터가 입력 데이터를 받아 일정한 처리를 수행하고, 파이프를 통해 출력이 다음 필터의 입력으로 전달된다. 필터의 입력·출력 계약을 맞추면 처리 단계를 조합하거나 교체할 수 있다. 여러 구성을 노드와 간선으로 그릴 수 있다는 사실만으로 이 구조를 구별할 수는 없다. 중앙 저장소를 공유하는 저장소 구조, 추상 수준으로 나누는 계층 구조, 모델·뷰·제어의 역할을 나누는 MVC와 핵심 관점이 다르다.
선지별 해설
- 중앙 저장소 공유를 중심으로 하는 구조를 설명하며 파이프-필터의 처리 전달과 다르다.
- 각 필터의 출력이 다음 필터의 입력으로 전달되는 핵심 방식이다.
- 계층 구조와 파이프-필터는 구별되는 설계 방식이다.
- 세 역할로 나누는 MVC의 설명이다.
편집 해설 근거: Microsoft Azure Architecture Center, Pipes and Filters pattern (2026-10-05 확인) — Solution; Issues and considerations
7. 코드화 대상 항목의 중량, 면적, 용량 등의 물리적 수치를 이 용하여 만든 코드는?
- 순차 코드
- 10진 코드
- 표의 숫자 코드
- 블록 코드
정답과 해설 보기
정답: 3
정답은 ③이다. 표의 숫자 코드는 대상의 중량·면적·용량처럼 의미가 있는 물리적 수치를 코드에 반영하는 방식이다. 예를 들어 제품의 실제 규격을 정해진 단위와 순서로 적은 코드라면 값 자체가 규격 정보를 전달한다. 순차 코드는 주로 일련번호를 부여하고, 블록 코드는 공통 특성에 따라 코드 구간을 나누며, 10진 코드는 십진 분류를 단계적으로 적용한다. 숫자로 구성되었다는 사실만으로 표의 숫자 코드가 되는 것은 아니며 숫자가 실제 속성값을 나타내는지 확인해야 한다.
선지별 해설
- 정해진 순서대로 일련번호를 부여하는 방식이다.
- 분류를 십진 체계로 단계적으로 나누는 방식이다.
- 대상의 물리적 속성값을 코드에 반영하는 방식이다.
- 공통 특성별로 코드 구간을 나누어 부여하는 방식이다.
편집 해설 근거: 교육부, NCS 학습모듈 애플리케이션 설계 LM2001020221_16v4 (2018), 목원대학교 제공본 — 1-3 공통 모듈 인덱스 및 기능 코드 설계, 인쇄 p. 29 — 코드의 유형 분류
8. GoF 디자인 패턴 사용의 장단점에 대한 설명으로 옳지 않은 것은?
[학습용 개정문항]
- 공통된 설계 어휘를 사용하여 소프트웨어 구조 파악에 도움을 줄 수 있다.
- 객체지향 설계와 구현의 반복되는 문제에 적용할 수 있다.
- 적절한 설계 지식 재사용으로 개발 시간을 줄일 수 있다.
- 절차형 언어와 함께 이용하면 적용 맥락과 관계없이 효율이 항상 극대화된다.
정답과 해설 보기
정답: 4
정답은 ④이다. 디자인 패턴은 반복해서 나타나는 설계 문제와 그 맥락에 맞는 해법을 정리한 지식이다. GoF 패턴의 공통 이름을 사용하면 객체의 역할과 협력 구조를 설명하기 쉽고, 적합한 해법을 재사용하면 설계·구현 부담을 줄일 수 있다. 그러나 패턴을 사용하기만 하면 생산성이 반드시 높아지는 것은 아니다. 문제에 맞지 않는 패턴을 억지로 넣으면 복잡성이 커질 수 있다. 특히 GoF 패턴은 객체지향 설계의 맥락을 다루므로 절차형 언어에서 항상 효율이 극대화된다는 일반 명제는 성립하지 않는다.
선지별 해설
- 공통된 설계 어휘를 사용하면 구조를 이해하는 데 도움이 될 수 있다.
- 반복되는 객체지향 설계 문제의 해법을 재사용하는 데 적합하다.
- 검증된 해법을 적절히 재사용하면 설계 시간을 줄일 수 있다.
- 특정 언어 부류에서 언제나 효율이 최대가 된다는 보장은 없다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — p. 15 Design Space for GoF Patterns; p. 18 Benefits & Limitations of Patterns
9. DFD(data flow diagram)에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 자료 흐름 그래프 또는 버블 차트라고도 한다.
- 구조적 분석 기법에 이용된다.
- 각 처리의 실행 시점과 시간적 순서를 일반 DFD만으로 명확하게 표현한다.
- 처리, 자료 흐름, 저장소, 외부 실체를 선택한 표기법의 기호로 표현한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 자료 흐름도는 외부 실체·처리·저장소 사이에서 어떤 자료가 이동하고 변환되는지를 나타낸다. 화살표는 자료의 이동을 뜻하며 프로그램 실행의 시간 순서를 직접 지정하는 제어 흐름 화살표와 다르다. 따라서 그림의 왼쪽에서 오른쪽으로 배치되어 있다는 이유만으로 각 처리가 언제 실행되는지 판단할 수 없다. 동작 시점이나 사건에 따른 상태 변화는 상태 모델 등으로 보완한다. 처리·저장소의 구체적인 그림 모양은 채택한 표기법에 따라 달라질 수 있다.
선지별 해설
- 자료 흐름 그래프 또는 버블 차트라는 이름으로도 설명하는 모델이다.
- 자료 변환을 중심으로 하는 구조적 분석에 사용된다.
- 일반적인 DFD는 처리의 시간적 순서나 실행 시점을 직접 명세하지 않는다.
- 표기법에 따라 처리·자료 흐름·저장소·외부 실체를 구별해 표시한다.
편집 해설 근거: Connell·Wenneson, NASA CR-177625 Software Engineering Guidebook (1993) — §4.1.1 Structured Requirements Analysis; §4.1.1.1 Dataflow Diagrams; Excel Software, Process Model — Data Flow Diagrams — Data Flow Diagrams
10. 그래픽 표기법을 이용하여 소프트웨어 구성 요소를 모델링 하는 럼바우 분석 기법에 포함되지 않는 것은?
- 객체 모델링
- 기능 모델링
- 동적 모델링
- 블랙박스 분석 모델링
정답과 해설 보기
정답: 4
정답은 ④이다. Rumbaugh의 OMT에서 대표적인 세 모델은 객체 모델, 동적 모델, 기능 모델이다. 객체 모델은 객체·클래스·관계의 구조, 동적 모델은 사건과 상태 변화, 기능 모델은 입력 자료가 처리되어 출력으로 바뀌는 흐름을 다룬다. 이들은 같은 시스템을 서로 다른 관점에서 설명하므로 함께 대조해야 한다. 블랙박스 분석 모델링은 이 세 모델의 정식 구분에 들어가지 않는다. 블랙박스라는 용어는 내부 구현을 보지 않고 외부 입출력이나 명세를 중심으로 판단하는 다른 맥락에서 사용된다.
선지별 해설
- 객체와 클래스 및 관계를 나타내는 OMT 모델이다.
- 자료 변환과 기능적 처리 흐름을 나타내는 OMT 모델이다.
- 사건과 상태 변화를 나타내는 OMT 모델이다.
- OMT의 세 가지 대표 모델 명칭에 포함되지 않는다.
편집 해설 근거: Dov Dori, On Bridging the Analysis–Design and Structure–Behavior Grand Canyons with Object Paradigms (1996), 저자 제공 원문 — printed p. 26 — object, dynamic and functional models
11. UML을 학습할 때 모델의 사물(요소), 관계, 다이어그램을 구분하여 설명한다. 이 세 가지 범주에 해당하지 않는 것은?
[학습용 개정문항]
- Things
- Terminal
- Relationship
- Diagram
정답과 해설 보기
정답: 2
정답은 ②이다. UML 모델을 배울 때 모델 요소인 사물, 요소 사이의 관계, 이를 나타내는 다이어그램을 구별할 수 있다. 예를 들어 클래스나 유스케이스 같은 요소를 만들고 연관·의존·일반화 같은 관계로 연결한 뒤 필요한 관점의 다이어그램에 표현한다. Terminal은 이 구분에서 나머지 세 항목과 나란히 놓는 기본 범주의 이름이 아니다. 이러한 학습용 분류와 UML 2.5.1 표준의 메타모델 장 구성을 동일시해서는 안 되며, 클래스나 관계의 구체적인 의미는 해당 표준 정의로 확인한다.
선지별 해설
- 클래스·유스케이스 등 모델에서 표현하는 요소를 가리키는 학습용 범주이다.
- 제시된 사물·관계·다이어그램의 기본 범주 구분에 속하지 않는다.
- 모델 요소 사이의 연결과 의존 등을 표현한다.
- 선택한 모델 요소와 관계를 특정 관점에서 시각화한다.
편집 해설 근거: OMG UML 2.5.1 (2017) — §7 Common Structure — Elements, Relationships; Annex A Diagrams
12. 소프트웨어의 상위설계에 속하지 않는 것은?
[학습용 개정문항]
- 시스템의 주요 구성요소와 협력 구조에 대한 아키텍처 설계
- 개별 모듈 내부의 세부 알고리즘과 처리 절차 설계
- 주요 구성요소 사이의 인터페이스 정의
- 사용자 인터페이스의 전체 상호작용 구조 설계
정답과 해설 보기
정답: 2
정답은 ②이다. 상위 설계에서는 시스템을 어떤 주요 구성요소로 나누고 이들이 어떤 인터페이스로 협력할지 같은 전체 구조를 정한다. 모듈 내부의 세부 알고리즘, 제어 흐름, 자료 표현을 구체화하는 일은 상세 설계에 해당한다. 모듈이라는 단어 자체가 상위 설계에서 금지되는 것은 아니다. 주요 모듈의 책임과 경계를 정하는 활동은 상위 설계에 포함될 수 있으므로 문항에서는 모듈 내부의 세부 알고리즘으로 범위를 분명히 했다. 사용자 인터페이스도 전체 상호작용 구조와 세부 구현을 나누어 볼 수 있다.
선지별 해설
- 주요 구성요소와 상호작용의 전체 구조를 정하는 상위 설계이다.
- 모듈 내부 처리의 구체적인 구현 설계로 상세 설계에 해당한다.
- 주요 구성요소 사이의 계약을 정하는 상위 설계 활동이다.
- 사용자와 시스템 사이의 전체 상호작용 구조를 정하는 설계이다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.211 architectural design; §3.1163 detailed design; §3.1164 detailed design description
13. 자료 사전에서 =는 정의, +는 구성요소의 결합, { }는 반복으로 쓰는 구조적 분석 표기법을 사용한다. 대안 가운데 하나를 선택하는 항목을 묶는 기호는?
[학습용 개정문항]
- [ ]
- { }
- +
- =
정답과 해설 보기
정답: 1
정답은 ①이다. 문항에서 사용하는 구조적 분석의 자료 사전 표기에서는 대괄호와 대안 구분 기호를 이용하여 여러 항목 가운데 하나를 선택하도록 나타낸다. 예를 들어 결제수단 = [카드 | 계좌이체]라면 두 대안 중 하나를 뜻한다. 중괄호는 반복, 더하기 기호는 구성요소의 결합, 등호는 왼쪽 항목의 정의를 나타낸다. 프로그래밍 언어의 배열 표기나 다른 명세 언어의 선택적 문법과 같은 의미라고 일반화해서는 안 되며 문서에서 정한 표기 규칙을 먼저 확인해야 한다.
선지별 해설
- 이 문항의 자료 사전 표기에서는 대안을 묶는 선택 기호이다.
- 같은 항목이나 묶음이 반복될 수 있음을 나타낸다.
- 자료 항목을 함께 구성하는 결합을 나타낸다.
- 왼쪽 항목을 오른쪽 내용으로 정의함을 나타낸다.
편집 해설 근거: Francis T. Marchese, Pace University SE616 Lecture 4 — Data Dictionary Contents — Data Dictionary Contents — Notation table: Selection [ | ], Repetition {}, Sequence +, Definition =
14. 코드 편집기나 IDE가 아닌 일반 업무 응용의 실행 화면을 설계한다. 공통적인 사용자 상호작용 지원 기능과 가장 거리가 먼 것은?
[학습용 개정문항]
- 사용자 입력의 검증
- 에러 처리와 에러 메시지 처리
- 도움과 프롬프트(prompt) 제공
- 소스 코드 분석 및 오류 복구
정답과 해설 보기
정답: 4
정답은 ④이다. 일반 업무 응용의 실행 화면에서는 잘못된 입력을 예방·검사하고 오류가 발생했을 때 원인과 해결 방법을 안내하며 필요한 도움을 제공해야 한다. 이러한 기능은 사용자가 업무를 완료할 수 있도록 돕는 상호작용 지원이다. 소스 코드의 구문이나 의미를 분석하고 프로그램을 수정하는 것은 개발 도구의 역할이다. 다만 IDE 자체도 사용자 인터페이스를 갖는 소프트웨어이므로 코드 분석은 어떤 UI에도 있을 수 없다고 말할 수는 없다. 문항은 코드 편집기가 아닌 일반 업무 응용의 실행 화면을 전제로 한다.
선지별 해설
- 입력값의 형식과 허용 범위를 확인하는 UI 지원이다.
- 오류를 이해하고 해결할 수 있도록 안내하는 UI 지원이다.
- 사용자가 필요한 작업을 이해하도록 돕는 지원이다.
- 일반 업무 실행 화면의 공통 UI 지원보다는 개발 도구의 코드 분석 작업이다.
편집 해설 근거: Microsoft, Windows 7 UX Guidelines: Error Messages — Guidelines — Error prevention; Providing useful and relevant error messages; Jakob Nielsen, 10 Usability Heuristics for User Interface Design — Error prevention; Help users recognize, diagnose, and recover from errors; Help and documentation
15. 요구 사항 명세기법에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 비정형 명세기법은 자연어를 기반으로 요구사항을 서술할 수 있다.
- Z는 자연어 중심의 비정형 명세기법이다.
- 정형 명세기법은 수학적인 원리와 표기법을 이용한다.
- 정형 표기는 허용 상태와 연산의 조건을 수학적으로 명시하는 데 사용할 수 있다.
정답과 해설 보기
정답: 2
정답은 ②이다. Z는 집합과 논리 등의 수학적 개념을 사용하는 정형 명세 언어로, 자연어 중심의 비정형 명세 기법으로 분류하지 않는다. 정형 명세에서는 허용 상태나 연산의 전후 조건을 명확히 표현하고 수학적으로 검토할 수 있다. 자연어 명세는 이해관계자가 읽고 논의하기 쉽지만 모호성과 해석 차이를 관리해야 한다. 정형 표기가 항상 더 짧거나 누구에게나 더 쉬운 것은 아니며 학습 비용과 적용 대상에 따라 장단점이 달라진다. 두 표현을 함께 사용하여 설명과 엄밀성을 보완할 수도 있다.
선지별 해설
- 자연어를 중심으로 요구사항을 서술하는 비정형 명세의 특징이다.
- Z는 정형 명세 언어이므로 비정형으로 분류한 설명이 틀렸다.
- 논리와 집합 같은 수학적 원리·표기법을 사용하는 정형 명세의 특징이다.
- 정형 표기는 허용 상태와 연산 조건을 수학적으로 표현하는 데 쓰일 수 있다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG19, Formal Specification Languages, 2001 보존 문서 — Scope; Z specification language; IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §4 Requirements Specification; Software Engineering Models and Methods §4.2 Formal Methods
16. 소프트웨어 개발 단계에서 요구 분석 과정에 대한 설명으로 거리가 먼 것은?
[학습용 개정문항]
- 분석 결과의 문서화는 향후 유지보수에 활용될 수 있다.
- 프로젝트 특성과 관계없이 요구 분석 단계에 개발 비용이 항상 가장 많이 소요된다.
- 구조적 분석에서는 자료 흐름도와 자료 사전 등을 활용할 수 있다.
- 처리 논리를 구체화하기 위해 소단위 명세서를 활용할 수 있다.
정답과 해설 보기
정답: 2
정답은 ②이다. 요구 분석에서는 이해관계자의 필요를 구체화하고 기능·자료·제약을 검토하여 이후 설계와 시험의 기준을 마련한다. 분석 결과를 문서로 남기면 변경 이유와 요구의 출처를 추적하는 데 도움이 된다. 구조적 분석에서는 자료 흐름도, 자료 사전, 소단위 처리 명세 등을 함께 사용하여 표현을 보완한다. 어느 단계에 비용이 가장 많이 드는지는 사업의 규모, 도메인, 품질 요구, 유지보수 기간 등에 따라 달라진다. 요구 분석이 모든 프로젝트에서 항상 최대 비용을 차지한다고 정할 수 없다.
선지별 해설
- 문서화한 요구와 분석 결과는 후속 유지보수의 이해와 추적에 도움이 된다.
- 프로젝트 조건에 따라 비용 분포가 달라지므로 항상 가장 큰 비용이라고 단정할 수 없다.
- 구조적 분석에서 자료 흐름도와 자료 사전을 함께 사용할 수 있다.
- 작은 단위 처리의 논리와 자료 변환을 소단위 명세로 구체화할 수 있다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Requirements §3 Requirements Analysis; §6 Requirements Management; Connell·Wenneson, NASA CR-177625 Software Engineering Guidebook (1993) — §4.1.1.1 Dataflow Diagrams; §4.1.1.4 Process Specifications; §4.1.1.5 Data Dictionary
17. 애자일 방법론에 해당하지 않는 것은?
- 기능중심 개발
- 스크럼
- 익스트림 프로그래밍
- 모듈중심 개발
정답과 해설 보기
정답: 4
정답은 ④이다. 기능 중심 개발인 FDD, 스크럼, XP는 짧은 주기의 결과와 피드백을 활용하는 애자일 계열 접근으로 다룬다. FDD는 고객 가치가 있는 기능을 중심으로 계획·설계·구현을 진행하고, 스크럼은 스프린트와 점검·적응을 위한 틀을 제공하며, XP는 시험·짝 프로그래밍·지속 통합 같은 개발 실천을 강조한다. 모듈 중심 개발이라는 일반 표현은 이들과 나란히 놓이는 고유한 애자일 방법론 명칭이 아니다. 모듈화를 애자일 개발에서 사용할 수 없다는 뜻은 아니다.
선지별 해설
- FDD는 기능 단위의 짧은 반복과 점진적 결과를 중심으로 하는 접근이다.
- 스프린트와 경험적 점검·적응을 사용하는 프레임워크이다.
- 피드백과 여러 공학 실천을 결합한 애자일 개발 방식이다.
- 모듈화라는 일반 설계 전략을 가리킬 수 있으나 제시된 고유 방법론의 이름과 다르다.
편집 해설 근거: Palmer·Felsing, A Practical Guide to Feature-Driven Development (2002), 출판사 소개와 목차 — Description; Chapters 7–11, Five Processes; Schwaber·Sutherland, The Scrum Guide (2020) — Scrum Definition; Scrum Theory; The Sprint; Ron Jeffries, What is Extreme Programming? (2011) — Basic Extreme Programming; Core Practices
18. 분산된 응용 프로그램 사이에서 메시지 전달·원격 호출 등의 공통 통신 중개 서비스를 제공하는 소프트웨어 계층은?
[학습용 개정문항]
- 웨어러블
- 하이웨어
- 미들웨어
- 응용 소프트웨어
정답과 해설 보기
정답: 3
정답은 ③이다. 미들웨어는 분산된 응용 프로그램이나 운영 환경 사이에서 통신, 메시지 전달, 원격 호출 등의 공통 서비스를 제공하는 소프트웨어 계층이다. 서로 다른 응용이 직접 모든 환경 차이를 처리하는 부담을 줄이는 데 활용할 수 있다. 다만 네트워크 통신을 담당하는 소프트웨어가 모두 미들웨어인 것은 아니며 운영체제의 프로토콜 구현이나 응용 자체의 통신 코드도 존재한다. 웨어러블은 몸에 착용하는 기기 범주이고, 응용 소프트웨어는 사용자 업무를 수행하는 더 넓은 범주이다.
선지별 해설
- 몸에 착용하는 기기나 관련 기술을 뜻하며 중개 소프트웨어 계층의 이름이 아니다.
- 제시한 공통 통신 중개 계층의 통상적인 기술 용어가 아니다.
- 분산 응용 사이에서 공통 서비스와 중개 기능을 제공하는 계층이다.
- 사용자의 업무 기능을 수행하는 프로그램 범주로 해당 중개 계층의 직접 명칭은 아니다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.2459 middleware; RFC 5531, Remote Procedure Call Protocol Version 2 — §4 The RPC Model
19. GoF(Gangs of Four) 디자인 패턴 분류에 해당하지 않는 것은?
- 생성 패턴
- 구조 패턴
- 행위 패턴
- 추상 패턴
정답과 해설 보기
정답: 4
정답은 ④이다. GoF 디자인 패턴은 주로 해결하려는 목적에 따라 생성·구조·행동의 세 부류로 구분한다. 생성 패턴은 객체를 만드는 방법, 구조 패턴은 클래스나 객체의 결합, 행동 패턴은 책임 배분과 상호작용에 초점을 둔다. 추상화는 여러 패턴에 활용되는 설계 개념이지만 이 세 부류와 나란히 있는 GoF 분류명이 아니다. 예를 들어 Abstract Factory라는 패턴 이름에 추상이라는 말이 있어도 그 분류는 객체 생성 책임을 다루는 생성 패턴이다.
선지별 해설
- 객체 생성의 절차와 책임을 다루는 분류이다.
- 객체와 클래스의 구성 구조를 다루는 분류이다.
- 책임과 상호작용 및 제어 흐름을 다루는 분류이다.
- GoF의 세 가지 목적별 분류에 없는 이름이다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — p. 15 Design Space for GoF Patterns
20. 바람직한 소프트웨어 설계 지침이 아닌 것은?
[학습용 개정문항]
- 책임과 관리 가능성을 고려하여 적당한 모듈 크기를 유지한다.
- 모듈 간 연결 관계를 분석하여 불필요한 복잡성과 중복을 줄인다.
- 모듈 간 결합도는 가능한 한 강하게 만드는 것이 바람직하다.
- 모듈 사이에 필요한 호출과 협력 관계를 명확하게 표현한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 바람직한 모듈 설계는 관련된 책임을 모듈 안에 모으고 다른 모듈과의 불필요한 의존을 줄이는 방향을 지향한다. 모듈 간 결합이 강하면 한 부분의 변경을 다른 부분이 함께 따라 바꿔야 하는 일이 늘어나 시험과 재사용이 어려워질 수 있다. 그렇다고 모듈 간 통신을 모두 없애는 것이 목표는 아니며 필요한 인터페이스와 계약을 명확히 해야 한다. 모듈 크기도 일률적인 최솟값보다 책임의 응집도와 이해·관리 가능성을 함께 고려하여 정한다.
선지별 해설
- 너무 크거나 불필요하게 잘게 나누지 않고 책임과 관리 가능성을 고려한다.
- 의존 관계를 분석하여 중복과 복잡성을 줄이는 데 도움을 줄 수 있다.
- 불필요하게 강한 결합은 변경 영향과 시험 부담을 키울 수 있다.
- 필요한 호출·협력 관계를 명확히 하면 제어와 변경 영향을 이해하기 쉽다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles — Modularity; Coupling and cohesion
정보처리기사 필기 기출문제 · 소프트웨어 개발
21. 소프트웨어 패키징 도구 활용 시 고려 사항으로 틀린 것은?
[학습용 개정문항]
- 배포 대상 콘텐츠와 라이선스의 보호 요구에 맞게 보안을 검토한다.
- 보안을 위해 이기종 환경과의 연동 가능성은 검토하지 않아도 된다.
- 사용자 편의성, 설치 복잡성, 불필요한 처리 부담을 고려한다.
- 암호화가 필요한 콘텐츠에는 해당 배포 방식에 적합한 암호화와 키 관리 기법을 적용한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 배포할 소프트웨어와 콘텐츠를 포장할 때는 대상 플랫폼, 사용자의 설치 환경, 연동 규약, 라이선스와 보호 요구를 함께 검토한다. 보안이 필요하다는 이유만으로 다른 운영체제나 플랫폼과의 연동 가능성을 검토하지 않아도 되는 것은 아니다. 지원 범위를 정하고 그 범위에서 안전하고 올바르게 설치·이용되는지 확인해야 한다. 암호화도 모든 배포물에 똑같이 강제하는 것이 아니라 보호할 자료와 위협, 배포 방식에 맞추어 적용 여부와 방법을 결정한다.
선지별 해설
- 배포 대상과 권리 보호 요구에 맞는 보안 검토가 필요하다.
- 보안과 이기종 연동 검토는 함께 다룰 수 있으므로 생략의 근거가 아니다.
- 설치·이용의 편의성과 불필요한 복잡성을 검토해야 한다.
- 보호가 필요한 콘텐츠에는 적절한 암호화와 키 관리 방식이 필요하다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Operations §1.3 Software Installation; Microsoft PlayReady, Content Encryption (2026-10-05 확인) — Content Encryption
22. EAI에서 허브-스포크 방식과 메시지 버스 방식을 조합한 구조를 혼합형(Hybrid)이라고 할 때, 이 구조에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- 허브-스포크 방식과 메시지 버스 방식을 조합한다.
- 연계 영역별로 요구에 적합한 연결 방식을 선택할 수 있다.
- 중개 지점의 부하를 나누어 병목을 줄이는 설계를 고려할 수 있다.
- 중개 계층 없이 모든 응용을 일대일 직접 연결하는 방식만 사용한다.
정답과 해설 보기
정답: 4
정답은 ④이다. 문항의 혼합형은 허브를 중심으로 메시지를 중개하는 방식과 메시지 버스를 이용하는 방식을 조합한 구조다. 영역이나 업무 특성에 맞는 연결 방식을 선택하고 부하를 적절히 나누는 설계를 할 수 있다. 그러나 혼합형이라는 이름만으로 병목이 완전히 사라지는 것은 아니며 실제 메시지 경로와 처리 용량을 확인해야 한다. 모든 응용을 중개 계층 없이 직접 일대일로만 연결한다는 설명은 문항에서 정의한 허브·메시지 버스 조합과 맞지 않는다.
선지별 해설
- 문항에서 정의한 혼합형의 구성 방식이다.
- 서로 다른 영역에 적합한 연결 방식을 배치할 수 있다.
- 부하 분산을 고려할 수 있으나 성능은 구체적인 설계에 따라 달라진다.
- 중개 계층을 모두 배제한 일대일 연결만의 구조는 제시한 조합과 다르다.
편집 해설 근거: IBM, What Is Enterprise Application Integration? (2026-10-05 확인) — Hub and spoke integration — ESB 설명 문단
23. 소스코드 품질분석 도구 중 정적분석 도구가 아닌 것은?
[학습용 개정문항]
- PMD
- Checkstyle
- Valgrind Memcheck
- Cppcheck
정답과 해설 보기
정답: 3
정답은 ③이다. Valgrind의 Memcheck는 프로그램을 실행하면서 메모리 접근과 할당·해제 상태를 추적하여 잘못된 접근이나 누수 같은 문제를 찾는 동적 분석 도구다. PMD는 소스 코드 규칙 분석, Checkstyle은 Java 소스의 코딩 규칙 검사, Cppcheck는 C/C++ 정적 분석을 주로 수행한다. 정적 분석은 시험 대상 프로그램을 실제 입력으로 실행하지 않고 코드나 표현을 조사한다는 점에서 차이가 있다. 원문의 valance라는 불명확한 명칭은 검증 가능한 Valgrind Memcheck로 바꾸었다.
선지별 해설
- 소스 코드에서 규칙 위반이나 결함 패턴을 찾는 정적 분석 도구이다.
- Java 소스의 스타일과 코딩 규칙 등을 검사하는 정적 분석 도구이다.
- 실행 중 메모리 동작을 추적하는 동적 분석 도구이다.
- C/C++ 코드에 대한 정적 분석 도구이다.
편집 해설 근거: Valgrind 공식 문서, Tool Suite: Memcheck — Tool Suite — Memcheck; PMD 공식 프로젝트, About PMD — About PMD; Checkstyle 공식 프로젝트, About 및 Limitations (2026-10-05 확인) — Overview; Limitations; Cppcheck 공식 저장소, 프로젝트 소개 — About Cppcheck
24. 이미지의 후위식을 계산한 결과는?
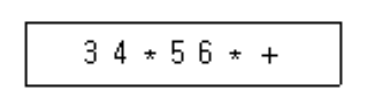
- 35
- 42
- 77
- 360
정답과 해설 보기
정답: 2
정답은 ②이다. 후위 표기에서는 피연산자를 순서대로 스택에 넣고 연산자를 만나면 필요한 두 값을 꺼내 계산한다. 그림의 3 4 *에서 3×4=12가 되고, 이어지는 5 6 *에서 5×6=30이 된다. 마지막 +는 이 두 부분식의 결과를 더하므로 12+30=42이다. 중위식으로 쓰면 (3×4)+(5×6)이다. 숫자와 연산자를 단순히 왼쪽부터 번갈아 처리하거나 마지막 +를 곱셈으로 바꾸면 다른 결과가 나온다. 계산 뒤 스택에 값이 하나만 남는지도 확인한다.
선지별 해설
- 두 곱셈 결과 12와 30을 합한 값과 다르다.
- (3×4)+(5×6)=12+30=42로 계산된다.
- 주어진 후위식의 연산 순서로는 나오지 않는 값이다.
- 12와 30을 곱하면 360이지만 마지막 연산자는 +이다.
편집 해설 근거: GNU dc manual — reverse Polish notation — Introduction; Stack; Arithmetic
25. 다음 중 통신·메시지 보호를 위해 제시된 보안 프로토콜과 달리, 기본 목적이 전자우편 전송인 프로토콜은? SSL과 S-HTTP는 역사적인 기술 분류로 비교한다.
[학습용 개정문항]
- IPSec
- SSL
- SMTP
- S-HTTP
정답과 해설 보기
정답: 3
정답은 ③이다. SMTP의 기본 목적은 전자우편 메시지의 전달이다. IPsec은 IP 계층에서 보안 서비스를 제공하고, 역사적인 SSL과 S-HTTP도 통신 또는 메시지 보호를 목적으로 제안된 프로토콜이다. SMTP가 TLS 같은 보호 기능과 함께 사용될 수 있다는 사실과 SMTP의 기본 역할은 구별해야 한다. 또한 이 보기의 역사적 분류가 현재 SSL 사용을 권장한다는 뜻은 아니다. SSL 3.0은 RFC 7568에서 사용을 금지했으며, S-HTTP는 오늘날 일반적으로 말하는 HTTPS와 별개의 실험적 프로토콜이었다.
선지별 해설
- IP 통신에 인증·무결성·기밀성 등의 보안 서비스를 제공하는 구조이다.
- 통신 보호를 위해 사용되던 프로토콜 계열이며 SSL 3.0은 현재 사용 금지 대상이다.
- 기본적으로 전자우편 전달을 담당하는 프로토콜이다.
- HTTP 메시지 자체에 보호 서비스를 적용하려던 별개의 실험적 프로토콜이다.
편집 해설 근거: IETF RFC 5321, Simple Mail Transfer Protocol (2008) — §1 Introduction; §2 The SMTP Model; IETF RFC 4301, Security Architecture for the Internet Protocol (2005) — §2.1 Goals/Objectives/Requirements/Problem Description; IETF RFC 2660, The Secure HyperText Transfer Protocol (1999), Experimental — Abstract; Status of this Memo; IETF RFC 7568, Deprecating Secure Sockets Layer Version 3.0 (2015) — §3 Do Not Use SSL Version 3.0
26. 검증(Validation) 검사 기법 중 개발자의 장소에서 사용자가 개발자 앞에서 행해지며, 오류와 사용상의 문제점을 사용자 와 개발자가 함께 확인하면서 검사하는 기법은?
- 디버깅 검사
- 형상 검사
- 자료구조 검사
- 알파 검사
정답과 해설 보기
정답: 4
정답은 ④이다. 알파 시험은 보통 개발 조직의 환경에서 잠재 사용자나 고객 등이 소프트웨어를 사용해 보고 개발 측과 함께 문제를 확인하는 인수 시험의 한 형태다. 실제 이용자의 작업과 관찰을 통해 기능뿐 아니라 사용상의 어려움도 발견할 수 있다. 개발 조직 밖의 실제 이용 환경에서 수행하는 베타 시험과 장소·참여 방식이 구별되는 단서다. 디버깅은 발견한 결함의 원인을 찾아 고치는 활동이므로 사용자와 함께 수행하는 이 인수 시험의 명칭과 같지 않다.
선지별 해설
- 결함의 원인을 분석하고 수정하는 활동이며 해당 인수 시험의 명칭이 아니다.
- 형상 항목의 상태나 구성을 확인하는 검사와 구별된다.
- 자료 구조의 구현이나 상태를 확인하는 시험 관점이다.
- 개발 조직의 환경에서 사용자와 함께 확인하는 알파 시험이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §2.2.1 Test Levels — Acceptance Testing, Alpha and Beta Testing
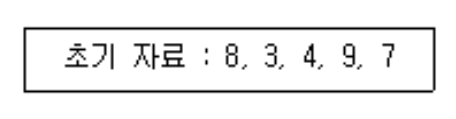
27. 이미지의 배열 [8, 3, 4, 9, 7]을 오름차순 삽입 정렬한다. 첫 원소만 정렬된 구간으로 보고 두 번째 원소를 삽입하는 1회전을 마친 결과는?
[학습용 개정문항]
- 3, 4, 8, 7, 9
- 3, 4, 9, 7, 8
- 7, 8, 3, 4, 9
- 3, 8, 4, 9, 7
정답과 해설 보기
정답: 4
정답은 ④이다. 삽입 정렬은 앞부분을 정렬된 구간으로 유지하면서 다음 원소를 그 구간의 알맞은 위치에 끼워 넣는다. 처음 원소 8 하나가 정렬된 구간이고, 1회전에서는 다음 원소 3을 처리한다. 3은 8보다 작으므로 8을 한 칸 오른쪽으로 옮기고 맨 앞에 3을 넣는다. 뒤의 4, 9, 7은 아직 처리하지 않아 결과는 3, 8, 4, 9, 7이다. 이 단계를 전체 배열에서 최솟값을 찾는 선택 정렬이나 끝까지 완성된 정렬 결과와 혼동하지 않아야 한다.
선지별 해설
- 첫 삽입에서 아직 처리하지 않은 4의 위치와 뒤의 9·7 순서까지 바뀌어 있다.
- 처리하지 않은 뒤쪽 원소의 순서까지 바뀌어 있다.
- 3을 앞의 정렬 구간에 삽입한 결과와 다르다.
- 3을 8 앞에 삽입하고 나머지는 그대로 둔 첫 회전 결과이다.
편집 해설 근거: NIST DADS, insertion sort — Definition
28. 소프트웨어 설치 매뉴얼에 대한 설명으로 틀린 것은?
- 설치과정에서 표시될 수 있는 예외상황에 관련 내용을 별도로 구분하여 설명한다.
- 설치 시작부터 완료할 때까지의 전 과정을 빠짐없이 순 서대로 설명한다.
- 설치 매뉴얼은 개발자 기준으로 작성한다.
- 설치 매뉴얼에는 목차, 개요, 기본사항 등이 기본적으로 포함되어야 한다.
정답과 해설 보기
정답: 3
정답은 ③이다. 설치 매뉴얼은 실제로 설치를 수행할 대상 독자가 필요한 준비와 절차를 이해하도록 작성해야 한다. 사용자가 일반 이용자인지 운영 관리자인지에 따라 필요한 기술 수준과 설명 방식이 달라질 수 있다. 개발자가 내부 구현을 알고 있다는 전제로만 쓰면 환경 준비, 권한, 순서, 실패 시 조치 같은 정보가 빠질 수 있다. 전체 설치 흐름과 예외 상황을 명확하게 안내하고, 매뉴얼의 구성도 제품과 독자의 요구에 맞게 정리해야 한다.
선지별 해설
- 예외 상황의 원인과 조치를 구분해 설명하면 설치 실패에 대응하는 데 도움이 된다.
- 독자가 필요한 단계를 빠뜨리지 않도록 순서대로 안내해야 한다.
- 실제 설치 담당자가 아니라 개발자의 내부 지식만을 기준으로 작성하면 안 된다.
- 설치 목적과 준비사항 및 절차를 찾기 쉽게 구성하는 것이 바람직하다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.2006 installation manual
29. 다음 중 자동화된 시험을 작성·실행하도록 지원하는 도구나 프레임워크와 달리, 기업 응용·서비스의 메시지 중개와 통합을 주목적으로 하는 것은?
[학습용 개정문항]
- ESB
- xUnit.net
- STAF
- JUnit
정답과 해설 보기
정답: 1
정답은 ①이다. ESB는 기업의 여러 응용이나 서비스 사이에서 메시지를 전달·변환·중개하는 통합 아키텍처 또는 이를 구현하는 미들웨어를 가리킨다. xUnit.net과 JUnit은 자동화된 시험 작성·실행을 위한 프레임워크이고, STAF는 여러 시스템에서 시험 자동화에 필요한 재사용 서비스를 제공한다. ESB 자체를 시험할 수 있다는 사실과 ESB가 시험 프레임워크라는 주장은 다르다. 특정 도구의 이름을 외우기보다 자동 시험 실행과 업무 응용 통합 중 어떤 목적을 갖는지 구별해야 한다.
선지별 해설
- 기업 응용·서비스 통합을 위한 미들웨어 구조이며 자동화 시험 프레임워크의 직접 명칭이 아니다.
- 자동화된 시험을 작성하고 실행하는 프레임워크이다.
- 여러 시스템의 시험 자동화를 지원하는 서비스·프레임워크이다.
- Java 등의 자동화된 시험을 작성하고 실행하는 생태계의 프레임워크이다.
편집 해설 근거: IBM, What Is Enterprise Application Integration? (2026-10-05 확인) — Hub and spoke integration — ESB 설명 문단; xUnit.net, About xUnit.net (2026-10-05 확인) — About xUnit.net; STAF V3 User Guide, Version 3.4.26 (2016) — Introduction; JUnit 공식 프로젝트, About — Overview
30. 소프트웨어 형상관리의 직접적인 활동에 해당하지 않는 것은?
[학습용 개정문항]
- 프로젝트 요구사항 문서의 기준선과 변경 이력 관리
- 소스 코드의 버전 식별 및 변경 관리
- 운영·설치 지침서의 버전과 승인된 변경 관리
- 프로젝트 비용 전표를 회계 계정별로 결산하는 업무
정답과 해설 보기
정답: 4
정답은 ④이다. 소프트웨어 형상관리는 관리 대상 항목을 식별하고 기준선을 설정하며 변경을 통제하고 상태와 이력을 추적하는 활동이다. 소스 코드뿐 아니라 요구사항 문서, 시험 자료, 운영·설치 문서도 대상이 될 수 있다. 회계 비용 전표를 결산하는 것은 프로젝트 회계 업무로서 형상관리의 직접적인 활동과 다르다. 다만 비용 추정서 같은 문서도 조직이 형상 항목으로 지정해 버전을 관리할 수 있으므로 비용 관련 정보는 절대로 관리할 수 없다는 뜻으로 확대하면 안 된다.
선지별 해설
- 요구사항 문서의 기준선과 변경 이력을 관리하는 형상관리 활동이다.
- 소스 코드의 버전과 변경을 추적하는 형상관리 활동이다.
- 운영·설치 문서의 버전과 승인된 변경도 관리할 수 있다.
- 회계 전표 결산은 재무·회계 업무이며 소프트웨어 형상관리의 직접 활동이 아니다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Configuration Management §2 Software Configuration Identification; §3 Software Configuration Change Control; §4 Software Configuration Status Accounting
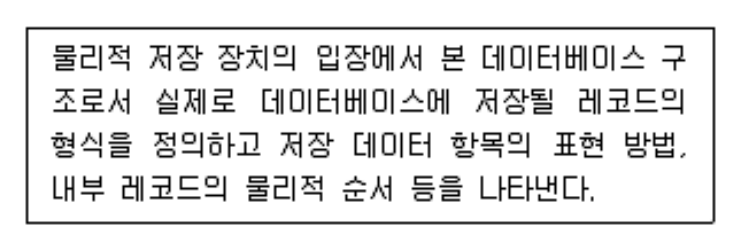
31. 이미지의 설명에 해당하는 데이터베이스 스키마는?
- 외부 스키마
- 내부 스키마
- 개념 스키마
- 슈퍼 스키마
정답과 해설 보기
정답: 2
정답은 ②이다. 내부 스키마는 데이터가 저장 장치에 어떤 형식과 배치로 표현되는지 기술하는 물리적 수준의 스키마다. 레코드의 저장 형식이나 접근 경로 등은 이 수준에서 다루는 내용이다. 반면 개념 스키마는 데이터베이스 전체의 논리적 구조와 제약을 나타내고, 외부 스키마는 특정 사용자나 응용에 필요한 관점을 나타낸다. 이미지가 논리적 의미나 사용자별 화면이 아니라 저장 방식에 초점을 맞추므로 내부 스키마에 해당한다.
선지별 해설
- 특정 사용자나 응용이 보는 데이터 관점을 나타낸다.
- 저장 형식과 물리적 배치를 기술하는 수준이다.
- 전체 데이터베이스의 논리적 구조를 나타낸다.
- 통상적인 외부·개념·내부의 3단계 스키마 분류에 없는 보기이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Introduction — Levels of Abstraction
32. 이미지의 트리를 중위 순회한 결과는?
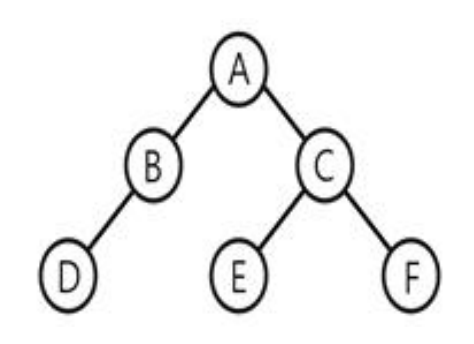
- D B A E C F
- A B D C E F
- D B E C F A
- A B C D E F
정답과 해설 보기
정답: 1
정답은 ①이다. 이진 트리의 중위 순회는 각 노드에서 왼쪽 부분 트리, 현재 노드, 오른쪽 부분 트리의 순서로 방문한다. 루트 A의 왼쪽 부분 트리에서는 D를 먼저 방문하고 B를 방문한다. 그다음 루트 A를 방문한다. 오른쪽 부분 트리의 루트 C에서는 왼쪽 자식 E, C 자신, 오른쪽 자식 F를 차례로 방문한다. 따라서 전체 방문 순서는 D B A E C F이다. 루트를 먼저 방문하는 전위 순회나 마지막에 방문하는 후위 순회와 구별해야 한다.
선지별 해설
- 왼쪽 부분 트리 D B, 루트 A, 오른쪽 부분 트리 E C F의 순서이다.
- 루트를 먼저 방문하는 전위 순회 결과이다.
- 부분 트리를 처리한 뒤 루트를 방문하는 후위 순회 결과이다.
- 위에서 아래로 같은 깊이의 노드를 방문하는 레벨 순서이다.
편집 해설 근거: NIST DADS, inorder traversal — Definition
33. 정점이 n개인 단순 무방향 그래프에서 자기 루프와 평행 간선을 허용하지 않을 때 최대 간선 수는?
[학습용 개정문항]
- n−1
- n−2
- n(n−1)/2
- n(n−1)
정답과 해설 보기
정답: 3
정답은 ③이다. 자기 루프와 중복 간선을 허용하지 않는 단순 무방향 그래프에서는 서로 다른 두 정점의 쌍마다 간선을 하나씩만 둘 수 있다. 모든 쌍이 연결되면 완전 그래프가 되므로 최대 간선 수는 n개 중 두 정점을 고르는 조합 수이다. 각 정점에서 나머지 n−1개 정점을 세면 n(n−1)이지만, 무방향 간선의 양 끝에서 같은 간선을 두 번 세므로 2로 나눈다. 결과는 n(n−1)/2이며 n−1은 트리의 간선 수와 관련된 값이다.
선지별 해설
- 연결된 트리의 간선 수이며 일반 단순 그래프의 최댓값은 아니다.
- 모든 정점 쌍을 세는 공식이 아니다.
- 서로 다른 두 정점의 무순서 쌍의 수이다.
- 같은 무방향 간선을 양방향에서 두 번 센 값이다.
편집 해설 근거: NIST DADS, complete graph — Definition
34. 소프트웨어 시험의 실제 결과가 기대 결과에 부합하는지 판단하는 데 사용하는 정보원이나 판정 수단을 무엇이라고 하는가?
[학습용 개정문항]
- 테스트 케이스
- 테스트 시나리오
- 테스트 오라클
- 테스트 데이터
정답과 해설 보기
정답: 3
정답은 ③이다. 테스트 오라클은 시험 결과가 기대한 결과에 부합하는지 판단할 때 사용하는 정보원이나 판정 수단이다. 명세, 계산된 기대값, 기존 시스템의 결과 또는 전문가 지식 등이 오라클 역할을 할 수 있다. 테스트 케이스는 입력과 실행 조건 및 기대 결과 등을 정리한 개별 시험이고, 테스트 데이터는 그 시험에 사용하는 값이다. 모든 시험에서 완벽한 정답을 미리 알 수 있는 것은 아니므로 오라클을 항상 확정된 참값을 제공하는 장치로 한정해서는 안 된다.
선지별 해설
- 개별 시험의 입력·사전 조건·기대 결과 등을 기술한 것이다.
- 업무 흐름이나 시험 상황을 묶어 설명하는 것이다.
- 실제 시험 결과의 적합성을 판단하는 정보원이나 수단이다.
- 시험 실행에 사용하는 입력값 등의 자료이다.
편집 해설 근거: ISTQB, Standard Glossary Version 3.01, Foundation Level terms, 회원위원회 제공본 — test oracle
35. 빌드 자동화 도구에 대한 설명으로 틀린 것은?
[학습용 개정문항]
- Gradle에서는 빌드 작업을 task로 정의하고 작업 간 의존관계를 구성할 수 있다.
- 빌드 자동화 도구는 지속적 통합 환경에서 활용할 수 있다.
- Ant, Gradle, Jenkins 등을 활용해 빌드 절차를 자동화할 수 있다.
- Jenkins는 Android 앱 프로젝트에만 사용할 수 있는 자동화 서버이다.
정답과 해설 보기
정답: 4
정답은 ④이다. Jenkins는 여러 종류의 프로젝트에서 빌드·시험·배포 등의 절차를 자동화하는 서버로, Android 앱에만 사용할 수 있는 도구가 아니다. Gradle은 빌드를 프로젝트와 작업(task) 단위로 구성하고 작업 사이의 의존관계에 따라 실행한다. 지속적 통합에서는 변경을 자주 합치고 자동 빌드와 시험으로 문제를 확인하므로 이러한 자동화 도구가 유용하다. Jenkins 파이프라인에서 Groovy 기반 문법을 쓸 수 있다는 점과 사용 대상이 Android로 제한된다는 주장은 구별해야 한다.
선지별 해설
- Gradle의 작업은 컴파일 등 빌드에서 수행할 단위를 표현한다.
- 자동 빌드와 시험은 지속적 통합의 반복 실행을 지원한다.
- 빌드 도구와 자동화 서버를 함께 활용해 빌드 절차를 자동화할 수 있다.
- Jenkins는 Android 전용 서버가 아니며 다양한 프로젝트를 자동화한다.
편집 해설 근거: Gradle User Manual, Core Concepts — Core concepts — Task, Build Script; Jenkins 공식 소개 — Build great things at any scale; Continuous Integration and Continuous Delivery
36. 콘텐츠 공급자, 패키저, 배포자, 라이선스 서비스, 이용 권한 집행기를 구별하는 DRM 역할 모델에서 역할 설명이 잘못 연결된 것은?
[학습용 개정문항]
- 콘텐츠 공급자: 제공 권한을 가진 콘텐츠를 공급한다.
- 콘텐츠 배포자: 콘텐츠를 암호화하고 메타데이터와 묶어 보호 형식으로 포장하는 역할 자체를 뜻한다.
- 클리어링 하우스 또는 라이선스 서비스: 키와 라이선스를 관리·발급한다.
- DRM 컨트롤러: 이용 환경에서 콘텐츠 사용 권한을 집행한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 이 문항은 콘텐츠 공급, 보호 형식으로 포장, 배포, 라이선스 발급, 이용 권한 집행을 구별한 DRM 역할 모델을 전제로 한다. 콘텐츠를 암호화하고 필요한 메타데이터와 묶어 보호 형식으로 만드는 것은 패키저의 역할이다. 배포자는 이렇게 준비된 콘텐츠를 이용자에게 전달하는 역할이다. 실제 서비스에서는 한 조직이나 제품이 여러 역할을 함께 수행할 수 있으므로 역할 분류와 조직 구성을 동일시하면 안 된다. 공급자 역시 반드시 원저작자만을 뜻하지 않는다.
선지별 해설
- 권리를 확보한 공급자가 배포할 콘텐츠를 제공할 수 있다.
- 보호 형식으로 포장하는 설명은 이 역할 모델에서 패키저에 해당한다.
- 키와 라이선스를 제공하는 서비스 역할을 설명한다.
- 이용 환경에서 라이선스 조건에 따른 접근과 이용을 집행하는 역할이다.
편집 해설 근거: Microsoft PlayReady, Content Packaging and Delivery — Content Packaging and Delivery; Microsoft PlayReady, Licensing FAQ, 아키텍처 역할 설명 — How does Microsoft PlayReady work?
37. 블랙박스 테스트 기법으로 거리가 먼 것은?
- 기초 경로 검사
- 동치 클래스 분해
- 경계값 분석
- 원인 결과 그래프
정답과 해설 보기
정답: 1
정답은 ①이다. 기본 경로 검사는 프로그램 내부의 제어 흐름을 분석하여 독립적인 실행 경로를 시험 대상으로 삼는 구조 기반 시험 기법이다. 따라서 외부 명세나 입출력 동작에 초점을 맞추는 블랙박스 시험과 구별된다. 동등 분할은 비슷하게 처리될 입력을 묶고, 경계값 분석은 구간의 경계 부근을 시험한다. 원인·결과 그래프는 입력 조건과 결과의 논리적 관계를 모델링한다. 어떤 기법을 쓰는지는 시험 대상의 내부 구조와 외부 명세 중 무엇을 근거로 삼는지 판단하면 된다.
선지별 해설
- 내부 제어 흐름의 독립 경로를 이용하므로 구조 기반 시험이다.
- 입력 영역을 비슷하게 처리되는 등가 그룹으로 나누는 블랙박스 기법이다.
- 명세가 정의한 입력 구간의 경계를 이용하는 블랙박스 기법이다.
- 입력 조건과 결과의 관계를 명세 관점에서 다루는 기법이다.
편집 해설 근거: ISTQB CTFL 2018 Syllabus v3.1.1 (2021-07-01) — §4.2 Black-box Test Techniques; §4.3 White-box Test Techniques; IEEE Computer Society, SWEBOK Guide V4.0a — Software Testing §3.1.6 Cause-Effect Graphing; §3.2.1 Control Flow Testing
38. 해시 함수에서 레코드 키를 일정한 자릿수의 여러 부분으로 나눈 뒤 각 부분의 값을 더해 주소 계산에 이용하는 방법은?
[학습용 개정문항]
- 제산법
- 폴딩법
- 기수변환법
- 숫자분석법
정답과 해설 보기
정답: 2
정답은 ②이다. 폴딩법은 긴 키를 몇 개의 부분으로 나누고 그 부분을 결합하여 해시 주소를 구하는 방식이다. 예를 들어 숫자 키를 일정한 자릿수로 나눈 뒤 각 부분을 더할 수 있다. 필요하면 합계를 주소 공간의 범위에 맞게 다시 줄인다. 제산법은 나머지 연산을 중심으로 주소를 구하고, 숫자 분석법은 키의 자릿수별 분포를 분석해 사용할 자리를 고른다. 따라서 이 문제의 핵심 단서인 부분으로 나눈 뒤 결합한다는 절차는 폴딩법에 해당한다.
선지별 해설
- 키를 제수로 나눈 나머지를 주소로 사용하는 방식이다.
- 키를 분할한 부분들을 더하는 등으로 결합하는 방식이다.
- 키의 진수 표현을 바꾸는 데 초점을 둔 방식이다.
- 자릿수별 분포를 분석해 주소 생성에 사용할 자리를 고르는 방식이다.
편집 해설 근거: Sartaj Sahni, Data Structures, Algorithms, & Applications in C++ (2004), Hash Functions — Folding; Digit Analysis
39. 코드의 목적을 분명하게 하고, 서로 무관한 작업과 불필요한 복잡성을 줄여 읽고 수정하기 쉽게 작성하려는 원칙에 가장 가까운 것은?
[학습용 개정문항]
- 다형성
- 단순성
- 추상화
- 의존성
정답과 해설 보기
정답: 2
정답은 ②이다. 단순한 코드는 목적이 분명하고 불필요하게 복잡한 제어 흐름이나 중복을 줄여 읽고 수정하기 쉽게 만든다. 함수가 서로 무관한 여러 작업을 뒤섞으면 이름만으로 역할을 알기 어렵고 변경의 영향도 커질 수 있다. 관련된 책임을 응집력 있게 구성하고 필요한 만큼만 추상화하는 것이 도움이 된다. 그렇다고 모든 클래스가 메서드 하나만 가져야 한다는 규칙은 아니다. 이 문항은 다형성 같은 언어 기법의 명칭이 아니라 코드의 불필요한 복잡성을 줄이는 작성 원칙을 묻는다.
선지별 해설
- 같은 인터페이스의 호출이 대상에 따라 다르게 동작하는 성질이다.
- 목적이 분명하고 불필요한 복잡성이 적은 코드를 지향하는 원칙이다.
- 중요한 특성을 드러내고 세부 사항을 감추는 모델링 개념이다.
- 모듈이나 요소가 서로 의존하는 관계를 나타낸다.
편집 해설 근거: Robert C. Martin, Solid Relevance (2020-10-18) — Single Responsibility Principle; IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §1.4 Software Design Principles
40. 다음 중 DRM의 핵심적인 콘텐츠 이용 권한 통제 기능과 목적이 가장 다른 것은?
[학습용 개정문항]
- 콘텐츠 암호화 및 키 관리
- 콘텐츠 식별자와 권리 정보의 연결
- 전송 중 손상된 데이터의 오류 정정·복구
- 라이선스 발급 및 관리
정답과 해설 보기
정답: 3
정답은 ③이다. DRM은 콘텐츠에 대한 이용 권한을 기술하고 집행하는 데 초점을 둔다. 콘텐츠를 암호화하여 보호하고, 키와 라이선스를 적절한 이용자에게 제공하며, 콘텐츠 식별자를 통해 권리 정보와 대상을 연결한다. 전송 중 손상된 데이터를 복구하는 오류 정정은 통신·저장 신뢰성을 위한 별도의 기능이다. DRM 구현에서도 무결성 검사나 오류 처리가 필요할 수 있지만, 이를 DRM의 핵심적인 저작권 이용 통제 기능과 같은 것으로 분류하지는 않는다.
선지별 해설
- 보호된 콘텐츠에 대한 접근을 제어하는 핵심 수단이다.
- 콘텐츠와 권리·라이선스 정보를 연결하는 데 사용된다.
- 전송·저장 과정의 데이터 손상 복구는 이용 권한 통제와 목적이 다르다.
- 누가 어떤 조건으로 콘텐츠를 사용할지 관리하는 핵심 기능이다.
편집 해설 근거: Microsoft PlayReady, Content Encryption (2026-10-05 확인) — Content Encryption; Microsoft PlayReady, Licensing FAQ, 아키텍처 역할 설명 — How does Microsoft PlayReady work?
정보처리기사 필기 기출문제 · 데이터베이스 구축
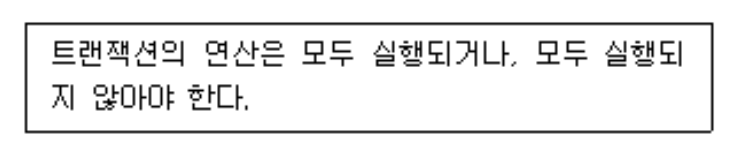
41. 이미지의 설명과 관련된 트랜잭션 특성은?
- Durability
- Isolation
- Consistency
- Atomicity
정답과 해설 보기
정답: 4
정답은 ④이다. 원자성은 하나의 트랜잭션에 묶인 작업이 전체로 반영되거나, 실패하면 그 트랜잭션의 효과가 반영되지 않도록 하는 성질이다. 예를 들어 계좌 이체에서 출금만 반영되고 입금은 빠지는 중간 결과가 확정되어서는 안 된다. 내구성은 성공적으로 확정한 결과를 유지하는 성질이고, 격리성은 동시에 수행되는 트랜잭션 사이의 간섭을 다룬다. 일관성은 트랜잭션 전후의 데이터가 무결성 조건을 만족하는 상태로 이어지는 것과 관련된다.
선지별 해설
- 커밋된 변경이 장애 후에도 유지되는 내구성이다.
- 동시 실행되는 트랜잭션 사이의 간섭을 제한하는 격리성이다.
- 트랜잭션 전후에 무결성 조건을 만족하는 상태를 유지하는 일관성이다.
- 전체 반영 또는 전체 미반영이라는 원자성을 뜻한다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 17 저자 자료 — ACID Properties
42. 데이터베이스에 영향을 주는 생성, 읽기, 갱신, 삭제 연산으 로 프로세스와 테이블 간에 매트릭스를 만들어서 트랜잭션 을 분석하는 것은?
- CASE 분석
- 일치 분석
- CRUD 분석
- 연관성 분석
정답과 해설 보기
정답: 3
정답은 ③이다. CRUD는 Create, Read, Update, Delete를 묶은 말로 각각 데이터의 생성, 조회, 수정, 삭제를 뜻한다. 업무 프로세스를 한 축에 놓고 데이터 엔터티나 테이블을 다른 축에 놓은 뒤 각 교차점에 수행하는 작업을 표시하면 데이터 사용 관계를 점검할 수 있다. 이 행렬을 통해 생성되는 경로가 없는 데이터나 필요한 조회가 빠진 업무 등을 확인할 수 있다. CRUD 행렬 자체가 트랜잭션의 격리 수준이나 실행 순서를 자동 결정하는 것은 아니다.
선지별 해설
- CASE는 개발 활동을 지원하는 도구 범주로 네 가지 데이터 조작의 약어가 아니다.
- 일괄 처리의 분석을 뜻하며 제시한 네 연산의 분류와 다르다.
- 생성·조회·수정·삭제를 기준으로 업무와 데이터의 관계를 분석한다.
- 데이터 수가 적다는 성질이며 제시한 행렬의 명칭이 아니다.
편집 해설 근거: SKF Group, Toolbox for Architecture Framework, Open Group 공개 자료 (2018) — B. Architecture Artefact Cards — Master Data Object to Business Process Matrix; ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.958 CRUD
43. 정규화된 데이터 구조에 대해 성능이나 운영 요구를 검토한 뒤, 의도적으로 데이터 중복이나 테이블 통합 등을 도입하는 설계 기법은?
[학습용 개정문항]
- 인덱스정규화
- 반정규화
- 집단화
- 머징
정답과 해설 보기
정답: 2
정답은 ②이다. 반정규화는 조회 성능이나 운영 요구 등을 고려하여 정규화된 논리 구조에 의도적으로 중복을 도입하거나 테이블을 합치는 등의 설계 선택이다. 필요한 조인의 수를 줄일 수 있지만 저장 공간과 갱신 비용이 늘고 같은 정보의 불일치 위험이 생길 수 있다. 따라서 실제 접근 패턴과 측정 결과를 근거로 적용해야 한다. 반정규화를 수행하면 항상 성능이 좋아진다는 뜻은 아니며, 인덱스를 추가하거나 잠금 단위를 조정하는 작업과도 구별된다.
선지별 해설
- 인덱스는 접근 경로를 제공하며 테이블의 논리적 중복 도입과는 다른 설계 수단이다.
- 성능 등의 목적을 위해 의도적으로 중복이나 구조 통합을 고려하는 설계이다.
- 종속성과 중복 문제를 줄이도록 관계를 분해·정리하는 과정이다.
- 동시 접근을 제어하는 잠금 기법이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Physical Database Design — Decisions to Make; Tuning the Conceptual Schema — Denormalization
44. 학생 테이블을 생성한 후, 성별 필드가 누락되어 이를 추가 하려고 한다. 이에 적합한 SQL 명령어는?
- INSERT
- ALTER
- DROP
- MODIFY
정답과 해설 보기
정답: 2
정답은 ②이다. 기존 테이블에 새로운 열을 추가하려면 테이블 정의를 변경하는 ALTER TABLE을 사용한다. 예를 들어 성별 열을 추가하는 기본 형태는 ALTER TABLE 학생 ADD COLUMN 성별 VARCHAR(10);이다. INSERT는 이미 정의된 열에 맞추어 새로운 행을 넣는 명령이므로 누락된 열 자체를 만들어 주지 않는다. DROP은 테이블 등의 객체를 제거한다. DBMS에 따라 열 변경 문법에 MODIFY가 나타날 수 있지만, 이 문제의 열 추가 작업에 해당하는 명령 종류는 ALTER이다.
선지별 해설
- 새 행을 추가하는 데이터 조작 명령이다.
- ALTER TABLE의 ADD COLUMN으로 열을 추가할 수 있다.
- 테이블 등 객체를 제거하는 명령이다.
- 일부 제품의 열 변경 구문에 쓰여도 여기서 열을 추가하는 최상위 명령은 아니다.
편집 해설 근거: PostgreSQL 18, ALTER TABLE — Synopsis — ADD COLUMN; Description
45. 정규화의 필요성으로 거리가 먼 것은?
- 데이터 구조의 안정성 최대화
- 중복 데이터의 활성화
- 수정, 삭제 시 이상현상의 최소화
- 테이블 불일치 위험의 최소화
정답과 해설 보기
정답: 2
정답은 ②이다. 정규화는 데이터의 함수 종속성 등을 분석하여 불필요한 중복과 그로 인한 삽입·수정·삭제 이상을 줄이는 설계 과정이다. 같은 사실을 여러 행에 반복하면 한 곳만 수정되어 값이 서로 달라질 수 있고, 관련 없는 정보를 함께 넣거나 지워야 하는 문제가 생긴다. 관계를 적절히 분해하면 이런 위험을 줄일 수 있다. 다만 정규화가 모든 무결성 문제를 자동 해결하거나 모든 조회를 빠르게 만드는 것은 아니므로 필요한 키와 제약조건도 함께 설계한다.
선지별 해설
- 갱신 이상을 줄여 데이터 구조의 일관성과 안정성을 높이는 데 기여한다.
- 불필요한 중복을 늘리는 것은 정규화의 목적과 반대이다.
- 함수 종속성에 기인한 갱신 이상을 줄이려는 목적에 해당한다.
- 같은 사실의 중복 저장으로 생기는 불일치 위험을 줄일 수 있다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Chapter 19 저자 자료 — The Evils of Redundancy; Decomposition of a Relation Scheme
46. Chen 방식의 기본 E-R 다이어그램 표기에서 기호와 의미가 잘못 연결된 것은?
[학습용 개정문항]
- 사각형 – 개체 타입
- 삼각형 – 속성
- 선 – 개체타입과 속성을 연결
- 마름모 – 관계 타입
정답과 해설 보기
정답: 2
정답은 ②이다. Chen 방식의 기본 E-R 표기에서는 개체 집합을 사각형, 관계 집합을 마름모, 속성을 타원으로 나타낸다. 선은 속성이나 관계를 관련 개체에 연결하는 데 쓰인다. 따라서 속성을 삼각형으로 표시한다는 연결은 맞지 않는다. E-R 다이어그램에는 여러 표기법과 확장 기호가 있으므로 기호의 뜻을 모든 모델링 도구에 동일하게 적용하면 안 된다. 이 문항은 Chen 방식의 기본 기호만 비교하며, 확장 모델의 ISA 관계 같은 다른 용도와도 구분한다.
선지별 해설
- Chen 방식에서 개체 집합을 표시하는 기본 기호이다.
- 속성의 기본 기호는 삼각형이 아니라 타원이다.
- 개체와 속성 또는 관계를 연결하는 데 사용된다.
- Chen 방식에서 관계 집합을 표시하는 기본 기호이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, ER Model — ER Model Basics
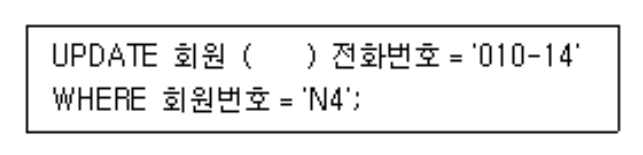
47. 이미지의 UPDATE 문 빈칸에 들어갈 키워드는?
- FROM
- SET
- INTO
- TO
정답과 해설 보기
정답: 2
정답은 ②이다. UPDATE는 기존 행의 열 값을 바꾸고, SET 절은 변경할 열과 새 값을 지정한다. 이미지에서는 회원 테이블에서 회원번호가 N4인 행을 찾아 전화번호를 바꾸므로 UPDATE 회원 SET 전화번호='010-14' WHERE 회원번호='N4';로 완성된다. WHERE는 수정할 행의 범위를 제한한다. WHERE를 생략하면 조건 없이 모든 대상 행을 갱신할 수 있으므로 SET이 정하는 변경 내용과 WHERE가 정하는 변경 대상을 구별해야 한다.
선지별 해설
- 일부 UPDATE 문에서 추가 테이블을 참조할 때 쓰일 수 있으나 대입을 시작하는 키워드가 아니다.
- 변경할 열과 새 값을 지정하는 절을 시작한다.
- INSERT INTO에서 삽입 대상 등을 나타낼 때 쓰인다.
- GRANT의 권한 수신자 등 다른 문맥에 쓰이며 UPDATE 대입 구문이 아니다.
편집 해설 근거: PostgreSQL 18 — UPDATE — Synopsis; Description
48. 릴레이션의 튜플을 유일하게 식별할 수 있어야 하지만 속성 집합의 최소성은 필수로 요구하지 않는 키의 일반적인 명칭은?
[학습용 개정문항]
- 후보키
- 기본키
- 슈퍼키
- 외래키
정답과 해설 보기
정답: 3
정답은 ③이다. 슈퍼키는 릴레이션의 각 튜플을 유일하게 식별할 수 있는 속성 집합이다. 유일성을 유지하는 데 불필요한 속성이 들어 있어도 슈퍼키가 될 수 있으므로 최소성을 필수로 요구하지 않는다. 슈퍼키 중 어떤 속성을 빼더라도 유일성을 잃는 최소 집합이 후보키이고, 후보키 중 하나를 대표로 선택하면 기본키가 된다. 따라서 후보키와 기본키도 슈퍼키에 포함된다. 슈퍼키는 최소성을 절대로 만족하지 않는다는 설명은 잘못이다.
선지별 해설
- 유일성과 함께 속성 집합의 최소성을 요구한다.
- 후보키 가운데 대표로 선택한 키이므로 최소성을 갖는다.
- 유일성을 요구하지만 최소성은 필수 조건으로 요구하지 않는다.
- 다른 관계의 키 등을 참조하는 제약으로 자신의 행 전체를 유일하게 식별할 필요는 없다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Primary Key Constraints; Primary and Candidate Keys in SQL
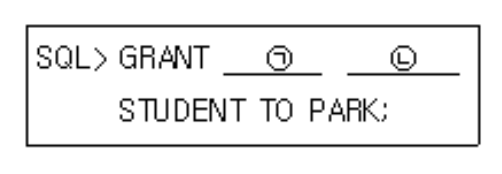
49. 이미지의 GRANT 문 빈칸을 올바르게 채운 것은?
- ㉠ INSERT, ㉡ INTO
- ㉠ ALTER, ㉡ TO
- ㉠ UPDATE, ㉡ ON
- ㉠ REPLACE, ㉡ IN
정답과 해설 보기
정답: 3
정답은 ③이다. 테이블의 기존 데이터를 수정할 권한은 UPDATE이며, 권한의 대상 테이블은 ON 뒤에, 권한을 받을 사용자나 역할은 TO 뒤에 쓴다. 따라서 GRANT UPDATE ON STUDENT TO PARK;로 문장을 완성한다. INSERT는 새 행을 추가할 권한으로 수정 권한과 다르고, INTO는 이 GRANT 문에서 테이블을 연결하는 키워드가 아니다. 권한을 부여하는 문장과 실제 데이터를 변경하는 UPDATE 문을 구분해야 하며, GRANT 자체는 테이블의 행 값을 바꾸지 않는다.
선지별 해설
- INSERT는 삽입 권한이고 테이블 앞에 INTO를 쓰는 GRANT 형식도 맞지 않는다.
- 제시한 ALTER와 TO 조합은 이 테이블 수정 권한 부여 구문이 아니다.
- UPDATE 권한을 ON STUDENT에 대해 TO PARK로 부여한다.
- 제시한 REPLACE와 IN 조합은 이 GRANT 구문이 아니다.
편집 해설 근거: PostgreSQL 18, GRANT — Synopsis — table privileges; GRANT on Database Objects
50. 관계대수에 대한 설명으로 틀린 것은?
- 주어진 릴레이션 조작을 위한 연산의 집합이다.
- 일반 집합 연산과 순수 관계 연산으로 구분된다.
- 질의에 대한 해를 구하기 위해 수행해야 할 연산의 순서 를 명시한다.
- 원하는 정보와 그 정보를 어떻게 유도하는가를 기술하는 비절차적방법이다.
정답과 해설 보기
정답: 4
정답은 ④이다. 관계대수는 릴레이션을 입력받아 릴레이션을 결과로 만드는 연산과 그 조합으로 질의를 표현한다. 선택, 투영, 조인 같은 관계 연산과 합집합, 차집합, 곱집합 같은 집합 연산을 이용한다. 원하는 결과를 얻기 위해 어떤 연산을 적용할지 식으로 표현하므로 교재에서는 절차적 질의 언어로 구분한다. 반면 관계해석은 결과가 만족할 조건을 선언적으로 기술한다. 여기서 절차적이라는 말은 디스크 접근이나 조인 알고리즘 등 실제 물리 실행 계획을 직접 고정한다는 뜻은 아니다.
선지별 해설
- 입력 릴레이션들에 연산을 적용하는 질의 표현이다.
- 집합 연산과 관계 모델에 특화된 연산을 함께 사용한다.
- 연산의 조합으로 결과를 구하는 방법을 표현한다.
- 비절차적 언어라는 설명이 관계대수의 교재상 분류와 맞지 않는다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — Relational Query Languages; Relational Algebra; Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Calculus — Relational Calculus
51. 다음 학생·성적 자료에서 SQL을 실행한 결과는? 결과 행의 순서는 무시하며 같은 값의 출현 횟수는 구별한다.
-- 학생(학번, 학과, 주소): 아래 5행이 전체 자료이다.
-- 1000 | 전산 | 서울
-- 2000 | 전기 | 경기
-- 3000 | 전자 | 경기
-- 4000 | 전산 | 경기
-- 5000 | 전자 | 서울
-- 성적(학번, 과목번호, 과목이름): 아래 7행이 전체 자료이다.
-- 1000 | A100 | 자료구조
-- 2000 | A200 | DB
-- 3000 | A100 | 자료구조
-- 3000 | A200 | DB
-- 4000 | A200 | DB
-- 4000 | A300 | 운영체제
-- 5000 | A300 | 운영체제
SELECT 과목이름
FROM 성적
WHERE EXISTS (
  SELECT 학번 FROM 학생
  WHERE 학생.학번 = 성적.학번
    AND 학생.학과 IN ('전산', '전기')
    AND 학생.주소 = '경기'
);
[학습용 개정문항]
- DB 1행
- DB 2행
- DB 2행, 운영체제 1행
- DB 1행, 운영체제 1행
정답과 해설 보기
정답: 3
정답은 ③이다. EXISTS의 내부 질의는 바깥 성적 행의 학번과 같은 학생 중 학과가 전산 또는 전기이고 주소가 경기인 학생이 있는지 검사한다. 이 조건에 맞는 학생은 2000번과 4000번이다. 성적 테이블에서 2000번의 DB 한 행, 4000번의 DB와 운영체제 두 행이 남으므로 총 세 행이 출력된다. SELECT에 DISTINCT가 없어서 과목이름이 같은 DB 두 행도 그대로 남는다. ORDER BY가 없으므로 표시 순서는 보장되지 않으며, 정답은 값의 종류와 각 출현 횟수로 판단한다.
선지별 해설
- 조건에 맞는 세 성적 행 중 두 행을 빠뜨린 결과이다.
- 4000번 학생의 운영체제 행이 누락되어 있다.
- DB 두 행과 운영체제 한 행이 남는다.
- DISTINCT를 적용한 것처럼 DB 중복을 제거한 결과이다.
편집 해설 근거: PostgreSQL 18, Subquery Expressions — §9.24.1 EXISTS; PostgreSQL 18 — SELECT — SELECT ALL; DISTINCT; ORDER BY
52. 로킹(Locking) 기법에 대한 설명으로 틀린 것은?
- 로킹의 대상이 되는 객체의 크기를 로킹 단위라고 한다.
- 로킹 단위가 작아지면 병행성 수준이 낮아진다.
- 데이터베이스도 로킹 단위가 될 수 있다.
- 로킹 단위가 커지면 로크 수가 작아 로킹 오버헤드가 감 소한다.
정답과 해설 보기
정답: 2
정답은 ②이다. 잠금 단위가 작으면 서로 다른 세부 항목을 쓰는 트랜잭션들이 동시에 진행할 여지가 커진다. 대신 많은 항목을 처리할 때 잠금의 수와 관리 비용이 증가할 수 있다. 반대로 큰 단위로 잠그면 필요한 잠금 수는 줄어들 수 있지만 실제로 충돌하지 않는 작업까지 함께 막힐 수 있다. 따라서 작은 잠금 단위가 일반적으로 병행성 수준을 낮춘다는 설명은 방향이 반대이다. 실제 처리량은 충돌 패턴, 잠금 유지 시간, DBMS의 잠금 승격 정책에도 영향을 받는다.
선지별 해설
- 레코드·페이지·테이블 등 잠그는 대상의 범위를 뜻한다.
- 작은 단위는 일반적으로 동시 진행의 여지를 늘리므로 설명이 반대이다.
- 시스템이나 제어 방식에 따라 데이터베이스 수준의 큰 잠금을 둘 수 있다.
- 같은 범위의 작업에서 큰 단위를 쓰면 관리할 잠금 수가 줄어들 수 있다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Concurrency Control — Multiple-Granularity Locks
53. 사용자 X1에게 department 테이블에 대한 검색 연산을 회 수하는 명령은?
- delete select on department to X1;
- remove select on department from X1;
- revoke select on department from X1;
- grant select on department from X1;
정답과 해설 보기
정답: 3
정답은 ③이다. 부여된 권한을 회수하는 SQL 명령은 REVOKE이다. 회수할 SELECT 권한을 먼저 쓰고, ON department로 대상 테이블을 지정한 뒤 FROM X1로 권한을 회수할 사용자나 역할을 나타낸다. 따라서 REVOKE SELECT ON department FROM X1;이 맞다. DELETE는 데이터 행을 삭제하는 명령이며 권한을 회수하지 않는다. 다만 사용자가 다른 역할이나 PUBLIC을 통해 같은 권한을 얻고 있다면 직접 부여된 권한 하나를 회수해도 조회가 가능할 수 있다.
선지별 해설
- DELETE는 행 삭제 명령이며 SELECT 권한 회수 구문이 아니다.
- REMOVE SELECT는 이 권한 회수 명령의 올바른 구문이 아니다.
- REVOKE 권한 ON 객체 FROM 사용자 형식에 맞는다.
- GRANT는 권한 부여에 사용되며 수신자를 나타낼 때 TO를 쓴다.
편집 해설 근거: PostgreSQL 18, REVOKE — Synopsis; Description; Notes
54. PostgreSQL 18의 일반 뷰(VIEW)에 대한 설명으로 잘못된 것은?
[학습용 개정문항]
- 다른 뷰를 참조하여 새 뷰를 정의할 수 있다.
- 뷰의 구조에 따라 INSERT·UPDATE·DELETE가 제한될 수 있다.
- ALTER VIEW 명령으로 뷰를 정의하는 SELECT 질의를 직접 교체한다.
- 기본 테이블을 DROP TABLE … CASCADE로 삭제하면 그 테이블에 종속된 뷰도 제거될 수 있다.
정답과 해설 보기
정답: 3
정답은 ③이다. PostgreSQL 18의 ALTER VIEW는 뷰의 이름, 소유자, 스키마, 일부 옵션 등 보조 속성을 변경한다. 뷰를 정의하는 SELECT 질의를 교체하려면 허용되는 열 호환성 조건을 만족하는 CREATE OR REPLACE VIEW 등을 사용해야 한다. 다른 뷰를 참조하는 뷰를 만들 수 있고, 집계 등 구조에 따라 일반 뷰의 자동 갱신이 제한될 수 있다. 기본 테이블을 삭제할 때에는 종속 객체 때문에 거부될 수 있으며 CASCADE를 명시하면 종속 뷰도 함께 제거될 수 있다.
선지별 해설
- 뷰의 질의에서 다른 뷰를 참조할 수 있다.
- 집계·중복 제거 등 뷰 구조에 따라 자동 갱신이 제한될 수 있다.
- ALTER VIEW로 SELECT 정의를 직접 교체한다는 설명은 맞지 않는다.
- CASCADE가 지정된 테이블 삭제는 종속 뷰의 제거로 이어질 수 있다.
편집 해설 근거: PostgreSQL 18 — ALTER VIEW — Description; PostgreSQL 18 — CREATE VIEW — Description; Updatable Views; PostgreSQL 18: DROP TABLE — Description; CASCADE
55. 데이터 모델에 표시해야 할 요소로 거리가 먼 것은?
- 논리적 데이터 구조
- 출력 구조
- 연산
- 제약조건
정답과 해설 보기
정답: 2
정답은 ②이다. 데이터 모델은 데이터를 어떤 구조로 표현할지, 그 데이터에 어떤 연산을 허용할지, 어떤 제약을 만족해야 할지를 함께 규정한다. 관계 모델을 예로 들면 릴레이션과 속성이 구조를 이루고, 선택·투영 등의 연산으로 데이터를 다루며, 키와 참조 무결성 같은 조건으로 유효한 상태를 제한한다. 화면의 출력 방식은 응용과 표현 계층의 설계 문제이다. 데이터를 모델링할 때 출력 요구를 참고할 수는 있어도 출력 방법 자체를 구조·연산·제약과 같은 기본 구성요소로 분류하지는 않는다.
선지별 해설
- 데이터의 조직과 관계를 표현하는 구조 요소이다.
- 사용자에게 보여 주는 방식이며 이 분류의 기본 구성요소가 아니다.
- 모델의 데이터에 적용하는 조작을 규정한다.
- 허용되는 데이터 상태와 관계의 조건을 규정한다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Introduction — Data Models; Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Integrity Constraints; Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Algebra 저자 자료 — Relational Algebra — Basic operations
56. 3NF를 만족하는 관계에서 BCNF까지 만족하도록 설계할 때 추가로 적용할 핵심 조건은?
[학습용 개정문항]
- 모든 속성 값의 원자성만 확인한다.
- 비주속성의 후보키에 대한 부분 함수 종속만 제거한다.
- 비주속성의 이행 함수 종속만 제거한다.
- 모든 비자명 함수 종속 X→Y에서 X가 슈퍼키인지 확인하고 위반을 해소한다.
정답과 해설 보기
정답: 4
정답은 ④이다. BCNF는 관계에서 성립하는 모든 비자명 함수 종속 X→Y에 대해 결정자 X가 슈퍼키여야 한다는 조건이다. 후보키는 최소인 슈퍼키이므로 결정자를 반드시 후보키로만 제한하면 정의가 지나치게 좁아진다. 3NF에서는 결정자가 슈퍼키가 아니더라도 우변의 속성이 어떤 후보키에 포함되는 주속성이면 허용되는 경우가 있으나 BCNF는 이 예외를 허용하지 않는다. BCNF 위반 종속을 기준으로 관계를 분해할 때에는 무손실 조인 여부와 종속성 보존도 함께 검토해야 한다.
선지별 해설
- 원자적 값에 관한 1NF의 학습 기준과 관련된다.
- 후보키 일부에 대한 비주속성의 부분 종속을 다루는 2NF 단계와 관련된다.
- 비주속성의 이행 종속을 다루는 3NF 단계의 대표적인 학습 설명이다.
- 비자명 함수 종속의 결정자가 슈퍼키여야 하는 BCNF 조건을 적용한다.
편집 해설 근거: Silberschatz·Korth·Sudarshan, Database System Concepts 7판, Chapter 7 저자 자료 — Boyce-Codd Normal Form; Third Normal Form
57. 속성 A1, A2, A3의 도메인 크기가 각각 3, 2, 4이다. 추가 제약이 없고 중복 튜플을 허용하지 않는 집합 의미의 릴레이션에 저장할 수 있는 서로 다른 튜플의 최대 수는?
[학습용 개정문항]
- 24
- 12
- 8
- 9
정답과 해설 보기
정답: 1
정답은 ①이다. 세 속성의 값은 각각의 도메인에서 하나씩 선택하므로 가능한 조합 수는 3×2×4=24이다. 수학적인 릴레이션은 도메인들의 카티션 곱의 부분집합이므로 모든 조합을 허용하면 24개의 서로 다른 튜플을 담을 수 있다. 집합에서는 동일한 튜플을 중복하여 세지 않는다. 실제 스키마에 추가 키 제약이나 다른 업무 제약이 있으면 허용되는 조합 수가 줄어들 수 있으며, SQL의 중복 행을 허용하는 테이블과 이 문항의 집합 모델도 구별해야 한다.
선지별 해설
- 각 도메인의 크기를 곱한 3×2×4와 같다.
- 세 번째 도메인 또는 다른 조합을 일부 누락한 값이다.
- 전체 세 속성의 조합 수를 반영하지 못한 값이다.
- 도메인 크기를 더한 값으로 곱집합의 크기가 아니다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relational Database: Definitions
58. 데이터베이스의 논리적 설계와 물리적 설계를 구분할 때, 주로 논리적 설계에 해당하는 작업은?
[학습용 개정문항]
- 저장 레코드의 물리적 배치 설계
- 레코드 길이와 저장 공간 효율 분석
- 인덱스 등 접근 경로 설계
- 목표 데이터 모델에 맞는 테이블·속성·제약의 논리 스키마 구성
정답과 해설 보기
정답: 4
정답은 ④이다. 논리적 설계는 선택한 데이터 모델과 DBMS에 맞춰 테이블, 속성, 관계, 무결성 제약 등 논리 스키마를 구성하는 단계이다. 물리적 설계에서는 그 구조를 효율적으로 저장하고 접근하도록 레코드 배치, 파일 조직, 인덱스 같은 접근 경로를 결정한다. 두 단계가 실무에서 반복되거나 서로 영향을 주는 것은 가능하다. 이 문항은 작업의 주된 관심사를 구분하므로 저장 방식과 접근 비용을 정하는 세 보기와 달리 논리 스키마 구성은 논리적 설계에 해당한다.
선지별 해설
- 물리적 저장 형식과 레코드 배치를 다루는 작업이다.
- 레코드 크기와 공간 효율 등을 검토하는 물리 설계 작업이다.
- 인덱스 등 접근 경로를 정하는 물리 설계 작업이다.
- 테이블·속성·제약의 논리 스키마 구성은 논리적 설계의 중심 작업이다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Introduction — Levels of Abstraction; Ramakrishnan·Gehrke, Database Management Systems 3판, Physical Database Design — Overview; Decisions to Make
59. 한 릴레이션 스키마가 4개 속성, 2개 후보키 그리고 그 스 키마의 대응 릴레이션 인스턴스가 7개 튜플을 갖는다면 그 릴레이션의 차수(degree)는?
- 1
- 2
- 4
- 7
정답과 해설 보기
정답: 3
정답은 ③이다. 릴레이션의 차수는 그 스키마를 구성하는 속성, 즉 열의 수이다. 문제에서 속성이 네 개이므로 차수는 4이다. 인스턴스에 들어 있는 튜플, 즉 행의 수는 카디널리티라고 하며 여기서는 7이다. 후보키가 두 개이고 기본키가 하나라는 조건은 행을 식별하는 속성 집합의 수에 관한 정보로 차수를 정하는 기준이 아니다. 키 하나가 여러 속성으로 이루어질 수도 있으므로 키의 개수와 속성의 개수를 혼동하지 않아야 한다.
선지별 해설
- 기본키로 선택한 속성 집합의 수와 혼동한 값이다.
- 후보키 집합의 개수와 혼동한 값이다.
- 스키마의 속성 네 개를 센 올바른 차수이다.
- 튜플의 수, 즉 카디널리티에 해당한다.
편집 해설 근거: Ramakrishnan·Gehrke, Database Management Systems 3판, Relational Model — Relational Database: Definitions
60. 데이터웨어하우스의 기본적인 OLAP(on-line analytical processing) 연산이 아닌 것은?
- translate
- roll-up
- dicing
- drill-down
정답과 해설 보기
정답: 1
정답은 ①이다. OLAP은 여러 차원으로 구성한 데이터를 다양한 집계 수준과 부분집합으로 분석하는 방식이다. Roll-up은 세부 데이터를 더 높은 수준으로 집계하고, drill-down은 그 반대로 세부 수준을 살펴본다. Dice는 여러 차원의 조건을 조합하여 분석할 부분 공간을 선택하는 연산이다. Translate라는 일반적인 변환·번역 용어는 이들과 함께 제시되는 기본 OLAP 분석 연산의 명칭이 아니다. 데이터 적재 과정의 변환 작업과 분석 큐브의 탐색 연산을 구분해야 한다.
선지별 해설
- 이 문항에서 비교하는 기본 OLAP 분석 연산의 표준적 명칭이 아니다.
- 상위 집계 수준으로 올라가 요약된 값을 분석한다.
- 여러 차원에 조건을 적용해 부분 큐브를 선택한다.
- 더 낮은 집계 수준으로 내려가 세부 값을 분석한다.
편집 해설 근거: AWS — What is OLAP? — What are OLAP operations? — Roll up, Drill down, Slice, Dice
정보처리기사 필기 기출문제 · 프로그래밍 언어 활용
61. Bash와 GNU Coreutils 환경을 전제로 할 때, 환경변수 또는 내보내기 대상으로 지정된 변수를 확인하는 제공 명령이 아닌 것은?
[학습용 개정문항]
- configenv
- printenv
- env
- export -p
정답과 해설 보기
정답: 1
정답은 ①이다. GNU Coreutils의 printenv는 환경변수 값을 출력하고, 별도의 명령을 지정하지 않은 env도 환경을 출력한다. Bash의 export -p는 자식 프로세스로 내보내도록 지정된 변수와 그 상태를 재사용할 수 있는 형식으로 보여 준다. 이 도구들이 제공하는 환경 확인 명령으로 configenv는 정의되어 있지 않다. 원래 보기의 setenv는 csh 계열에 속하여 Bash에 그대로 적용할 수 없으므로 실행 환경을 혼합하지 않는 것이 중요하다. 여기서는 Bash와 GNU Coreutils로 범위를 고정했다.
선지별 해설
- Bash와 GNU Coreutils가 제공하는 환경 확인 명령으로 정의되어 있지 않다.
- GNU Coreutils에서 환경변수의 값을 출력한다.
- 별도 명령 없이 실행하면 환경을 출력한다.
- Bash가 내보내는 변수의 상태를 출력하는 내장 명령 형식이다.
편집 해설 근거: GNU Coreutils, printenv invocation — printenv invocation; GNU Coreutils, env invocation — env invocation; GNU Bash Reference Manual, Edition 5.3 (2025) — Bourne Shell Builtins — export
62. Java 프로그래밍 언어의 정수 데이터 타입 중 'long'의 크기 는?
- 1byte
- 2byte
- 4byte
- 8byte
정답과 해설 보기
정답: 4
정답은 ④이다. Java 언어 명세에서 long은 64비트 부호 있는 정수형으로 정의된다. 1바이트를 8비트로 계산하면 64÷8=8바이트이다. byte, short, int, long의 비트 수는 각각 8, 16, 32, 64이므로 long을 int와 혼동하면 안 된다. 이 크기는 원시 정수형의 값 표현에 대한 설명이며, Long 객체가 힙에서 차지하는 전체 메모리 크기를 뜻하지 않는다. 객체 헤더나 정렬 패딩이 포함된 실제 객체의 저장 크기는 JVM 구현과 설정에 따라 달라질 수 있다.
선지별 해설
- 8비트 정수형 byte에 해당하는 크기이다.
- 16비트 정수형 short에 해당하는 크기이다.
- 32비트 정수형 int에 해당하는 크기이다.
- long의 64비트를 8로 나눈 값이다.
편집 해설 근거: Oracle Java SE 25 Language Specification, Chapter 4 Types, Values, and Variables — §4.2.1 Integral Types and Values
63. Java SE의 System.out 객체가 속한 PrintStream 클래스에 정의된 출력 메서드 이름이 아닌 것은?
[학습용 개정문항]
- println
- printing
- printf
정답과 해설 보기
정답: 3
정답은 ③이다. System.out은 PrintStream 객체이며 print, println, printf라는 메서드를 제공한다. print는 값을 출력하고, println은 값을 출력한 뒤 줄을 마치며, printf는 형식 문자열과 인수를 이용하여 형식화된 출력을 수행한다. printing이라는 메서드는 PrintStream의 표준 API에 정의되어 있지 않다. 다만 메서드 이름이 존재한다는 것과 인수 없이 호출할 수 있다는 것은 별개이다. print와 printf에는 적절한 인수가 필요하므로 이 문항은 호출식의 완성 여부가 아니라 메서드 이름을 비교한다.
선지별 해설
- 값을 출력하는 PrintStream 메서드 이름이다.
- 값을 출력하고 줄을 마치는 메서드 이름이며 인수 없는 형태도 있다.
- PrintStream의 표준 출력 메서드 이름으로 정의되어 있지 않다.
- 형식 문자열에 따라 출력을 구성하는 메서드 이름이다.
편집 해설 근거: Oracle Java SE 17 API, java.io.PrintStream — Method Summary — print, println, printf
64. 일반적인 Unix 계열 운영체제에서 커널의 자원 관리 기능보다 사용자 공간 셸이 주로 담당하는 것은?
[학습용 개정문항]
- 프로세스 생성과 종료에 필요한 상태 관리
- 사용자가 명령을 입력하는 대화형 셸 인터페이스
- 프로세스 기억장치의 할당과 회수
- 파일시스템을 통한 저장 데이터 접근 관리
정답과 해설 보기
정답: 2
정답은 ②이다. 일반적인 Unix 계열 운영체제에서 커널은 프로세스와 메모리, 입출력 장치, 파일시스템 등 시스템 자원을 관리한다. 사용자가 명령을 입력하거나 창과 버튼을 조작하는 인터페이스는 주로 사용자 공간의 셸과 데스크톱 프로그램이 제공한다. 커널도 시스템 호출 인터페이스를 제공하지만 이것은 프로그램이 커널 서비스를 요청하는 경계이지 이 문항에서 말하는 대화형 사용자 화면과 같지 않다. 운영체제 전체의 기능과 커널의 직접 역할을 구분하는 것이 핵심이다.
선지별 해설
- 프로세스 생성과 종료에 필요한 핵심 자원·상태 관리는 커널의 역할이다.
- 대화형 명령 입력 화면은 주로 사용자 공간의 셸이 제공한다.
- 프로세스에 메모리를 할당하고 회수하는 핵심 기능이다.
- 파일과 저장 장치에 대한 접근을 관리하는 핵심 기능이다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 2 Introduction to Operating Systems — The Operating System; Persistence; Design Goals; POSIX.1-2024 Issue 8, Shell Command Language — Shell Command Language — Introduction
65. OSI 기본 참조 모델에서 상위 계층에 종단 간 데이터 전송 서비스를 제공하며, 신뢰성 있는 서비스의 경우 오류 복구와 흐름 제어 등을 지원하는 계층은?
[학습용 개정문항]
- 전송 계층
- 응용 계층
- 세션 계층
- 표현 계층
정답과 해설 보기
정답: 1
정답은 ①이다. OSI 기본 참조 모델의 전송 계층은 서로 다른 종단 시스템의 상위 계층 사이에 데이터 전송 서비스를 제공한다. 사용하는 서비스 유형과 프로토콜에 따라 오류 복구, 순서 유지, 흐름 제어 같은 기능을 통해 신뢰성 있는 종단 간 전달을 지원할 수 있다. 인접한 링크 한 구간의 전달과 종단 간 전달을 구별해야 한다. 응용 계층은 응용 서비스, 표현 계층은 데이터 표현, 세션 계층은 대화와 동기화 등을 다루므로 이 문항의 종단 간 전송 역할과 다르다.
선지별 해설
- 종단 간 데이터 전송과 필요한 신뢰성·흐름 제어를 제공하는 계층이다.
- 응용 프로세스에 필요한 통신 서비스를 제공하는 상위 계층이다.
- 응용 간 대화와 동기화 등을 관리하는 계층이다.
- 데이터 표현과 표현 형식의 변환을 다루는 계층이다.
편집 해설 근거: ITU-T X.200 (07/1994), OSI Basic Reference Model — §7.4 Transport Layer
66. Bash에서 pipefail이 꺼져 있고 명령 실행 오류가 없다고 할 때 다음 코드의 동작은?
until who | grep -q 'wow'
do
  sleep 5
done
[학습용 개정문항]
- wow가 포함된 줄을 찾은 경우에만 본문을 반복한다.
- who 출력에 wow가 포함된 줄을 찾을 때까지 5초씩 기다리며 재검사한다.
- wow 문자열을 복사한다.
- 일치 여부와 관계없이 사용자 정보를 무한히 출력한다.
정답과 해설 보기
정답: 2
정답은 ②이다. until은 조건 명령의 종료 상태가 0이 아닐 동안 본문을 반복하고, 0이면 반복을 끝낸다. 기본 파이프라인의 종료 상태는 마지막 명령인 grep의 상태로 정해진다. 정상 동작하는 grep -q는 who 출력에서 wow라는 부분 문자열을 찾으면 0을 반환하므로 반복이 종료된다. 일치가 없으면 sleep 5를 수행한 뒤 다시 검사한다. 이 패턴은 사용자명 열만 정확히 비교하지 않으므로 wow라는 이름의 사용자만을 식별하는 정확한 로그인 확인 코드라고 설명해서는 안 된다.
선지별 해설
- 일치하는 줄을 찾으면 반복하는 것이 아니라 종료한다.
- 일치하는 줄을 찾을 때까지 5초 간격의 재검사를 반복한다.
- 문자열을 파일이나 변수에 복사하는 명령이 없다.
- 조건이 성공하면 끝나며 -q 옵션은 일치한 줄의 출력도 생략한다.
편집 해설 근거: GNU Bash Reference Manual, Edition 5.3 (2025) — Looping Constructs — until; Pipelines; GNU Grep, Exit Status — Exit Status
67. Java에서 다음 메서드 본문을 포함한 클래스를 컴파일하면 어떻게 되는가?
public static void main(String[] args) {
    int x = 1, y = 6;
    while (y--) {
        x++;
    }
    System.out.println("x=" + x + " y=" + y);
}
[학습용 개정문항]
- x=7 y=0을 출력한다.
- x=6 y=-1을 출력한다.
- x=7 y=-1을 출력한다.
- while 조건의 타입 때문에 컴파일 오류가 발생한다.
정답과 해설 보기
정답: 4
정답은 ④이다. Java의 while 조건식은 boolean 또는 Boolean이어야 한다. y는 int이고 y의 후위 감소식은 감소 전의 정수 값을 결과로 내는 후위 감소식이므로 boolean 조건으로 사용할 수 없다. Java는 C 계열 일부 언어처럼 정수 0을 거짓으로, 그 밖의 정수를 참으로 자동 변환하지 않는다. 따라서 이 코드는 컴파일 오류가 나고 x와 y의 최종 값을 출력하는 단계에 도달하지 않는다. 구체적인 오류 문구는 컴파일러나 개발 도구에 따라 달라지므로 특정 메시지 하나를 필수 결과로 암기할 필요는 없다.
선지별 해설
- 반복을 정수 조건으로 실행할 수 있다고 가정한 값이며 Java에서는 출력되지 않는다.
- 컴파일이 실패하므로 이 숫자 결과가 나오지 않는다.
- 정수 조건을 허용하는 다른 언어의 해석을 적용한 결과와 혼동한 것이다.
- int형 후위 감소식을 while의 boolean 조건으로 사용할 수 없어 컴파일에 실패한다.
편집 해설 근거: Oracle Java SE 17 Language Specification, Chapter 14 Blocks and Statements — §14.12 The while Statement; Oracle Java SE 17 Language Specification, Chapter 15 Expressions — §15.14.3 Postfix Decrement Operator
68. 이미지의 Python 슬라이스 실행 결과는?
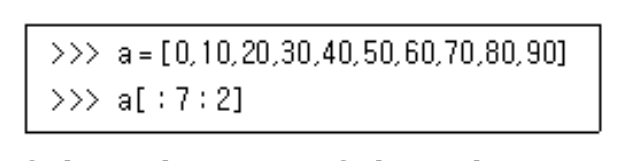
- [20, 60]
- [60, 20]
- [0, 20, 40, 60]
- [10, 30, 50, 70]
정답과 해설 보기
정답: 3
정답은 ③이다. Python의 a[start:stop:step] 슬라이스는 start에서 시작하여 stop 직전까지 step 간격의 원소를 선택한다. a[:7:2]는 시작 인덱스를 생략하여 0부터 시작하고, 인덱스 7은 포함하지 않으며, 2칸씩 이동한다. 따라서 선택하는 인덱스는 0, 2, 4, 6이고 대응하는 값은 0, 20, 40, 60이다. 슬라이스의 숫자는 원소의 값이 아니라 위치를 지정하며, step이 양수이므로 뒤에서 앞으로 읽는 역순 결과도 아니다.
선지별 해설
- 시작 인덱스 0과 중간 인덱스 4의 값을 빠뜨렸다.
- 양의 간격을 역방향으로 잘못 해석한 결과이다.
- 인덱스 0, 2, 4, 6의 값을 순서대로 선택한 결과이다.
- 시작 인덱스를 1로 잘못 해석하고 끝 경계도 다르게 적용했다.
편집 해설 근거: Python 3.14, Built-in Types — Common Sequence Operations — s[i:j:k]
69. 소프트웨어 재사용의 범위를 함수·객체, 컴포넌트, 응용 전체의 크기로 나누는 분류에서 범위 단계에 해당하지 않는 것은?
[학습용 개정문항]
- 컴포넌트 재사용
- 더미코드 재사용
- 함수와 객체 재사용
- 애플리케이션 재사용
정답과 해설 보기
정답: 2
정답은 ②이다. 소프트웨어 재사용은 이미 만들어진 자산을 새 개발에 활용하는 것으로 함수나 객체, 더 큰 컴포넌트, 완성된 응용 수준에서 논의할 수 있다. 범위가 커질수록 얻는 기능도 커질 수 있지만 요구 적합성, 인터페이스, 배포 조건과 같은 검토가 필요하다. 더미 코드는 실제 기능을 대신하는 임시 구현을 뜻할 수 있으나 이 문항의 재사용 크기별 분류에 대응하는 단계는 아니다. 더미 코드가 어떤 상황에서도 재사용될 수 없다는 뜻으로 해석해서는 안 된다.
선지별 해설
- 인터페이스를 가진 기능 단위의 재사용 범위를 나타낸다.
- 임시 구현의 성격을 가리키며 제시한 크기·범위별 분류의 단계가 아니다.
- 작은 함수나 객체 수준의 재사용 범위를 나타낸다.
- 기존 응용 전체나 그 변형을 활용하는 큰 범위의 재사용을 나타낸다.
편집 해설 근거: 교육부, NCS 학습모듈 애플리케이션 설계 LM2001020221_16v4 (2018), 목원대학교 제공본 — 인쇄 p.4, 표 1-1 재사용 규모에 따른 분류
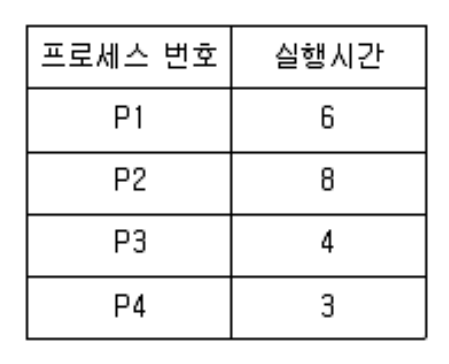
70. 이미지의 네 프로세스 P1(6), P2(8), P3(4), P4(3)가 모두 시각 0에 준비되어 있다. 괄호는 CPU 실행 시간이며 비선점 SJF로 가장 먼저 실행할 프로세스는?
[학습용 개정문항]
- P1
- P2
- P3
- P4
정답과 해설 보기
정답: 4
정답은 ④이다. SJF는 준비된 작업 중 예상 CPU 실행 시간이 가장 짧은 작업을 먼저 선택한다. 네 작업이 모두 준비되어 있고 실행 시간이 각각 P1=6, P2=8, P3=4, P4=3이라면 가장 짧은 작업은 P4이다. 이후 남은 작업의 길이를 비교하면 P3, P1, P2 순서가 된다. 도착 시각이 서로 다르면 그때 준비된 작업만 비교해야 하므로 실행 시간 표만으로 같은 순서를 항상 결론 낼 수는 없다. 여기서는 모든 작업이 동시에 준비되어 있다는 조건을 명시했다.
선지별 해설
- 실행 시간 6으로 P3와 P4보다 길다.
- 실행 시간 8로 네 작업 중 가장 길다.
- 실행 시간 4로 P4의 3보다 길다.
- 실행 시간 3으로 준비된 네 작업 중 가장 짧다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 7 Scheduling: Introduction — §7.4 Shortest Job First (SJF)
71. 처음에 모두 비어 있는 페이지 프레임 3개에서 이미지의 참조열 [1, 2, 3, 1, 2, 4, 5, 1]에 FIFO 페이지 교체를 적용할 때 페이지 결함 횟수는?
[학습용 개정문항]
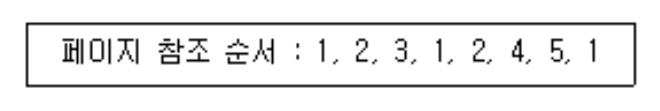
- 6회
- 7회
- 8회
- 9회
정답과 해설 보기
정답: 1
정답은 ①이다. 빈 프레임 세 개에서 1, 2, 3을 처음 참조하면 각각 결함이 발생하여 프레임을 채운다. 이어지는 1, 2는 이미 메모리에 있으므로 적중한다. FIFO는 적중했다고 적재 순서를 바꾸지 않으므로 다음 4를 넣을 때 가장 먼저 들어온 1을 제거한다. 다음 5에서는 2를 제거하고, 마지막 1에서는 3을 제거한다. 결함이 난 참조는 첫 세 번과 마지막 세 번으로 합계 6회이다. 프레임 수와 초기 상태가 달라지면 결과도 달라지므로 조건을 함께 읽어야 한다.
선지별 해설
- 1·2·3의 최초 적재와 4·5·1의 교체에서 총 6회 발생한다.
- 이미 적재된 1 또는 2의 적중을 추가 결함으로 센 값이다.
- 두 적중을 모두 결함으로 잘못 세어 참조 횟수와 같게 만든 값이다.
- 참조 자체가 8회이므로 이 조건에서 9회의 결함은 나올 수 없다.
편집 해설 근거: Arpaci-Dusseau & Arpaci-Dusseau, OSTEP Chapter 22 Beyond Physical Memory: Policies — §22.3 A Simple Policy: FIFO
72. 한 프레임을 보낸 뒤 그 프레임의 확인 응답을 기다리고, 확인 후 다음 프레임으로 진행하며 필요하면 재전송하는 ARQ 방식은?
[학습용 개정문항]
- Slow Start
- Sliding Window
- Stop and Wait
- Congestion Avoidance
정답과 해설 보기
정답: 3
정답은 ③이다. Stop-and-Wait는 한 프레임을 보낸 뒤 그 프레임의 확인 응답을 기다리고, 확인되면 다음 프레임으로 진행하는 방식이다. 손실이나 오류를 판단하면 같은 프레임을 재전송한다. 여러 프레임을 미리 보내 두는 슬라이딩 윈도 방식에 비해 단순하지만 전파 지연이 긴 링크에서는 대기 시간이 커질 수 있다. TCP 자체는 슬라이딩 윈도를 사용하는 프로토콜이므로 Stop-and-Wait를 TCP의 일반적인 흐름 제어 방식으로 설명하면 부정확하다. Slow Start와 Congestion Avoidance는 TCP 혼잡 제어와 관련된다.
선지별 해설
- TCP가 혼잡 윈도를 증가시키는 혼잡 제어 단계이다.
- 일정한 윈도 범위 안에서 여러 데이터를 확인 응답 전에 보낼 수 있는 방식이다.
- 한 프레임을 보내고 그 확인 응답을 기다리는 방식이다.
- 네트워크 혼잡을 피하도록 전송량을 조절하는 TCP 혼잡 제어 단계이다.
편집 해설 근거: IETF RFC 3366, Advice to Link Designers on Link ARQ — §1.4.1 Stop-And-Wait ARQ; §1.4.2 Sliding-Window ARQ
73. 자료·스탬프·제어·공통·내용 결합을 구별하는 전통적 모듈 결합도 분류에서 틀린 설명은?
[학습용 개정문항]
- 구조체 전체를 인수로 전달하고 일부 필드만 이용하는 상황을 자료 결합으로 분류한다.
- 한 모듈이 다른 모듈 내부의 변수나 구현을 직접 참조하면 내용 결합에 해당한다.
- 두 모듈이 같은 전역 데이터 영역을 참조하면 공통 결합에 해당한다.
- 결합도는 모듈 사이의 상호작용과 의존 정도를 나타낸다.
정답과 해설 보기
정답: 1
정답은 ①이다. 제시한 전통적 결합도 분류에서는 필요한 단순 데이터만 매개변수로 주고받는 경우를 자료 결합으로, 구조체나 객체 같은 복합 자료구조를 인터페이스로 전달하는 경우를 스탬프 결합으로 구별한다. 그러므로 복합 구조 전체를 넘기고 일부 필드만 사용하는 상황을 자료 결합이라고 부르는 보기는 이 분류와 맞지 않는다. 다른 모듈 내부를 직접 참조·변경하는 것은 내용 결합이고 전역 데이터 영역을 함께 사용하는 것은 공통 결합이다. 실제 언어 설계의 장단점은 자료형 이름 하나만으로 확정하지 않는다.
선지별 해설
- 이 분류에서는 복합 자료구조를 전달하는 스탬프 결합으로 구별하는 상황이다.
- 다른 모듈의 내부 구현에 직접 의존하는 내용 결합의 설명이다.
- 공유된 전역 데이터에 의존하는 공통 결합의 설명이다.
- 결합도는 모듈 간 상호 의존의 정도를 나타낸다.
편집 해설 근거: 교육부, NCS 학습모듈 애플리케이션 설계 LM2001020221_16v4 (2018), 목원대학교 제공본 — 인쇄 p.14, 표 1-7 결합도의 유형 및 설명 — 자료·스탬프·공통·내용
74. 응집도의 종류 중 서로 간에 어떠한 의미 있는 연관관계도 지니지 않은 기능 요소로 구성되는 경우이며, 서로 다른 상 위 모듈에 의해 호출되어 처리상의 연관성이 없는 서로 다 른 기능을 수행하는 경우의 응집도는?
- Functional Cohesion
- Sequential Cohesion
- Logical Cohesion
- Coincidental Cohesion
정답과 해설 보기
정답: 4
정답은 ④이다. 우연적 응집은 한 모듈 안의 작업들이 의미 있는 기능적 관계 없이 모여 있는 상태를 가리킨다. 여러 곳에서 호출된다는 사실 자체가 응집도를 낮추는 것은 아니고, 묶인 작업들 사이에 공통된 목적이나 데이터 흐름이 없다는 점이 핵심이다. 기능적 응집은 한 가지 명확한 기능을 함께 수행하는 경우이고, 순차적 응집은 앞 작업의 결과가 뒤 작업의 입력이 되는 경우이다. 논리적 응집은 입력·출력 같은 유사한 종류의 작업을 논리적으로 한데 묶는 경우와 관련된다.
선지별 해설
- 관련 요소들이 하나의 명확한 기능을 수행하도록 모인 상태이다.
- 앞 작업의 결과가 다음 작업의 입력으로 이어지는 관계이다.
- 논리적으로 같은 종류의 작업을 묶은 상태이다.
- 작업들 사이에 기능적 연관성이 없는 우연적 묶음이다.
편집 해설 근거: ISO/IEC/IEEE 24765:2017, Systems and software engineering — Vocabulary, NASA 제공본 — §3.625 cohesion; §3.626 coincidental cohesion
75. Java의 일반 클래스 멤버에 적용하는 접근 제어 수준 또는 제한자에 해당하지 않는 것은?
[학습용 개정문항]
- internal
- private
- package access (접근 제한자 생략)
- public
정답과 해설 보기
정답: 1
정답은 ①이다. Java의 접근 제어에는 public, protected, private와 접근 제한자를 생략했을 때의 package access가 있다. internal은 Java의 접근 제한자나 접근 수준 명칭이 아니다. 클래스의 일반 멤버에서 제한자를 생략한 패키지 접근을 관용적으로 default 접근이라고 부르기도 하지만, 이를 default라는 접근 제한자 키워드를 써서 선언하지는 않는다. 인터페이스 멤버 등은 생략 시 규칙이 다를 수 있으므로 모든 선언이 항상 패키지 접근이 된다고 일반화해서도 안 된다.
선지별 해설
- Java의 접근 제어 수준 또는 제한자 명칭에 해당하지 않는다.
- 선언을 둘러싼 최상위 클래스·인터페이스의 내부 범위에서 접근을 제한하는 수준이다.
- 클래스의 일반 멤버에서 접근 제한자를 생략할 때 적용되는 패키지 접근이다.
- 접근 대상 타입과 모듈 등의 조건을 만족하는 곳에서 공개 접근을 허용한다.
편집 해설 근거: Oracle Java SE 17 Language Specification, Names — §6.6 Access Control; §6.6.1 Determining Accessibility
76. UDP 기본 프로토콜 자체의 특성으로 옳은 것은?
[학습용 개정문항]
- 각 데이터그램마다 반드시 ACK를 받는다.
- 연결 상태를 유지하며 데이터 전달의 신뢰성을 보장한다.
- 데이터그램의 순서 보장·재전송·흐름 제어를 자체적으로 제공하지 않는다.
- 복잡한 확인 응답과 재전송 제어를 기본 기능으로 수행한다.
정답과 해설 보기
정답: 3
정답은 ③이다. UDP는 데이터그램 전달을 위한 단순한 전송 프로토콜로, 기본 프로토콜 자체에 확인 응답과 재전송, 수신 순서 복원, 흐름 제어를 제공하지 않는다. 필요한 신뢰성은 사용하는 응용이나 상위 프로토콜이 구현할 수 있다. UDP의 체크섬은 손상 검출과 관련되며 손상된 데이터를 복구하는 재전송 기능과 같지 않다. 절차가 단순하다는 점을 모든 환경에서 TCP보다 빠르다는 보장으로 바꾸면 안 된다. 실제 지연과 처리량은 응용 설계와 네트워크 조건에 따라 달라진다.
선지별 해설
- UDP 자체에는 각 데이터그램에 대한 확인 응답 절차가 없다.
- 연결을 유지하여 신뢰성을 보장하는 전송 방식으로 정의되지 않는다.
- 순서 보장·재전송·흐름 제어를 기본 기능으로 제공하지 않는다.
- 기본 헤더와 절차가 단순하므로 복잡한 신뢰성 제어를 자체적으로 수행한다는 설명은 맞지 않는다.
편집 해설 근거: IETF RFC 768, User Datagram Protocol (1980) — Introduction; User Interface
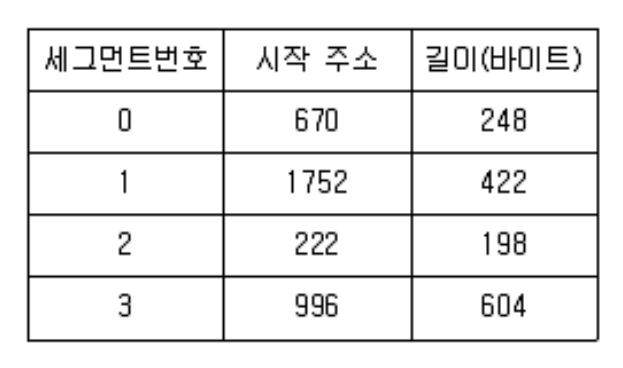
77. 이미지의 세그먼트 표에서 논리주소 (2,176)의 물리주소는?
- 398
- 400
- 1928
- 1930
정답과 해설 보기
정답: 1
정답은 ①이다. 세그먼트 방식의 논리주소는 세그먼트 번호와 그 세그먼트 안의 변위로 구성된다. 번호 2의 베이스 주소는 222이고 길이는 198이므로 변위 176은 0 이상 198 미만의 유효한 범위에 들어간다. 물리주소는 베이스에 변위를 더한 222+176=398이다. 다른 세그먼트의 베이스를 가져오거나 길이를 주소에 더하면 안 된다. 변위가 길이 이상이라면 베이스에 더해 접근하는 것이 아니라 범위 오류로 처리해야 한다.
선지별 해설
- 세그먼트 2의 베이스 222에 유효한 변위 176을 더한 값이다.
- 베이스와 변위의 합을 잘못 계산한 값이다.
- 다른 세그먼트의 베이스 1752에 변위를 더한 값이다.
- 다른 세그먼트의 베이스 사용과 합산 오류가 겹친 값이다.
편집 해설 근거: Arpaci-Dusseau, OSTEP v1.10, 16 Segmentation — §16.1 Segmentation: Generalized Base/Bounds
78. IPv4를 사용하는 Ethernet 링크에서 다음 홉의 IPv4 주소에 대응하는 MAC 주소를 알아내는 데 쓰는 프로토콜은?
[학습용 개정문항]
- TCP
- ARP
- FTP
- IP
정답과 해설 보기
정답: 2
정답은 ②이다. ARP는 같은 링크에서 IPv4 주소에 대응하는 링크 계층 주소를 알아내는 데 사용하는 주소 해석 프로토콜이다. Ethernet 환경에서는 보통 MAC 주소를 알아내 프레임을 보낼 수 있게 한다. 목적지가 다른 네트워크에 있으면 원격 목적지의 MAC 주소를 인터넷 전체에서 찾는 것이 아니라 해당 링크의 다음 홉, 예를 들어 게이트웨이의 주소를 해석한다. IPv6에서는 ARP 대신 Neighbor Discovery를 사용하므로 모든 IP 버전의 주소 변환을 ARP라고 일반화하지 않아야 한다.
선지별 해설
- 종단 간 신뢰성 있는 바이트 스트림 전송 프로토콜이다.
- 같은 IPv4 링크에서 프로토콜 주소에 대응하는 링크 계층 주소를 해석한다.
- 파일 전송을 위한 응용 프로토콜이다.
- 패킷 주소 지정과 전달을 담당하지만 이 주소 해석 요청의 명칭은 아니다.
편집 해설 근거: IETF RFC 826, Ethernet Address Resolution Protocol (1982) — Abstract; Packet Generation; Packet Reception
79. C언어에서 구조체를 사용하여 데이터를 처리할 때 사용하는 것은?
- for
- scanf
- struct
- abstract
정답과 해설 보기
정답: 3
정답은 ③이다. C에서 struct는 서로 다른 자료형의 멤버를 하나의 구조체 형식으로 묶어 선언하는 데 사용하는 키워드이다. 예를 들어 학생 번호와 점수를 하나의 학생 자료형으로 구성할 수 있다. 구조체 변수의 멤버에는 점 연산자로, 구조체를 가리키는 포인터의 멤버에는 화살표 연산자로 접근한다. for는 반복문을 구성하는 키워드이고 scanf는 서식 있는 입력을 수행하는 표준 라이브러리 함수이다. abstract는 C 언어의 구조체 선언 키워드가 아니다.
선지별 해설
- 반복문을 구성하는 제어문 키워드이다.
- 서식 있는 입력을 수행하는 표준 라이브러리 함수 이름이다.
- 구조체 형식을 정의하거나 나타내는 키워드이다.
- C 언어의 구조체 선언 키워드가 아니다.
편집 해설 근거: ISO/IEC JTC1/SC22/WG14, C11 committee draft N1570 (2011-04-12) — §6.7.2.1 Structure and union specifiers; §6.5.2.3 Structure and union members
80. PHP에서 연산자가 아닌 표기는?
[학습용 개정문항]
- @
- #
- <>
- ===
정답과 해설 보기
정답: 2
정답은 ②이다. PHP에서 @는 표현식의 진단 메시지 처리를 조절하는 오류 제어 연산자이고, <>는 값이 같지 않은지 비교하는 연산자이며, ===는 값과 타입이 모두 같은지 비교하는 연산자이다. #은 일반적인 한 줄 주석을 시작하는 표기로 쓰이며 계산이나 비교 연산자가 아니다. PHP 8에서는 #[가 속성(attribute) 문법을 시작하므로 #이 보이면 언제나 주석이라고 단정해서도 안 된다. 원문의 전각 기호를 실제 코드에 사용하는 ASCII <>로 고쳐 연산자 자체를 비교한다.
선지별 해설
- PHP가 제공하는 오류 제어 연산자이다.
- 연산자가 아니며 일반적인 한 줄 주석 표기 등에 사용된다.
- PHP에서 같지 않음을 비교하는 연산자이다.
- 값과 타입의 동일성을 비교하는 연산자이다.
편집 해설 근거: PHP Manual, Operators — Operator categories — Error Control; PHP Manual, Comparison Operators — Comparison Operators table; PHP Manual, Comments — Comments; PHP Manual, Attributes overview — Example #1 Implementing optional methods of an interface with Attributes
정보처리기사 필기 기출문제 · 정보시스템 구축관리
81. 이용자가 인터넷과 같은 공중망에 사설망을 구축하여 마치 전용망을 사용하는 효과를 가지는 보안 솔루션은?
- ZIGBEE
- KDD
- IDS
- VPN
정답과 해설 보기
정답: 4
정답은 ④이다. VPN은 기존 네트워크 위에 논리적인 사설 연결을 구성하는 기술이다. 인터넷 같은 공중망을 지나는 통신에 터널과 인증·암호화 등을 적용하여 원격 사용자나 떨어진 조직망을 연결할 수 있다. 이때 물리적으로 전용 회선을 새로 설치하는 것은 아니다. 모든 VPN이 같은 보안 기능을 갖는 것도 아니므로 사용하는 프로토콜과 설정에 따라 보호 범위를 판단해야 한다. IDS는 침입 징후를 탐지하는 기능이고 Zigbee는 근거리 무선 통신 기술이므로 사설 연결 구성이라는 설명과 다르다.
선지별 해설
- 저전력 근거리 무선 통신과 관련된 기술이다.
- 데이터에서 유용한 지식을 발견하는 과정의 약어이다.
- 침입이나 공격 징후를 탐지하는 시스템이다.
- 기존 네트워크 위에 논리적인 사설 연결을 구성하는 VPN이다.
편집 해설 근거: NIST CSRC Glossary, Virtual Private Network — Definitions — NIST SP 800-77 Rev.1; NIST SP 1800-21B
82. Software CMM v1.1의 다섯 성숙도 단계 명칭에 포함되지 않는 것은?
[학습용 개정문항]
- 최적단계
- 관리단계
- 계획단계
- 정의단계
정답과 해설 보기
정답: 3
정답은 ③이다. 고전적인 Software CMM v1.1의 성숙도 단계는 Initial, Repeatable, Defined, Managed, Optimizing의 다섯 단계이다. 따라서 최적 단계, 관리 단계, 정의 단계는 이 모델의 단계 이름에 해당하지만 계획 단계는 포함되지 않는다. 계획 수립은 여러 단계에서 수행할 수 있는 활동이며 별도의 성숙도 수준 이름과는 다르다. 후속 모델인 CMMI는 일부 단계의 이름과 구성에 차이가 있으므로 CMMI의 용어를 이 문제의 CMM v1.1에 그대로 대입하면 안 된다.
선지별 해설
- Optimizing으로 고전 CMM의 5단계이다.
- Managed로 고전 CMM의 4단계이다.
- 계획은 활동이지만 이 모델의 성숙도 단계 이름이 아니다.
- Defined로 고전 CMM의 3단계이다.
편집 해설 근거: CMU SEI, Capability Maturity Model for Software v1.1, CMU/SEI-93-TR-024 — §2 The Five Levels of Software Process Maturity; Figure 2.1
83. 요구사항 분석·설계·구현·시험 등의 단계를 구분하고, 앞 단계의 산출물을 검토한 뒤 다음 단계로 순차 진행하는 전통적인 소프트웨어 생명주기 모형은?
[학습용 개정문항]
- 패키지 모형
- 코코모 모형
- 폭포수 모형
- 관계형 모델
정답과 해설 보기
정답: 3
정답은 ③이다. 폭포수 모형은 요구사항 분석, 설계, 구현, 시험 같은 개발 활동을 단계별로 구성하고 앞 단계의 산출물을 검토한 후 다음 단계로 진행하는 선형 순차적 관점의 생명주기 모형이다. 이미 확정한 산출물을 뒤에서 크게 바꾸면 앞 단계까지 다시 검토해야 할 수 있어 변경 비용이 커질 수 있다. 그렇다고 모든 폭포수형 개발에서 피드백이 절대로 금지되는 것은 아니다. COCOMO는 비용·노력 추정 모형이고 관계형 모델은 데이터를 표현하는 모델이므로 개발 생명주기의 단계 순서와 구별된다.
선지별 해설
- 제시된 선형 순차 생명주기 모형의 일반 명칭이 아니다.
- 소프트웨어 개발 노력과 비용을 추정하는 모형이다.
- 단계의 산출물을 검토하며 순차적으로 진행하는 폭포수 모형이다.
- 테이블과 관계 연산 등으로 데이터를 표현하는 모델이다.
편집 해설 근거: Connell·Wenneson, NASA CR-177625 Software Engineering Guidebook (1993) — §3.3.2 Concurrent Engineering
84. The Open Group SOA Reference Architecture에서 사용하는 계층 명칭이 아닌 것은?
[학습용 개정문항]
- Consumer Layer
- Business Process Layer
- Control Class Layer
- Services Layer
정답과 해설 보기
정답: 3
정답은 ③이다. The Open Group의 SOA 참조 아키텍처에서는 서비스를 호출하는 Consumer Layer, 업무 흐름을 구성하는 Business Process Layer, 서비스를 제공하는 Services Layer 등을 구별한다. 업무 프로세스 계층은 서비스들을 조합하여 업무 목적에 맞는 흐름을 만들고 소비자 계층은 이를 호출하거나 실행을 유발할 수 있다. Control Class Layer는 이 참조 아키텍처의 계층 명칭이 아니다. 다른 설계에서 제어 클래스나 컨트롤러를 사용할 수 있다는 사실과 특정 참조 모델의 계층 이름에 포함되는지는 별개이다.
선지별 해설
- 서비스나 업무 프로세스를 이용하는 소비자 역할의 계층이다.
- 업무 흐름과 서비스 조합을 다루는 계층이다.
- 이 SOA 참조 아키텍처의 계층 명칭에 해당하지 않는다.
- 서비스를 노출하고 제공하는 계층이다.
편집 해설 근거: The Open Group, SOA Reference Architecture — Business Process Layer — Overview; Interaction with Horizontal Layers
85. 이미지의 설명에 해당하는 스토리지 연결 방식은?
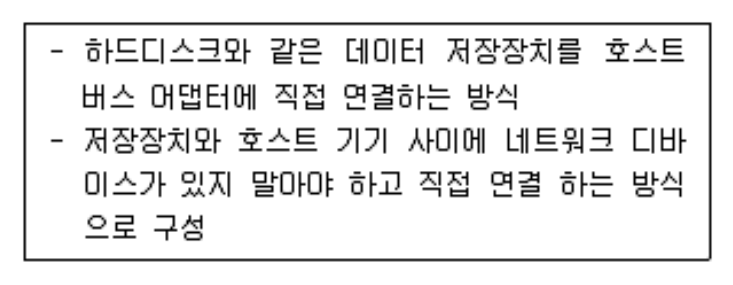
- DAS
- NAS
- N-SCREEN
- NFC
정답과 해설 보기
정답: 1
정답은 ①이다. DAS는 저장 장치를 사용하는 호스트에 직접 연결하는 저장 구성이다. 이미지의 호스트 버스 어댑터와 저장 장치의 직접 연결이라는 설명이 이에 해당한다. NAS는 네트워크를 통해 파일 접근 서비스를 제공하는 저장 시스템으로 연결과 서비스 방식에 차이가 있다. DAS를 반드시 컴퓨터 케이스 내부의 디스크만으로 한정할 필요는 없으며 외부 직접 연결 장치도 가능하다. N-SCREEN은 여러 화면에서의 콘텐츠 이용과 관련된 용어이고 NFC는 가까운 거리의 무선 통신 기술이다.
선지별 해설
- 호스트와 저장 장치의 직접 연결을 뜻한다.
- 네트워크를 통해 파일 서비스를 제공하는 저장 구성이므로 직접 연결 설명과 다르다.
- 여러 화면이나 기기에서 콘텐츠를 이용하는 개념이다.
- 가까운 거리에서 사용하는 무선 통신 기술이다.
편집 해설 근거: SNIA Dictionary v2015.1, Direct Attached Storage — 인쇄 p.72 Direct Attached Storage; p.186 Network Attached Storage
86. 프레임워크 도입 시 기대하는 장점보다 관리해야 할 위험에 해당하는 것은?
[학습용 개정문항]
- 공통 기능 재사용에 따른 중복 개발 비용 감소 가능성
- 특정 공급자나 기술에 대한 의존도 증가
- 표준화된 인터페이스 활용에 따른 상호운용성 향상 가능성
- 일관된 구조와 개발 규칙에 따른 유지보수 용이성
정답과 해설 보기
정답: 2
정답은 ②이다. 프레임워크를 적절히 선택하면 공통 기능과 구조를 재사용하여 중복 개발을 줄이고 일관된 인터페이스와 개발 규칙을 적용하는 데 도움이 된다. 그러나 특정 공급자나 기술에 강하게 종속되면 교체와 유지보수 비용이 늘 수 있다. 이런 의존도 증가는 기대하는 장점이 아니라 도입 시 평가해야 할 위험이다. 모든 프레임워크가 자동으로 비용 절감이나 상호운용성을 보장하는 것은 아니므로 요구 적합성, 확장 지점, 기술 수명, 전환 비용 등을 함께 검토해야 한다.
선지별 해설
- 공통 기능을 재사용하여 기대할 수 있는 효과이다.
- 공급자·기술 종속은 평가하고 관리해야 할 위험이다.
- 호환되는 표준과 인터페이스를 사용할 때 기대할 수 있는 효과이다.
- 일관된 구조와 확장 규칙은 유지보수에 도움이 될 수 있다.
편집 해설 근거: Douglas C. Schmidt, Object-Oriented Patterns & Frameworks — pp. 28–30 Benefits of Frameworks; p. 31 Limitations of Frameworks
87. 활동과 데이터를 상자와 화살표로 표현하고 하향식으로 세분화하는 Structured Analysis and Design Technique의 약어는?
[학습용 개정문항]
- SREM
- PSL/PSA
- HIPO
- SADT
정답과 해설 보기
정답: 4
정답은 ④이다. SADT는 Structured Analysis and Design Technique의 약어로, 시스템의 활동과 데이터를 상자 및 화살표로 표현하고 더 상세한 수준으로 분해하여 이해하는 구조적 분석·설계 기법이다. 활동 상자는 입력과 출력, 제어 조건 등을 연결해 기능의 관계를 나타낼 수 있다. 이를 지원하는 도구를 사용할 수 있지만 SADT라는 기법 자체와 특정 자동화 제품을 동일시하면 안 된다. HIPO는 계층과 입력·처리·출력 문서화에 초점을 둔 다른 표현 기법이며 나머지 보기들도 같은 약어를 뜻하지 않는다.
선지별 해설
- Software Requirements Engineering Methodology의 약어로 제시한 SADT 기법의 명칭이 아니다.
- Problem Statement Language/Problem Statement Analyzer 계열의 명칭이다.
- Hierarchy plus Input-Process-Output 문서화 기법이다.
- 구조적 분석·설계에서 상자와 화살표 및 계층적 분해를 사용하는 SADT이다.
편집 해설 근거: John Mylopoulos, CSC2507 Structured Analysis and Design Technique (2004) — 슬라이드 2–4 SADT, Notation, Primitives; 슬라이드 9 The SADT Process
88. 익스트림 프로그래밍 (eXtreme Programming)의 5가지 가 치에 속하지 않는 것은?
- 의사소통
- 단순성
- 피드백
- 고객 배제
정답과 해설 보기
정답: 4
정답은 ④이다. XP의 다섯 가치는 의사소통, 단순성, 피드백, 용기, 존중이다. 고객과 개발자가 요구와 결과를 자주 확인하는 협업은 빠른 피드백과 이해 공유를 돕는다. 고객을 배제하면 무엇이 필요한지 검증할 기회가 줄어들므로 XP의 가치에 포함되지 않는다. 초기 문헌에서는 네 가치로 설명되기도 했고 이후 존중을 포함한 다섯 가치가 널리 제시되므로 버전에 따른 차이를 알아 두면 된다. 이 문항은 명시된 다섯 가치 체계를 기준으로 판단한다.
선지별 해설
- 요구와 문제를 팀 안에서 공유하는 XP의 가치이다.
- 현재 필요한 해결책을 단순하게 유지하려는 가치이다.
- 시험과 고객 반응 등을 통해 빠르게 학습하려는 가치이다.
- 고객 협업과 피드백을 약화시키는 방향으로 XP의 가치가 아니다.
편집 해설 근거: Ron Jeffries, What is Extreme Programming? (2011) — Values — Communication, Simplicity, Feedback, Courage, Respect
89. 중앙 보안 정책을 시스템이 강제하며, 전통적인 보안등급 모델에서는 객체의 보안 레이블과 주체의 인가 등급에 따라 접근을 결정하여 개별 소유자의 임의 권한 변경을 제한하는 방식은?
[학습용 개정문항]
- NAC
- MAC
- SDAC
- AAC
정답과 해설 보기
정답: 2
정답은 ②이다. MAC은 중앙에서 정한 강제 접근통제 정책을 시스템이 적용하고 개별 객체 소유자가 임의로 권한을 바꾸어 우회할 수 없도록 하는 방식이다. 전통적인 다중 보안등급 모델에서는 정보의 보안 레이블과 사용자의 인가 등급을 비교해 접근을 결정한다. DAC에서는 소유자가 허용 범위를 정하는 재량이 있고, RBAC는 역할을 통해 권한을 연결하는 데 초점을 둔다. 실제 MAC 구현에는 타입 강제 등 여러 정책이 있으므로 보안등급 비교만이 MAC의 유일한 구현이라고 설명해서는 안 된다.
선지별 해설
- 네트워크 접속을 통제하는 기술 범주로 이 강제 접근통제 모델의 약어가 아니다.
- 중앙 정책을 강제하며 소유자의 임의 변경을 제한하는 Mandatory Access Control이다.
- 이 문항에서 정의한 강제 접근통제의 약어가 아니다.
- 이 문항에서 정의한 강제 접근통제의 약어가 아니다.
편집 해설 근거: NIST CSRC Glossary, Mandatory Access Control — Definitions — NIST SP 800-192; NIST SP 800-44 v2
90. 나선형 모형의 한 주기를 다음 활동으로 요약할 때 올바른 순서는? A: 목표·대안·제약 확인, B: 결과 검토와 다음 주기 계획, C: 산출물 개발·검증, D: 대안 평가와 위험 분석·해소.
[학습용 개정문항]
- A → B → D → C
- A → D → C → B
- A → B → C → D
- A → C → B → D
정답과 해설 보기
정답: 2
정답은 ②이다. 나선형 모형은 각 주기에서 목표와 대안 및 제약을 확인한 뒤 주요 위험을 평가하고 해소할 방법을 찾는다. 그 결과에 따라 다음 수준의 산출물을 개발·검증하고, 이해관계자 검토와 다음 주기 계획으로 이어 간다. 제시된 기호에 대응시키면 A→D→C→B이다. 위험 분석을 개발이 모두 끝난 뒤의 형식적 점검으로 미루는 흐름과는 다르다. 실제로는 위험의 성격에 따라 프로토타이핑 등 활동을 선택하며 모든 주기가 동일한 규모의 구현을 반복하는 것은 아니다.
선지별 해설
- 산출물 개발 전에 결과 검토를 놓고 위험 분석의 위치도 맞지 않다.
- 목표·대안·제약 확인, 위험 분석, 개발·검증, 검토·다음 계획 순서이다.
- 위험 분석을 개발과 검토 뒤로 미룬 순서이다.
- 위험 분석보다 개발을 먼저 수행하는 순서이다.
편집 해설 근거: Barry W. Boehm, A Spiral Model of Software Development and Enhancement (1988), 논문 보존 사본 — Figure 2; A typical cycle of the spiral
91. 다음 중 소프트웨어 규모·노력·비용 산정에 활용하는 모형이나 크기 측정법과 달리, 활동의 선후 관계와 소요 시간을 바탕으로 프로젝트 일정을 분석하는 네트워크 기법은?
[학습용 개정문항]
- COCOMO
- Putnam
- Function-Point
- PERT
정답과 해설 보기
정답: 4
정답은 ④이다. PERT는 활동 사이의 선후 관계와 소요 시간의 불확실성을 이용하여 프로젝트 일정을 계획하고 분석하는 네트워크 기법이다. COCOMO와 Putnam 모형은 소프트웨어 규모와 생산성·환경 등의 관계를 이용해 노력과 기간 등을 추정하는 데 쓰인다. 기능점수는 사용자에게 제공하는 기능의 크기를 측정하며 생산성 자료와 결합해 노력·비용 산정의 입력으로 활용할 수 있다. 기능점수 자체가 비용 금액을 자동 산출하는 모형은 아니고, PERT에도 비용 관리가 결합될 수 있으므로 각 기법의 주된 목적을 구별한다.
선지별 해설
- 소프트웨어 규모와 비용 요인 등을 이용하는 노력 추정 모형이다.
- 규모·노력·기간의 관계를 이용하는 소프트웨어 추정 모형이다.
- 기능 규모를 측정하여 노력·비용 산정의 입력으로 활용할 수 있다.
- 활동 간 선후 관계와 시간 추정을 이용하는 일정 네트워크 기법이다.
편집 해설 근거: R. G. Batson, NASA TM-100311 Program Risk Analysis Handbook (1987) — E. Analytical Technique for Schedule Risk Assessment — PERT and activity precedence networks; IEEE Computer Society, SWEBOK Guide V4.0a — Software Engineering Management §2.3 Effort, Schedule, and Cost Estimation
92. 일반적인 공개키 암호화 방식에 대한 설명으로 잘못된 것은?
[학습용 개정문항]
- 수신자의 공개키로 암호화한 메시지는 같은 공개키로 복호화해야 한다.
- 공개키와 개인키를 구별하므로 비대칭 암호 방식이라고도 한다.
- RSA 기반 암호화가 대표적인 예이다.
- 공개키는 배포할 수 있지만 개인키는 비밀로 보호해야 한다.
정답과 해설 보기
정답: 1
정답은 ①이다. 공개키 암호화에서는 수신자의 공개키로 암호화한 데이터를 그에 대응하는 수신자의 개인키로 복호화한다. 공개키와 개인키가 서로 다른 역할을 하므로 비대칭 암호라고도 부른다. RSA는 이런 공개키 체계를 구현하는 대표적인 알고리즘 계열이며 실제 암호화에는 적절한 인코딩·패딩 방식까지 필요하다. 공개키는 공유할 수 있지만 그 키가 의도한 상대의 것인지 인증해야 하고 개인키는 비밀로 보호해야 한다. 전자서명에서 개인키로 서명하고 공개키로 검증하는 동작을 암호화·복호화와 혼동하면 안 된다.
선지별 해설
- 공개키로 암호화한 데이터의 복호화에는 대응하는 개인키를 사용한다.
- 서로 다른 공개키와 개인키를 사용하므로 비대칭 방식이다.
- RSA는 공개키 암호 체계의 대표적인 예이다.
- 공개키 배포와 개인키 비밀 보호를 구분하는 올바른 설명이다.
편집 해설 근거: IETF RFC 8017, PKCS #1: RSA Cryptography Specifications Version 2.2 (2016) — §3 Key Types; §7 Encryption Schemes
93. 서로 다른 파장의 광 신호를 결합해 하나의 광섬유로 전송하고 수신 측에서 파장별로 분리하는 광통신 기술의 통상적인 명칭은?
[학습용 개정문항]
- Wavelength Division Multiplexing
- Frequency Division Multiplexing
- Code Division Multiplexing
- Time Division Multiplexing
정답과 해설 보기
정답: 1
정답은 ①이다. 광통신에서 서로 다른 파장의 광 신호를 하나의 광섬유에 결합하여 보내고 수신 측에서 파장별로 분리하는 기술은 WDM, 파장 분할 다중화이다. 파장은 빛의 주파수와 대응하므로 원리상 주파수 분할과 관련되지만 광 파장을 기준으로 채널을 구별하는 이 기술의 통상 명칭은 WDM이다. TDM은 시간 구간을 나누고 CDM은 코드로 채널을 구별한다. 서로 다른 파장을 쓴다는 사실만으로 물리적 간섭이나 누화가 무조건 사라지는 것은 아니며 실제 광학 설계와 성능 관리가 필요하다.
선지별 해설
- 서로 다른 광 파장을 같은 광섬유로 전송하는 기술의 통상 명칭이다.
- 주파수 대역을 구분하는 일반 원리와 관련되지만 질문이 특정한 광통신 명칭은 WDM이다.
- 서로 다른 코드로 신호를 구별하는 방식이다.
- 각 신호에 다른 시간 구간을 배정하는 방식이다.
편집 해설 근거: Cisco ONS 15454 DWDM Engineering and Planning Guide, DWDM Overview — §1.2 Wavelength Division Multiplexing Versus Dense Wavelength Division Multiplexing
94. 웹페이지에 악의적인 스크립트를 포함시켜 사용자 측에서 실행되게 유도함으로써, 정보유출 등의 공격을 유발할 수 있는 취약점은?
- Ransomware
- Pharming
- Phishing
- XSS
정답과 해설 보기
정답: 4
정답은 ④이다. XSS는 신뢰할 수 없는 입력이 웹 콘텐츠에 안전하지 않게 포함되어 사용자 브라우저에서 원하지 않는 스크립트로 실행되는 취약점이다. 공격자는 페이지의 내용을 바꾸거나 사용자가 접근할 수 있는 정보와 기능을 악용할 수 있다. 입력이 HTML 본문, 속성, URL, JavaScript 중 어디에 들어가는지에 따라 적절한 출력 인코딩이 달라지며, 허용한 HTML에는 안전한 정제가 필요하다. 랜섬웨어는 데이터 암호화 등을 이용한 금전 요구이고 피싱과 파밍은 사용자를 속여 잘못된 대상으로 유도하는 공격과 관련된다.
선지별 해설
- 데이터 접근을 막거나 암호화하여 금전을 요구하는 악성 행위이다.
- 이름 해석 등 경로를 조작해 사용자를 가짜 사이트로 유도하는 공격이다.
- 신뢰할 만한 대상을 사칭하여 정보 제공이나 행동을 유도하는 공격이다.
- 웹 콘텐츠에 포함된 악성 스크립트가 사용자 브라우저에서 실행되는 취약점이다.
편집 해설 근거: OWASP, Cross Site Scripting (XSS), Overview — Description; OWASP, Cross Site Scripting Prevention Cheat Sheet — Output Encoding; HTML Sanitization
95. 컴포넌트 기반 개발(CBD)에 대한 설명으로 잘못된 것은?
[학습용 개정문항]
- 적합한 기존 컴포넌트를 활용해 개발 기간을 줄일 수 있다.
- 명확한 인터페이스를 통해 기능의 교체·확장을 지원할 수 있다.
- 소프트웨어 컴포넌트를 조합하고 재사용할 수 있다.
- 컴포넌트를 재사용하면 인터페이스 호환성 검토와 통합 시험을 생략해도 된다.
정답과 해설 보기
정답: 4
정답은 ④이다. CBD는 명확한 인터페이스와 의존관계를 가진 컴포넌트를 조합하여 소프트웨어를 구성하는 개발 접근이다. 적합한 컴포넌트를 재사용하면 구현할 범위를 줄이고 교체·확장을 쉽게 할 수 있지만 그 효과가 자동으로 보장되지는 않는다. 인터페이스의 형식뿐 아니라 데이터 의미, 실행 환경, 버전, 품질 요구와 의존성도 서로 맞아야 한다. 따라서 컴포넌트만 가져오면 호환성과 통합 검증을 생략해도 된다는 설명은 틀리다. 재사용은 검증 작업을 없애는 것이 아니라 검토할 대상을 바꾼다.
선지별 해설
- 적합한 컴포넌트를 재사용하면 개발할 범위를 줄일 수 있다.
- 잘 정의된 인터페이스는 교체와 확장을 지원할 수 있다.
- 기존 자산의 조합과 재사용은 CBD의 핵심 목적이다.
- 컴포넌트 간 호환성과 통합 동작은 반드시 검토해야 한다.
편집 해설 근거: IEEE Computer Society, SWEBOK Guide V4.0a — Software Design §5.6 Component-Based Design (CBD)
96. 소프트웨어 정의 데이터센터(SDDC)의 개념과 지향점에 대한 설명으로 잘못된 것은?
[학습용 개정문항]
- 컴퓨팅·스토리지·네트워크 자원을 소프트웨어로 통합 관리한다.
- 정책을 바탕으로 자원 할당과 관리 절차를 자동화할 수 있다.
- 자원을 추상화하고 풀로 구성하여 필요한 서비스를 제공한다.
- 특정 물리 하드웨어에 대한 종속을 더 강하게 만드는 것이 핵심 목표이다.
정답과 해설 보기
정답: 4
정답은 ④이다. SDDC는 컴퓨팅·스토리지·네트워크 자원을 추상화하고 소프트웨어 정책과 도구를 통해 통합적으로 할당·관리하는 데이터센터 접근이다. 자원을 풀로 구성하고 프로비저닝을 자동화하여 물리 장비의 개별 설정에 따른 제약을 줄이려 한다. 특정 장비에 더 강하게 종속되는 것이 목표라는 설명은 이 방향과 맞지 않는다. 다만 실제 제품의 호환성 조건은 존재하며 물리 장비 자체가 없어지는 것은 아니다. 자동화를 사용해도 정책 수립, 권한 관리, 장애 대응과 같은 사람의 책임까지 없어지지는 않는다.
선지별 해설
- 컴퓨팅·네트워크·스토리지의 가상 자원을 통합적으로 다루는 방향이다.
- 정책에 따른 할당과 운영 자동화를 활용한다.
- 물리 자원을 추상화하고 풀로 관리하여 필요한 서비스를 제공한다.
- 특정 하드웨어에 종속을 강화하는 것이 SDDC의 목표라는 설명은 틀리다.
편집 해설 근거: IBM, What is a software-defined data center? — What is an SDDC?
97. 커널 수준의 접근통제와 감사 등 보안 기능을 강화한 운영체제를 가리키는 일반적인 용어는?
[학습용 개정문항]
- GPIB
- CentOS
- XSS
- Secure OS
정답과 해설 보기
정답: 4
정답은 ④이다. Secure OS는 접근통제와 감사 등 보안 기능을 강화한 운영체제를 가리키는 일반 용어다. 커널 수준에서 보안 정책을 집행하면 개별 응용이 임의로 권한을 우회하지 못하도록 제한하는 데 도움이 된다. 예를 들어 SELinux는 Linux 커널에 포함된 보안 모듈로 강제 접근통제 정책을 적용한다. 다만 보안 기능을 추가했다고 모든 취약점과 공격을 막을 수 있는 것은 아니다. CentOS 같은 배포판에서도 보안 기능을 사용할 수 있으므로 특정 배포판 이름을 보안이 없는 운영체제라는 뜻으로 해석하면 안 된다.
선지별 해설
- 계측 장비 연결용 버스와 관련된 명칭이다.
- Linux 배포판 계열의 이름이며 보안 강화 운영체제를 가리키는 일반 용어와는 다르다.
- 웹 페이지에서 악성 스크립트 실행을 유발하는 취약점이다.
- 운영체제의 접근통제·감사 등 보안 기능을 강화한 체계를 가리키는 용어이다.
편집 해설 근거: Red Hat Enterprise Linux 9, Getting started with SELinux — §1.1 Introduction to SELinux; §1.4 SELinux architecture and packages
98. Nassi–Shneiderman(NS) 차트에 대한 설명으로 잘못된 것은?
[학습용 개정문항]
- 논리의 기술에 중점을 둔 도형식 표현 방법이다.
- 연속, 선택 및 다중 선택, 반복 등의 제어논리 구조로 표 현한다.
- 주로 화살표를 사용하여 논리적인 제어구조로 흐름을 표 현한다.
- 조건이 복합되어 있는 곳의 처리를 시각적으로 명확히 식별하는데 적합하다.
정답과 해설 보기
정답: 3
정답은 ③이다. Nassi–Shneiderman 차트는 구조적 프로그램의 순차, 선택, 반복 제어를 중첩된 블록으로 나타내는 도식이다. 블록의 배치와 포함 관계가 실행 구조를 드러내므로 일반적인 순서도처럼 화살표를 중심으로 임의의 분기 경로를 연결하지 않는다. 조건 분기나 반복의 범위를 눈으로 구분하고 구조적으로 중첩된 흐름을 표현하는 데 도움이 된다. 다만 도식으로 표현했다고 프로그램이 자동으로 올바르거나 복잡한 조건이 저절로 단순해지는 것은 아니므로 논리 자체의 검토도 필요하다.
선지별 해설
- 프로그램의 제어 논리를 구조적으로 나타내는 도형식 표현이다.
- 순차·선택·반복의 구조적 제어를 표현할 수 있다.
- 주된 표현 수단은 중첩 블록이며 화살표 중심의 흐름 연결이 아니다.
- 조건과 반복의 포함 관계를 시각적으로 구분하는 데 도움이 된다.
편집 해설 근거: Nassi·Shneiderman, Flowchart techniques for structured programming (1973), 저자 제공 원문 — Flowchart techniques for structured programming — Figures 1–3
99. map 함수로 중간 키·값 쌍을 만들고 같은 키의 값들을 모아 reduce 함수로 처리하는 대용량 분산 데이터 처리 모델은?
[학습용 개정문항]
- MapReduce
- SQL
- Hijacking
- Logs
정답과 해설 보기
정답: 1
정답은 ①이다. MapReduce는 map 함수가 입력 키·값 쌍을 중간 키·값 쌍으로 바꾸고, 같은 중간 키에 대응하는 값들을 reduce 함수로 처리하는 프로그래밍 모델이다. 단어 수를 세는 예에서는 map이 단어마다 1을 내보내고 같은 단어의 값들을 모아 reduce가 더할 수 있다. 분산 실행 시스템은 작업 분배와 통신, 실패 후 재실행 등을 지원한다. 핵심은 임의의 순서로 자료를 섞는다는 표현이 아니라 같은 키의 중간 결과를 함께 처리한다는 점이다. SQL이라는 질의 언어 전체와도 구별된다.
선지별 해설
- 중간 키·값 생성과 키별 집계 단계를 사용하는 분산 처리 모델이다.
- 관계형 데이터 등을 질의·조작하는 언어로 이 두 함수 모델의 명칭은 아니다.
- 연결이나 권한 등을 가로채는 공격 행위를 가리키는 용어이다.
- 실행 이력 등의 기록을 가리키며 이 처리 모델의 이름이 아니다.
편집 해설 근거: Jeffrey Dean·Sanjay Ghemawat, MapReduce: Simplified Data Processing on Large Clusters, OSDI 2004 — Abstract
100. 전통적으로 ISO/IEC 15504 계열과 연결되어 소프트웨어 프로세스의 평가·개선 및 능력 결정을 다루는 체계의 통용 명칭은?
[학습용 개정문항]
- ISO 14001
- IEEE 802.5
- IEEE 488
- SPICE
정답과 해설 보기
정답: 4
정답은 ④이다. SPICE는 Software Process Improvement and Capability Determination과 관련된 프로세스 평가·개선 체계를 가리키는 통용 명칭이며 고전적인 ISO/IEC 15504 계열과 연결된다. 실제 프로세스가 어느 수준으로 수행되고 관리되는지 평가하여 개선에 활용하는 것이 목적이다. ISO 14001은 환경경영, IEEE 802.5는 토큰 링 계열 통신, IEEE 488은 계측기 버스와 관련되므로 이 목적과 다르다. 15504의 여러 부분은 후속 330xx 계열로 대체되었으며, 예를 들어 15504-4는 TR 33015:2019로 개정되었다.
선지별 해설
- 환경경영시스템에 관한 표준 계열이다.
- 토큰 링 방식의 LAN 표준과 관련된다.
- 계측기 연결 인터페이스 버스 표준과 관련된다.
- 소프트웨어 프로세스 평가·개선 및 능력 결정에 관한 SPICE이다.
편집 해설 근거: ISO/IEC 15504-4:2004, Process assessment, 공식 개요 및 대체 표준 표시 — Abstract; Revised by — ISO/IEC TR 33015:2019
정보처리기사 필기 기출문제 학습 방법
먼저 PDF 문제지를 시간에 맞춰 푼 뒤, 이 글에서 오답의 정답·해설·근거를 확인하세요. 법규 문항은 근거 기준일 이후 개정 여부도 함께 확인하는 것이 안전합니다.